
Мой блог
Как нейросети захламляют науку и как с этим бороться: разбор подхода SciSlop

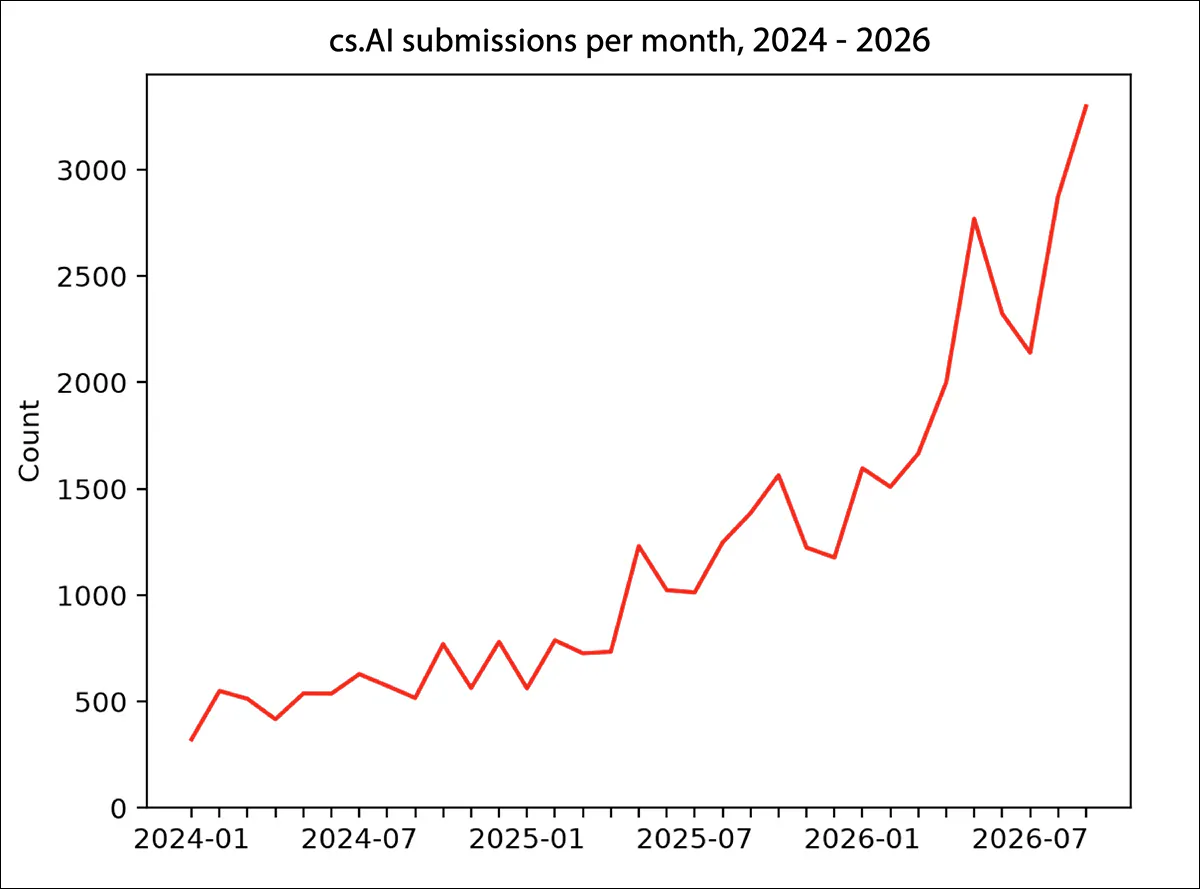
Подробности изложены в материале первоисточника. Масштабное внедрение искусственного интеллекта привело к лавинообразному росту числа научных публикаций, что спровоцировало серьезный кризис качества. На этом фоне препринт-сервер arXiv ввел жесткие ограничения на количество подаваемых материалов для авторов, а исследователи из Сеульского национального университета и Университета Миннесоты разработали специальный бенчмарк для поиска и исправления «научного мусора» (scientific slop).
Проблема избыточного потока низкокачественного контента стала настолько острой, что ведущие площадки пересматривают свою политику. Я провел детальный анализ нового метода, оценив его эффективность против традиционных детекторов текста и возможности автоматического исправления ошибок.
Масштаб кризиса и реакция платформ
Современные генеративные модели позволяют создавать научные работы в промышленных масштабах. Это привело не только к техническим проблемам с парсингом данных и нагрузкой на веб-ресурсы, но и к резкому падению общего уровня публикаций. Сигнал-тонусовое соотношение в базах данных стремительно ухудшается.
В ответ на это администрация arXiv ввела жесткий лимит — не более двух заявок на публикацию от одного автора в месяц. Согласно статистике, только за сентябрь 25-го и 26-го годов объемы выросли в несколько раз, породив около девяти тысяч запросов в службу поддержки за месяц. Модераторы отмечают засилье поверхностных работ узкой направленности, «салями-публикаций», когда одно исследование искусственно разбивается на части, и полностью сгенерированных ИИ текстов.
Новый подход к оценке качества: SciSlopBench
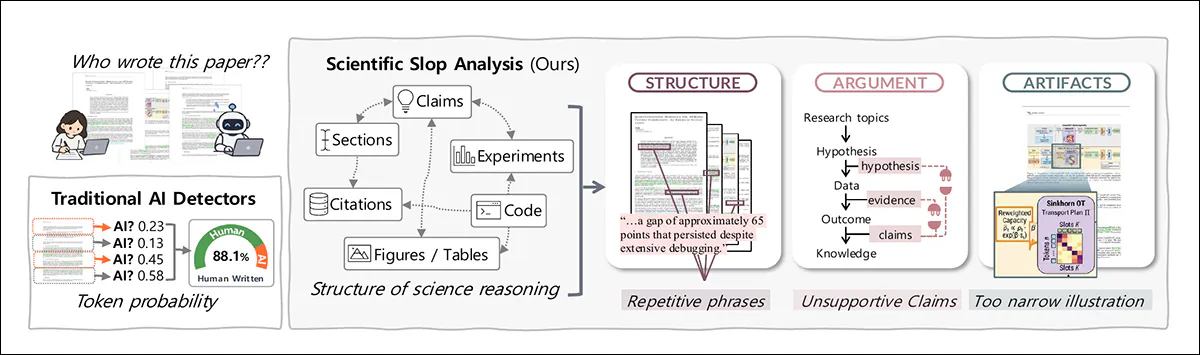
Чтобы справиться с проблемой, исследователи из Южной Кореи и США предложили оценивать не просто стилистику текста, а логические связи внутри работы. Новая система получила название SciSlopHarness на базе бенчмарка SciSlopBench. В отличие от стандартных детекторов, которые анализируют отдельные токены, этот инструмент проверяет, насколько убедительно аргументы, цитаты и доказательства связаны между собой на уровне всего документа.
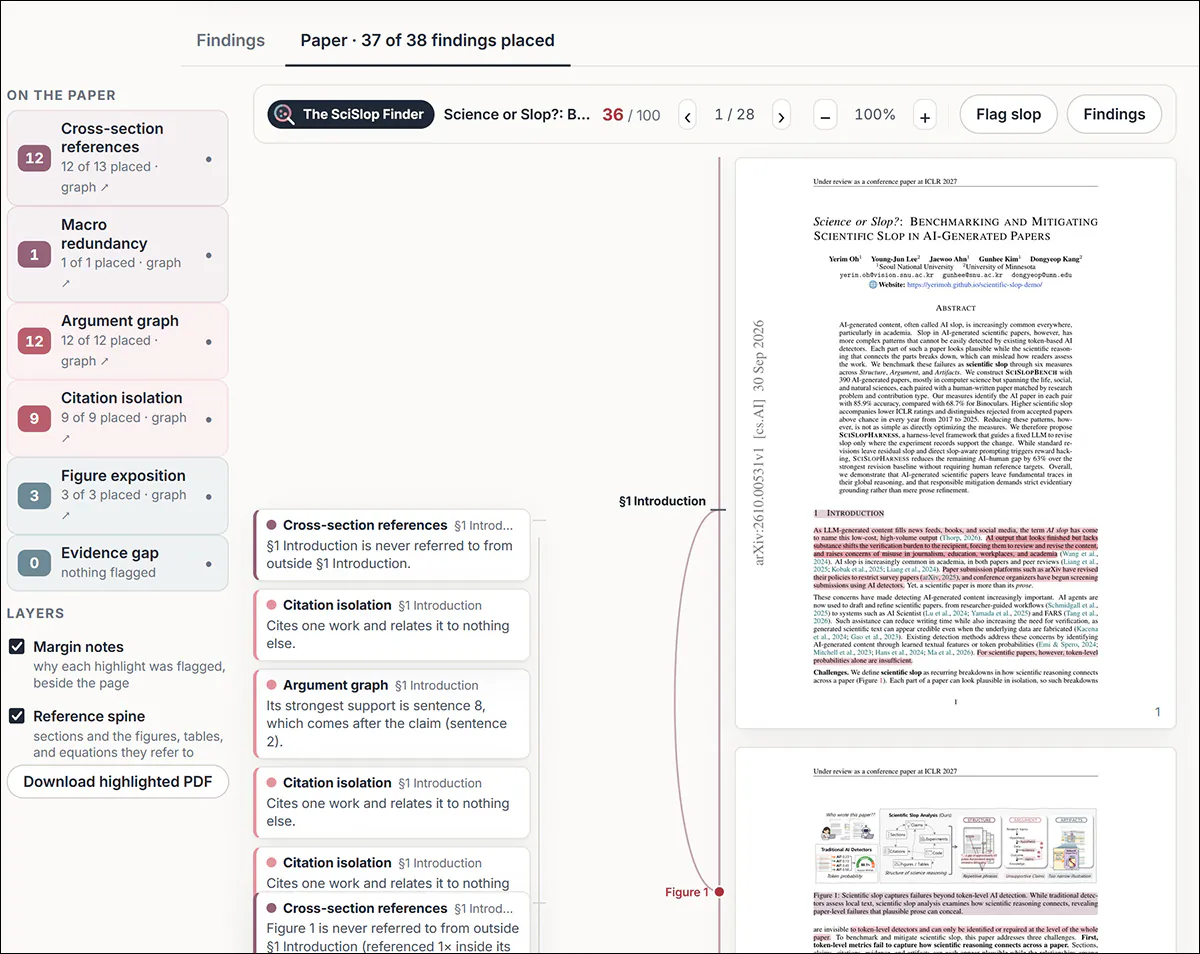
Авторы выделяют три главные трудности при работе с контентом от нейросетей. Во-первых, метрики на уровне токенов не видят разрывов в логике, так как каждый отдельный абзац может выглядеть вполне правдоподобно. Во-вторых, паттерны «научного мусора» ранее не измерялись в комплексе. В-третьих, исправление таких ошибок требует не простого перефразирования, а восстановления логических цепочек без искажения сути исследования.
Шесть признаков научного мусора
В основу методики легло понятие «поверхностной компетентности», описанное в недавних исследованиях феномена ИИ-мусора. Ученые выделили шесть основных критериев оценки:
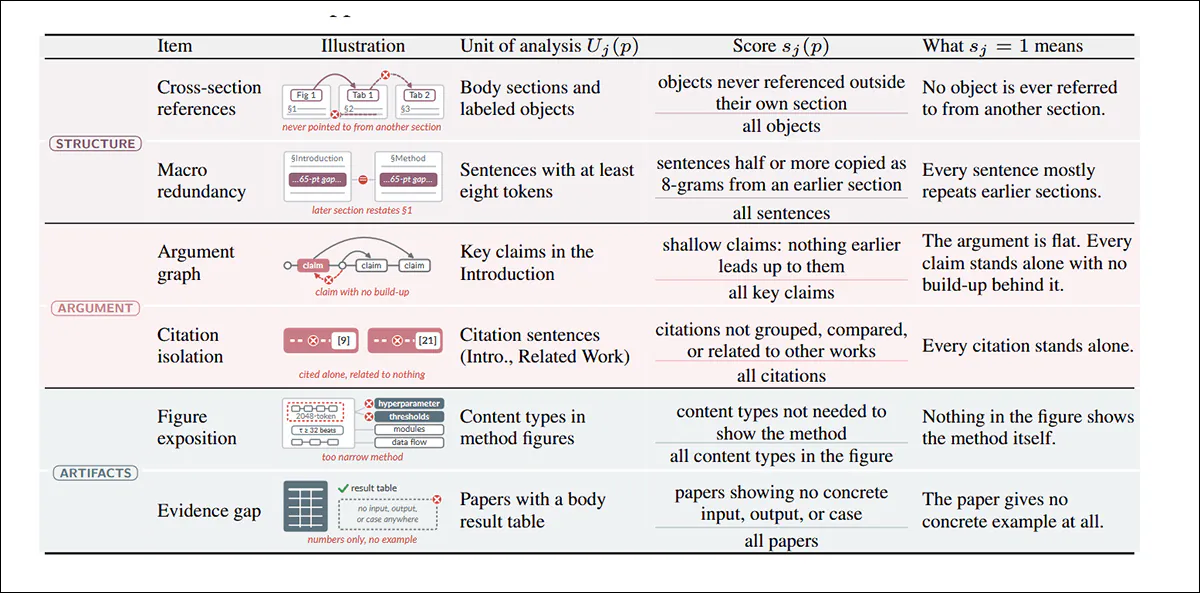
- Перекрестные ссылки — насколько осмысленно разделы ссылаются друг на друга.
- Макроизбыточность — дублируют ли поздние части текста более ранние выводы.
- Аргументационный граф — подтверждаются ли заявленные тезисы предыдущими рассуждениями.
- Изоляция цитат — используются ли источники поверхностно, без реального анализа их связи с работой.
- Экспозиция иллюстраций — объясняют ли графики и схемы суть метода на самом деле.
- Пробелы в доказательствах — подкреплены ли заявленные результаты конкретными данными.
Для создания бенчмарка исследователи объединили сотни сгенерированных ИИ работ с сопоставимыми по тематике трудами реальных ученых, отобранными из престижных баз и конкурсов. Это позволило обучить систему эффективно разделять человеческий и машинный контент.
Результаты тестирования и исправления ошибок
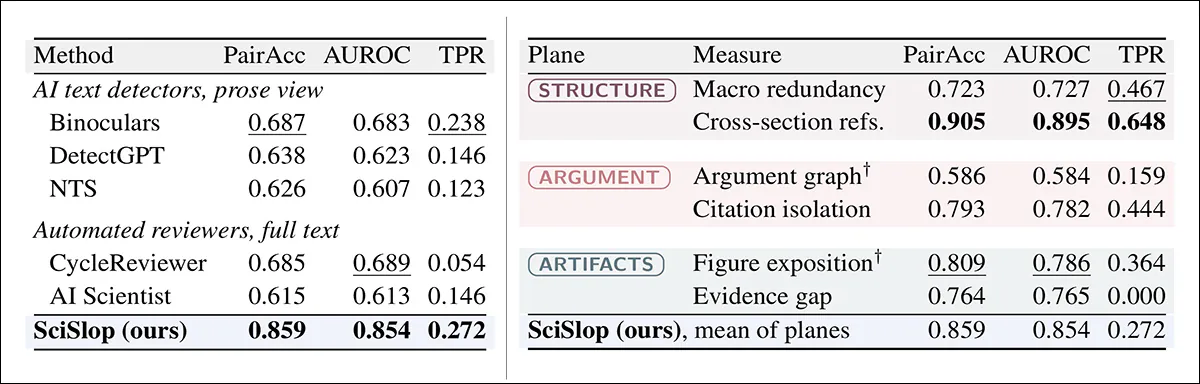
В ходе сравнительных тестов новый инструмент продемонстрировал впечатляющие результаты. Метрика PairAcc показала точность алгоритма на уровне 85.9%, что существенно превзодело показатели классических детекторов вроде Binoculars и DetectGPT, а также автоматических рецензентов. При этом анализ перекрестных ссылок сам по себе выдал точность в 90.5%.
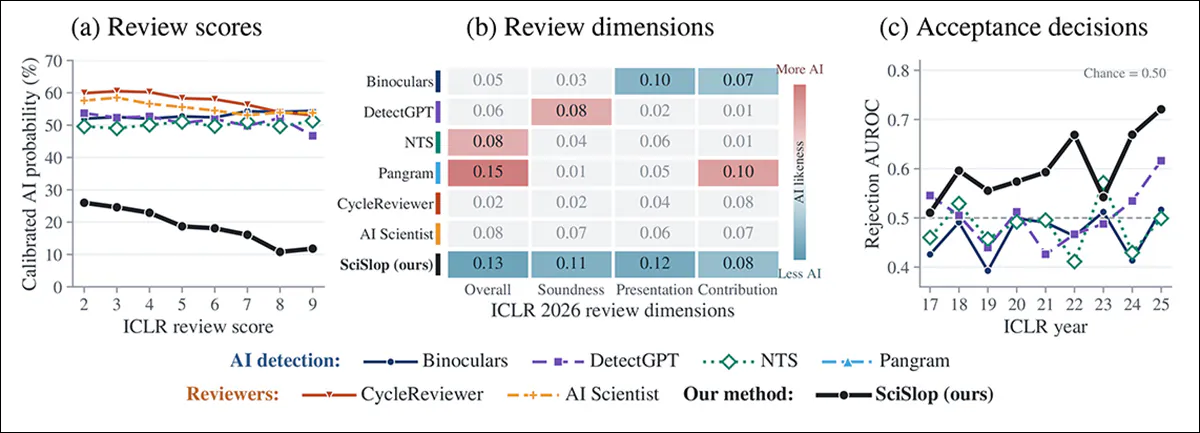
Кроме того, исследователи сопоставили уровень «мусора» с реальными оценками рецензентов на конференциях вроде ICLR. Выяснилось, что высокая концентрация таких дефектов напрямую коррелирует с низкими баллами за содержательность и научную значимость. Отклоненные работы неизменно набирали худшие показатели по шкале SciSlop.
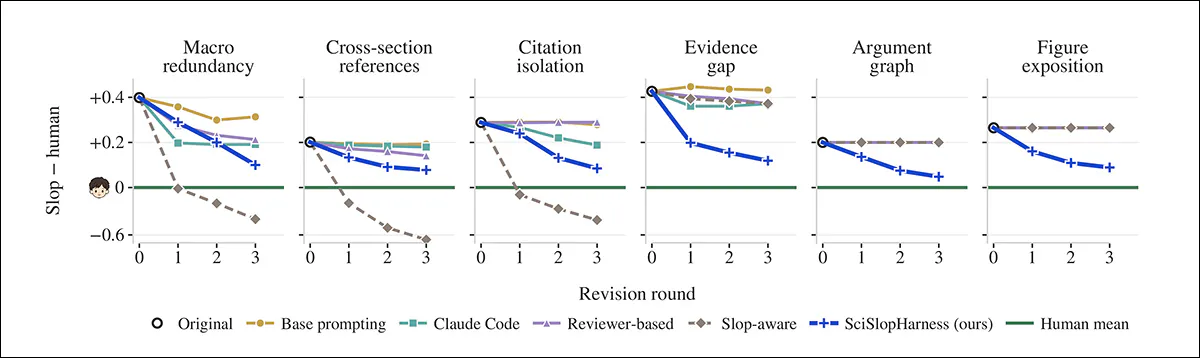
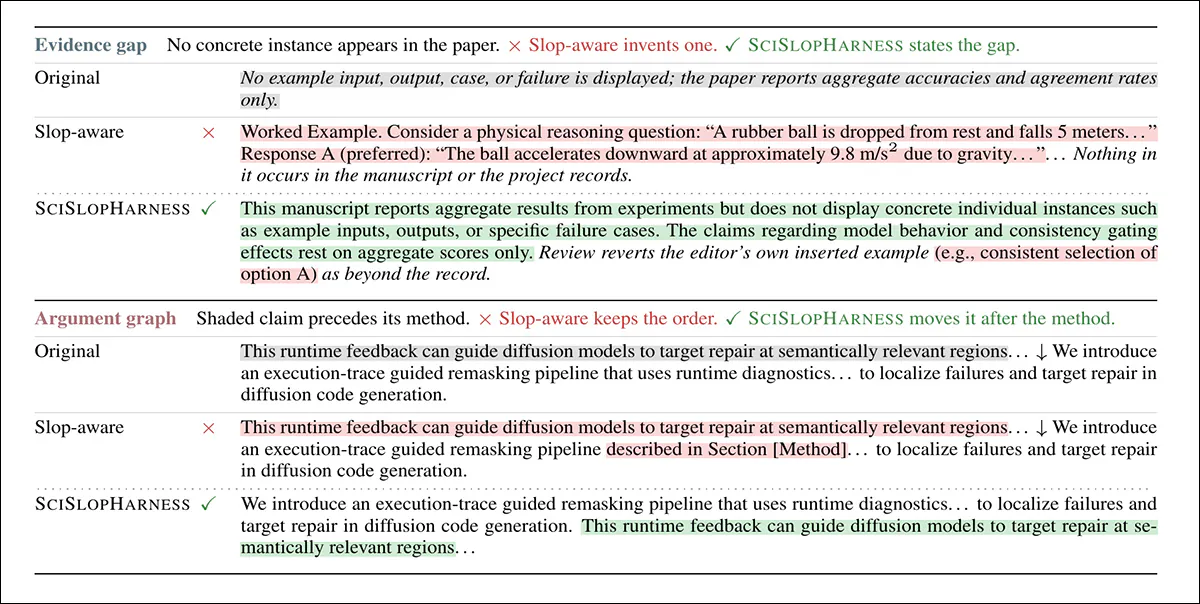
Финальная проверка фреймворка SciSlopHarness в качестве инструмента для правки показала, что система способна устранять выявленные логические разрывы лучше, чем общие языковые модели или базовые сценарии рефакторинга. Искусственные исправления не просто полируют текст, а возвращают ему строгую доказательную базу.
