
Мой блог
Борьба с галлюцинациями в ИИ-ассистентах для сайтов: как настроить честные ответы

Современные языковые модели склонны уверенно выдумывать информацию, когда точных данных нет в базе знаний. Для чат-бота на сайте интернет-магазина или компании подобное поведение может привести к неприятным последствиям, если бот выдаст неверные условия доставки или возврата.
В практике разработки сайтов-ассистентов главная задача заключается в том, чтобы разграничить обычный разговор и подтвержденные факты, исключив генерацию вымышленных условий.
Разделение ответов на диалог и утверждения
Все реплики пользователей в чате можно разделить на две основные категории. Первая группа — это непринужденный диалог: приветствия, благодарности, уточняющие вопросы и общие реплики. С этими задачами языковые модели справляются отлично, так как здесь практически невозможно допустить фактическую ошибку.
Вторая категория — это конкретные факты: стоимость доставки в определенный город, сроки возврата товара, графики работы или контактные данные. Каждое подобное сообщение расценивается как официальное обязательство компании. Именно здесь модели чаще всего склонны фантазировать, достраивая логические цепочки при отсутствии информации. Базовое правило построено на жестком ограничении: поддерживать беседу разрешено свободно, но утверждать факты можно исключительно со ссылкой на верифицированный источник.
Привязка фактов к номерам источников
Для формирования базы знаний материалы собираются непосредственно с сайта компании: с главной страницы, карты сайта sitemap.xml, разделов условий, контактов и справочных материалов. Каждая запись содержит заголовок, текст и прямой адрес страницы.
При поступлении вопроса поисковая система подбирает релевантные фрагменты справки, которые передаются модели в виде пронумерованного списка. Ответ модель обязана вернуть в формате JSON по строгой схеме, где ключевым элементом выступает номер источника. Если точного ответа в предоставленной справке нет, модель должна оставить поле ответа пустым и присвоить индексу источника отрицательное значение.
Использование числовых идентификаторов вместо текстовых цитат или ссылок повышает надежность, поскольку модель не может нафантазировать несуществующий адрес. Наличие числового индекса позволяет пользователю проверить информацию, а разработчикам упрощает разбор возможных ошибок.
Проверка ответов с помощью программного кода
После того как модель генерирует ответ, полученные данные проходят обязательную программную фильтрацию. Код проверяет наличие корректного индекса источника и сверяет его с допустимым диапазоном записей.
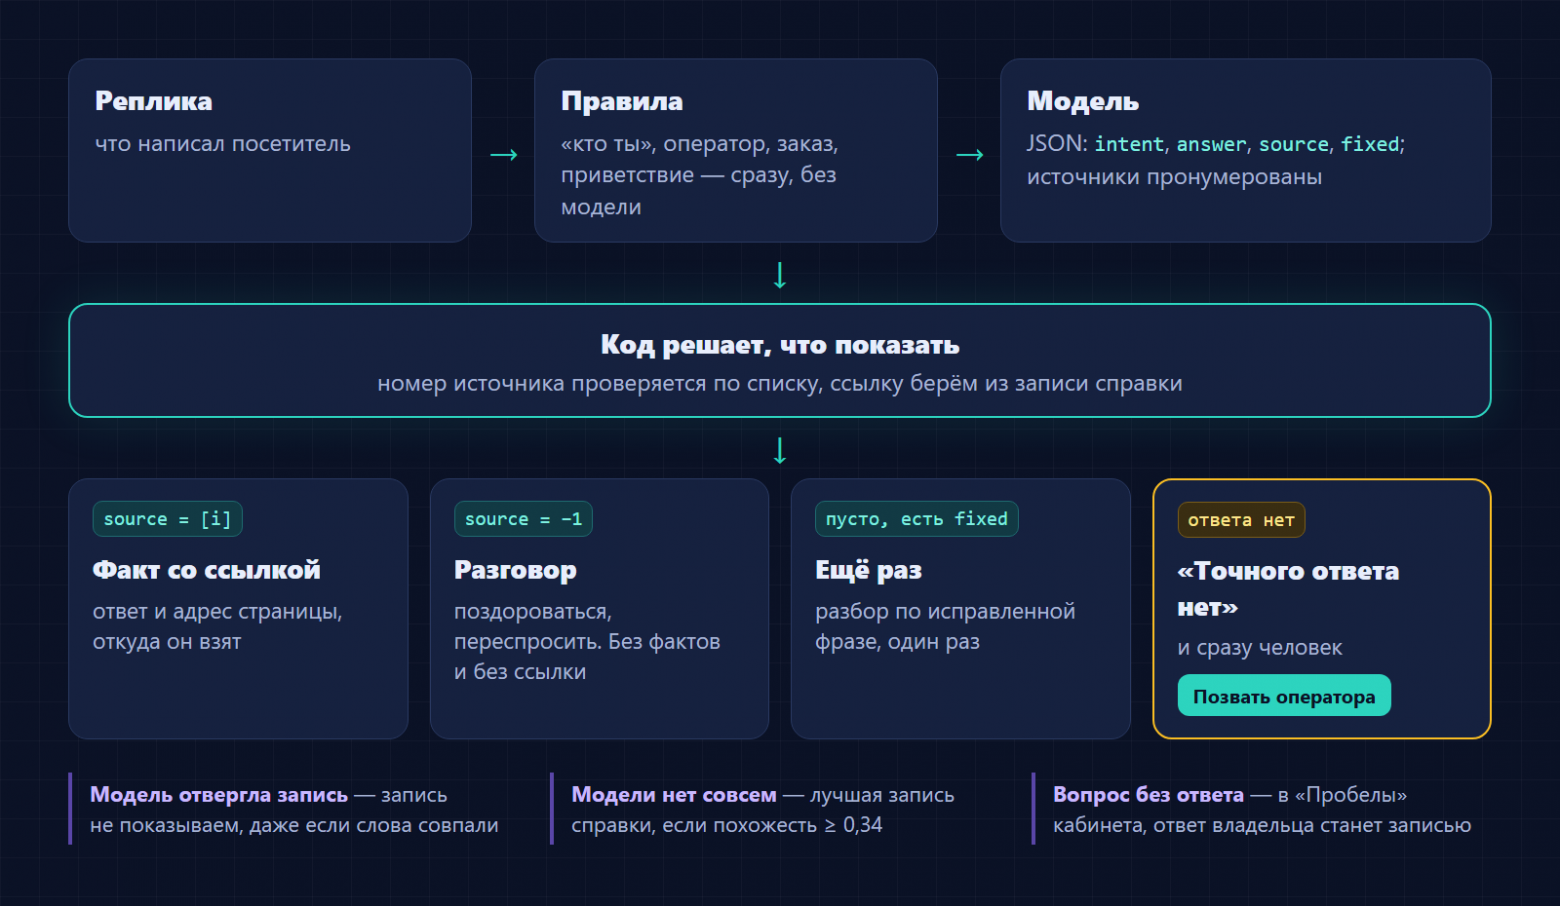
Схема обработки ответов
Логика работы кода строится на нескольких последовательных шагах. Сначала проверяется наличие валидного ответа из существующего списка источников. Если таковой найден, посетителю отправляется текст вместе со ссылкой на официальную страницу. Второй шаг обрабатывает обычные разговорные реплики без фактов, отправляя текст без ссылок. Третий шаг активируется при отсутствии модели или ее недоступности, подставляя наиболее похожую запись из справки по ключевым словам. Четвертый сценарий срабатывает, когда точной информации обнаружить не удалось.
В случае отсутствия ответа стандартная формулировка «точного ответа нет» не превращается в тупик. Рядом с ней выводится кнопка вызова оператора, которая передает сотруднику всю историю переписки. Это избавляет пользователя от необходимости повторять свой вопрос заново.
Фильтрация ложных совпадений и опечаток
Поиск по справке иногда находит материалы по поверхностному совпадению слов, игнорируя реальный смысл. Если модель распознает нерелевантность найденной записи и отказывается от нее, программный код блокирует вывод этой статьи в качестве запасного варианта.
Для борьбы с опечатками в запросах пользователей применяется дополнительный механизм исправления текста. Если исходный запрос с ошибкой не дал результатов, а исправленный вариант отличается от оригинала, система производит повторный анализ по скорректированной фразе.
Приоритет жестких правил над нейросетью
Некоторые критически важные сценарии, такие как прямая просьба позвать живого менеджера или уточнение статуса заказа, обрабатываются до вызова языковой модели с помощью регулярных выражений. Это обеспечивает высокую скорость работы и предсказуемость результата.
Сложные лингвистические конструкции вроде «костюм для менеджера» или «кабель для соединения» не путаются с реальным требованием перевести диалог на сотрудника, так как поиск оператора привязан к глаголам действия. Для проверки надежности таких правил используется специальный эталонный набор фраз, включающий как типовые запросы клиентов, так и случайные реплики из сторонних датасетов голосовых помощников.
Управление пробелами в знаниях
Вопросы, на которые бот не смог найти ответ, фиксируются в специальном разделе панели управления. Схожие формулировки группируются вместе, а владелец сайта может добавить новые ответы, которые автоматически превращаются в полноценные записи справки с небольшим приоритетом при поиске.
Система не требует сложного переобучения нейросети или хранения громоздких клиентских весов. Все изменения вносятся через обновление справочной базы и корректировку системного промпта, что позволяет мгновенно применять правки и при необходимости откатывать их.
Оставшиеся слабые места системы
Несмотря на многоуровневую защиту, сохраняются определенные риски. Модель может выдать разговорную реплику без фактов и случайно добавить утверждение, опираясь исключительно на внутренние инструкции промпта. Возможны ситуации неточного пересказа исходных данных, когда формулировка меняет изначальный смысл. Кроме того, ассистент не может быть точнее первоисточника и честно повторит фактическую ошибку, допущенную на самом сайте.
Грамотно настроенный чат-ассистент должен воспринимать фразу «не знаю» как нормальный результат работы, предотвращая появление уверенных, но ложных ответов, за которые приходится отвечать сотрудникам поддержки.
