
Мой блог
Как создание карты файлов с помощью Claude Code сократило время поиска на 96%

Проблема беспорядка на жестком диске знакома многим пользователям: со временем университетские задания, рабочие документы, скриншоты и случайные файлы накапливаются в таком объеме, что стандартный поиск по системе перестает справляться. В материале рассматривается эксперимент по решению этой проблемы с помощью искусственного интеллекта. Авторы проекта решили превратить домашнюю директорию в персональную карту знаний, заставив нейросеть проанализировать структуру каталогов и построить иерархию файлов через специальные описания.
Попытки навести порядок вручную обычно заканчиваются кратковременным энтузиазмом, после которого папки снова загромождаются случайными данными. Встроенные средства поиска операционных систем эффективны только тогда, когда точно известно название документа, но оказываются бесполезными при попытке найти файл по его содержимому или контексту. Для обхода этого ограничения было решено задействовать инструмент Claude Code, поручив ему составить структурированную справку без изменения исходных данных.
Организация структуры и составление плана
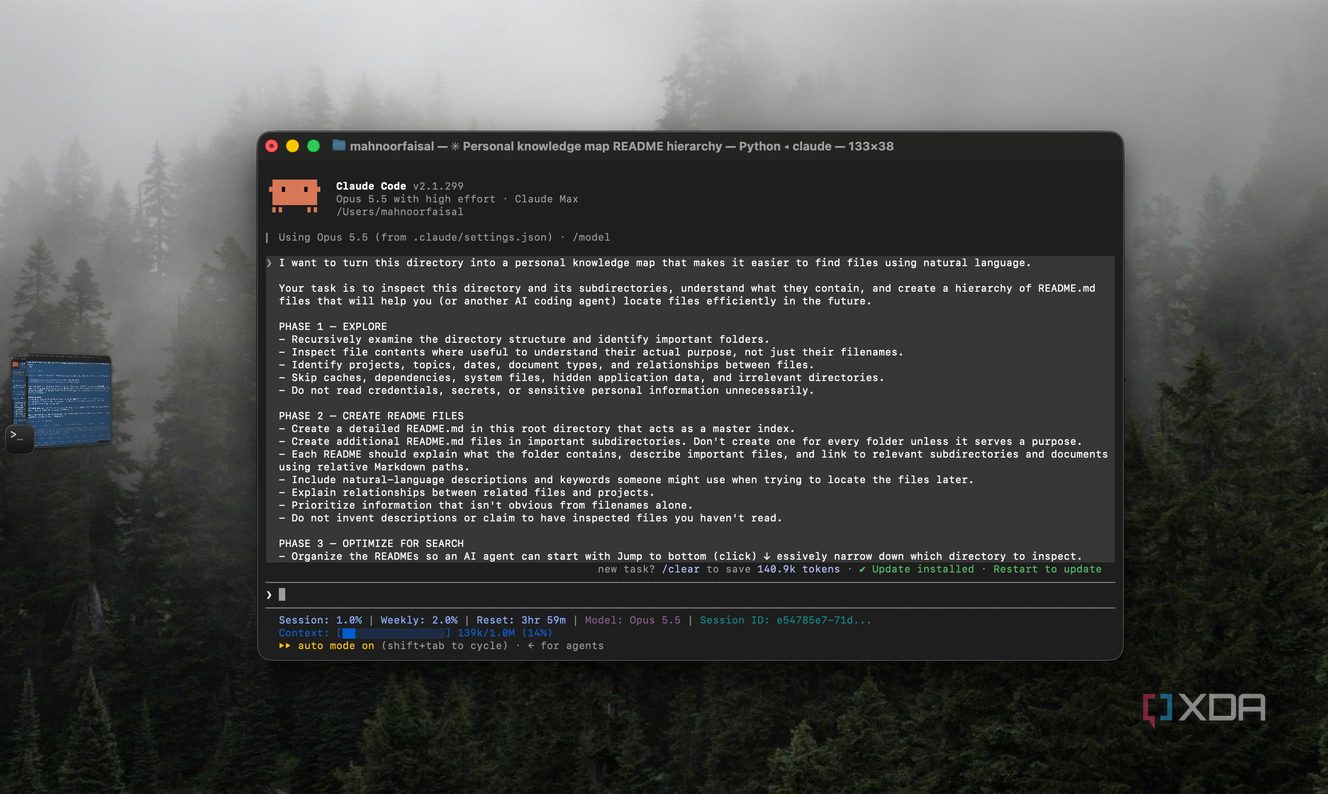
Процесс начался с подачи детального задания для искусственного интеллекта. Промпт предполагал сканирование корневого каталога и вложенных папок с целью формирования иерархии документов README.md. Нейросеть должна была изучать содержимое файлов для понимания их назначения, выявлять связи между проектами и пропускать системные каталоги, кэш, а также конфиденциальные данные.
На первом этапе помощник запустил три параллельных агента для анализа рабочего стола, папки загрузок, документов и проектов. В процессе работы выяснилось, что некоторые файлы имеют неочевидное логическое размещение — например, базы данных SQL хранились внутри папки с названием университетского курса по ассемблеру. После завершения сканирования ассистент предложил план создания индексов, в который были внесены правки безопасности.
В список исключений добавили конфиденциальные материалы: CSV-файлы с паролями, платежные документы, удостоверения личности и визовые бумаги. Главным требованием стало ориентирование файлов на поиск с помощью естественного языка, чтобы в будущем можно было запрашивать конкретные материалы по описанию, а не по точному имени.
Создание иерархии README и файла CLAUDE.md
По результатам выполнения задачи нейросеть сформировала семь файлов с описаниями и один корневой файл CLAUDE.md. Главный документ в корневой директории выполнял роль оглавления, а специализированные индексы охватывали рабочий стол, загрузки, документы и учебные материалы по программированию. В свою очередь, файл CLAUDE.md содержал инструкции для агента: при новом поисковом запросе сначала обращаться к мастер-индексу, переходить по ссылкам к конкретным разделам и только потом проверять наличие целевого файла.
Перед завершением этапа система проверила валидность всех созданных ссылок. Устранив несколько первоначальных неточностей, помощник подтвердил корректность работы всех 309 перекрестных ссылок. При этом ни один из существующих пользовательских файлов не был переименован, перемещен или удален.
Тестирование скорости поиска файлов
Для проверки эффективности созданной карты провели тестирование с использованием двух независимых сессий модели Claude Sonnet 5.5. Обе сессии запускались в безопасном режиме с флагом –safe-mode для отключения кастомных плагинов и хуков, чтобы исключить влияние фоновых настроек. Первой сессии было поручено использовать созданную иерархию README, а второй — полагаться исключительно на стандартные инструменты поиска по файловой системе без использования карт.
В качестве первого теста задали поиск старой программы на языке ассемблера, реализующей меню банкомата. Файл имел неинформативное название labtask4.asm и находился глубоко внутри директории DOS. С помощью иерархического индекса сессия обнаружила нужный объект всего за 9 секунд, последовательно обратившись к главному оглавлению и локальному README в папке DOS. Без применения карты стандартный поиск занял более четырех минут (260 секунд), так как системе потребовалось сканировать множество нерелевантных директорий.
Суммарные результаты серии тестов показали общее сокращение времени поиска примерно на 79% при использовании индексной структуры. Главным достижением эксперимента стало сокращение объема ненужной работы для искусственного интеллекта: вместо постоянного сканирования диска система сразу обращалась к точечным описаниям. Вопрос долгосрочного поддержания такой базы в актуальном состоянии при дальнейшем появлении новых документов остается открытым, однако текущие результаты демонстрируют высокую эффективность подобного подхода к организации данных.
