
Мой блог
Cognition представила модель SWE-2: новый ИИ-кодер на базе Kimi K3 с экономией затрат до 64%

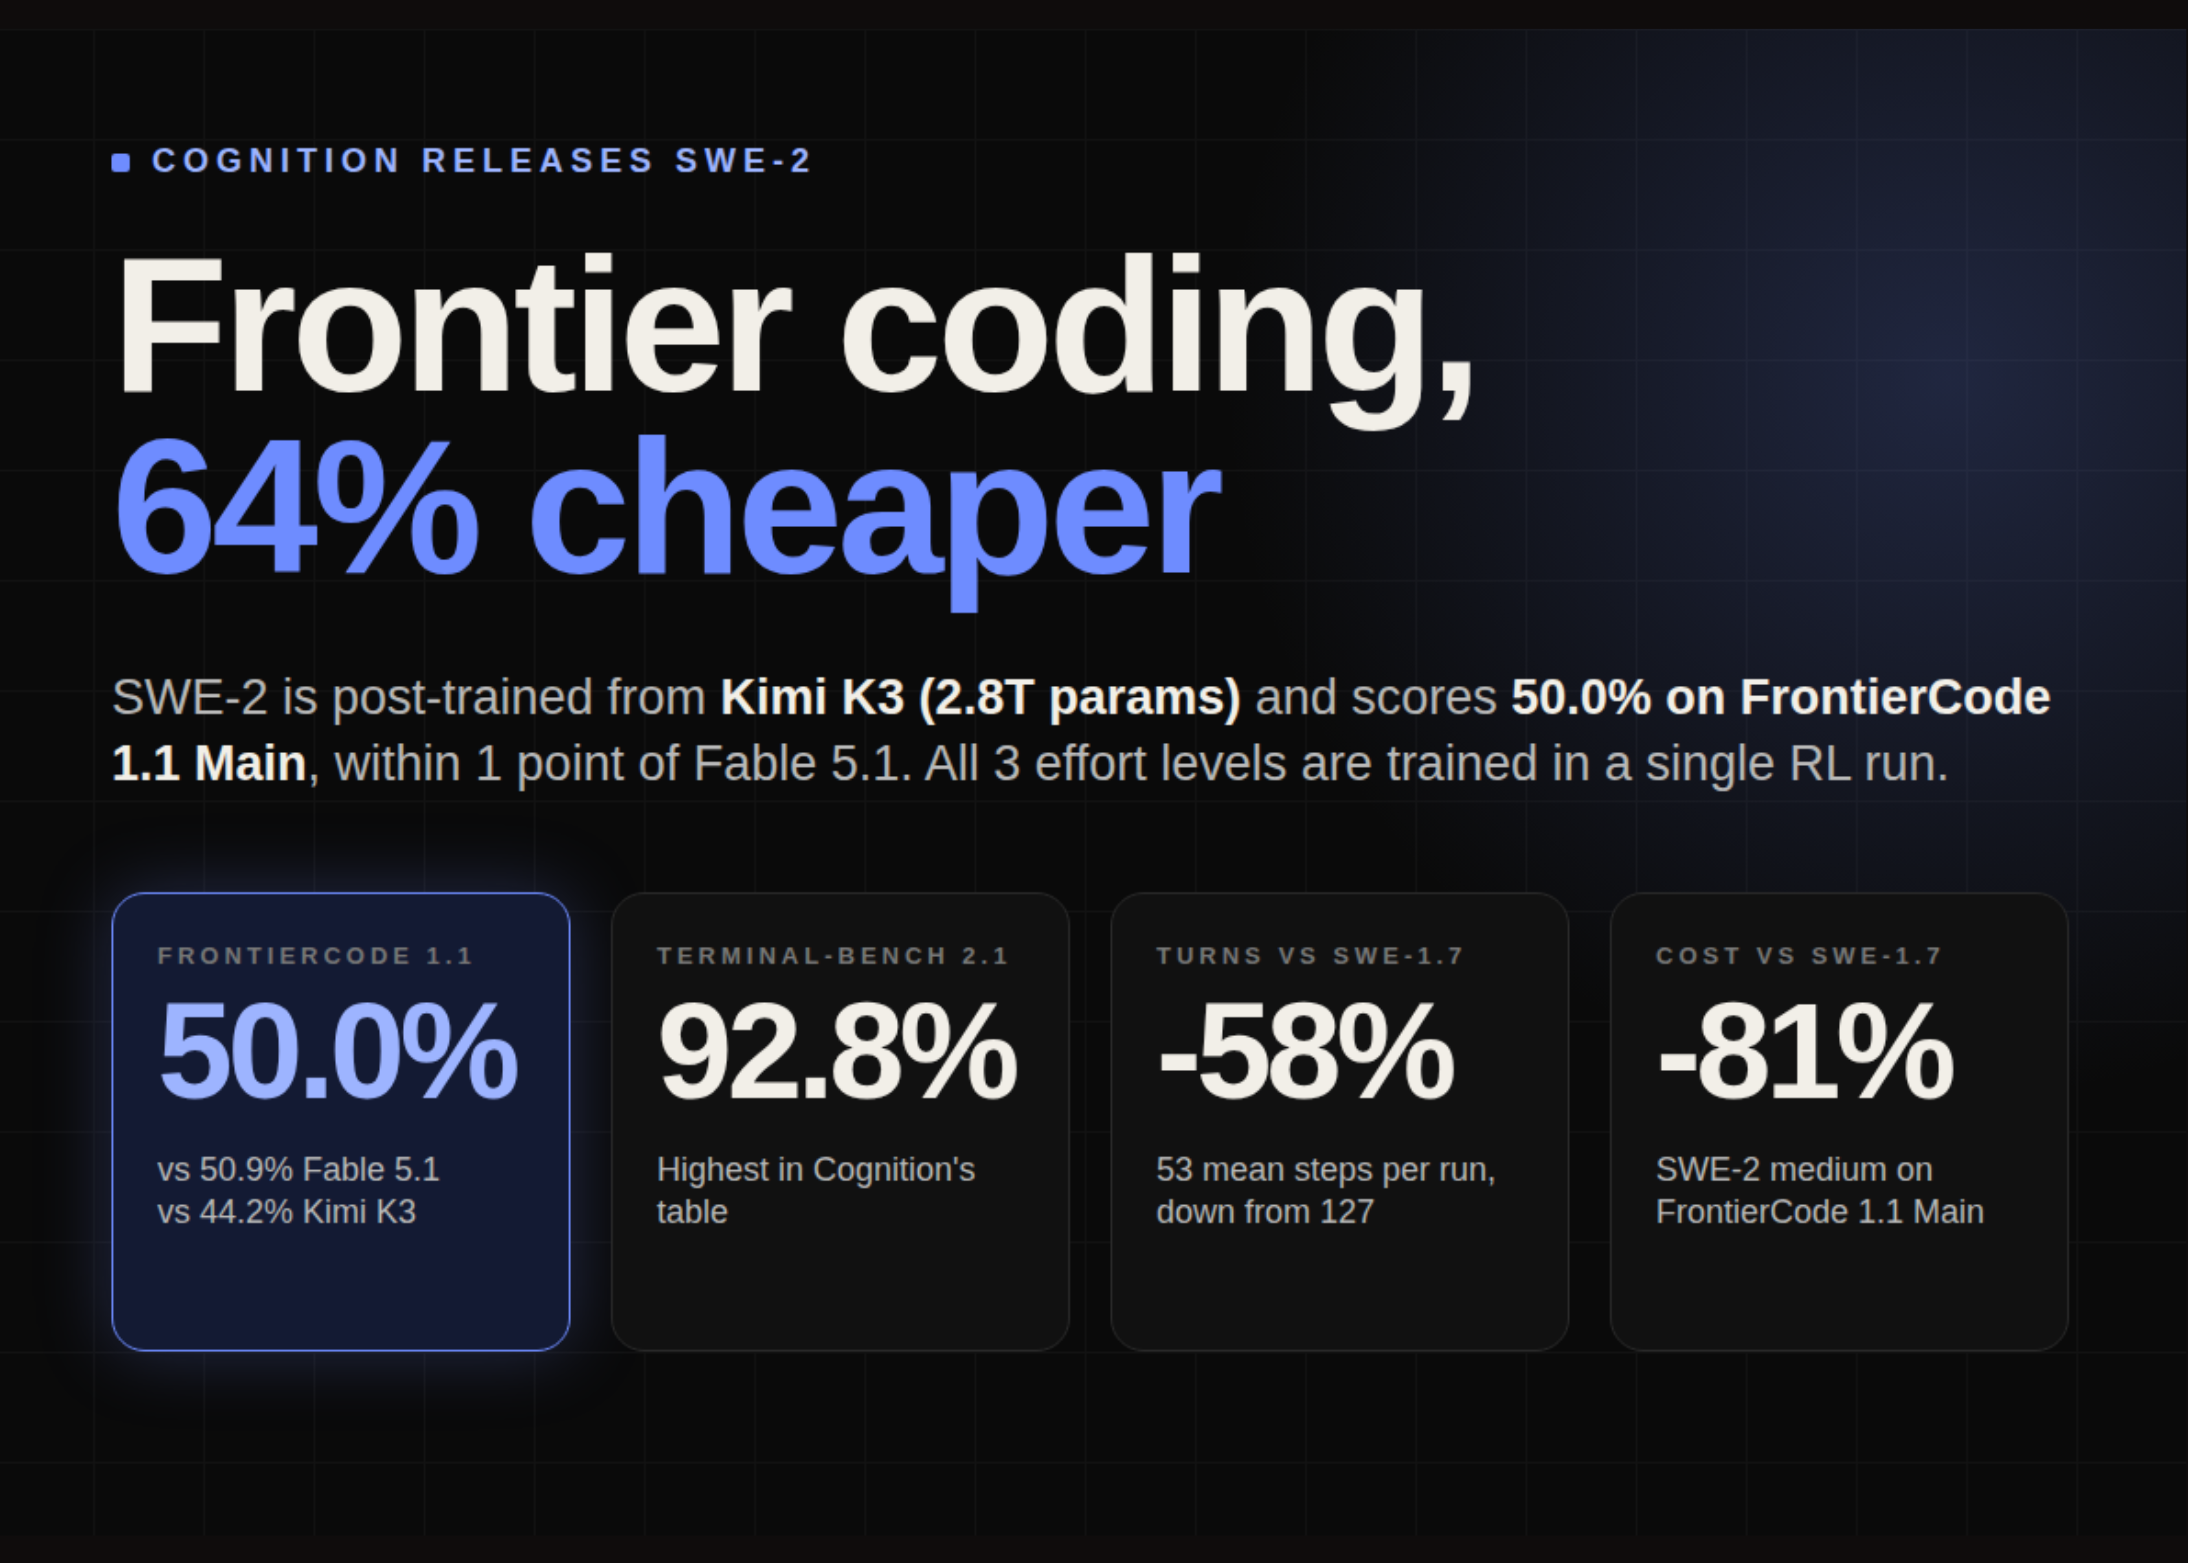
Компания Cognition, создатель известного ИИ-агента Devin, официально представила свою самую продвинутую нейросетевую модель для разработки программного обеспечения — SWE-2. В качестве основы для новинки разработчики выбрали открытую модель Kimi K3 от китайской лаборатории Moonshot AI с 2,8 триллиона параметров, после чего провели глубокое дообучение методом обучения с подкреплением (Reinforcement Learning, RL).
По данным официального отчёта Cognition, на специализированном бенчмарке FrontierCode 1.1 Main новая модель SWE-2 набрала 50,0%, что всего на 0,9 процентного пункта уступает показателям Fable 5.1, но обходится при этом на 64% дешевле. Я внимательно изучил технические детали релиза и готов подробно рассказать, как устроен новый ИИ-кодер и каких результатов удалось добиться разработчикам.
Что представляет собой модель SWE-2
Предыдущая версия системы, SWE-1.7, была построена на базе модели Kimi K2.7. На этот раз инженеры Cognition масштабировали процессы RL-дообучения на мультитриллионный режим параметров, задействовав базовую модель Kimi K3, которая превосходит предшественницу почти в три раза по объёму. Опыт команды показал, что даже на сверхкрупных архитектурах алгоритмы RL способны находить колоссальный запас производительности, добавляя от 5 до 6 процентных пунктов к результатам базовой модели на большинстве тестов.
Ключевой инновацией SWE-2 стало внедрение нескольких выборочных уровней мощности рассуждений (effort levels). В отличие от стандартных подходов, все три доступных режима мощности обучаются в рамках единого прогона алгоритма RL. Каждому уровню назначается индивидуальный штраф за вычислительные затраты, благодаря чему вся граница соотношения цены и производительности смещается одновременно.
Что касается развёртывания, то запустить SWE-2 на собственной инфраструктуре не получится. У модели отсутствуют открытые веса и нет автономного REST API. Она функционирует исключительно внутри платформы Devin: на данный момент поддержка реализована в десктопном клиенте и CLI, а развёртывание для Devin Web и Fusion продолжается.
Результаты бенчмарков и сравнение с конкурентами
Для объективной оценки Cognition опубликовала сводную таблицу результатов на основных тестах производительности. Там, где это возможно, использовались открытые данные, а для остальных моделей проводилось тестирование в их родной тестовой обвязке с максимальными настройками.
| Бенчмарк | SWE-2 | Kimi K3 | Grok 4.6 | Fable 5.1 | GPT-5.6 Sol | GPT-6 Astra | SWE-1.7 |
|---|---|---|---|---|---|---|---|
| FrontierCode 1.1 Main | 50.0% | 44.2% | 48.0% | 50.9% | 47.5% | 53.3% | 42.0% |
| DeepSWE 1.1 | 73.0% | 68.5% | 67.5% | 67.4% | 72.7% | 74.1% | 37.7% |
| Terminal-Bench 2.1 | 92.8% | 88.3% | 88.4% | 91.4% | 88.8% | 89.9% | 81.5% |
| Terminal-Bench 4 | 27.3% | 21.5% | 20.3% | 55.8% | 37.3% | 57.9% | 7.6% |
Как видно из приведенных данных, SWE-2 вырывается в лидеры на Terminal-Bench 2.1 с результатом 92,8% и превосходит базовую Kimi K3 по всем строкам. Представители Cognition отмечают, что модель сокращает отставание от флагманской GPT-6 Astra до нескольких пунктов при вчетверо меньшей стоимости использования. Единственной заметной слабой стороной остаётся бенчмарк Terminal-Bench 4, где SWE-2 набрала 27,3%, уступив лидерам Fable 5.1 и GPT-6 Astra около 30 процентных пунктов.
Изменения в поведении: сфокусированное исследование кода
Прошедшая версия SWE-1.7 часто страдала избыточной разведкой — модель делала много лишних шагов и отвлечений на простых задачах. В SWE-2 эту проблему решили внедрением концепции «сфокусированного исследования» (focused exploration).
На бенчмарке FrontierCode 1.1 Main модель SWE-2 на среднем уровне мощности (medium) показывает более высокую точность, чем SWE-1.7, совершая при этом на 58% меньше итераций и снижая общие затраты на 81%. Среднее число шагов за запуск сократилось со 127 (в SWE-1.7) до 53 в режиме medium, 80 в режиме high и 98 в режиме max. Первую реальную правку кода SWE-2 medium делает в среднем на 18-м шаге против 48 шагов у SWE-1.7.
Кроме того, я отметил три важных паттерна поведения, зафиксированных инженерами в SWE-2:
- Глубокое сквозное тестирование: модель более тщательно покрывает написанный код тестами перед завершением задачи.
- Находчивость при блокировке инструментов: при невозможности использовать привычную утилиту ИИ оперативно находит альтернативные методы решения.
- Дисциплина верификации: если выводы модели подвергаются сомнению, она не просто повторяет утверждение, а заново пересчитывает логические шаги и выводит результат с нуля.
Как обучали SWE-2: штрафы по Парето и оптимизация инференса
Техническая команда Cognition поделилась ключевыми математическими и архитектурными решениями, которые сделали возможным эффективное обучение модели такого масштаба:
Штрафы за стоимость на основе Парето
Функция вознаграждения задаётся формулой R = S – λ × C, где S — бинарный показатель успеха, а C включает стоимость инференса в долларах США и время исполнения. Авторы доказали, что только линейный штраф делает целевую функцию RL строго зависимой от средней стоимости и доли успешных решений. Коэффициент λ для каждого уровня мощности выставляется равным локальному наклону кривой Парето базовой модели.
Взвешенный по длине базовый уровень вознаграждения
Поскольку величина градиента напрямую зависит от длины вызова (rollout), групповой базовый уровень взвешивается по токенам: сумма (R × L), делённая на сумму L. На тестах это позволило существенно снизить дивергенцию Кульбака — Лейблера между инференсом и обучением, стабилизировав процесс без лишних расчетов.
Оптимизация сервинга и вычислительные ядра
Модуль задержки префилла (prefill delayer) объединяет похожие запросы в батчи, повышая показатели TPM на GPU и TPS на запрос на 10–20%. Спекулятивное декодирование DSpark с вспомогательной моделью, дообученной через SpecForge, увеличило длину принимаемых токенов на 15%. Использование квантования NVFP4 и FP8 с обучением, учитывающим квантование (QAT), удержало расхождение между обучением и инференсом на минимальном уровне.
Расширение обучающих данных
Cognition в три раза увеличила число симулируемых сред для RL, добавила наложения следования инструкциям и развернула замкнутый цикл (flywheel), в котором прошлые чекпоинты SWE-2 автоматически исправляют ложные срабатывания в верификаторах.
Проверки надежности и безопасность
В рамках проверки безопасности Cognition повторила два теста из своего открытого исследования надежности. В тесте из 145 политически чувствительных вопросов, касающихся Китая, SWE-2 успешно прошла 98,0% проверок: 99,8% на английском языке, 95,2% на упрощённом китайском и 99,1% на традиционном китайском.
Дополнительное тестирование на устойчивость к контекстным уязвимостям при различных формулировках пользовательских запросов показало отсутствие статистически значимых отклонений ни для одной из протестированных моделей.
Главные выводы
Выход SWE-2 наглядно демонстрирует, как грамотная методика post-training и RL-оптимизация открытых мультитриллионных моделей позволяет добиваться эффективности, сопоставимой с топовыми закрытыми ИИ-системами, но при значительно меньших финансовых затратах.
Я продолжаю активно следить за развитием автономных агентов программирования. SWE-2 задает высокий стандарт практической работы с кодом, и интеграция таких решений в рабочие процессы разработчиков станет важным шагом в автоматизации IT-индустрии.
Источник: www.marktechpost.com
