
Мой блог
Contrastive-LM выпустила модель CLM-8B: открытая система оценки действий агентов

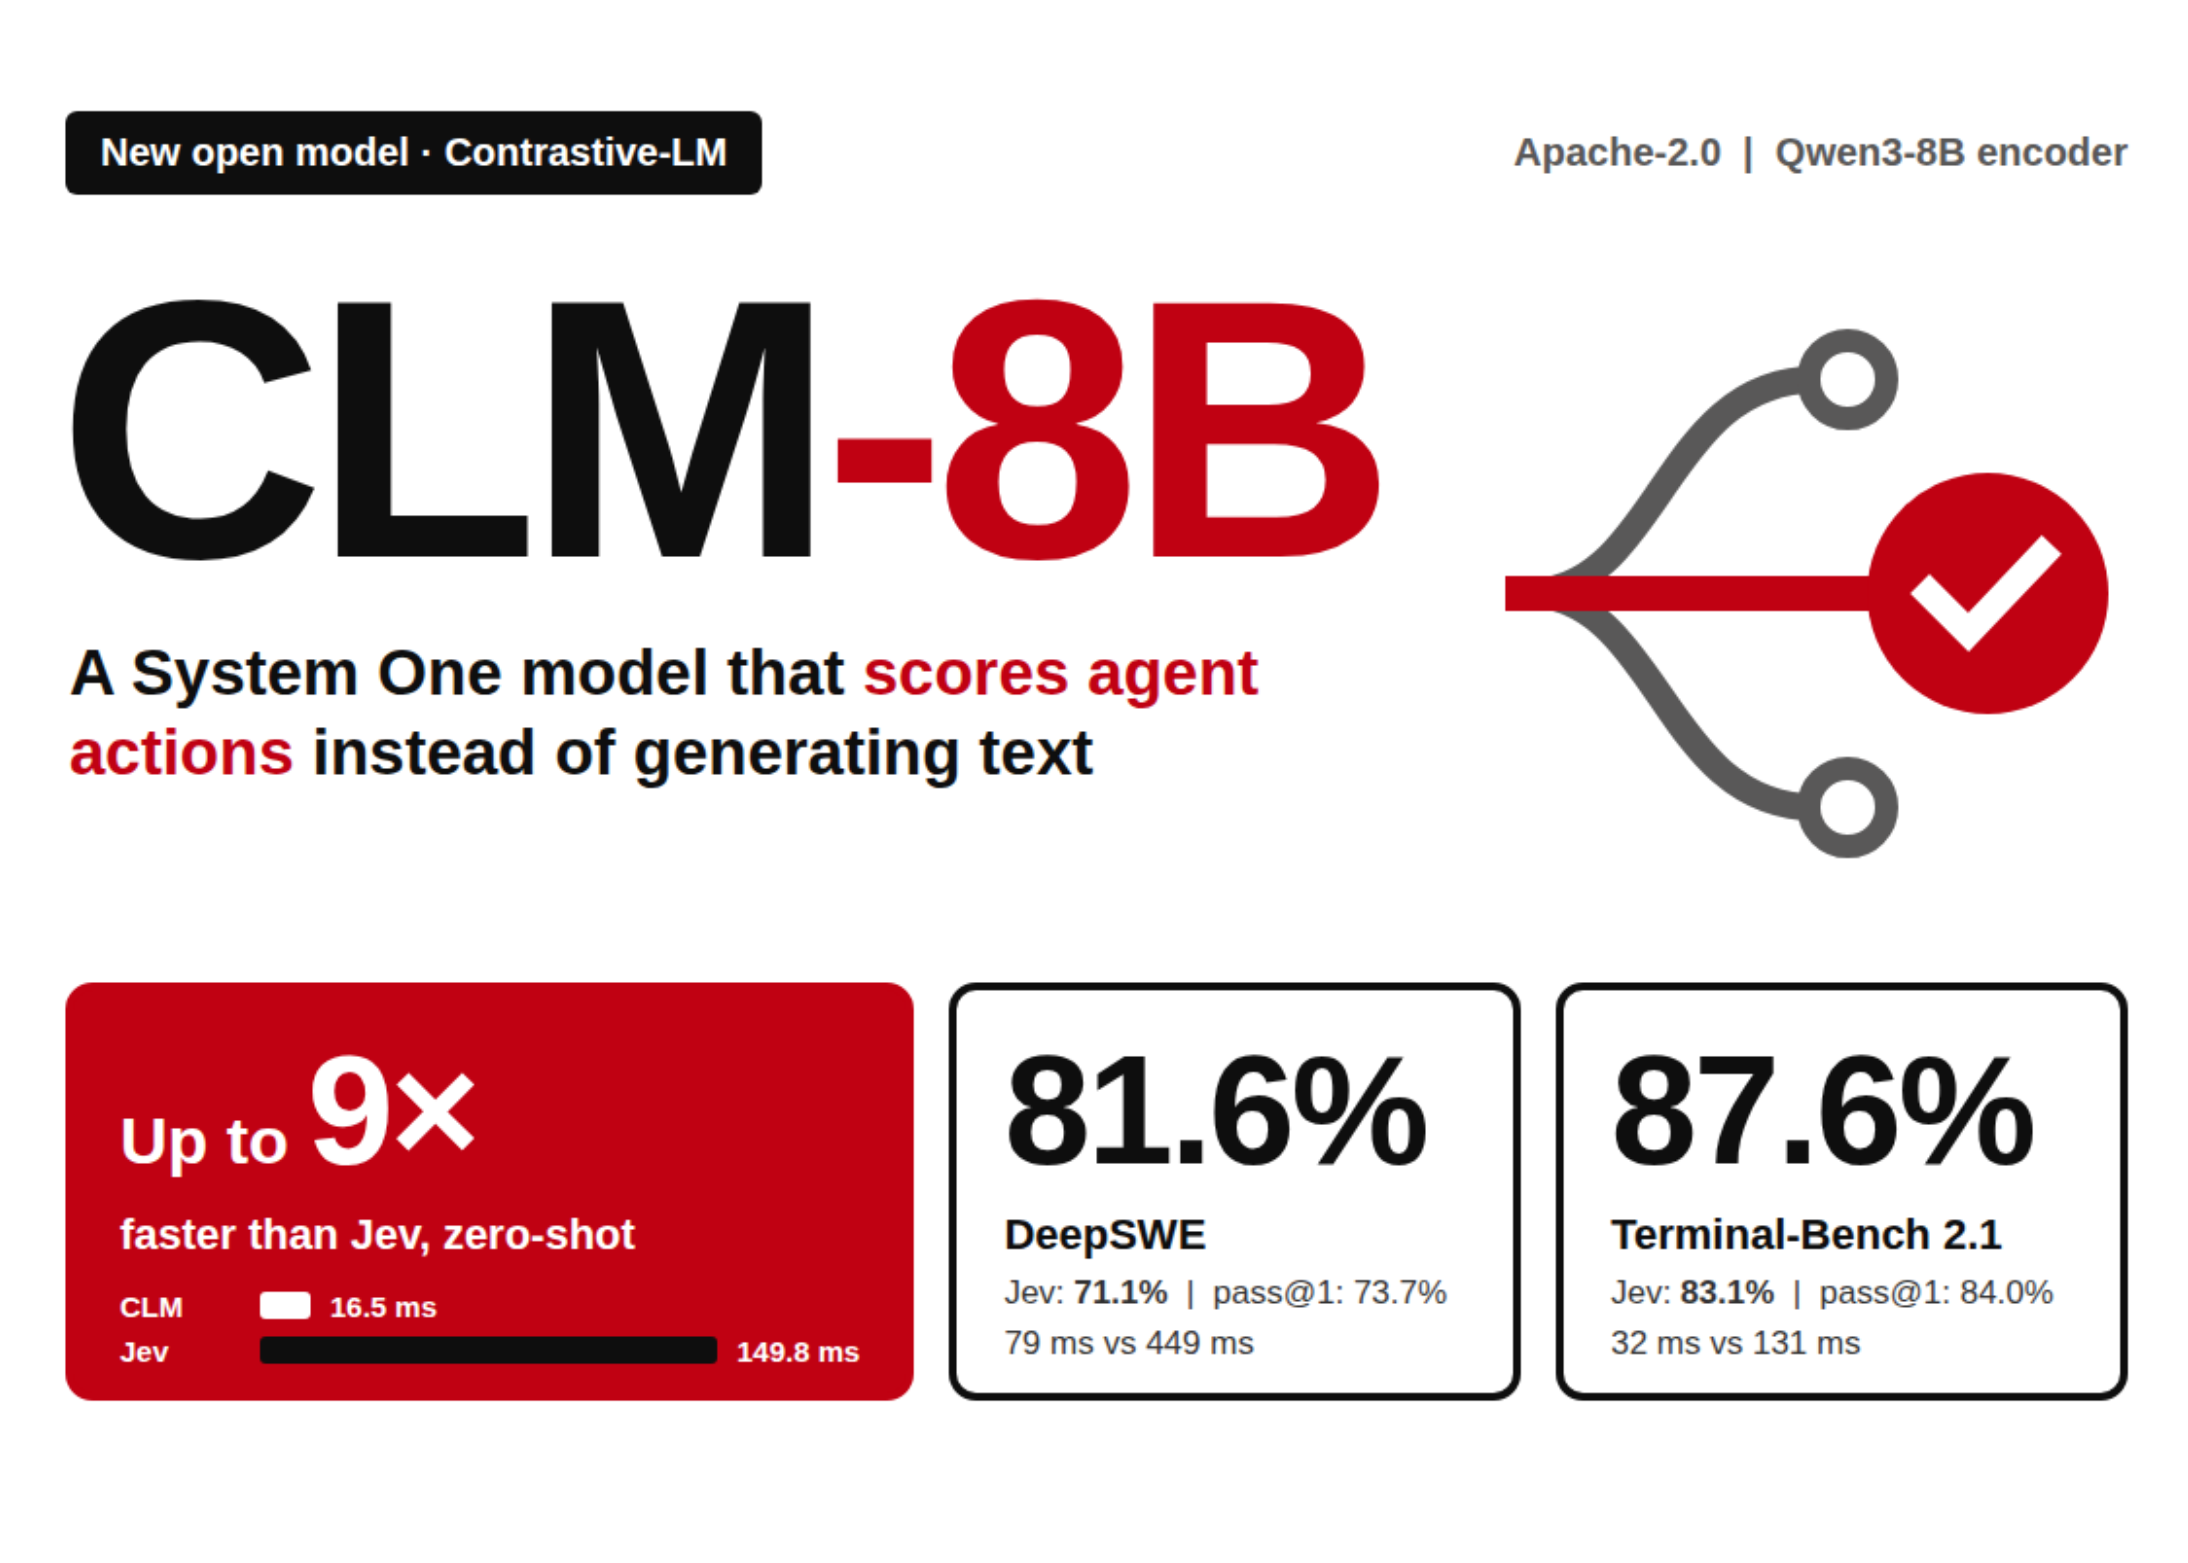
Подробности изложены в материале первоисточника. Сообщество разработчиков искусственного интеллекта получило в своё распоряжение новую открытую модель Contrastive Language Model (CLM-8B), которая принципиально отличается от привычных языковых генераторов. Проект нацелен на прямую конкуренцию с проприетарными решениями и оценивает набор возможных шагов на основе текущего состояния среды, выдавая вероятности до девяти раз быстрее аналогов.
Я создал этот обзор, чтобы детально разобрать архитектуру, особенности обучения и реальные тесты новой разработки, которая может существенно ускорить работу автономных ИИ-агентов.
Что делает System One модель
Интерфейс CLM спроектирован так, чтобы напрямую взаимодействовать с существующими стандартами для систем такого класса. Репозиторий проекта на GitHub позволяет запускать CLM-8B через API, совместимое с TypeSafe, поддерживая три базовых типа вопросов. Первый тип, Noul, вычисляет вероятность истинности заданного утверждения. Второй тип, Choice, выбирает один вариант из объявленного перечня с распределением вероятностей. Третий тип, Score, возвращает ожидаемый уровень по упорядоченной шкале. Любой запрос, составленный для экосистемы TypeSafe, можно без проблем перенаправить и обработать через стандартный Python-клиент CLM.
Как устроена модель CLM
В основе архитектуры лежит раздельное обучение энкодера состояний и энкодера действий при помощи двунаправленной функции потерь InfoNCE. Каждая часть построена на базе замороженной языковой модели Qwen3-8B, к которой добавлена обучаемая проекционная голова размером 20 миллионов параметров. В процессе тренировки алгоритм сближает вектор состояния с тем действием, которое было совершено фактически, и одновременно удаляет его от неверных вариантов.
Интерференция и кэширование векторов
На этапе инференса CLM оценивает каждый кандидат через скалярное произведение эмбеддингов состояния и действия. Применение функции softmax к полученным оценкам формирует итоговое распределение ответов. Такой механизм эффективно ранжирует лучшие решения в задачах best-of-N, управляет маршрутизацией инструментов и обрабатывает типизированные решения.
Поскольку в цикле работы агента состояние среды меняется на каждом шаге, а набор доступных действий остается неизменным, разработчики предусмотрели оптимизацию. Утилита clm-serve выделяет область памяти графического процессора, напоминающую кэш KV в vLLM, и повторно использует кэшированные векторы. На одной видеокарте RTX 4090 при работе с тремя действиями время обработки повторяющихся состояний сокращается с 1.7 миллисекунды до 0.6 миллисекунды.
Трехэтапный рецепт обучения
Процесс создания модели включал три масштабных этапа. Сначала проводилось предварительное обучение примерно на 60 миллионах пар вопросов и ответов из базы Nemotron DQA. На втором этапе модель дообучалась на 30 миллионах синтетических сложных примеров с негативным исходом, которые были сгенерированы с помощью Gemini 2.5 Flash-Lite. На заключительном этапе использовался массив из одного миллиона реальных траекторий агентов из таких источников, как Agent Data Protocol, Endless-Terminals и LiteCoder-Terminal-SFT.
Эксперименты команды показывают, что одно лишь предварительное обучение на 100 тысячах отложенных вопросов обеспечивает 52.1% точности top-1. Промежуточная фаза поднимает этот показатель до 69.2%. При этом попытка обучать модель на сложных негативных примерах с самого начала дает пик на отметке 62.4%, после чего наступает быстрое переобучение.
Результаты нулевого шока против Jev
Девятикратное ускорение было зафиксировано на игре T-Rex, где доступные действия циклически повторяются между состояниями. В тестах на T-Rex и Super Mario новинка демонстрирует результаты, полностью сопоставимые с Jev. Небольшое отставание наблюдается в задачах вызова инструментов (Tool calling) и в бенчмарке WikiRacing, однако CLM неизменно сохраняет преимущество в скорости на каждой из поставленных задач.
CLM в роли верификатора для кодинг-агентов
В задачах программной инженерии генератор создает несколько вариантов решений, после чего верификатор выбирает наиболее подходящий. В тестах модель Opus 5 генерировала кандидатов для DeepSWE (в режиме best-of-4), а Fable 5 готовила варианты для Terminal-Bench 2.1 (в режиме best-of-5). Команда исследователей протестировала 38 задач DeepSWE и 30 задач Terminal-Bench 2.1 на аппаратном обеспечении с ускорителем H100.
Замеры показали, что доработанные версии CLM демонстрируют передовые результаты верификации. Базовый аналог Jev в этих тестах набирает баллы ниже стандартного показателя pass@1, что делает автоматический выбор с его помощью менее эффективным, чем случайный забор одного образца. При этом CLM работает быстрее в 4.1–5.7 раза. Важно отметить, что эти цифры получены с использованием специализированных легковесных голов после тонкой настройки, а не на исходных чекпоинтах нулевого шока.
Ключевые выводы
Новая модель CLM-8B предлагает нестандартный подход к работе с ИИ-агентами, оценивая готовые действия вместо генерации текста. Открытая архитектура распространяется по лицензии Apache-2.0, весит 75 МБ в своей рабочей части и запускается на одном потребительском или серверном GPU под управлением Linux. Сочетание кэширования векторов и эффективной системы оценки делает проект перспективным инструментом для разработчиков, стремящихся минимизировать задержки в автономных программных циклах.
