
Мой блог
Как я настроил проверку здоровья Docker-контейнеров, и теперь мой домашний сервер сам перезапускает сбоящие службы

Подробности изложены в материале первоисточника. Утром можно открыть любимый сервис и обнаружить, что он не работает, хотя стандартные мониторинги и сам Docker рапортуют об абсолютном благополучии. Я неоднократно сталкивался с подобными ситуациями в своем домашнем сервере, поэтому решил внедрить надежные проверки работоспособности для каждого контейнера, чтобы система могла автоматически восстанавливаться.
Когда я столкнулся с тем, что автоматическое обновление через Watchtower сломало базу данных Nextcloud из-за рассинхронизации версий, стандартные средства мониторинга промолчали. Контейнер работал, но само приложение внутри него было сломано. Обычный статус «Up» в Docker означает лишь то, что главный процесс запущен, но это не гарантирует корректную работу самого веб-сервиса или базы данных.
Почему статус «работает» не означает реальную работоспособность
В течение своей практики администрирования домашней лаборатории я неоднократно убеждался, что базового мониторинга Docker явно недостаточно. Несколько недель назад я экспериментировал с утилитой Watchtower для автоматического обновления образов. Все шло гладко, пока однажды утром я не увидел ошибку базы данных в Nextcloud. Новая версия кода опережала схему базы данных, требуя ручной миграции через консоль.
Сама проблема решалась одной командой, но тревожным фактом оказалось молчание систем слежения. Посмотреть на эту проблему изнутри можно с помощью простого теста с временным контейнером Nginx. Если намеренно удалить конфигурационный файл и перезагрузить Nginx внутри контейнера, то команда curl покажет ошибку, в то время как стандартная проверка docker ps отразит статус работающего сервиса.
Анализ существующих проверок в контейнерах
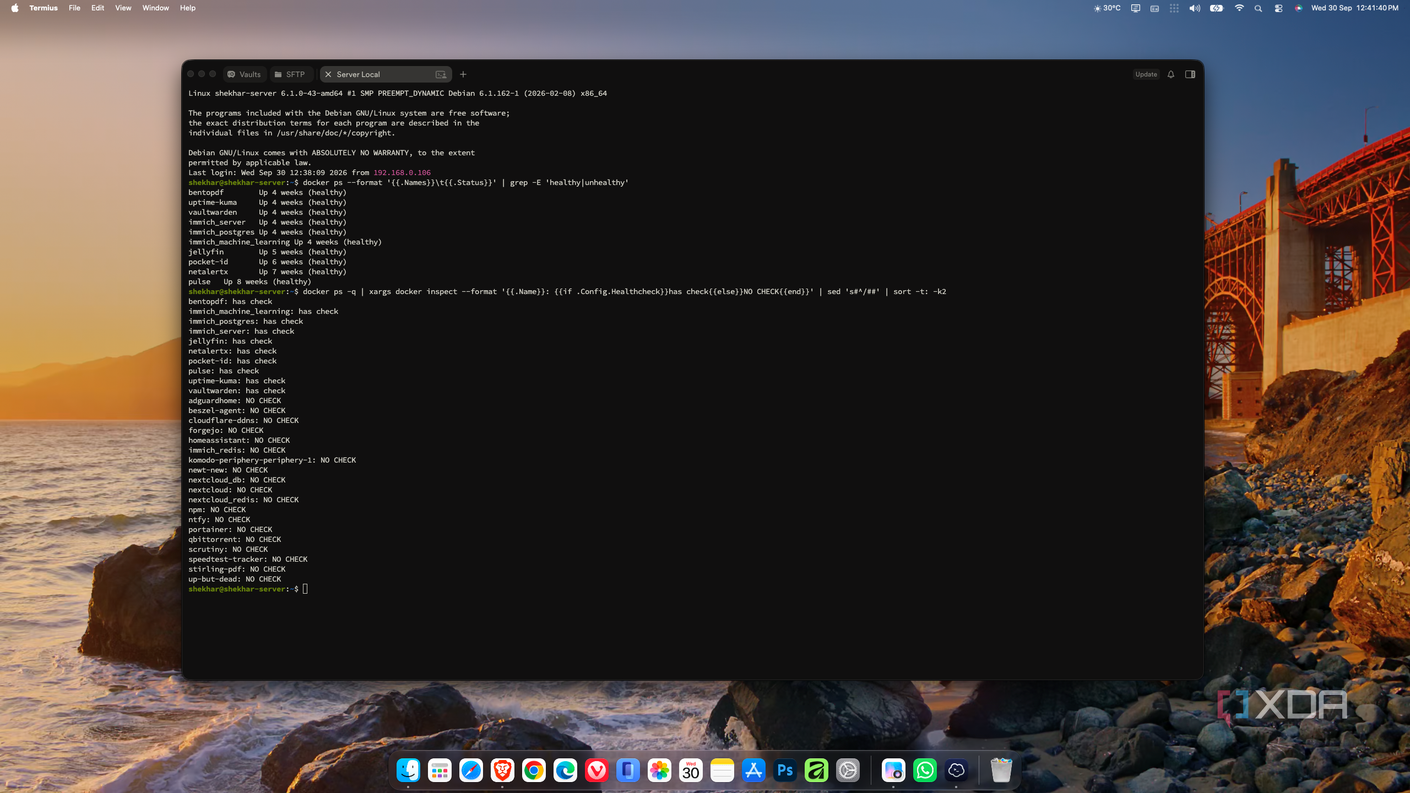
Прежде чем массово добавлять healthcheck ко всем сервисам, я проверил текущую ситуацию в своей инфраструктуре. Из двадцати восьми запущенных контейнеров десять уже имели встроенные проверки здоровья, которые работали на протяжении многих недель. Оставшиеся восемьнадцать контейнеров, включая Nextcloud, не имели никаких дополнительных параметров контроля.
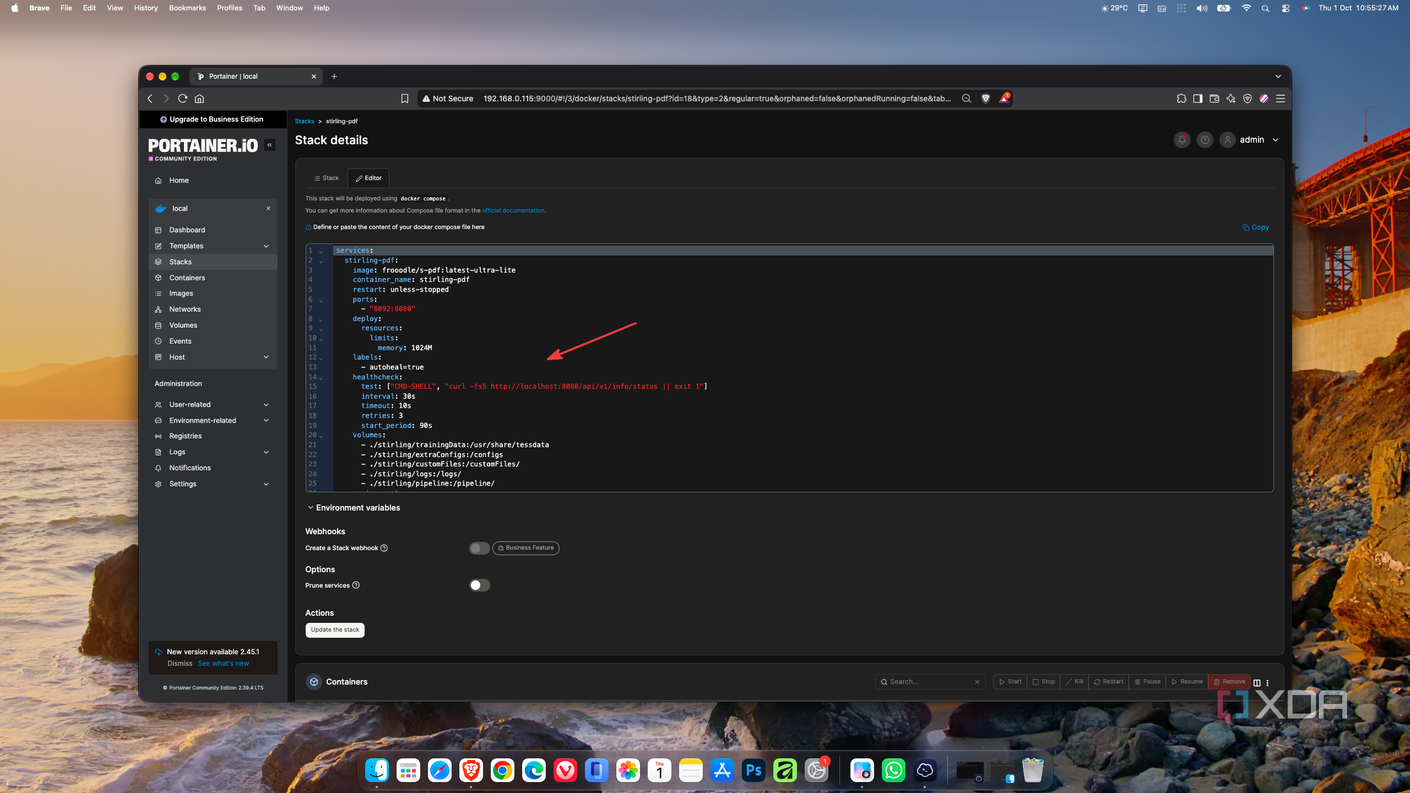
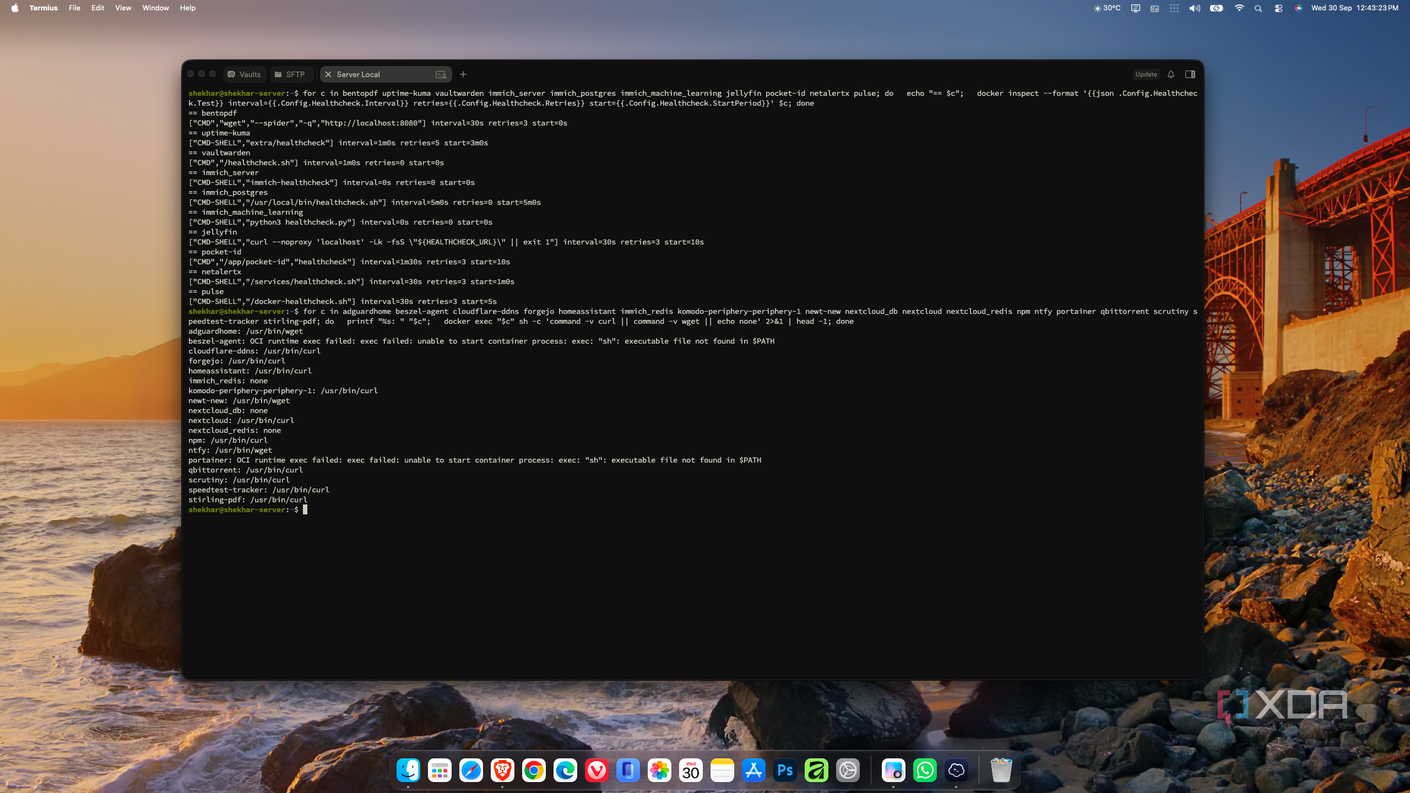
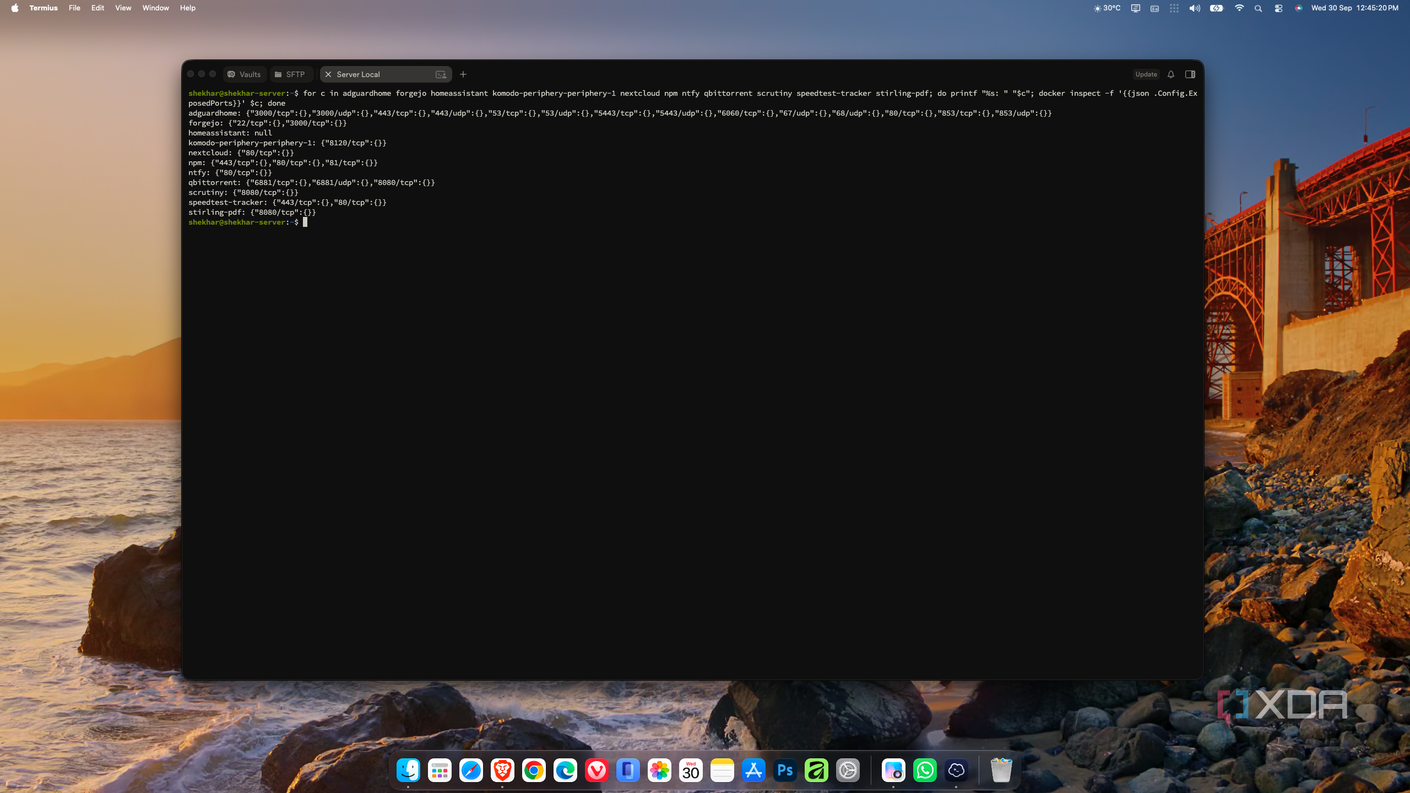
Используя команды docker inspect и цикл со скриптами, я выяснил интервалы, количество попыток и команды проверки для настроенных контейнеров. Большинство из них фиксировали сбой через девяносто секунд (30 секунд интервала умноженные на 3 попытки), а некоторые, например Immich, требовали около пятнадцати минут на обнаружение проблемы. Для остальных контейнеров я проверил наличие утилит curl или wget внутри окружения, после чего приступил к доработке конфигурационных файлов Docker Compose.
Автоматическое восстановление с помощью системного наблюдателя
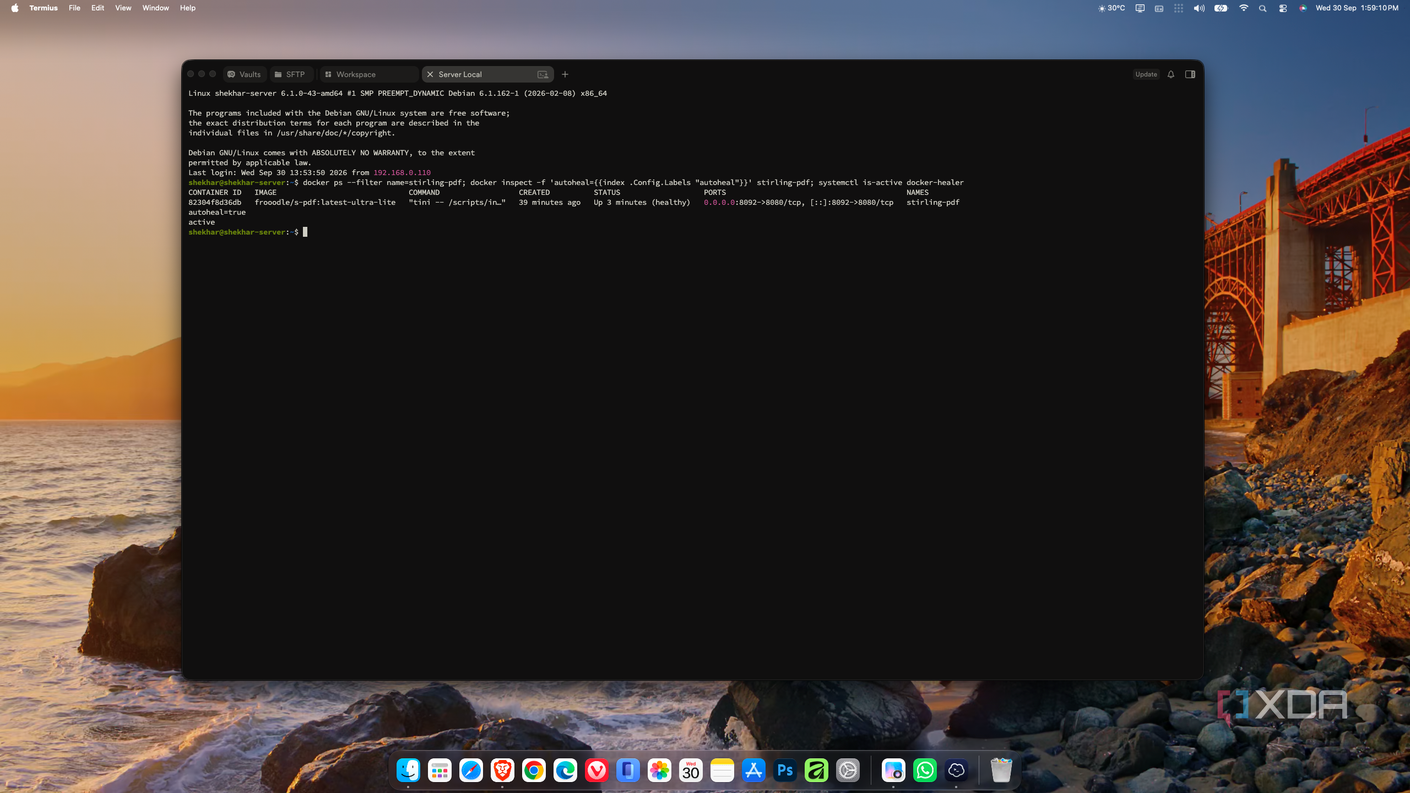
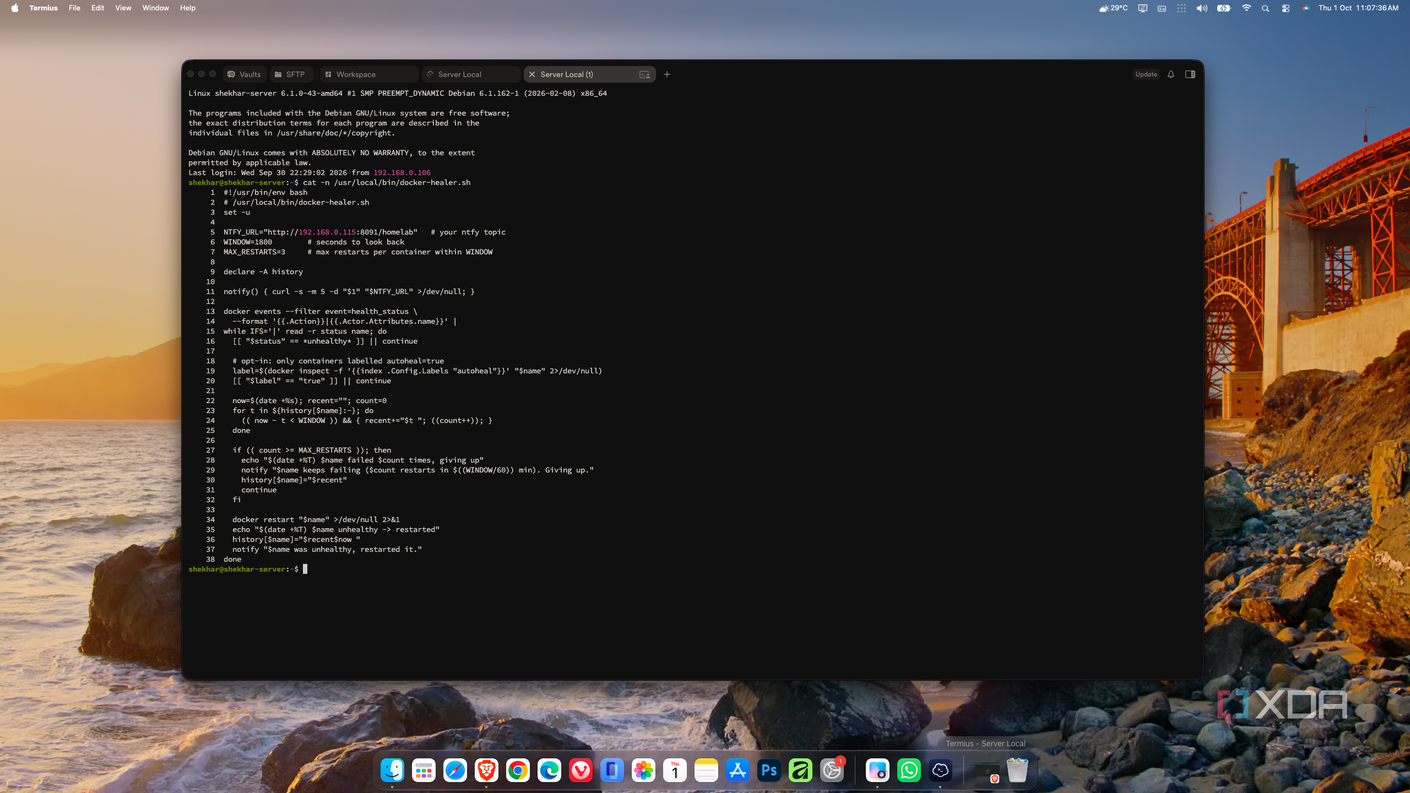
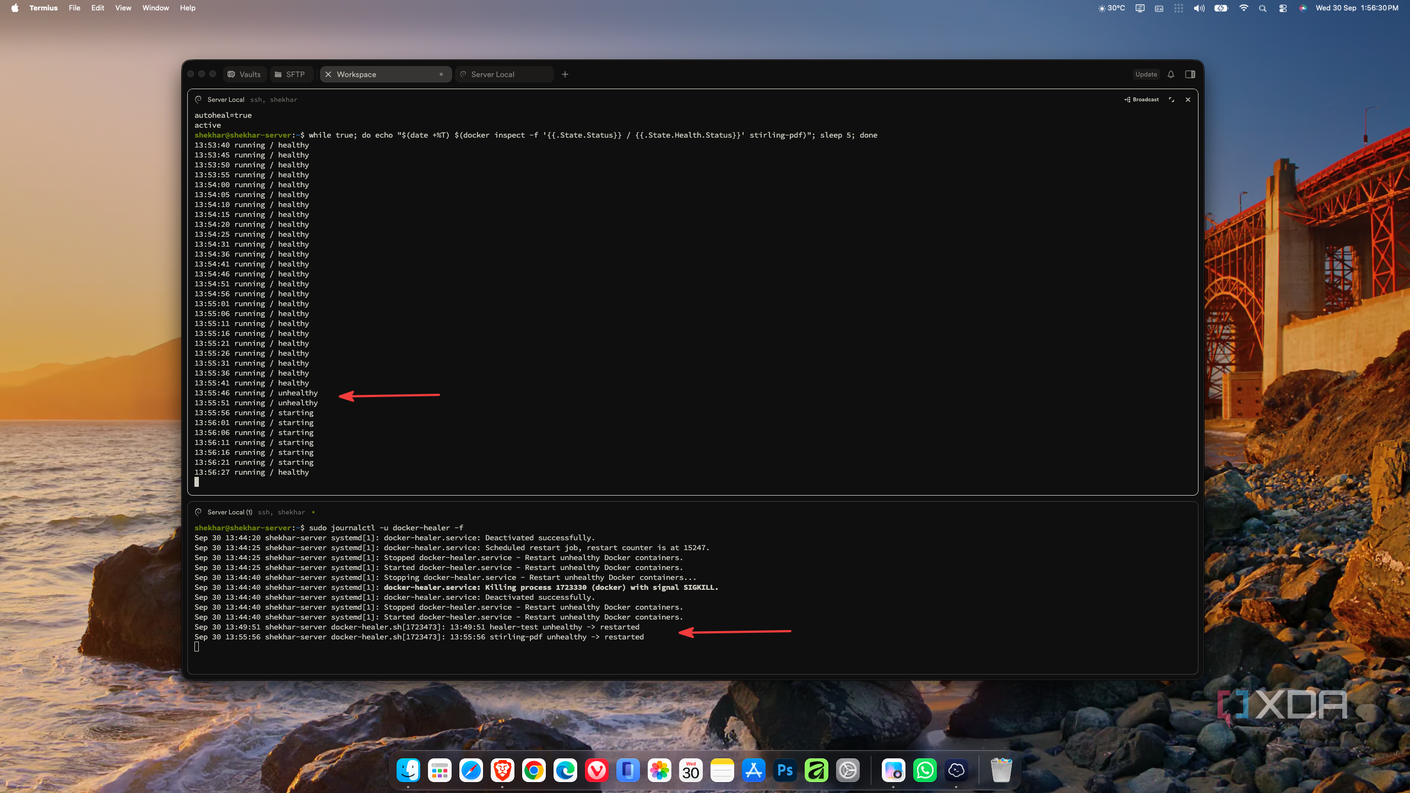
Обнаружение проблем и добавление проверок — это лишь половина дела, поэтому я создал специальный фоновый скрипт, работающий непрерывно под управлением systemd. Этот инструмент отслеживает поток событий health-status от Docker. Если статус меняется на «нездоровый» (unhealthy), скрипт автоматически перезапускает проблемный контейнер, предварительно убедившись по специальной метке autoheal=true, что это разрешено для данного сервиса.
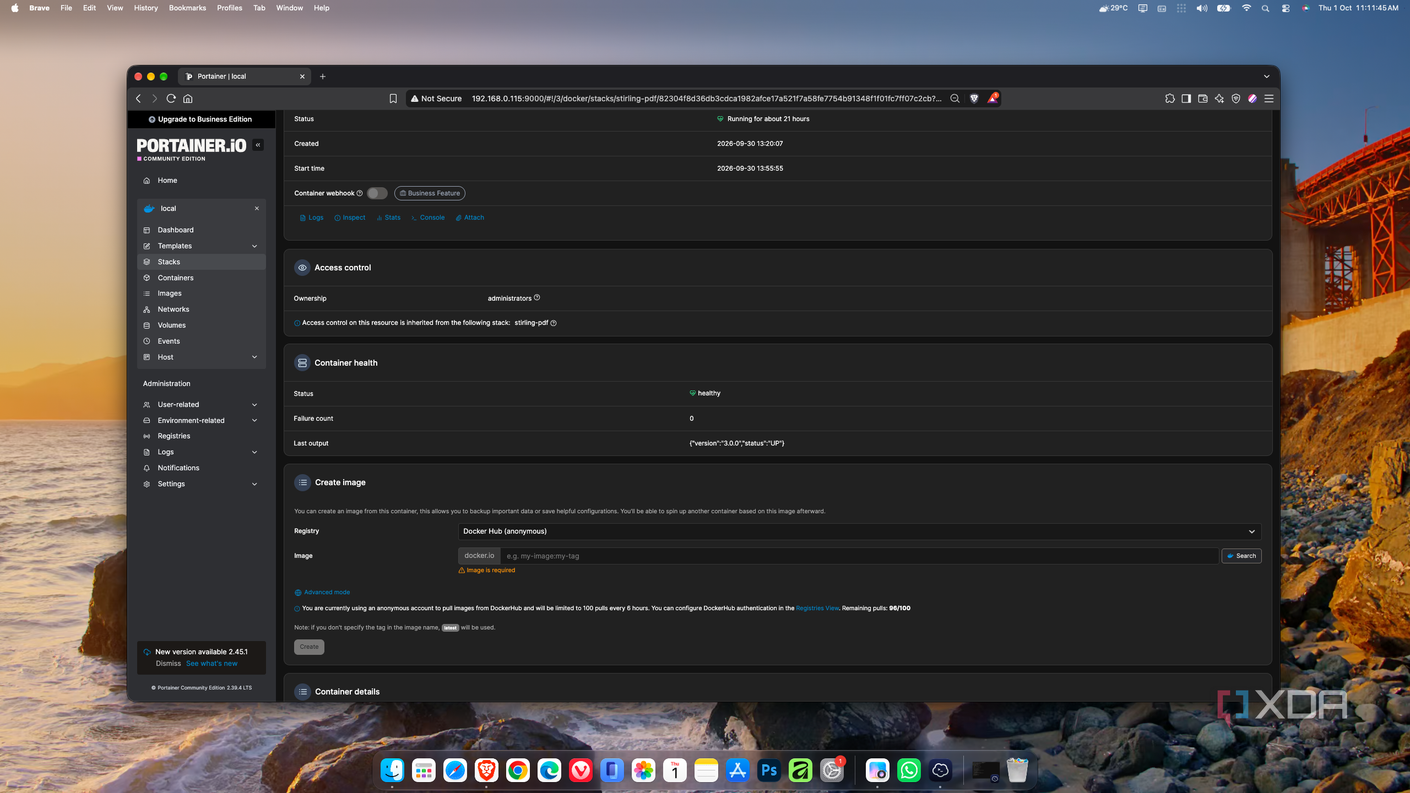
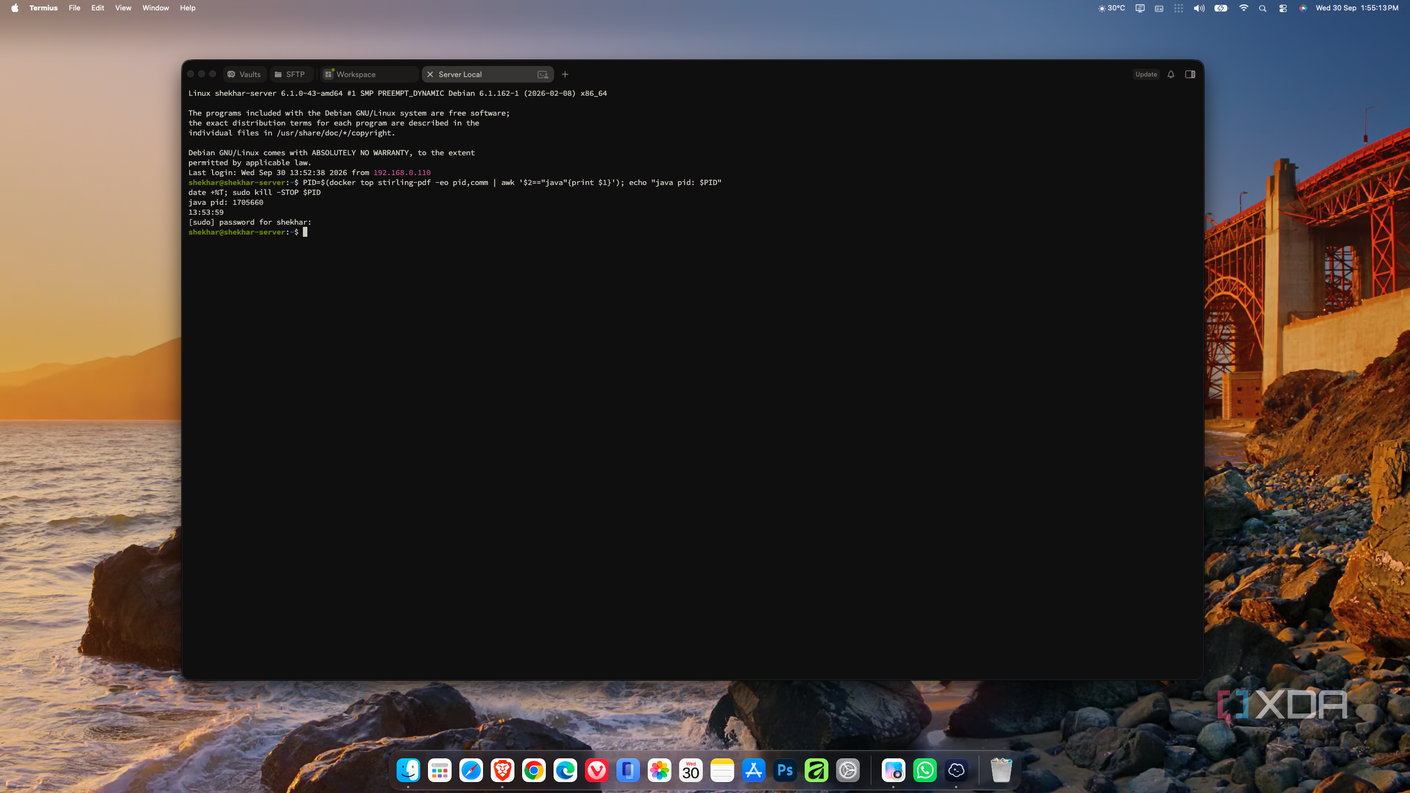
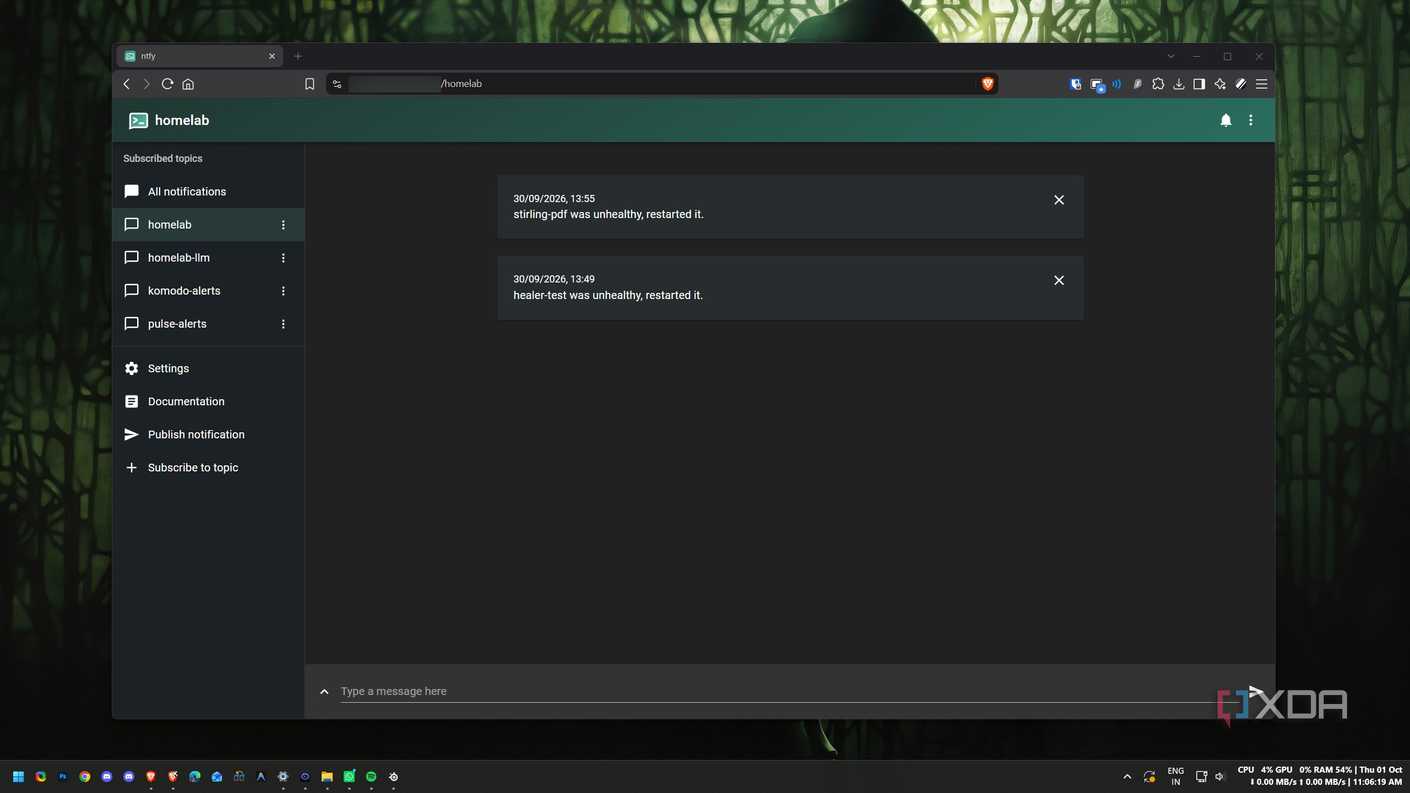
Для предотвращения бесконечных циклов перезагрузки я ограничил максимальное число перезапусков до трех раз в течение получасона, а все уведомления отправляю через сервис ntfy. Когда я искусственно заморозил Java-процесс в контейнере Stirling PDF, система зафиксировала проблему примерно через полторы минуты, перезапустила службу и вернула ее в рабочий статус всего за пару минут.
Дальнейшие перспективы и выводы
Важно понимать, что автоматический перезапуск не равен интеллектуальному исцелению конфигураций. Если база данных требует ручной миграции, скрипт сможет лишь бесконечно перезапускать контейнер без решения первопричины. Тем не менее, даже в таком полуфабрикатном виде этот подход значительно повышает стабильность домашней лаборатории.
В будущем я планирую доработать этот скрипт, интегрировав локальную языковую модель для более глубокой диагностики ошибок. Но даже сейчас внедрение корректных проверок здоровья и простого механизма восстановления избавило меня от необходимости вручную поднимать упавшие службы.
