
Мой блог
GitHub запустил Project HydraFusion: мультимодельная оркестровка задач в Copilot CLI

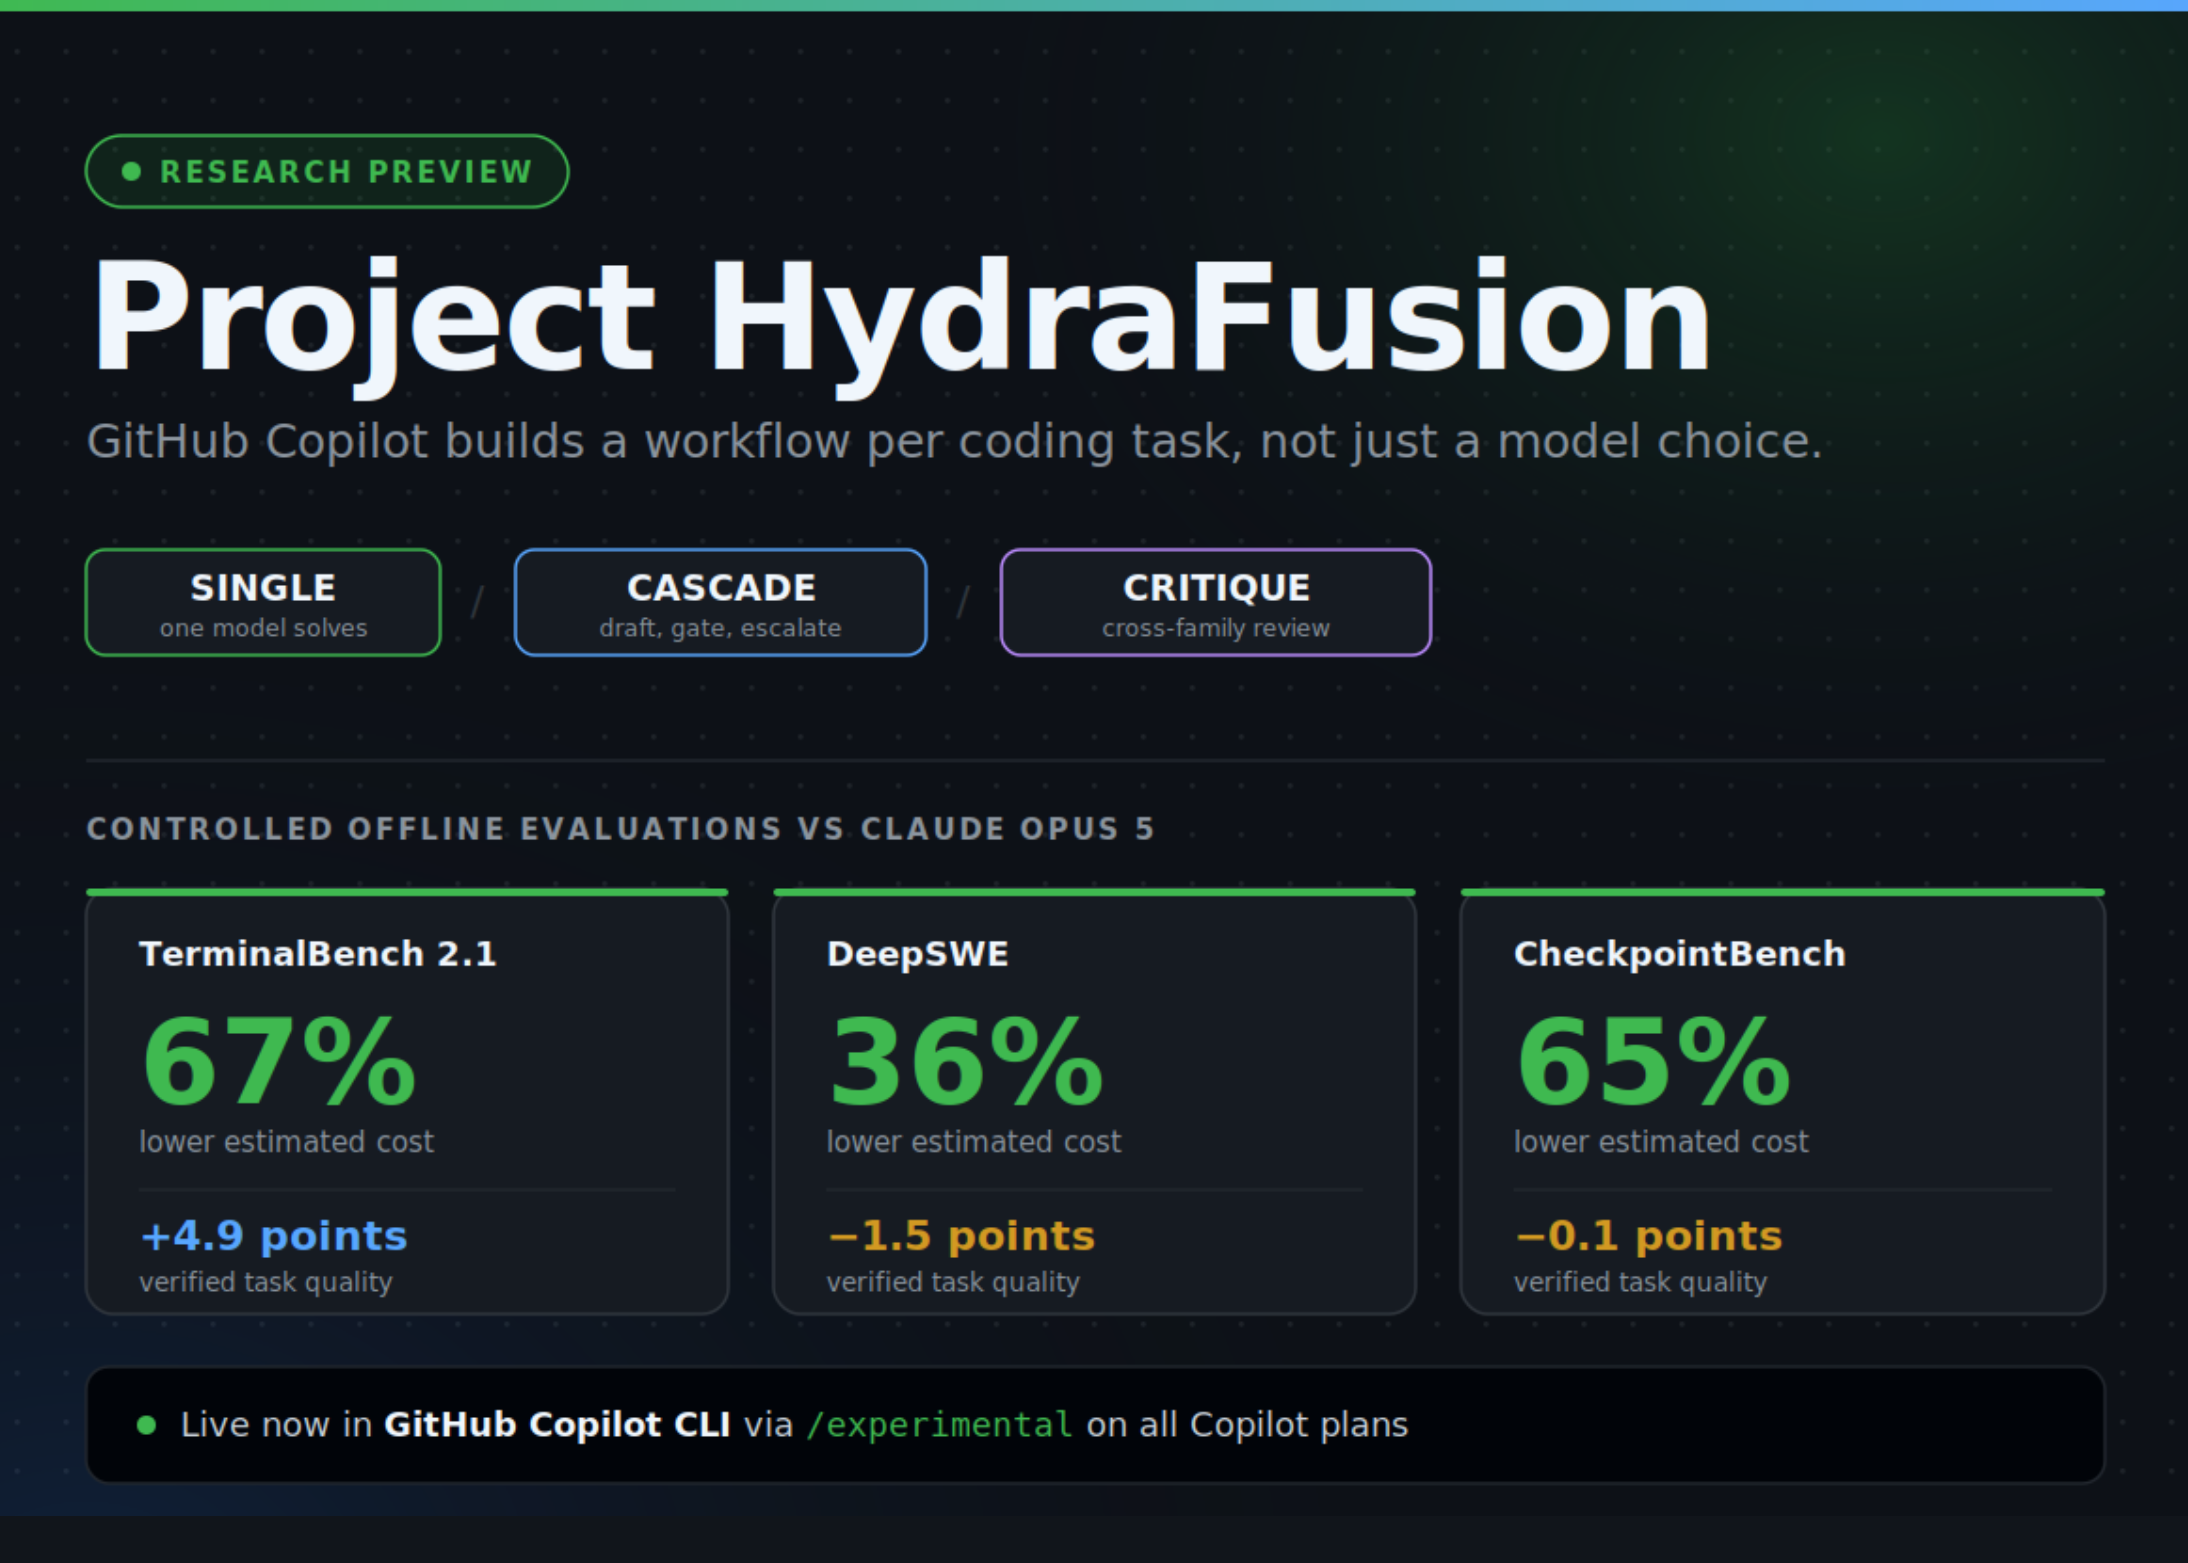
Разработчики GitHub представили исследовательский проект Project HydraFusion — новую систему динамической оркестровки нейросетей прямо во время выполнения задач. Если раньше выбор ИИ-модели был статичной настройкой или разовым действием, то HydraFusion меняет сам подход: под каждый конкретный запрос в терминале Copilot CLI формируется уникальный план исполнения. Система может составить первичный черновик с помощью одной модели, передать его на критический разбор другой, а при неудовлетворительном результате автоматически подключить более мощный алгоритм рассуждений.
Я внимательно изучил этот релиз, и должен отметить: перед нами постепенный уход от парадигмы «одна задача — одна нейросеть». Все задействованные модели могут принадлежать разным провайдерам, а сам разработчик лишь единожды выбирает HydraFusion как целевой режим. На текущий момент нововведение доступно в формате Research Preview исключительно внутри интерфейса GitHub Copilot CLI для пользователей всех тарифных планов Copilot. Чтобы активировать функцию, достаточно обновить утилиту командой /update, включить экспериментальные опции через /experimental on, а затем в меню /model выбрать HydraFusion (Research Preview). Списание средств и токенов происходит по стандартным тарифам тех моделей, которые реально привлекались к решению задачи.
Как устроена оркестровка и принцип работы системы
В начале 2026 года GitHub запустил функцию автоматического выбора моделей (Auto model selection), которая подбирала одну наиболее подходящую нейросеть под конкретный текст запроса. Project HydraFusion сделал шаг дальше, превратив построение рабочего процесса в классическую задачу оптимизации.
Под капотом система постоянно анализирует сигналы возможностей доступных моделей по четырем ключевым направлениям: логические рассуждения (reasoning), генерация кода, отладка и умение работать с внешними инструментами. На основе этого анализа HydraFusion выбирает наименее затратный и наименее сложный сценарий, способный гарантированно преодолеть установленную планку качества. Дополнительные вызовы более дорогих и медленных нейросетей происходят только в тех случаях, когда это объективно оправдано сложностью задачи.
Три основных паттерна исполнения задач
На этапе публичного исследования HydraFusion умеет комбинировать работу нейросетей по трем базовым архитектурным паттернам:
- Single (Одиночный режим): Запрос полностью обрабатывается одной выбранной нейросетью. Это максимальная скорость и минимальные задержки для простых или стандартных рутинных операций.
- Cascade (Каскадная обработка): Экономичная и быстрая модель создает первичный вариант решения. Затем специальный «гейт качества» (Quality Gate) оценивает результат. Если проверка пройдена, код отдается пользователю. Если возникли сомнения или ошибки, задача перенаправляется более мощной логической модели.
- Critique (Рецензирование и критика): Первая нейросеть пишет черновик кода, а независимый арбитр из другого семейства моделей анализирует его в режиме «только для чтения» (по принципу парного программирования или каучуковой уточки). Получив конструктивную критику, исходная модель производит однократную корректировку.
Каждый из этих паттернов предлагает собственный баланс между скоростью, итоговой стоимостью и качеством. Схема Single экономит время, Cascade оставляет открытым путь к глубинному анализу без переплаты за простые запросы, а Critique добавляет независимый взгляд со стороны, что критично при поиске скрытых багов.
Архитектурные ограничения и защитные механизмы
Инженеры GitHub спроектировали средовый интерпретатор HydraFusion с учетом строгих требований к работе с локальными и корпоративными репозиториями. В основу легли пять ключевых принципов надежности:
- Прозрачный учет операций: Система ведет полную детализацию каждого шага — от черновой генерации и рецензирования до повторных попыток и переключений на резервные модели.
- Ограничение времени выполнения: Каждое звено в цепи вызовов имеет жестко заданные таймауты и возможность мгновенной отмены процесса пользователем.
- Изоляция критиков: Модели-рецензенты запускаются в изолированном контексте без доступа к инструментам модификации кода и не могут напрямую менять файлы в репозитории.
- Безопасное приведение изменений: Если цепочка выполнения прервана или не прошла валидацию, в репозиторий не вносится ни одна строчка патча.
- Предварительная проверка маршрутов: Перед стартом генерации система проверяет доступность моделей, привязки API и готовность резервных сценариев.
Для разработчика вся эта сложность остается скрытой: в терминале он получает один единый, выверенный ответ и изолированный набор изменений, готовый к применению. При этом внутри рантайма фиксируются точные метрики задержки, стоимости и состояния каждого шага.
Результаты тестов и бенчмарков
Команда GitHub протестировала фиксированные стратегии HydraFusion на трех популярных агентурных бенчмарках для программирования. В качестве базовых ориентиров использовали модели Claude Opus 5 и GPT-5.6 Sol со средним уровнем рассуждений (medium reasoning level). Все показатели рассчитывались относительно производительности Opus 5:
- TerminalBench 2.1: Экономия стоимости составила 67%, при этом качество решения задач выросло на +4.9 пункта по сравнению с базовой Opus 5.
- DeepSWE: Снижение затрат на 36% при несущественном снижении точности всего на −1.5 пункта.
- CheckpointBench: Снижение расходов на 65% при практически идентичном качестве (разница составляет всего −0.1 пункта).
Стоит отдельно упомянуть CheckpointBench — это внутренний тестовый набор GitHub, собранный из реальных сессий пользователей Copilot и привязанный к неизменяемым коммитам в публичных репозиториях, что обеспечивает 100% воспроизводимость результатов.
Главные выводы и практическое значение
Проект HydraFusion наглядно демонстрирует, куда движется разработка с помощью искусственного интеллекта. Вместо поиска «идеальной универсальной модели» мы переходим к гибкой оркестровке узкоспециализированных или разноуровневых нейросетей под каждую конкретную задачу.
Я рекомендую опробовать этот режим всем, кто активно пользуется консольным клиентом Copilot CLI. Возможность получить прирост качества на сложных тасках и одновременно сократить расходы на простые операции — это именно то, чего не хватало продвинутым разработчикам.
Источник: www.marktechpost.com
