
Мой блог
Google представила Gemini 3.8 Live и Live Extended Thinking для создания диалоговых ИИ-агентов

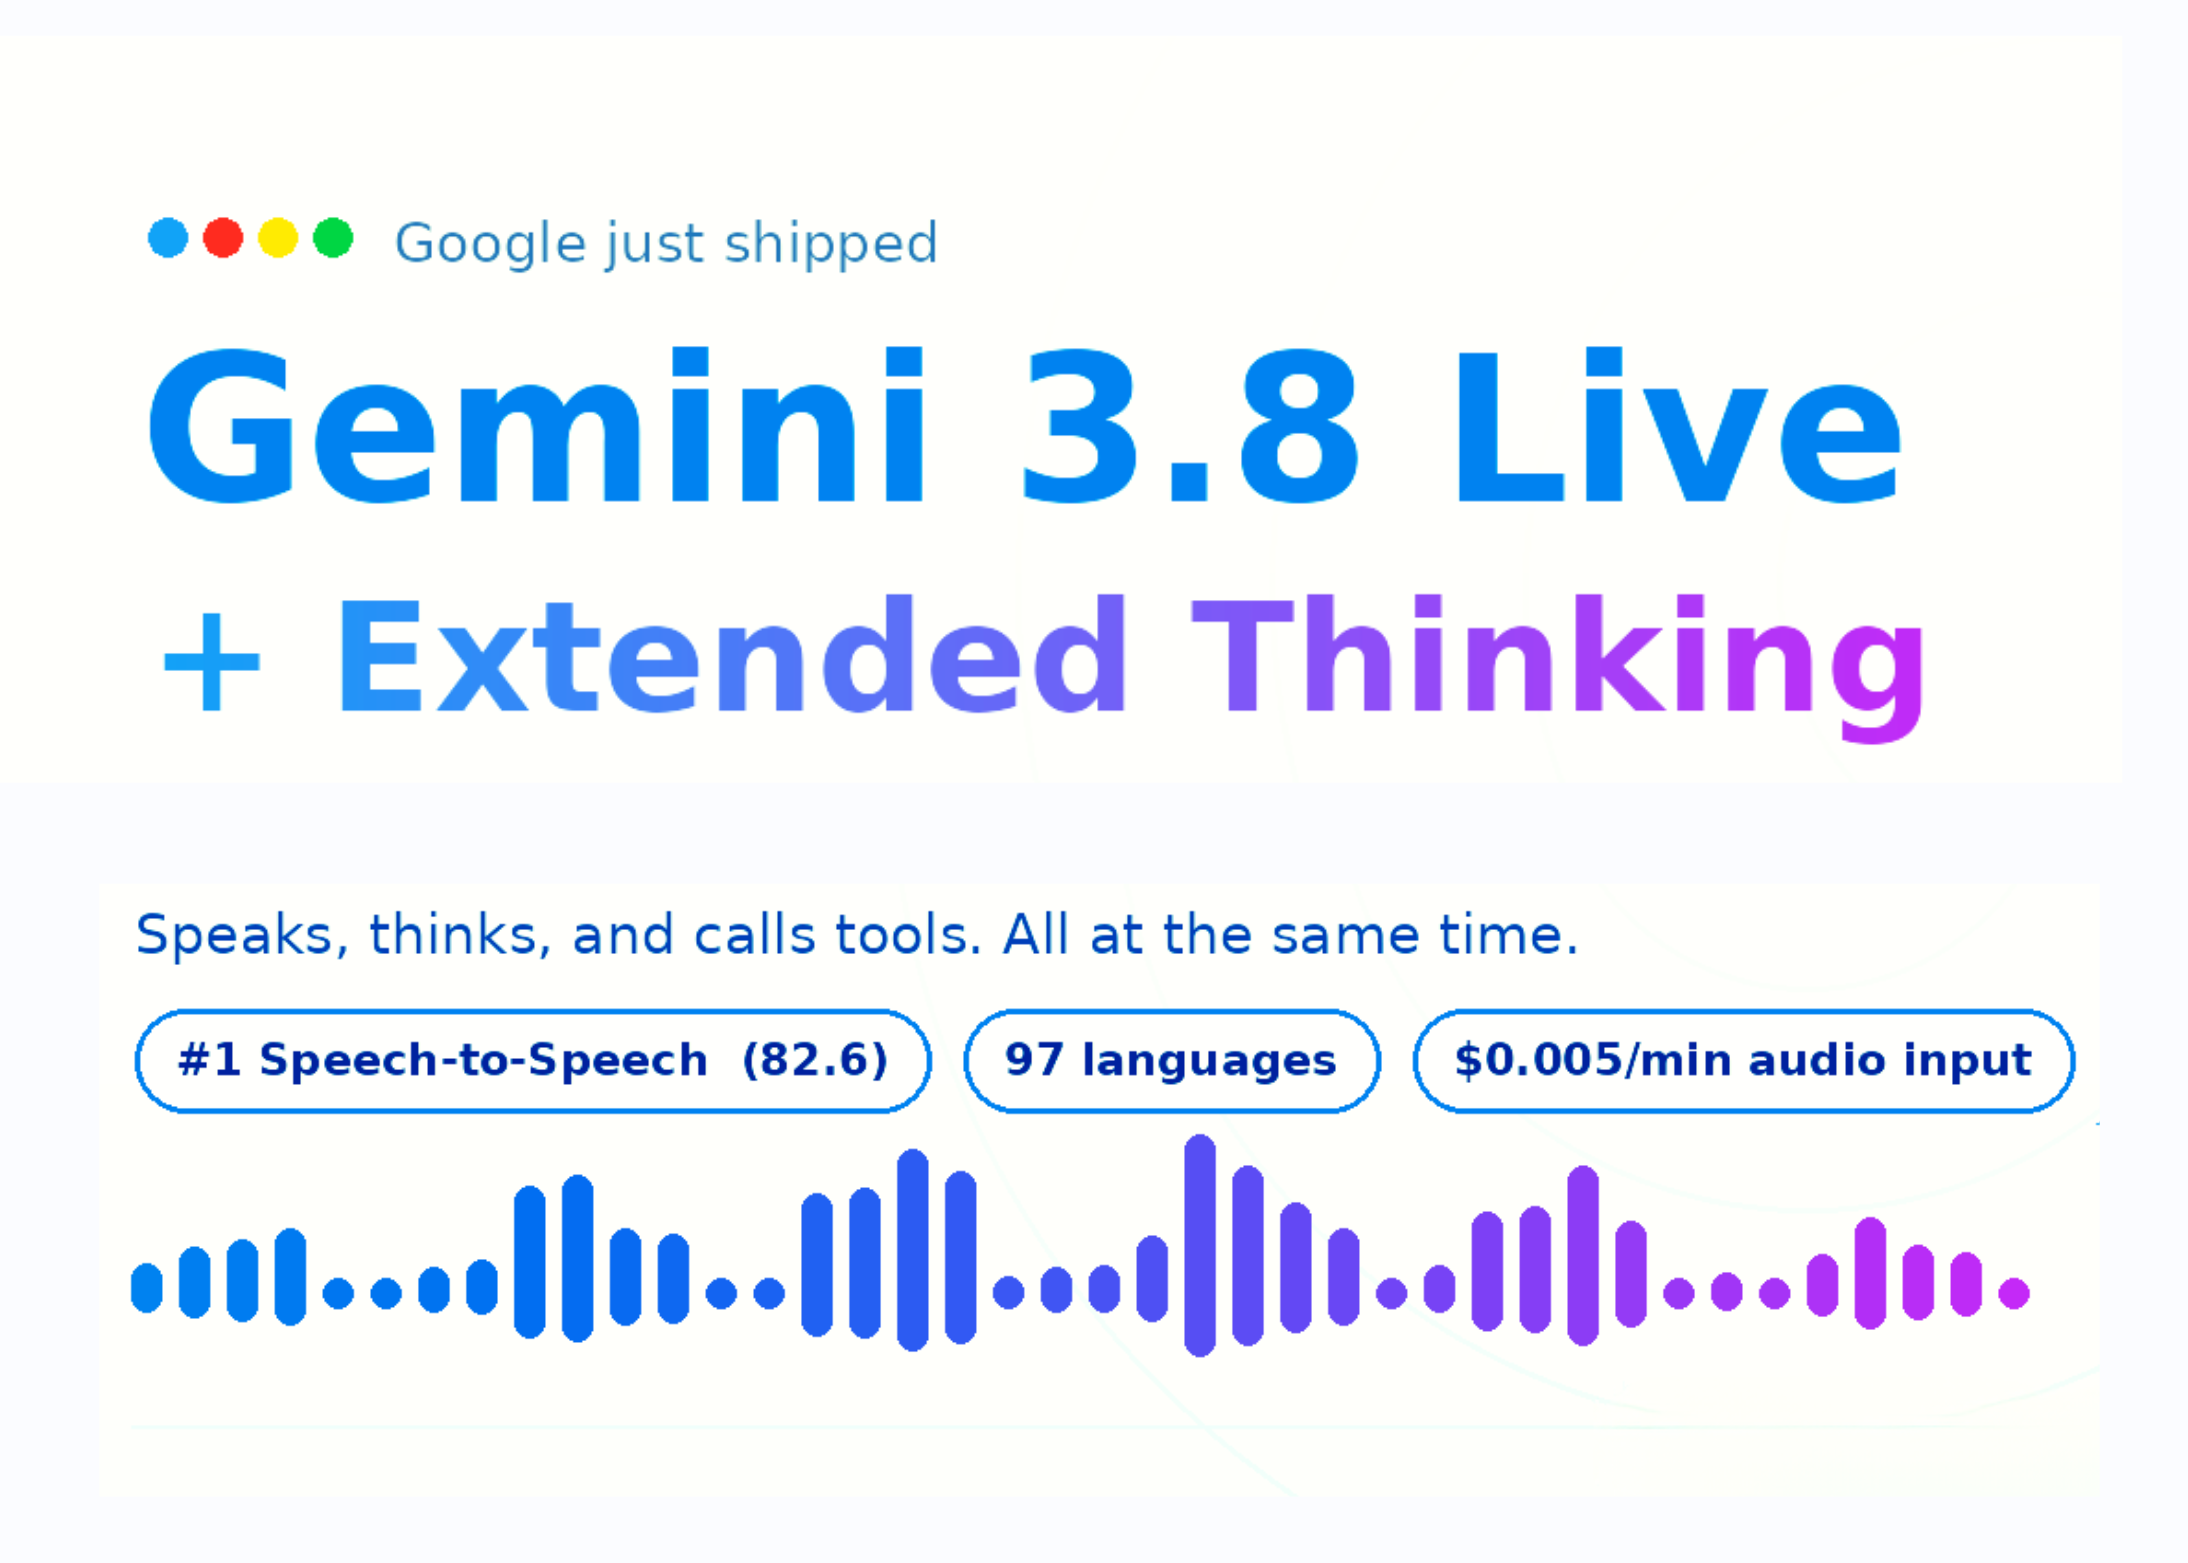
Компания Google презентовала очередное важное обновление своей экосистемы мультимодального искусственного интеллекта, официально представив модели Gemini 3.8 Live и Gemini 3.8 Live Extended Thinking. Это самые продвинутые диалоговые модели IT-гиганта на сегодняшний день, созданные по схеме «речь в речь» (speech-to-speech) и рассчитанные на интеграцию в голосовые агенты промышленного уровня. Новый релиз стал органичным продолжением развития аудиолинейки Gemini Audio, в рамках которой месяц назад была анонсирована модель Gemini 3.5 Transcribe.
Главная цель, которую перед собой ставили инженеры Google, — решить фундаментальную проблему современных голосовых ассистентов. Стандартные боты часто «застывают» или разрывают диалоговую нить, когда им требуется выполнить сложную логическую задачу или обратиться к внешним инструментам. Модели Gemini 3.8 созданы для того, чтобы ИИ мог производить вычисления, рассуждать и вызывать API прямо во время речи, сохраняя естественный темп и плавность беседы.
Модели уже полностью готовы к коммерческому развертыванию. На текущий момент они доступны для разработчиков через Gemini Live API и в консоли Google AI Studio. Важно учитывать, что оба решения распространяются исключительно по облачной модели (hosted models) без публикации открытых весов, поэтому запустить их локально на собственных мощностях не получится.
Что именно представила Google: двухкомпонентная линейка Gemini 3.8 Live
Релиз включает две специализированные нейросети, каждая из которых решает свой спектр задач:
- Gemini 3.8 Live: базовая модель, спроектированная с акцентом на масштабируемость и высокую экономическую эффективность. Она обеспечивает сочетание диалогового интеллекта, плавной речи и визуального заземления (visual grounding).
- Gemini 3.8 Live Extended Thinking: продвинутая модификация для выполнения задач повышенной сложности. Она добавляет функцию глубокого многошагового рассуждения прямо в процессе генерации ответа.
Google позиционирует новейшие нейросети как технологическую альтернативу традиционным каскадным системам. В классическом каскаде обработка голоса делится на три последовательных этапа: распознавание речи (ASR), передача текста в большую языковую модель (LLM) и последующий синтез ответа через движок речи (TTS). Переход на нативную архитектуру «speech-to-speech» устраняет цепочку лишних задержек и исключает потерю эмоционально-интонационного контекста.
Результаты в бенчмарках и независимых тестах
Эффективность релиза подтверждается результатами в серии индустриальных тестов и независимых рейтингов:
- Лидерство в Speech to Speech Quality Index: В рейтинге исследовательского агентства Artificial Analysis модель Gemini 3.8 Live Extended Thinking заняла безусловное первое место с результатом 82,6 балла.
- Тесты агентских сценариев: В бенчмарке τ-Voice модель продемонстрировала 68,6% успешного выполнения автономных задач, а в специализированном банковском тесте Sierra τ-Voice-banking набрала 35,1%.
- Логический анализ аудио: В тесте Big Bench Audio, проверяющем способность модели рассуждать при работе со звуковым контентом, версия Extended Thinking показала точность в 97,7%.
- Оценка предпочтений пользователей: Базовая версия Gemini 3.8 Live завоевала вторую строчку в независимом слепом тестировании Speech Agent Arena.
- Баланс точности и качества: По данным ServiceNow EVA-Bench, модели существенно сдвинули границу Парето (Pareto Frontier) для сложных рабочих процессов, продемонстрировав оптимальное соотношение точности выполнения инструкций и естественного диалогового поведения при тестировании через Live API на платформе Gemini Enterprise Agent.
Ключевые возможности Live API для разработчиков
Интерфейс Live API открывает доступ к пяти ключевым функциям новых моделей, критически важным для создания полноценных голосовых продуктов:
- Асинхронный вызов функций (Asynchronous function calling): Модель выполняет внешние запросы к API и вызовы инструментов в фоновом режиме, продолжая при этом непрерывно потоковать голосовой ответ пользователю.
- Визуальный контекст (Visual context): Поддерживается обработка видео и изображений практически в реальном времени. Голосовой агент может ориентироваться не только на слух, но и понимать зрительное окружение пользователя.
- Высокая точность обработки символов (Alphanumeric precision): Нейросеть корректно распознает и транслирует коды подтверждения, номера страховых полисов, артикулы и технические данные, где традиционные голосовые движки часто допускают ошибки.
- Мультиязычность и работа с акцентами: Система автоматически определяет язык общения и бесшовно переключается между 97 поддерживаемыми языками непосредственно в ходе разговора, сохраняя естественность акцента.
- Инкрементальное обновление контента: Модель способна объединять потоковое аудио реального времени со структурированными базами данных для выдачи актуальных контекстных ответов.
Особенности режима Extended Thinking
Режим настраиваемого фонового мышления (Extended Thinking) кардинально меняет логику работы с длинными задачами. Модель умеет одновременно анализировать проблему и продолжать диалог. При получении сложной команды она использует промежуточные вербальные маркеры (например, реплику «Сейчас я проверю эти данные»), после чего подробно озвучивает ход выполнения каждого шага операции.
В демонстрационных примерах Google показала, как система способна на лету преобразовывать рукописный набросок интерфейса и устные указания пользователя в готовые рабочие компоненты для React, а также координировать многоэтапные процессы бронирования с учётом множества условий.
Стоимость, инфраструктура и экосистема интеграций
Тарификация работы моделей в рамках Gemini Live API унифицирована и рассчитывается по следующим ставкам:
- Входящий аудиопоток: $0.005 за одну минуту (из расчета $3 за 1 миллион входных токенов).
- Исходящий аудиопоток: $0.018 за одну минуту (из расчета $12 за 1 миллион выходных токенов).
Для создания полноценных сервисов разработчики могут использовать готовые партнерские интеграции. Потоковую инфраструктуру реального времени поддерживают платформы Agora, Fishjam, LangChain, LiveKit, Pipecat, Vercel и Vision Agents. В число корпоративных партнеров, уже внедряющих новые модели, вошли компании Salesforce, Genspark и Lumeris, отметившие минимальный уровень задержки, естественность речи и высокую надежность вызова функций. Готовые примеры кода и приложений опубликованы в репозиториях на GitHub.
Также стоит отметить аспект безопасности: весь голосовой поток, создаваемый моделями Gemini 3.8 Live, маркируется цифровым незаметным водяным знаком SynthID от Google DeepMind, что позволяет однозначно идентифицировать сгенерированный нейросетью звук.
Главные выводы и перспективы внедрения
С выходом Gemini 3.8 Live и 3.8 Live Extended Thinking мы видим переход голосовых ассистентов от простых скриптовых систем к настоящим автономным ИИ-агентам. Я отмечу ключевые моменты, на которые стоит обратить внимание при развертывании:
- Первое место в качестве речи по версии Artificial Analysis (82.6 балла) и высокая точность в агентских тестах τ-Voice и Big Bench Audio.
- Фоновое исполнение инструментальных задач (tool calling) без прерывания естественного диалога.
- Прозрачная стоимость ($0.005/мин входящий поток, $0.018/мин исходящий) и нативная поддержка 97 языков.
- Защита аудиоконтента с помощью водяных знаков SynthID.
Попробовать возможности новых моделей в собственных проектах можно уже сейчас — они доступны для тестирования в Google AI Studio и работы через Live API.
Источник: www.marktechpost.com
