Мой блог
ИИ-спам и обновления Google: как находить дубликаты страниц

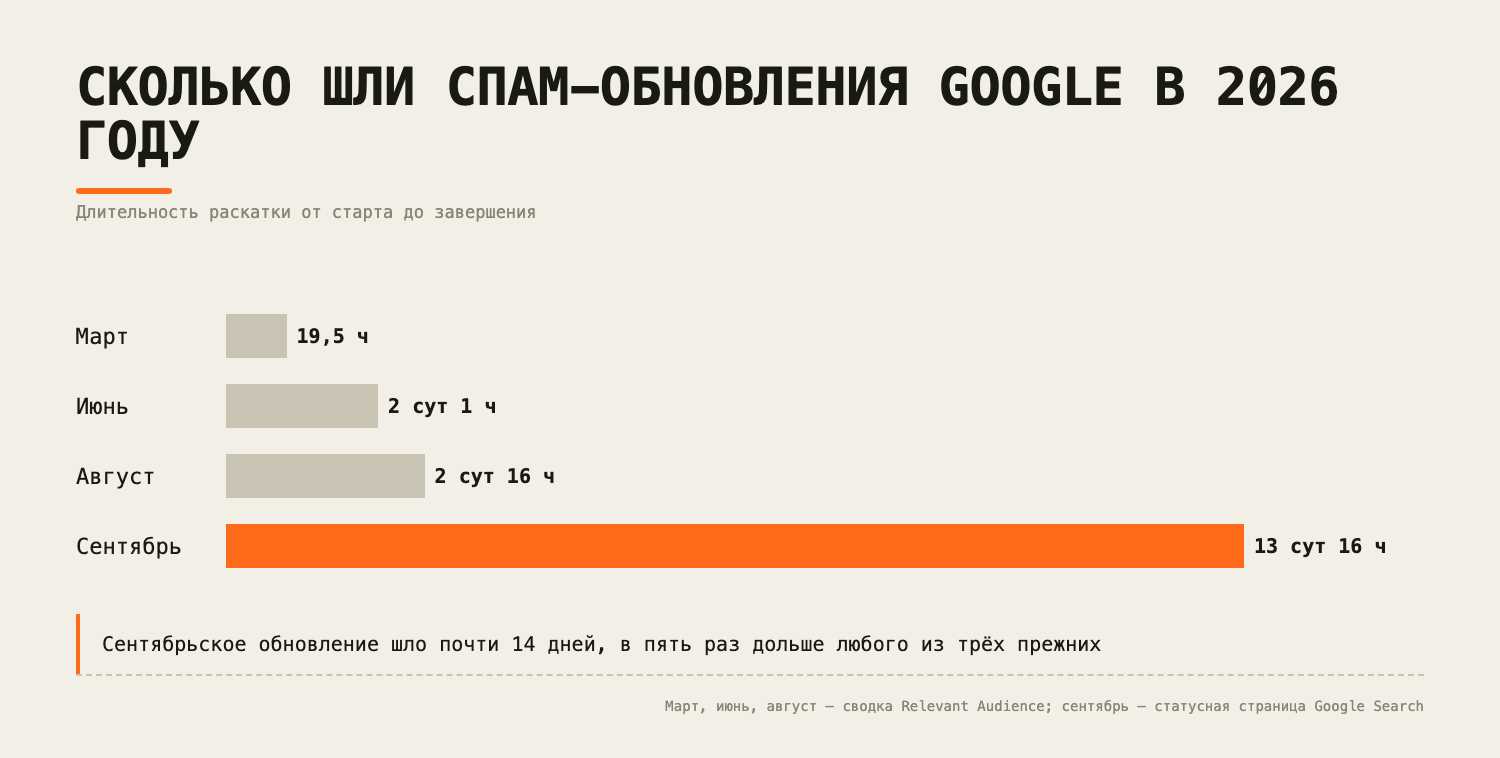
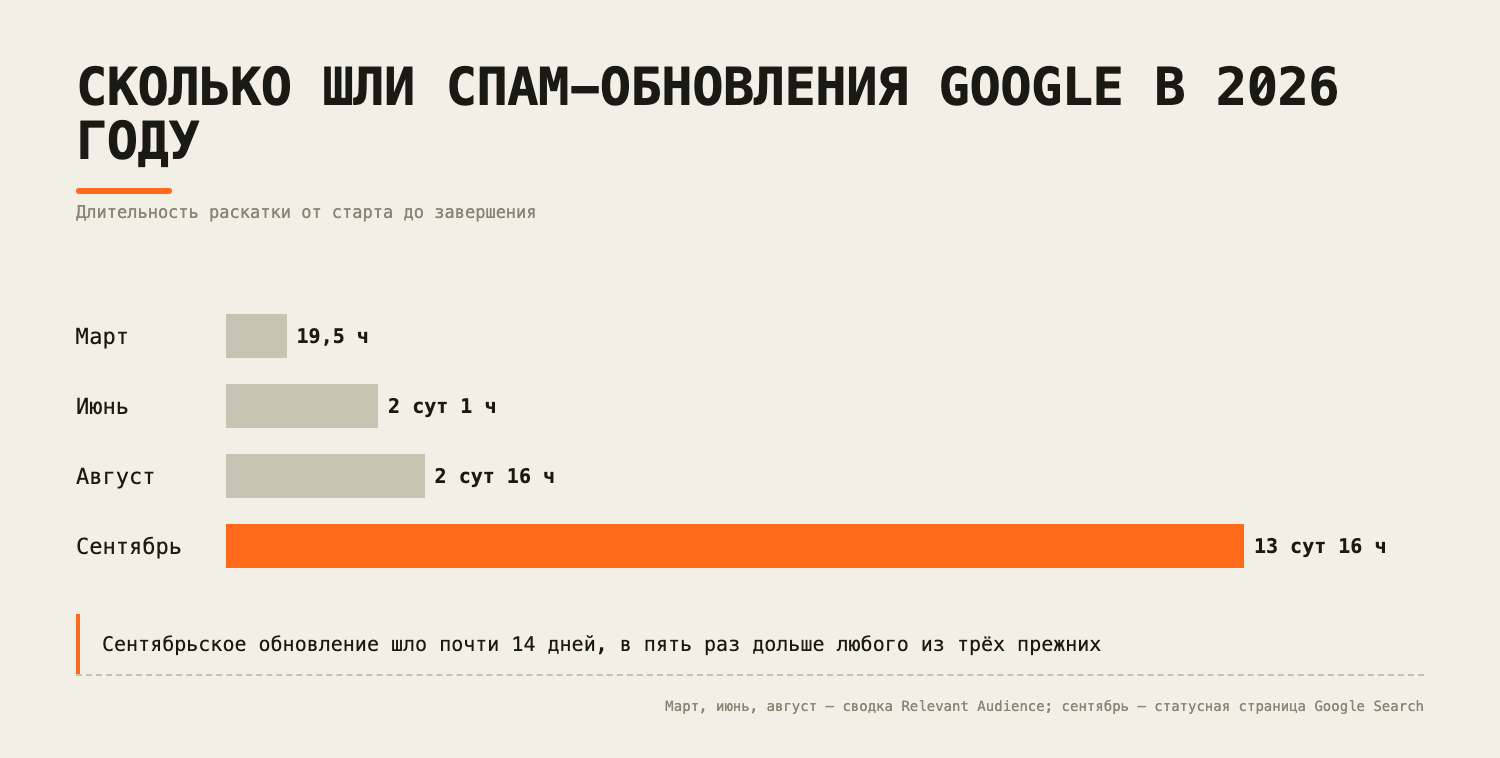
Сентябрьское обновление алгоритмов Google, направленное на борьбу со спамом, продемонстрировало рекордную продолжительность, охватив период почти в две недели. На фоне активного внедрения нейросетей в создание контента веб-мастера сталкиваются с задачей контроля уникальности материалов. В условиях, когда алгоритмические пороги похожести не раскрываются поисковой системой напрямую, разработчики применяют специализированный анализ контента для выявления потенциального дублирования.
Подобный подход позволяет оценить степень сходства сгенерированных страниц и предотвратить санкции за автоматизированное массовое производство текстовых массивов.
Особенности сентябрьского обновления Google и скан контента
Запуск спам-обновления сопровождался стандартным предупреждением о том, что развертывание может занять до двух недель. Официальные источники охарактеризовали изменения как рутинную корректировку без введения принципиально новых правил. При этом представители компании отмечали увеличение частоты подобных апдейтов из-за общего роста объемов публикуемого в сети контента, хотя прямая привязка исключительно к искусственному интеллекту в официальных комментариях не фигурировала.
Действующие правила в отношении сгенерированных материалов опираются на оценку общей пользы для аудитории. Согласно политике компании, нарушение квалифицируется как создание избыточного массива страниц с целью манипуляции поисковой выдачей независимо от инструментов генерации. В то же время сторонние статистические исследования показывают разницу в индексации ресурсов с разной долей автоматизированного текста, хотя исследователи подчеркивают, что этот показатель отражает общую корреляцию, а не прямую причинно-следственную связь.
Методика измерения массового производства страниц
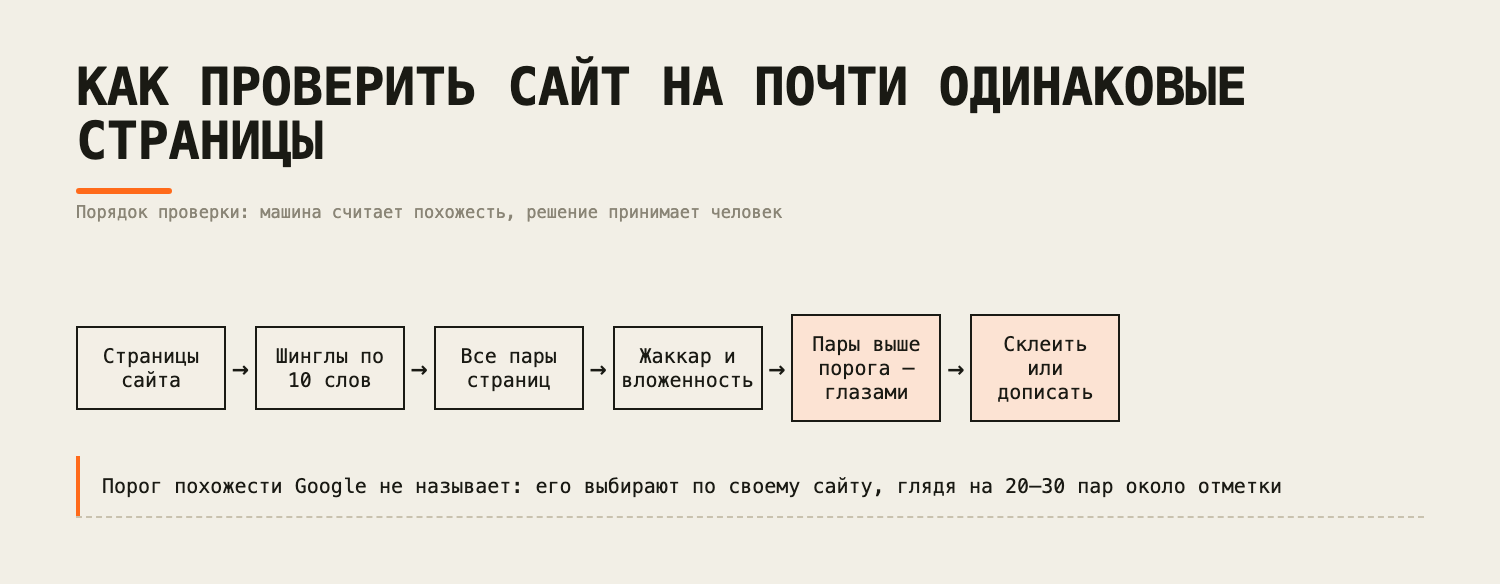
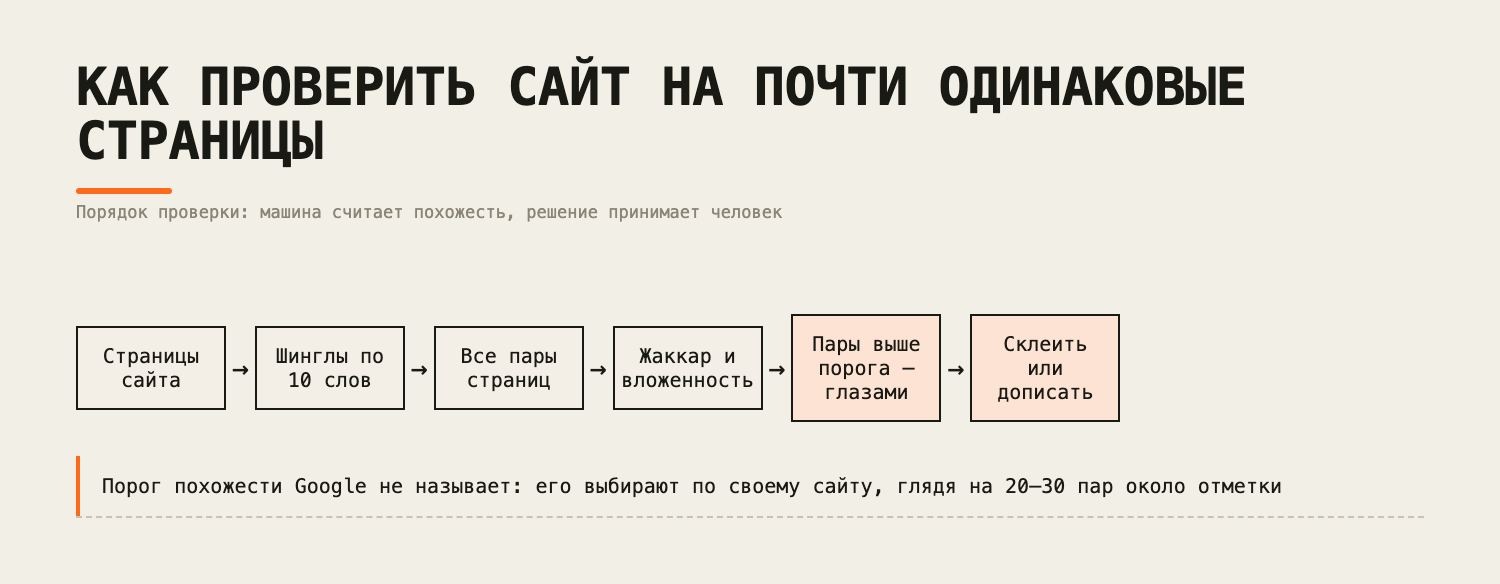
Для технической оценки контента применяется разбиение текста на пересекающиеся последовательности слов фиксированной длины — шинглы. Такой математический подход позволяет сопоставлять текстовые массивы с помощью двух ключевых метрик:
- Сходство Жаккара, определяющее отношение общих фрагментов к их общему числу в обеих сравниваемых документах;
- Вложенность, показывающая долю текстовых элементов одной страницы, которые присутствуют внутри другой.
Первая метрика удобна для симметричного парного сравнения, тогда как вторая эффективно выявляет короткие материалы, полностью интегрированные в более крупную структуру шаблона. Исторические исследования поисковых систем применяли определенные числовые коэффициенты для кластеризации массивов данных, однако поисковые роботы не используют единый публичный порог для выявления спама.
Проверка текстовых совпадений с помощью Python
Для практического поиска дубликатов используется программная обработка текстов. Ниже приведен пример скрипта на языке Python, который вычисляет шинглы и рассчитывает показатели сходства и вложенности для набора страниц:
import re
from itertools import combinations

def shingles(text, w=10):
    words = re.findall(r"\w+", text.lower())
    return {" ".join(words[i:i + w]) for i in range(len(words) - w + 1)}

def jaccard(a, b):
    return len(a & b) / max(len(a | b), 1)

def containment(a, b):
    return len(a & b) / max(len(a), 1)

sh = {url: shingles(text) for url, text in pages.items()}

for (u1, a), (u2, b) in combinations(sh.items(), 2):
    print(f"{u1:18} {u2:18} jaccard={jaccard(a, b):.2f} in={containment(a, b):.2f} out={containment(b, a):.2f}")
При тестировании синтетических примеров, таких как типовые страницы доставки для разных городов с минимальными текстовыми различиями, метрики показывают высокую степень вложенности при умеренном значении коэффициента Жаккара. Это подтверждает необходимость использования вложенности для поиска базовых шаблонов.
Настройка порогов и работа с найденными дублями
Перед запуском анализа необходимо исключить из обработки сквозные элементы сайта, такие как навигационные меню, подвалы и хлебные крошки, поскольку они искусственно завышают показатели совпадений. Для извлечения чистого контента применяются профильные библиотеки парсинга, а при работе с крупными порталами вместо прямого перебора пар задействуются хэш-функции MinHash.
Выбор пороговых значений осуществляется индивидуально для каждого ресурса. Рекомендуется изучить несколько десятков пар страниц, оказавшихся на границе выбранного значения, чтобы оценить реальное смысловое различие. Если обнаруженные группы страниц не содержат уникальной полезной информации для читателя, принимается решение об их объединении или доработке.
Полученные программным путем метрики фиксируют лишь технические совпадения текста, но не являются прямым доказательством нарушения правил поисковой системы. Итоговая оценка качества ресурса всегда зависит от его пользы для пользователей, поэтому стандартизированные карточки с разным наполнением могут успешно функционировать в индексе при условии реальной ценности информации.