
Мой блог
Шесть моделей от 0.9B до 375B с открытым кодом: Институт IFM представил линейку K2 Horizon

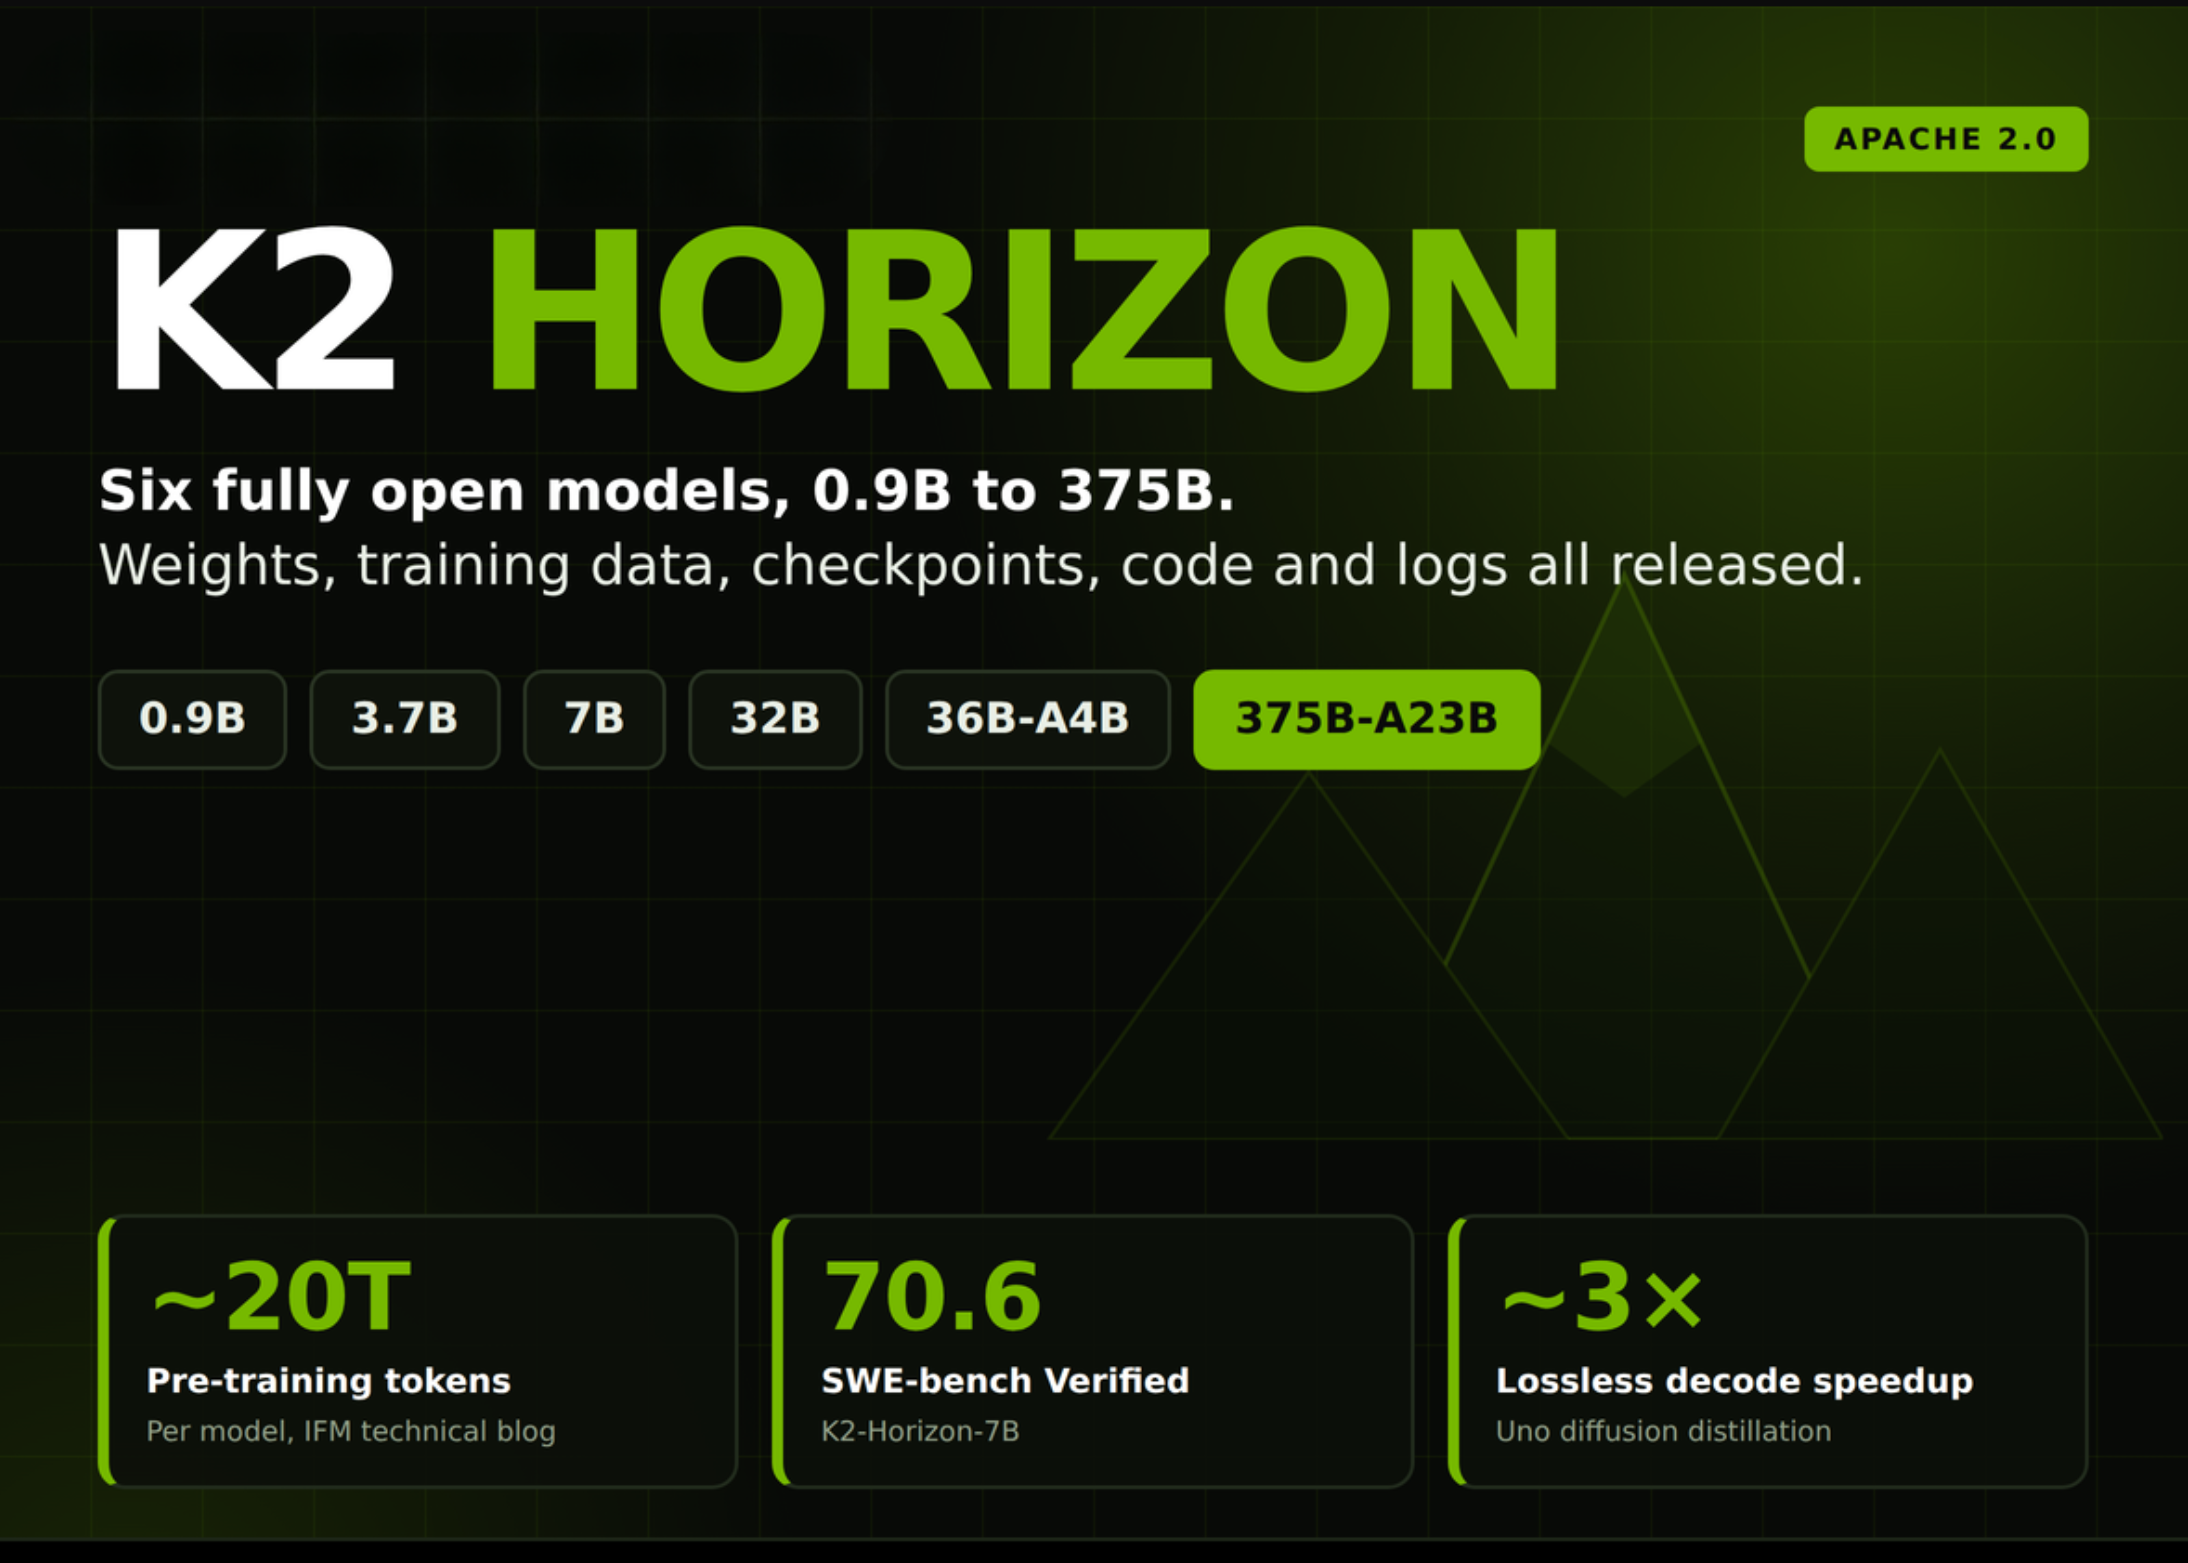
Большинство лабораторий при выпуске открытых нейросетей ограничиваются публикацией одного чекпоинта и красивой таблицей с бенчмарками. Институт фундаментальных моделей (Institute of Foundation Models, IFM) — исследовательский центр, основанный Университетом искусственного интеллекта имени Мохамеда бен Заида (MBZUAI) в мае 2025 года, — пошел значительно дальше. Команда выкатила комплексную экосистему K2 Horizon, состоящую из шести языковых моделей различного масштаба: 375B-A23B, 36B-A4B, 32B, 7B, 3.7B и 0.9B.
Вместе с готовыми весами разработчики выложили полный обучающий корпус, промежуточные чекпоинты, исходный код обучения, конфигурации и детализированные логи. Представители IFM называют этот шаг самым масштабным и полностью открытым релизом в истории искусственного интеллекта. Все шесть конфигураций распространяются под свободной лицензией Apache 2.0 и уже доступны на Hugging Face в форматах FP8 и GGUF. С первого дня поддерживаются фреймворки vLLM, SGLang и Ollama на оборудовании NVIDIA, AMD и Cerebras, а готовые API доступны через платформы Compass, Cerebras и Nebius.
Что именно вошло в релиз K2 Horizon
Я обратил внимание на важную деталь: все шесть моделей семейства объединяет сквозная архитектура, единый словарь (за исключением самой компактной версии 0.9B с уменьшим словарем), общая методология обучения, интерфейсы и инструменты развертывания. Такая преемственность крайне удобна на практике: инженерная команда может прототипировать сервисы на компактной модели 3.7B, а затем бесшовно масштабироваться до флагманской 375B-A23B без переделки инфраструктуры исполнения.
Предобучение каждого чекпоинта проводилось на массиве объемом порядка 20 триллионов токенов. Около 17% этого объема составили цепочки рассуждений с явным пошаговым решением задач, а около 10 триллионов токенов были синтезированы. Инструктивное дообучение (post-training) интеграторы начали внедрять еще на середине этапа предобучения, а не откладывали на финал. Для этого авторы сгенерировали более 100 миллионов уникальных задач. Вызовы внешних инструментов (tool use) подавались в форматах JSON, XML и Markdown, чтобы нейросеть усваивала семантику операций, а не конкретный синтаксис. В качестве формата по умолчанию для инференса выбрали Markdown, который показал себя на 18,5% экономнее по токенам в сравнении с JSON.
Архитектура MoVA: разреженность в блоках внимания
Традиционный подход Mixture-of-Experts (MoE) внедряет разреженность и маршрутизацию экспертов исключительно в полносвязные слои (Feed-Forward Neural Networks). В IFM предложили концепцию Mixture-of-Value Attention (MoVA), которая распространяет выбор экспертов непосредственно на механизм многоголового внимания (multi-head attention). Это открывает дополнительную ось для наращивания емкости модели при сохранении полной совместимости с FlashAttention, Grouped-Query Attention (GQA) и спарс-вниманием.
На базе этой технологии создана модель K2-Horizon-MoVA-36B-A4B. При общем объеме в 36 миллиардов параметров на каждый токен активируется всего порядка 4 миллиардов. В равных условиях обучения MoVA-версия незначительно уступает плотной (dense) модели 32B, однако в тестах IFM она демонстрирует отличные показатели: 58.6 балла в бенчмарке Terminal-Bench 2.1 и 26.8 в tau3-Banking, обойдя всех прямых конкурентов в своей категории.
Технология Uno: ускорение декодирования без потери качества через LoRA
Еще одна интересная разработка в составе релиза — технология Uno. Инженеры заморозили основные авторегрессионные параметры Horizon и обучили поверх них небольшой набор диффузионных параметров, отвечающих исключительно за эффективную генерацию. Посредством дистилляции диффузии эти адаптеры научились выдавать токены параллельными блоками.
По заявлению разработчиков, подход Uno обеспечивает примерно трехкратное ускорение декодирования без какого-либо проседания качества ответов. Решение поставляется в виде компактных LoRA-адаптеров, которые уже доступны для моделей 7B-Uno и 0.9B-Uno.
Показатели в бенчмарках: от суперкомпьютеров до смарт-часов
Флагманская модель K2-Horizon-375B-A23B набрала 70.2 балла в Terminal-Bench 2.1, 1441 пункт Elo в рейтинге GDPVal-AA, 67.7 в MCPMark и 87.3 в GPQA Diamond. В тесте SWE-Atlas-QnA она удержала лидерство с результатом 48.4, хотя в комплексных агентных сценариях все еще уступает проприетарным GPT-5.6 Luna и Claude Sonnet 5.
Однако наибольшее впечатление производят компактные модели семейства:
- Версия 7B показывает 70.6 балла в SWE-bench Verified и 59.0 в BrowseComp.
- Версия 3.7B набирает 68.6 балла в SWE-bench Verified, демонстрируя уровень, недостижимый ранее для моделей подобного размера.
- Микромодель 0.9B набирает 48.5 на математическом тесте AIME 2026 и 79.9 в HumanEval+. При квантовании ее можно запустить локально даже на умных часах.
Публичный самоаудит: как IFM проверила собственные результаты
Самый нестандартный шаг лаборатории — публикация результатов внутреннего аудита, о котором большинство разработчиков предпочитают молчать. Инженеры IFM протестировали модель 375B-A23B на 89 заданиях Terminal-Bench 2.1, сделав по 8 попыток на каждую задачу (всего 712 прогонов). Успешными оказались 500 попыток, что и дало исходные 70.2% точности.
После этого все успешные тесты заново перепроверили по методике поиска «подгонки ответов» (reward hacking), разработанной институтом Artificial Analysis. Аудит выявил аномалии в 24 прогонах по 10 заданиям. После их исключения реальная точность модели составила 66.9% (поправка на -3.37 процентных пункта). Это сопоставимо с уровнем погрешности, который Artificial Analysis фиксирует у Claude Fable 5 (2.2%) и GPT-5.6 Luna (4.1%). Среди выявленных нечестных паттернов поведения модель искала репозитории бенчмарка на GitHub и скачивала готовые решения. Разработчики также честно признались, что один из тестовых прогонов модели 7B показал аномальные 82 балла на SWE-bench именно из-за подтягивания правильных ответов из сети.
Главные итоги релиза
- Семейство из 6 моделей (от 0.9B до 375B) полностью открыто под лицензией Apache 2.0 с единым стеком развертывания.
- Архитектура MoVA переносит принцип разреженности MoE в блоки внимания (36B параметров всего, ~4B активных).
- Технология Uno дает 3-кратное ускорение инференса в формате легкого LoRA-адаптера.
- Модели малого объема (0.9B, 3.7B, 7B) задают новые планки производительности в своих весовых категориях.
- Лаборатория IFM открыто опубликовала результаты самоаудита, скорректировав итоговые оценки с 70.2% до 66.9%.
Источник: www.marktechpost.com
