Мой блог
Как нейросети диагностируют рак кожи: сравнение GPT-6 Astra, Claude и старой CNN

В ходе практического тестирования современных языковых моделей на дерматологических снимках выяснилось, что специализированная сверточная нейросеть десятилетней давности точнее распознает кожные образования, чем передовые генеративные системы.
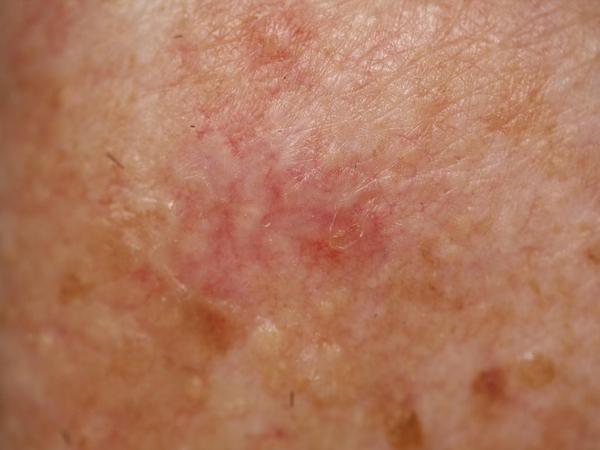
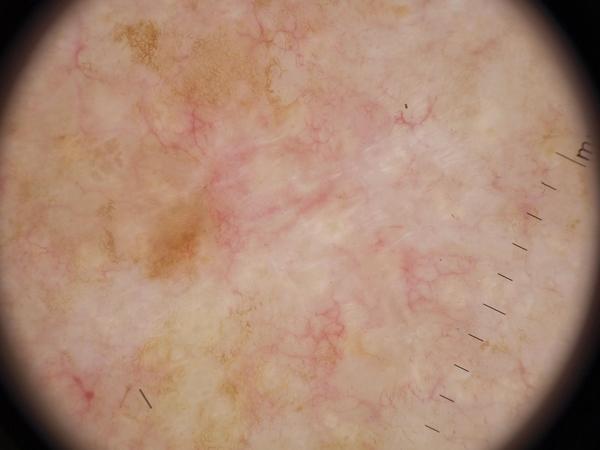
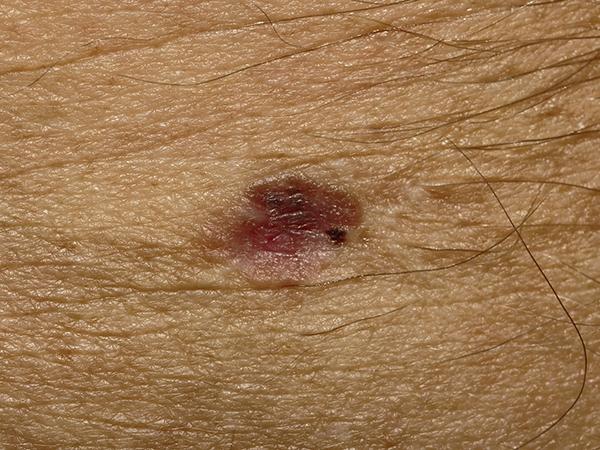
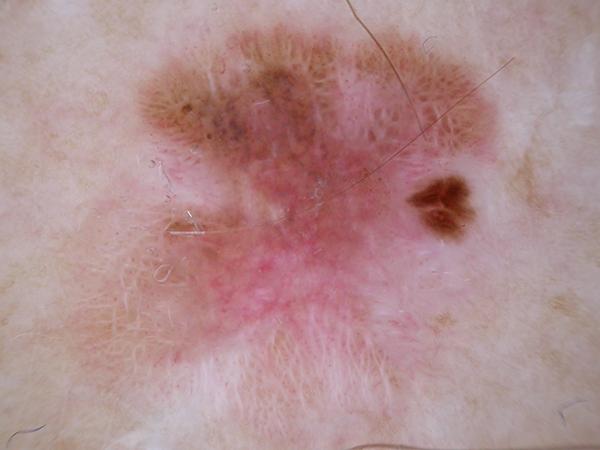
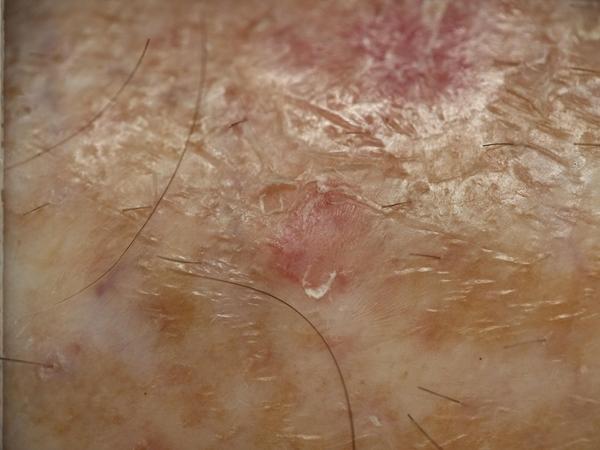
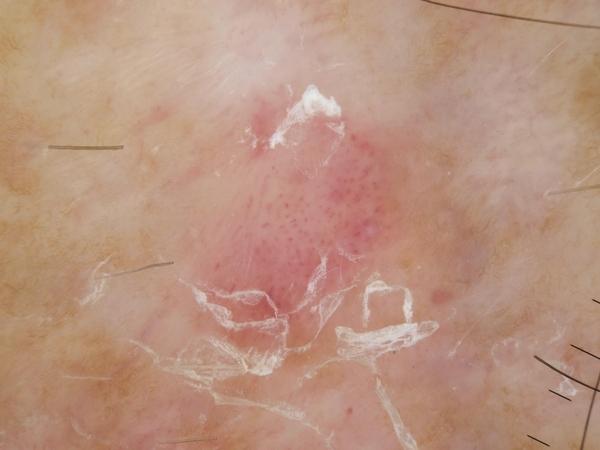
В материале рассматривается проверка эффективности ИИ в дерматологии и проводится детальное сравнение точности диагностики.
Методика тестирования моделей
Для проверки возможностей искусственного интеллекта в распознавании патологий кожи были задействованы две современные языковые модели — GPT-6 Astra и Claude Fable 5.1. В качестве ориентира для сопоставления результатов использовали классическую сверточную нейросеть Inception v3, созданную еще в 2015 году и дообученную на специализированном открытом архиве медицинских изображений.
Набор данных и категории образований
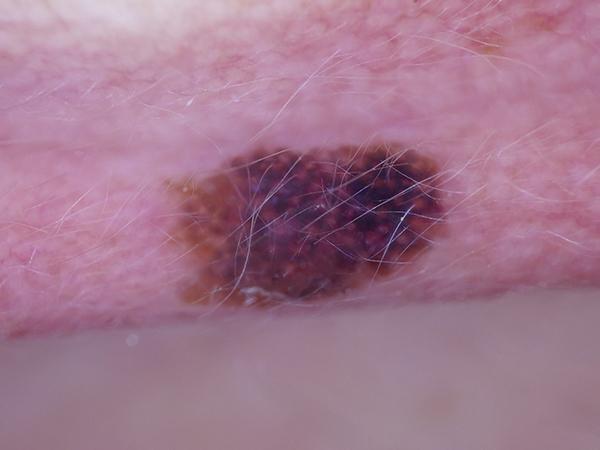
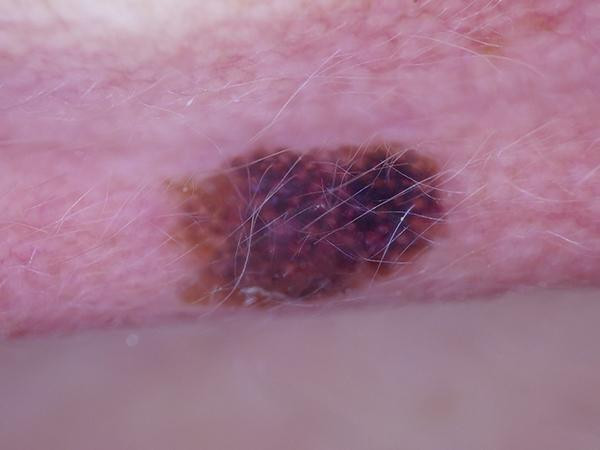
В качестве тестовой базы выступил открытый датасет MILK10k, выпущенный Международным сотрудничеством по визуализации кожи в 2025 году. Каждая клиническая единица в нем представлена парой снимков: общим планом и дерматоскопическим кадром, полученным через специальную увеличительную линзу с подсветкой. Всего для эксперимента отобрали 200 образований с подтвержденными результатами биопсии.
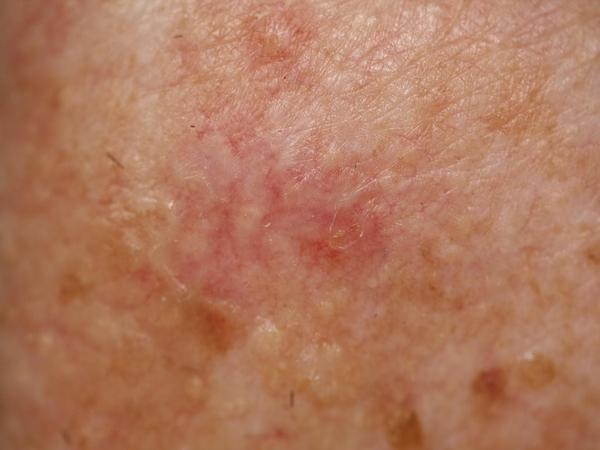
Тестовая выборка делилась на две равные части:
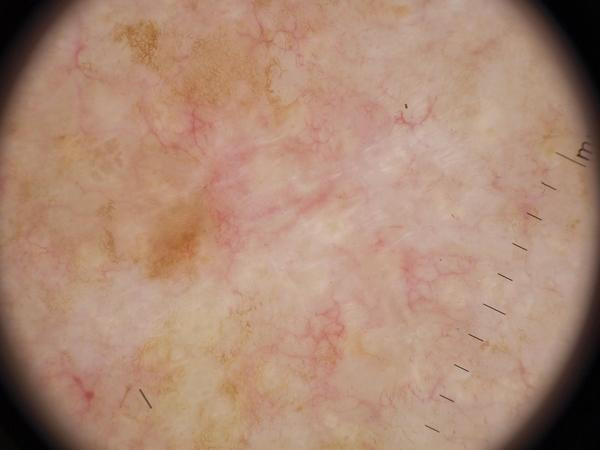
- 100 опасных образований, требующих обязательного врачебного контроля: 30 меланом, по 25 базальноклеточных и плоскоклеточных карцином, а также 20 актинических кератозов;
- 100 доброкачественных образований, которые можно не наблюдать: 50 родинок (невусов) и 50 случаев себорейного кератоза.
Поскольку биопсию проводили даже доброкачественным объектам, усложнивших задачу врачам, диагностика потребовала максимальной точности от всех участников эксперимента.
Результаты диагностики
В ходе анализа исследовалась способность моделей определять наиболее вероятный диагноз из шести предложенных вариантов на основе предоставленных снимков. Языковые модели получали одинаковые стандартные запросы без дополнительных подсказок.
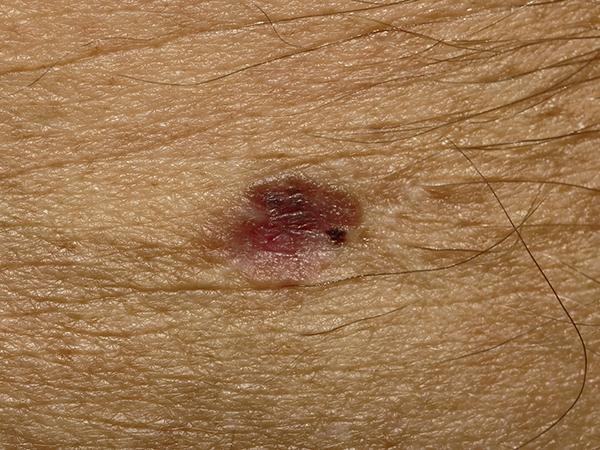
Точность классификации
Старая сверточная нейросеть смогла поставить правильный диагноз с первого раза в 125 случаях из 200, что составляет 62%. Передовые языковые модели GPT-6 Astra и Claude Fable 5.1 справились хуже, показав результат в 42% (84 и 85 правильных ответов соответственно). Если учитывать второй вариант в выдаче, то показатели старой архитектуры возрастают до 173 верных ответов против 134 и 138 у конкурентов.
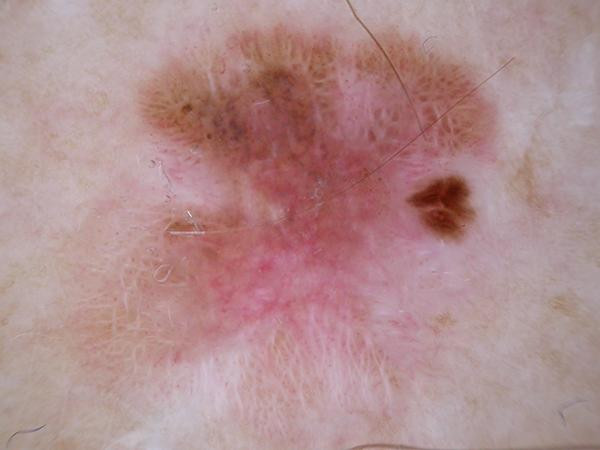
Особенно заметный разрыв зафиксирован при оценке безопасных образований: классическая сеть распознала 37 из 50 родинок и 26 из 50 случаев себорейного кератоза. При этом современные мультимодальные системы продемонстрировали склонность к системным ошибкам, регулярно выбирая определенные диагнозы в качестве универсального ответа независимо от реальной гистологии.
Важные оговорки и ограничения
Автор проведенного анализа подчеркивает несколько факторов, которые следует учитывать при оценке результатов:
- Относительно небольшой объем тестовой выборки в 200 образцов позволяет выявить общие закономерности, но недостаточен для ранжирования близких показателей.
- Все отобранные для теста случаи прошли через процедуру биопсии, что автоматически отсеивало простые клинические картины и повышало общую сложность задач.
- Возможная утечка данных из открытого датасета MILK10k могла частично присутствовать в тренировочных базах языковых моделей, однако для старой сети исключалось любое предварительное знакомство с тестовыми кадрами.
Полученные данные показывают, что узкоспециализированные алгоритмы компьютерного зрения старой школы при правильном дообучении сохраняют высокую эффективность в медицинской диагностике по сравнению с универсальными мультимодальными системами.