
Мой блог
Как организовать работу долгосрочного AI-проекта и сохранить контекст в нейросетях

При длительной работе с искусственным интеллектом в рамках одного направления пользователи часто сталкиваются с тем, что нейросеть начинает забывать принятые решения или предлагает уже опубликованные темы заново. Чтобы избежать постоянного восстановления утерянной информации, требуется грамотное управление контекстом долгосрочного проекта на базе встроенных инструментов платформ.
Современные AI-сервисы предлагают специализированные механизмы для упорядочивания информации, однако их наличие не гарантирует автоматического порядка. Рассмотрим, как правильно распределить функции между инструкциями, файлами источников и историей диалогов.
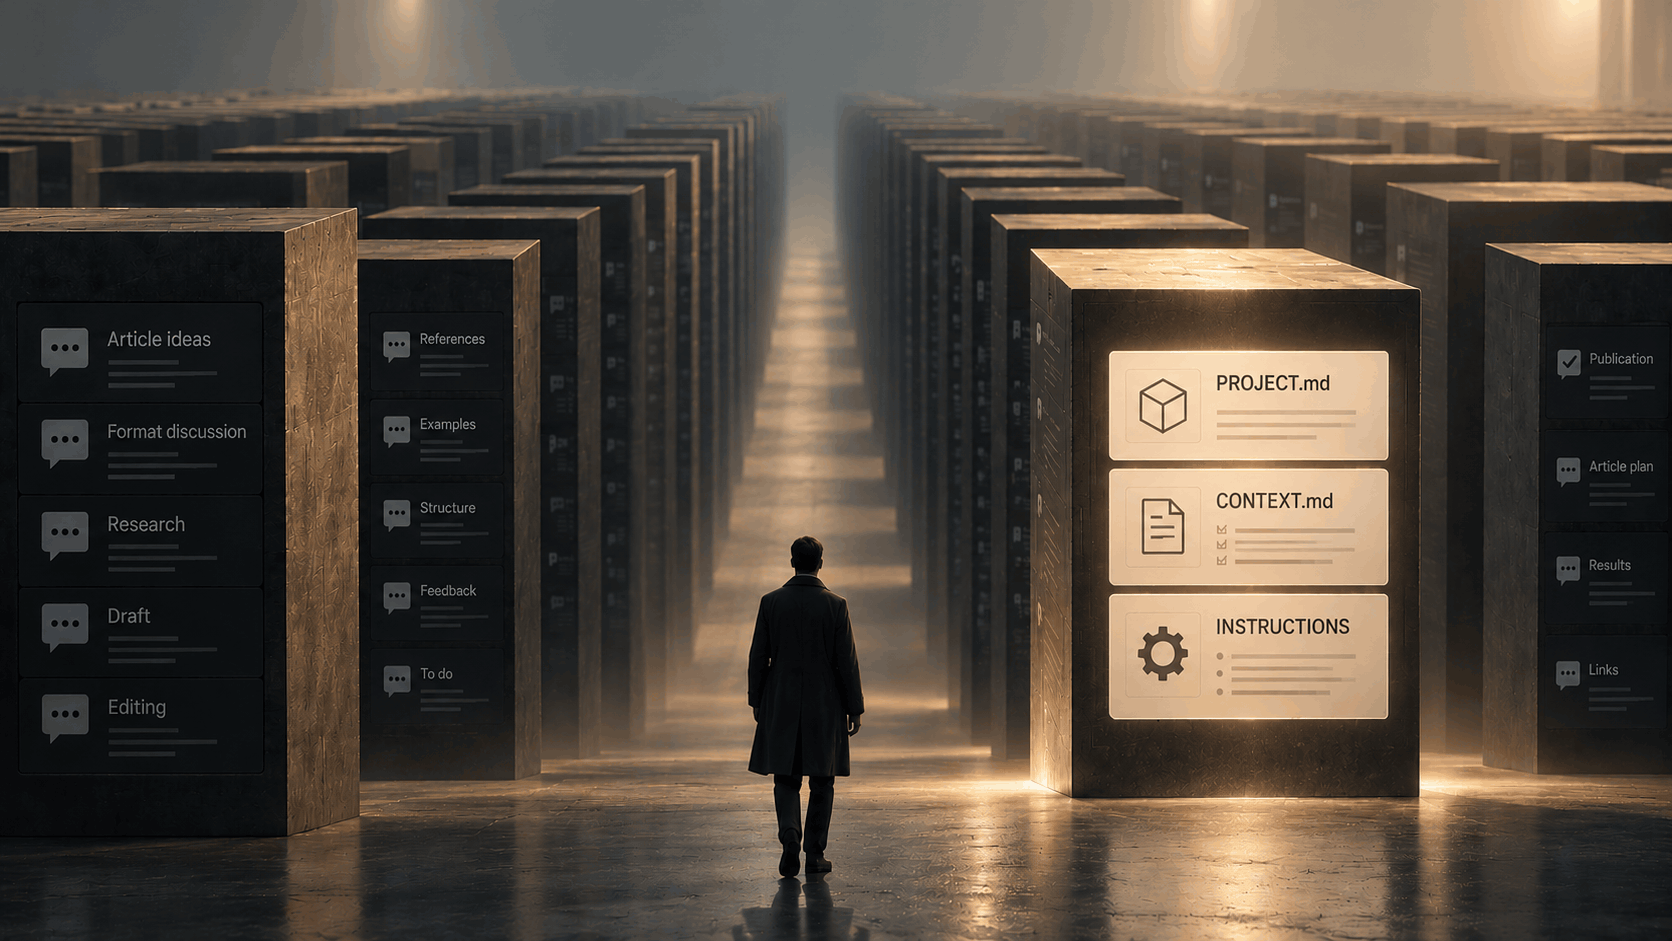
Особенности работы с долгосрочными AI-проектами
Описанный подход к структурированию данных актуален не только для ведения блогов, но и для реализации образовательных курсов, научных исследований, формирования бизнес-стратегий или планирования цифровых продуктов. За основу можно взять ChatGPT Projects, хотя аналогичные принципы применяются и на других чат-платформах. Подобные пространства позволяют объединять тематические обсуждения, фиксировать постоянные правила и подключать справочные материалы.
Для сравнения, при разработке с помощью AI-агентов вроде Cursor, Claude Code или Codex CLI доступ к репозиторию и документации происходит напрямую через файлы. В чат-интерфейсах архитектура устроена иначе: модель опирается на загруженные файлы, системные подсказки, историю чатов и модули памяти. Именно для таких сред критически важно выстраивать изолированную систему хранения знаний.
Почему история чатов не решает проблему контекста
Распространено заблуждение, будто достаточно просто создать отдельный проект в ChatGPT, и платформа автоматически сохранит все нюансы работы. На практике языковые модели имеют ограничения по размеру окна контекста. При удлинении бесед система может сокращать историю, отбирать лишь отдельные фрагменты или задействовать механизмы памяти, из-за чего старые договоренности теряются.
Более того, даже при наличии доступа к прошлым диалогам модель способна запутаться в промежуточных вариантах и окончательных решениях. Если при выработке стратегии рассматривалось несколько форматов, а затем был утвержден только один, нейросеть при отсутствии четких указаний рискует выбрать устаревший черновой вариант.
Инструменты платформ для управления информацией
Большинство чат-платформ предоставляют набор базовых компонентов, которые распределяются по конкретным задачам. Правильное сочетание этих элементов позволяет стабилизировать поведение модели.
Основные механизмы и их назначение
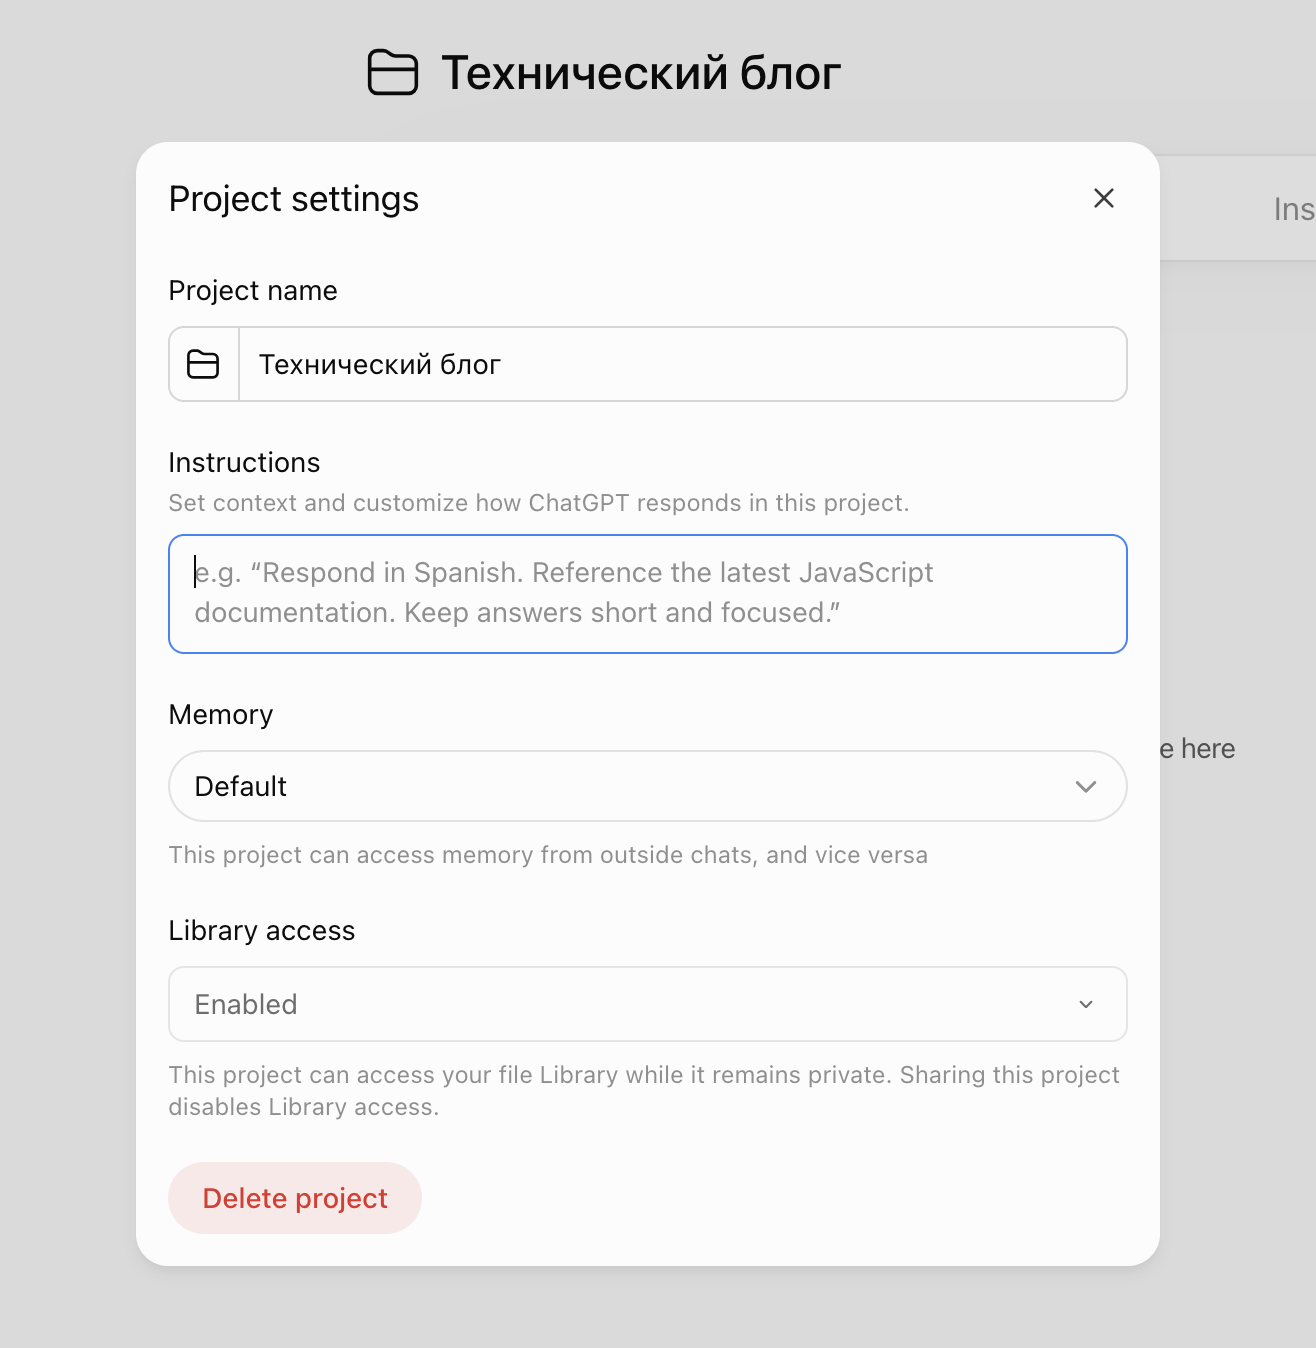
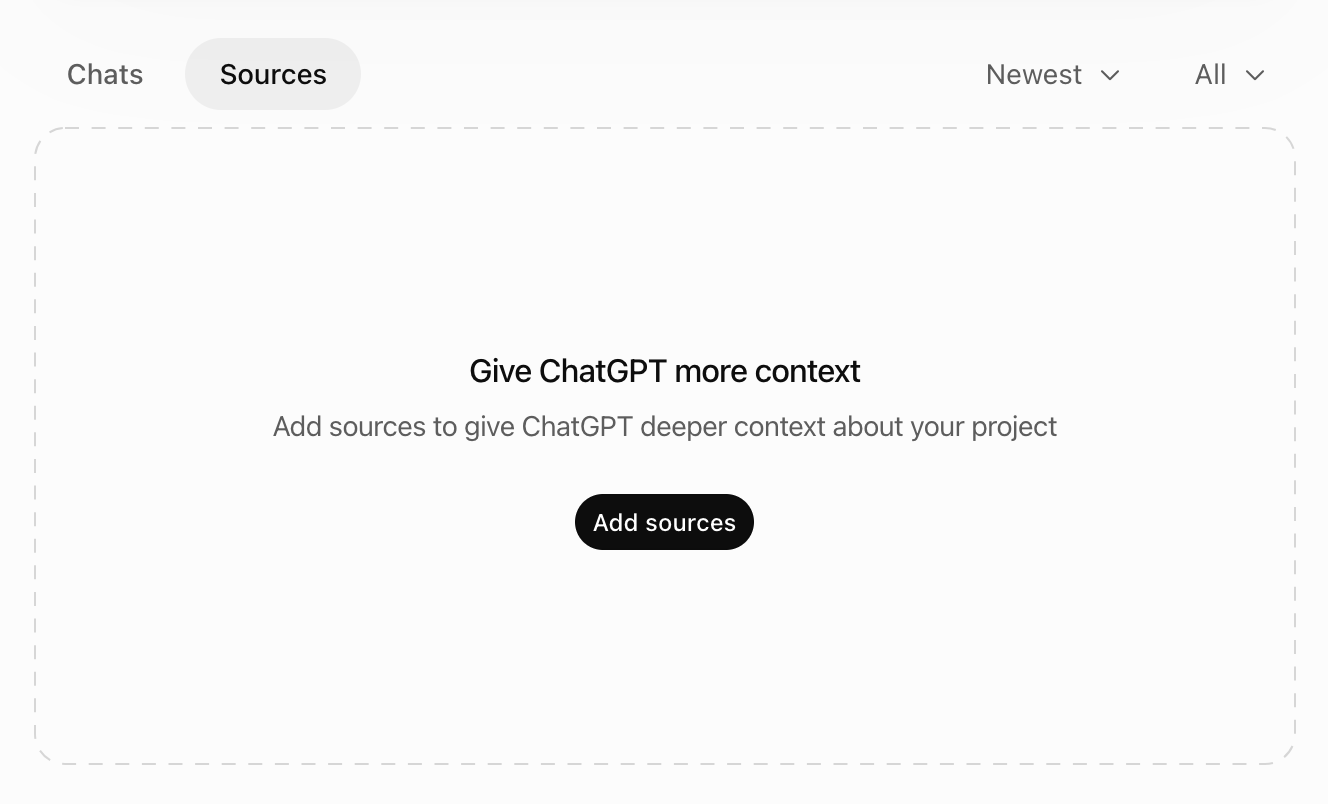
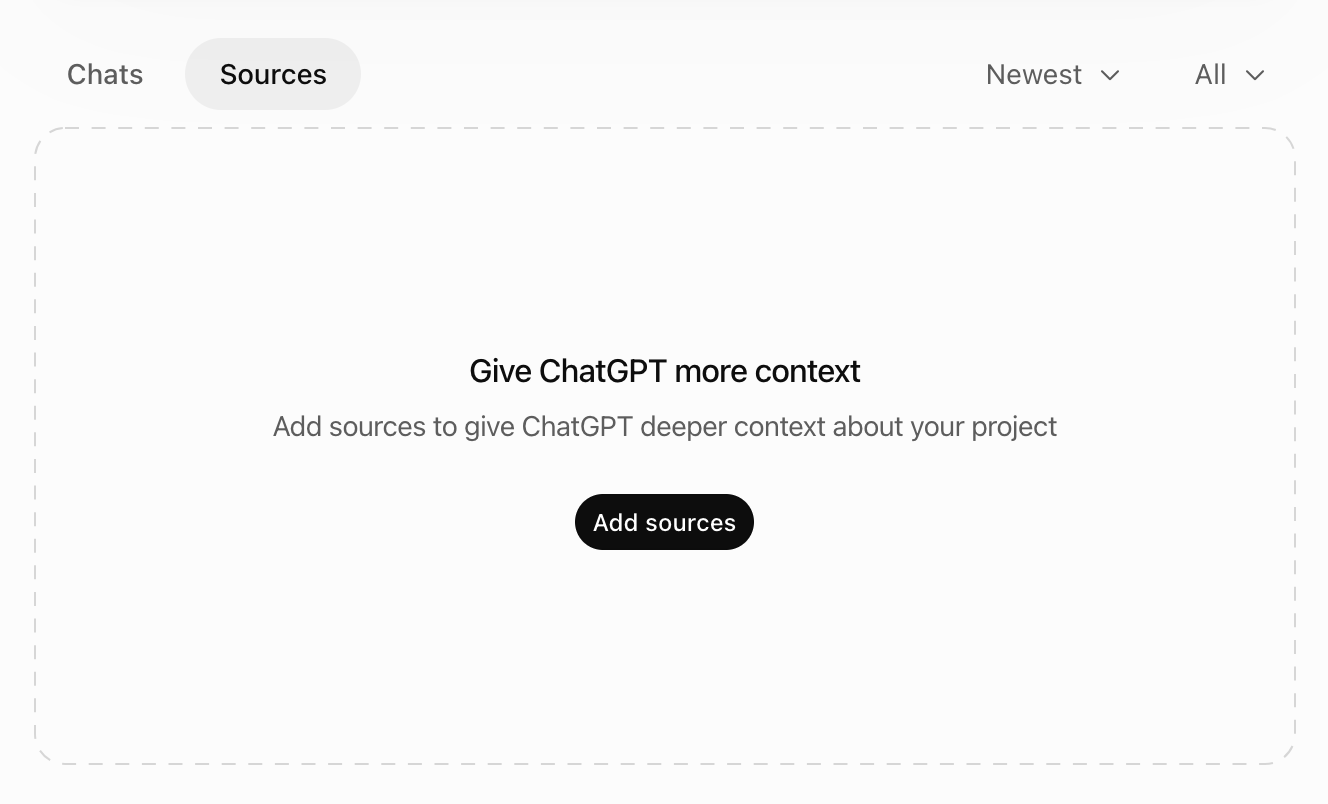
Функция Project Instructions отвечает за постоянные правила поведения модели. Блок Project Files / Sources служит хранилищем справочных материалов и актуальной документации. Memory и история чатов помогают учитывать прошлые взаимодействия, а Skills стандартизируют повторяющиеся рабочие процедуры, такие как вычитывание черновиков или проверка фактов.
Инструкции задают общие рамки работы, но перегружать их всей историей проекта и планами публикаций нельзя. Для детальных требований лучше использовать отдельные файлы в источниках проекта, разделяя информацию по смысловым блокам.
Практическая настройка AI-проекта по шагам
Для запуска структурированной работы достаточно сформировать постоянные инструкции и пару ключевых документов. Это создаст надежную основу для дальнейшего взаимодействия без хаоса в чатах.
Шаг 1. Создание файла PROJECT.md
Первый документ содержит стабильные параметры: цели направления, характеристики целевой аудитории, редакционные правила и ограничения. Например, в нем фиксируют требования писать понятным языком, избегать неподтвержденных цифр и не дублировать ранее раскрытые темы без новых вводных.
Шаг 2. Создание файла CONTEXT.md
Второй документ описывает актуальное состояние дел, включая список вышедших материалов, текущие черновики в работе и планы на будущее. Важно учитывать, что искусственный интеллект не имеет прямого доступа к внешним площадкам, поэтому статусы публикаций всегда должны подтверждаться пользователем.
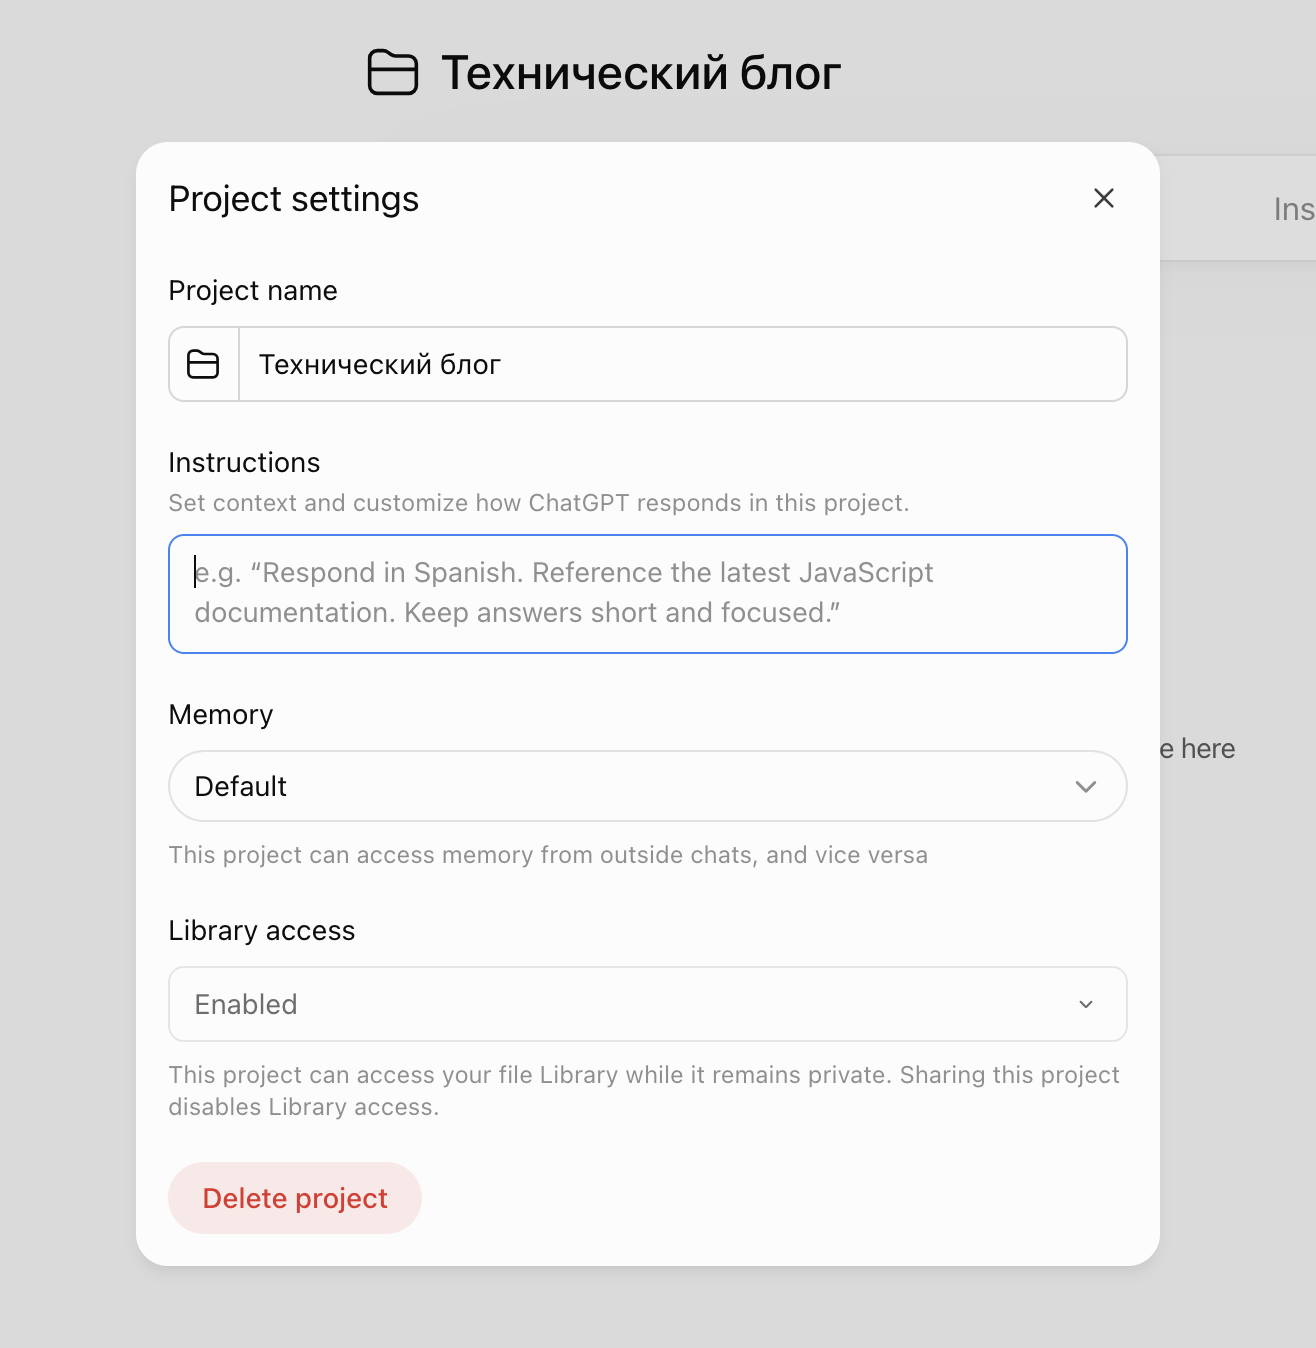
Шаг 3. Настройка Project Instructions
Системные инструкции определяют, как именно модель должна обращаться с подготовленной документацией. В них прописывается обязанность сверяться с источниками перед ответом, разделять гипотезы и утвержденные решения, а также инициировать обновление файлов при завершении значимых этапов.
Шаг 4. Проверка конфигурации
После завершения базовой настройки следует открыть новый чат и задать проверочные вопросы о редакционных правилах или текущем статусе задач. Ответы должны строго опираться на созданные документы, а не на догадки алгоритма.
Поддержание актуальности проектных данных
Наличие документов не решает проблему само по себе, так как со временем планы меняются. Для поддержания актуальности применяется последовательный алгоритм: чтение текущего контекста, обсуждение текущей задачи, подтверждение результата, обновление файлов-источников и верификация изменений.
После публикации материала или утверждения важного этапа необходимо актуализировать состояние в CONTEXT.md, заменяя устаревшие пункты новыми данными, а не дописывая бесконечную историю в конец файла. Обновления можно выполнять вручную на основе предложений модели либо автоматически при наличии соответствующих разрешений у подключенных инструментов.
Предотвращение избыточности и ограничения метода
Со временем возникает риск превратить проектную документацию в свалку информации, куда сливаются все промежуточные обсуждения. Чтобы этого не происходило, следует отделять историю диалогов от финального состояния. Для крупных стратегических решений допускается заведение отдельного файла DECISIONS.md, однако на старте достаточно минимально достаточного набора.
Стоит помнить, что даже идеальная настройка не исключает полностью ситуаций, когда модель упускает детали или применяет инструкции непоследовательно. Грамотное проектирование контекста значительно упрощает работу с новыми чатами и снижает зависимость от старой переписки, но не отменяет необходимости финальной проверки результатов человеком.
