
Мой блог
Контекстный инжиниринг ИИ-агентов: 4 механизма обвязки против переполнения контекста и потери цели

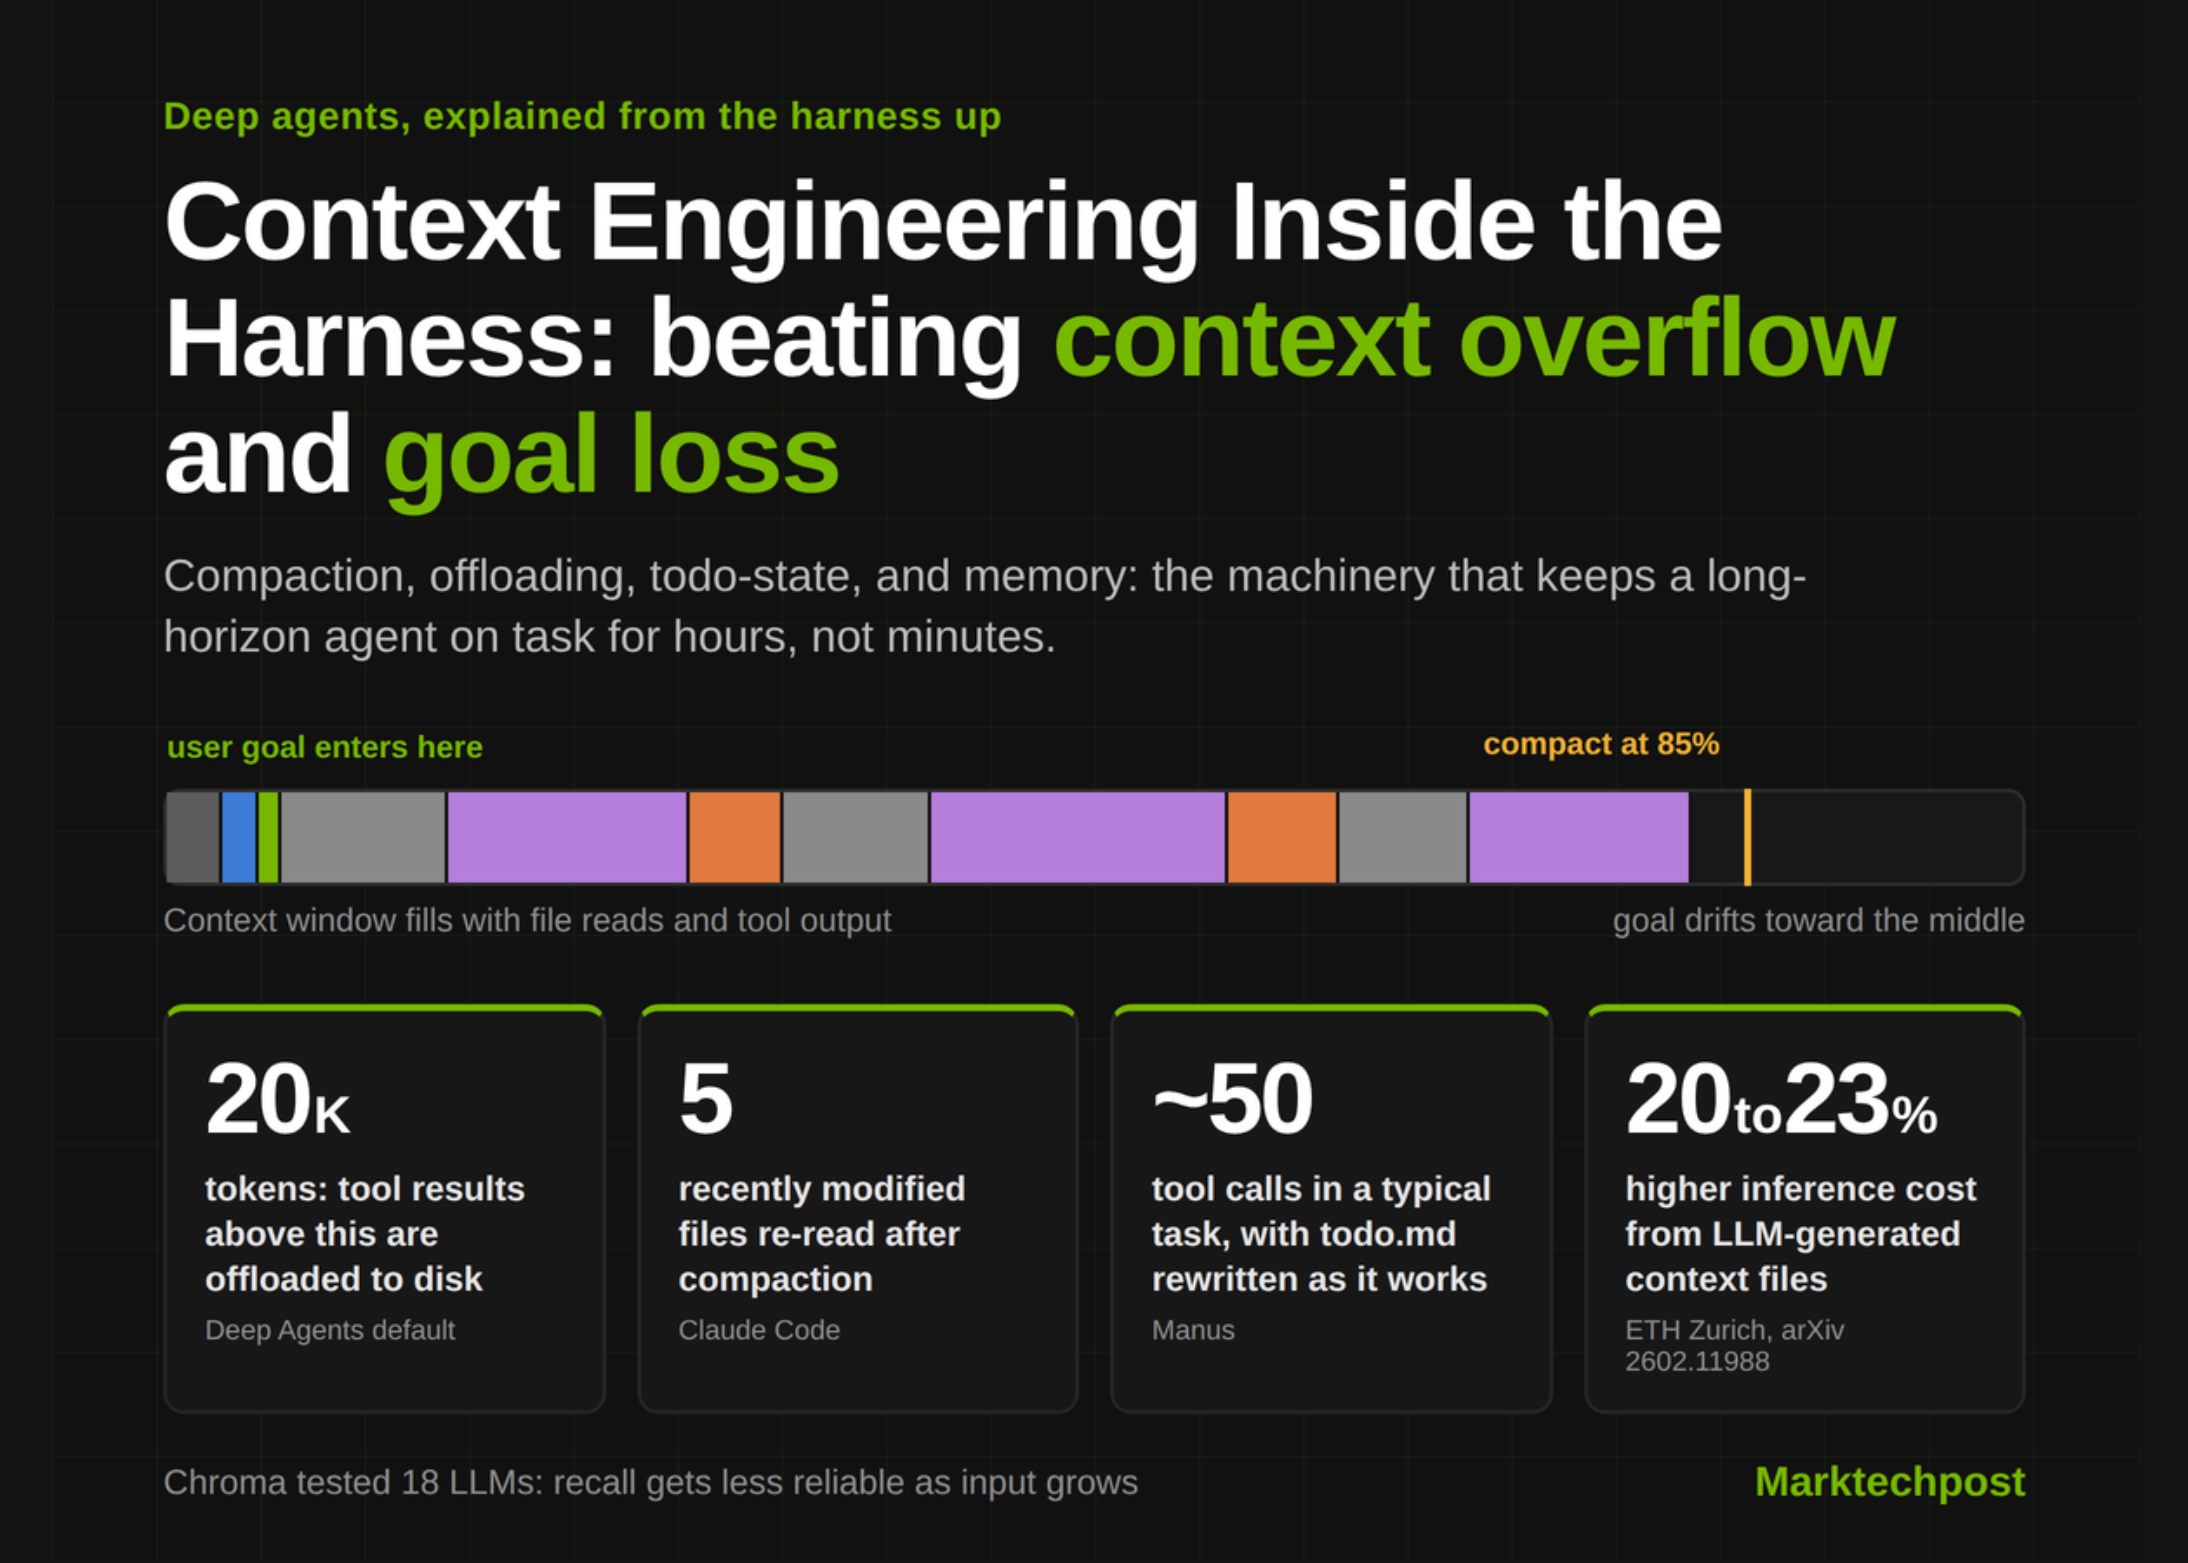
В своей самой базовой реализации автономный ИИ-агент — это языковая модель (LLM), вызывающая внешние инструменты в цикле. Для коротких сценариев этой схемы вполне достаточно. Однако стоит поручить агенту комплексную задачу, требующую пары сотен вызовов инструментов и получасовой автономной работы, как система неизбежно ломается по двум предсказуемым причинам. В официальном руководстве AWS по проектированию облачных агентов эти проблемы названы прямо: поверхностные агенты страдают от переполнения контекстного окна, отвлекаются от первоначальной цели (происходит так называемый goal loss) и не способны удерживать состояние на длинных дистанциях.
Решение этой проблемы лежит не на стороне самой нейросети, а в так называемой обвязке (harness) — инфраструктурном слое, который управляет всем окружением вокруг модели. Компактизация, грамотное бюджетирование контекста, стратегии межсессионной памяти и списки задач (todo-state) — это именно те архитектурные механизмы, которые превращают примитивный цикл вызовов в глубокого агента. В этой статье я детально разобрал, как эти механики реализуются в современных фреймворках и инструментах, включая LangChain Deep Agents, Claude Code, Manus, OpenAI Codex и Amazon Bedrock AgentCore, а также какие конкретные пороги и лимиты они используют на практике.
Почему простое увеличение окна контекста не решает проблему
Первая очевидная идея при столкновении с лимитами — просто использовать модель с огромным контекстным окном на миллионы токенов. Однако эмпирические исследования показывают, что это помогает значительно меньше, чем принято считать. В отчёте Chroma «Context Rot», где оценивались 18 популярных LLM (включая GPT-4.1, Claude 4, Gemini 2.5 и Qwen3), зафиксировано: точность работы модели становится всё менее надежной по мере роста длины входного текста даже в простых задачах извлечения информации.
Инженеры Anthropic объясняют этот эффект механикой внимания (attention mechanism). При увеличении длины текста в n токенов количество парных связей растёт пропорционально n². В результате каждый новый входящий токен истощает ограниченный «бюджет внимания» модели. Контекст — это не просто пустая ёмкость, а ресурс с убывающей полезностью.
В цикле работы ИИ-агента ситуация усугубляется в разы. По данным разработчиков Manus, среднестатистическая автономная задача требует порядка 50 вызовов инструментов, а соотношение входящих токенов к исходящим достигает 100 к 1. Каждый ответ инструмента или вывод терминала попадает в контекст и остается там. В итоге первоначальная инструкция пользователя «сползает» в середину огромного контекстного окна — ровно туда, где механизм внимания модели работает хуже всего. Потеря цели — это не просто случайный баг модели, а неизбежное следствие неуправляемого контекста на длинных дистанциях.
Механизм 1. Бюджетирование контекста и выгрузка данных на диск
Первостепенная задача обвязки — заранее определить, какая информация вообще не должна попадать в контекстное окно модели.
В фреймворке Deep Agents заложены два чётких правила выгрузки (offloading):
- Если ответ инструмента превышает 20 000 токенов, он полностью записывается в файловую систему, а в контекстное окно передаётся только путь к файлу и превью первых 10 строк.
- Когда общий объём сессии достигает 85% от максимума контекстного окна модели, устаревшие вызовы инструментов записи и редактирования (содержимое которых уже сохранено на диске) усекаются до указателей-ссылок. Лишь в том случае, если выгрузка на диск не освобождает достаточно места, система переходит к суммаризации.
Похожий подход к бюджетированию использует и Claude Code, причем ещё до первого запроса пользователя:
- Автоматическая память ограничена первыми 200 строками или 25 КБ данных.
- Схемы инструментов MCP (Model Context Protocol) по умолчанию отложены: модель видит только их имена, а полная схема подтягивается по требованию через инструмент поиска.
- После процедуры компактизации любой повторно читаемый файл объёмом более 5000 токенов возвращается в контекст в виде ссылки на путь, а не исходного текста.
В документации Claude Code приводится наглядный пример экономии: исследовательский субагент прочитывает файлы на 6100 токенов, но возвращает родительскому агенту структурированный итог всего на 420 токенов.
Использование субагентов — это бюджетирование на уровне самой архитектуры. В руководстве Anthropic отмечается, что каждый субагент может потратить десятки тысяч токенов на исследование задачи, но передаёт в основной контекст лишь сжатый отчёт на 1000–2000 токенов. В руководстве AWS AgentCore описывается аналогичный шаблон: координатор запускает трёх браузерных субагентов параллельно в изолированных MicroVM, а субагент-аналитик получает только их структурированные находки. По оценкам AWS, такой подход занимает 4–6 минут работы, тогда как последовательная обработка в одном контексте потребовала бы в три раза больше времени.
Механизм 2. Сжатие и компактизация (Compaction)
Когда методов выгрузки оказывается недостаточно, обвязка прибегает к сжатию. Компактизация (compaction) — это процесс, при котором диалог, приближающийся к лимиту окна, суммируется, после чего запускается новый контекст с внедрённой выжимкой.
Именно на этапе компактизации чаще всего происходит потеря цели, так как неточная суммаризация может упустить важные детали или ограничения. Различные платформы решают эту проблему по-разному:
- Claude Code: промпт компактизации нацелен на сохранение архитектурных решений, нерешённых багов и деталей реализации, отбрасывая при этом избыточные выводы инструментов. Сразу после сжатия система заново прочитывает до 5 недавно изменённых файлов, перезагружает соответствующие правила и внедряет тела вызванных навыков (с лимитом 5000 токенов на навык и не более 25 000 токенов суммарно). Ранние подробные инструкции могут теряться, поэтому долгосрочные правила рекомендуется хранить в файле
CLAUDE.mdв корне проекта, который перечитывается с диска. Разработчик также может направить сжатие командой/compact focus on...или настроить порог с помощью/autocompact. - Deep Agents: команда LangChain сделала сохранение цели структурным элементом. Итоговая суммаризация представляет собой документ с чёткими полями: намерение сессии, созданные артефакты и следующие шаги. Полнотекстовый транскрипт при этом сохраняется в файловой системе, поэтому утерянный при сжатии факт агент всегда может восстановить через
read_file. - Уровень API: OpenAI предлагает серверную компактизацию в Responses API через параметр
context_managementс порогомcompact_threshold, а также отдельный эндпоинт/responses/compact. Он возвращает зашифрованный объект сжатого контекста, который передаётся в следующий вызов без изменений. В OpenAI отмечают, что на эту систему опирается Codex для ведения длинных сессий кодинга. На платформе Claude Developer Platform доступно редактирование контекстаcompact_20260112с кастомными инструкциями и опциейpause_after_compaction.
Механизм 3. Управление состоянием через Todo-списки и цитирование целей
Если компактизация защищает цель в момент сжатия текста, то Todo-списки уберегают её на каждом промежуточном шаге. Разработчики Manus описали этот прием очень просто: агент создаёт файл todo.md и перезаписывает его на каждом шаге, отмечая выполненные пункты. Постоянная перезапись списка заставляет модель повторно «произносить» свои задачи в самом конце контекстного окна. Это смещает глобальный план в зону свежего внимания модели и предотвращает эффект «потери в середине» (lost in the middle).
Однако эффективность списков задач зависит от условий:
- В фреймворке Deep Agents инструмент
write_todosбыл включён по умолчанию до версии v0.7 (июль 2026 года). Позже LangChain сделалаTodoListMiddlewareопциональным, так как бенчмарки на трёх категориях задач показали чуть более высокую производительность и меньшие расходы без принудительных todo-списков на коротких дистанциях. При этом LangChain по-прежнему рекомендует активировать его для сложных многошаговых задач, менее мощных моделей и интерфейсов, где важен визуальный прогресс. - Claude Code поддерживает todo-список и повторно внедряет план из режима планирования после компактизации.
- В гайде Anthropic эта концепция называется структурированным ведением заметок (structured note-taking). В примере «Claude Plays Pokémon» агент вел учёт действий на протяжении тысяч шагов игры, вычитывал свои файлы
NOTES.mdпосле каждого сброса контекста и успешно продолжал многочасовые сессии.
Главный вывод этого подхода: цель должна существовать как изменяемый артефакт на диске, а не только как текстовое сообщение в истории диалога. Сообщения стареют и сжимаются, а файл, обновляемый каждые несколько шагов, всегда остается свежим и легко восстанавливается при любых сбросах.
Механизм 4. Стратегия долгосрочной памяти между сессиями
Последний элемент архитектуры — сохранение знаний после завершения работы задачи:
- Claude Code повторно внедряет
CLAUDE.mdи автоматическую память с диска после каждой компактизации. - В Amazon Bedrock AgentCore Memory события сохраняются в фоновом режиме с применением экстракционных стратегий. Это позволяет координатору при следующем запуске вызывать инструмент
recallвместо повторного анализа репозитория. AWS отдельно предупреждает: если не настроена хотя бы одна стратегия экстракции, сырые события сохранятся, но ничего извлечь для поиска не удастся.
Однако долговременная память имеет свою цену. Исследование ETH Zurich показало, что файлы контекста репозитория (такие как AGENTS.md) далеко не всегда повышают процент успешного выполнения задач, но гарантированно увеличивают расходы на инференс. Файлы, сгенерированные самими LLM, увеличивали стоимость вызовов на 20–23% в двух бенчмарках, а файлы, написанные разработчиками, — до 19%. Память, загружаемая в каждую сессию, — это постоянный налог на бюджет внимания. По этой причине в документации Claude Code рекомендуется держать CLAUDE.md в пределах 200 строк, а справочные материалы выносить в отдельные навыки или локальные правила, подгружаемые только при необходимости.
Как протестировать, удерживает ли обвязка цель
Система управления контекстом полезна только тогда, когда агент способен успешно завершить задачу и восстановить детали, которые больше не видны в его текущем окне.
Для проверки обвязки инженеры LangChain используют специализированные тесты (evals):
- Тесты с искусственной компактизацией: сжатие контекста вызывается намеренно на ранних этапах (на уровне 10–20% от лимита окна вместо стандартных 85%). В тестах с Claude Sonnet 4.5 на бенчмарке terminal-bench-2 порог снижали до 25%, чтобы проверить, сможет ли агент продолжить движение к цели после сжатия.
- Иголка в стоге сена (Needle-in-a-haystack): проверяется ситуация, когда важный факт выпадает из контекста при суммаризации, и агент должен самостоятельно найти его через поиск по файловой системе.
Главный сбой, за которым нужно следить — это дрейф цели (goal drift), когда агент сразу после компактизации начинает запрашивать уточнения у пользователя или ошибочно объявляет задачу выполненной. В AgentCore Evaluations встроен специальный модуль оценки успешности цели (goal success rate evaluator). Если вы разрабатываете свою обвязку и ни разу принудительно не вызывали компактизацию в тестах, вы ещё не знаете, какие именно детали теряет ваш промпт суммаризации.
Итоги и ключевые выводы
- Проблема в обвязке, а не в модели: при длительных задачах простые агенты ломаются из-за переполнения контекста и потери цели. Решение этих проблем лежит в архитектуре harness-слоя.
- Бюджетируйте ресурсы в первую очередь: выгружайте результаты работы инструментов объёмом более 20 000 токенов на диск и усекайте старые редактирования файлов при достижении 85% окна (как в Deep Agents).
- Сжатие должно быть структурированным: промпты компактизации должны четко сохранять намерение сессии, созданные артефакты и следующие шаги, а также подтягивать с диска ключевые файлы проекта.
- Повторение целей через Todo-списки — не бесплатное решение: регулярная перезапись
todo.mdудерживает цель в зоне внимания, но требует токенов. Для коротких сценариев её можно отключать, но для многочасовых задач она необходима. - Память стоит денег: автоматическая загрузка файлов конфигурации увеличивает затраты на инференс на 19–23%. Держите глобальные файлы памяти компактными (до 200 строк) и используйте отложенную загрузку навыков.
Источник: www.marktechpost.com
