
Мой блог
Kyutai представила Voice of Reason: нативные голосовые нейросети для устного решения математических задач

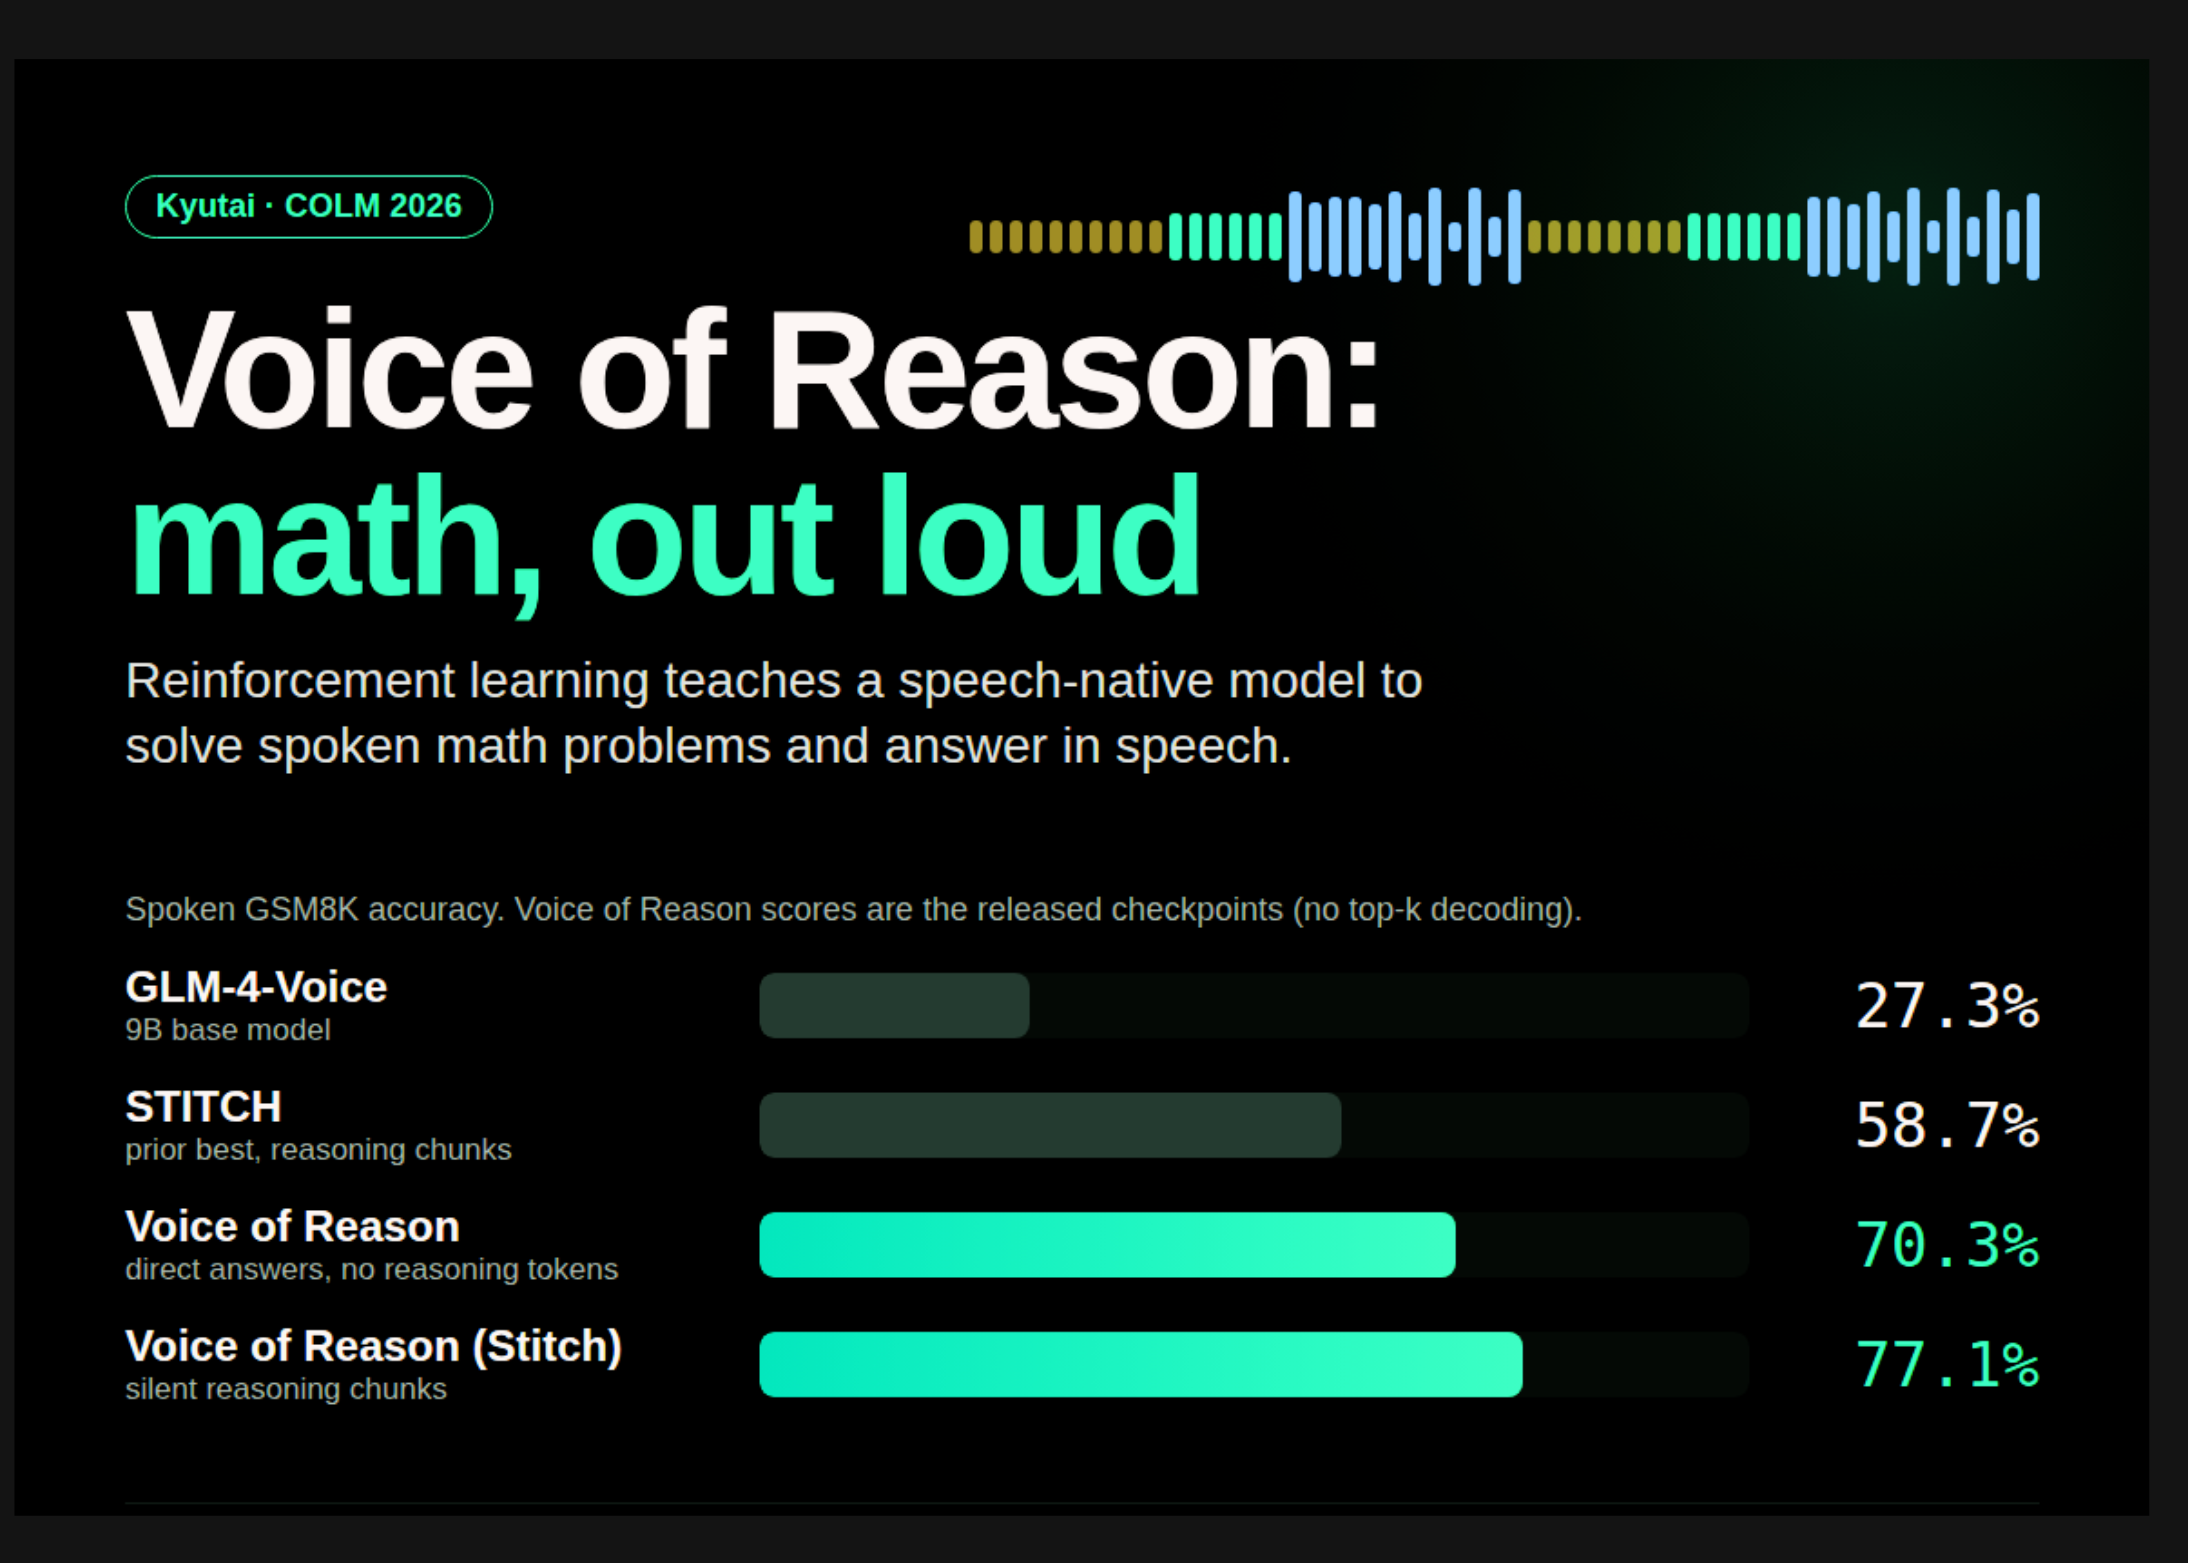
Разработчики из исследовательской лаборатории Kyutai представили проект Voice of Reason — две сквозные модели голосового взаимодействия с открытыми весами, предназначенные для устного решения математических задач. Главная особенность этих нейросетей заключается в их нативности: процесс обработки речи и генерации ответа происходит без промежуточного перевода аудио в текст и без участия сторонней текстовой языковой модели.
В основу новинки легла архитектура GLM-4-Voice-9B, которую авторы доработали с помощью комбинации тонкой настройки (SFT) и алгоритмов обучения с подкреплением (RL). Это позволило увеличить точность устных математических вычислений на бенчмарке GSM8K с базовых 27,3% до 77,1%. При этом голосовые модели с открытым весом уже доступны для локального запуска и способны работать на одной видеокарте уровня NVIDIA H100.
Почему сквозным голосовым нейросетям сложно даваться математические рассуждения
Традиционный подход к созданию голосовых ассистентов строится на каскадных системах: сначала модуль распознавания речи (ASR) превращает голос в текст, затем текстовая LLM генерирует ответ, а система синтеза (TTS) озвучивает результат. Такие цепочки демонстрируют высокую точность в логических задачах, однако платят за это задержками и полной потерей интонаций, темпа и прочих невербальных нюансов речи.
Нативные же сквозные модели (speech-native) обязаны выдавать аудиотокены с регулярным интервалом, чтобы разговор сохранял естественный темп. Из-за этого ограниченного лимита времени нейросеть просто не успевает сформировать достаточное количество скрытых токенов рассуждения перед тем, как произнести ответ. Базовая версия GLM-4-Voice показывала на тесте GSM8K всего 27,3% правильных ответов. Ранее предложенный метод STITCH смог повысить показатель до 58,7% за счет вставки промежуточных блоков рассуждений, но работа команды Kyutai стала первым успешным примером применения обучения с подкреплением для развития математического мышления в нативно-голосовых моделях.
Как устроена процедура обучения и в чем технологический прорыв
Выходной поток исходной модели GLM-4-Voice организован путем чередования: за 13 текстовыми токенами всегда следуют 26 аудиотокенов. Чтобы научить систему правильно рассуждать в таком жестком формате, инженеры Kyutai разбили процесс подготовки на два ключевых этапа.
На этапе SFT (Supervised Fine-Tuning) модель обучалась на 150 616 задачах из набора Orca-Math. Все формулировки были адаптированы под устную речь с помощью нейросети Qwen3-235B, а затем озвучены собственной системой синтеза Kyutai DSM TTS с разным тембром и интонациями. Одно лишь контролируемое обучение подняло точность GLM-4-Voice с 27,3% до 61,7%.
На втором этапе применили обучение с подкреплением (RL). Для каждого устного вопроса модель генерировала по 4 варианта ответа при температуре сэмплирования 0,9. В роли арбитра выступала модель Qwen3-235B-A22B-2507, которая выставляла бинарную оценку декодированному тексту, не имея доступа к эталонному ответу. При проверке на 100 контрольных примерах оценка арбитра совпала с мнением людей в 88% случаев. Для оптимизации использовался целевой метод REINFORCE с внутригрупповым центрированием наград, похожий на GRPO, но без отсечения PPO и регуляризации KL. Весь процесс RL занял 1500 шагов обновления на кластере из 16 карт NVIDIA H100.
Критически важными для успеха RL оказались два инженерных решения:
- Температурная коррекция градиентов (Temperature correction): логиты перед вычислением log-softmax в функции потерь делятся на температуру сэмплирования. Без этого механизма точность модели на GSM8K катастрофически падала с 65,5% до 12,3%.
- Объединение аудиотокенов (Audio-token merging): в каждой аудиопозиции вероятности всех токенов из аудиословаря суммируются в единый абстрактный токен. В результате функция потерь оценивает только то, должно ли дальше идти аудио, а не конкретный звук, что снижает дисперсию оценки без создания смещения.
Характеристики двух выпущенных чекпоинтов
Разработчики выложили в открытый доступ две конфигурации модели, различающиеся способом построения устного ответа:
Конфигурация glm-4-voice-of-reason-9b работает напрямую. Она не генерирует скрытые токены размышлений, а проговаривает все промежуточные шаги вычислений вслух прямо во время ответа.
Конфигурация glm-4-voice-of-reason-stitch-9b задействует метод скрытых рассуждений. Между озвучиваемыми блоками модель формирует молчаливые блоки по 100 токенов мышления. Поскольку последующие блоки рассуждений генерируются параллельно с воспроизведением предыдущего фрагмента речи, общая задержка диалога не увеличивается. В используемой схеме STITCH-R самый первый блок размышлений создается перед началом первой сказанной фразы.
Результаты тестирования и сопоставление с аналогами
При оценке моделей на устном бенчмарке GSM8K с декодированием top-k 50 результаты распределились следующим образом (в скобках указаны показатели без ограничения top-k):
- PersonaPlex (8B): 3,2%
- Базовая GLM-4-Voice (9B): 27,3%
- Проект STITCH (9B): 58,7%
- Voice of Reason Direct (9B): 65,5% ± 1,1% (70,3% в итоговом релизе)
- Voice of Reason Stitch (9B): 74,8% ± 1,1% (77,1% в итоговом релизе)
Для сравнения, мультимодальные гиганты Qwen2.5-Omni (7B) и Qwen3-Omni (30B) с текстовым выводом набирают 84,7% и 94,6% соответственно, а классическая каскадная система ASR-LLM-TTS показывает 95,7%. Однако авторы подчеркивают, что это лишь ориентиры верхнего предела, так как каскады и крупногабаритные omni-системы используют значительно больше ресурсов и работают с иной задержкой.
Тестовые аудиозаписи формировались с помощью системы GPT-4o-mini-TTS, а арбитром при итоговой оценке выступала модель GPT-4o. В ходе подробного анализа исследователи выявили еще несколько важных фактов:
- Устойчивость к реальной речи: при распознавании сторонней системой Qwen3-ASR-1.7B точность модели Stitch осталась на высоком уровне 72,0% ± 1,9%.
- Сохранение естественности: метрика качества звучания UTMOSv2 практически не изменилась после обучения с подкреплением, оставшись на уровне 4,07–4,17.
- Эффективность по времени: обучение RL не привело к раздуванию ответов. Напротив, средняя длительность ответа прямой модели сократилась с 41,9 до 36,4 секунды.
- Работа с малым объемом данных: при использовании всего 10% от объема SFT-данных последующий этап RL позволил достичь 58,5% точности, тогда как один SFT на том же объеме давал лишь 43,9%.
- Побочный эффект для эрудиции: точность в общей викторине TriviaQA снизилась с 40,6% до 34,0%, причем авторы связывают это с этапом SFT, а не с алгоритмами обучения с подкреплением.
- Проверка на утечку данных: из тестов были исключены наборы AddSub, MultiArith, SingleEQ и SVAMP, а прямые совпадения с Orca-Math на уровне парафраза составили 54,0%.
Ключевые итоги и практическая ценность
Созданный Kyutai метод обучения с подкреплением доказал, что нативные голосовые нейросети способны решать сложные логические и математические задачи без разрыва диалога и без перевода речи в текст. Подъем точности с 27,3% до 77,1% делает Voice of Reason одним из самых заметных прорывов в области Voice AI.
Обе модели на 9 миллиардов параметров доступны на Hugging Face, полностью поддерживают локальное развертывание на одной карте NVIDIA H100 и требуют для работы лишь оригинальный репозиторий GLM-4-Voice для токенизации и декодирования аудио.
