Мой блог
Новое исследование Linux Foundation оценило влияние генеративного ИИ на разработку ПО

Исследовательское подразделение Linux Foundation Research опубликовало доклад, посвященный влиянию генеративного искусственного интеллекта на экосистему открытого исходного кода. Сама структура LF Research была создана в 2021 году и занимается публикацией исследований о том, как создается и используется открытый софт, опираясь на опросы и данные проектов. Аналитический материал под названием Navigating Open Source Software Development in the Generative AI Era опирается на опрос разработчиков и мейнтейнеров, затронувший актуальные проблемы качества кода и надежности pull requests в современных проектах.
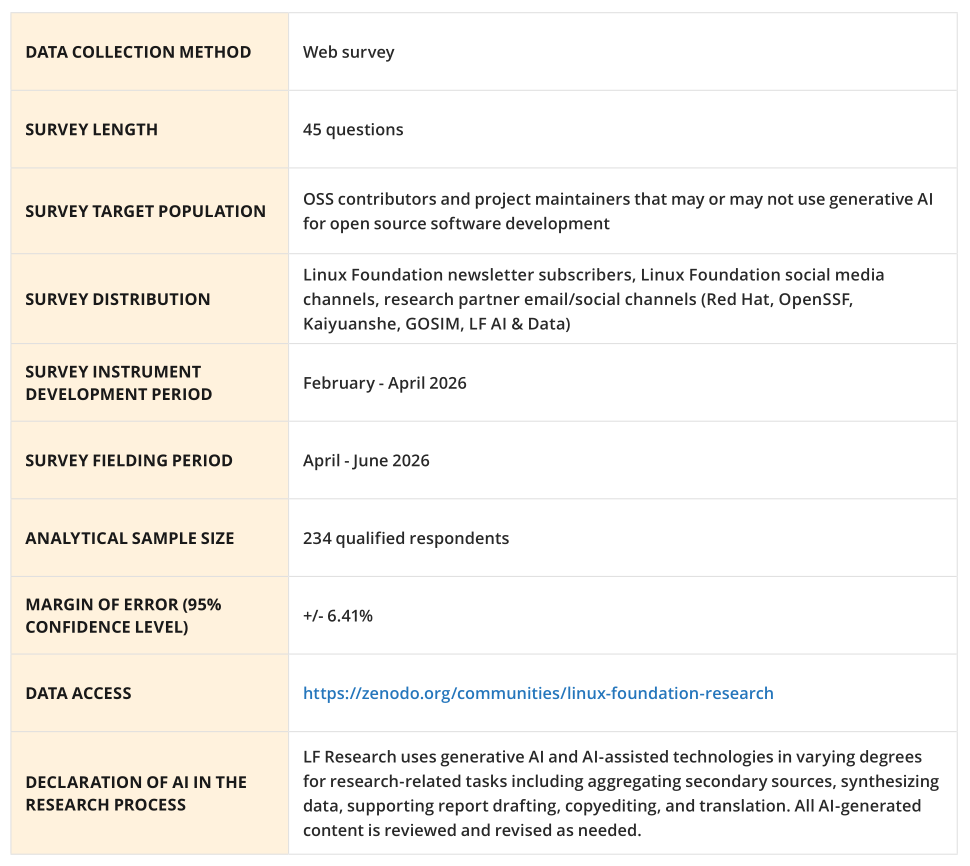
Проект был подготовлен при спонсорской поддержке Red Hat, а также при участии организаций OpenSSF, LF AI & Data и Futurewei. Авторы опросили 234 участников и руководителей проектов, чтобы выяснить, как алгоритмы генеративного кода меняют практику создания программного обеспечения. Респонденты для этого исследования рекрутировались через новостные рассылки и социальные каналы Linux Foundation, а также через партнерские каналы, включая Red Hat.
Основные результаты исследования
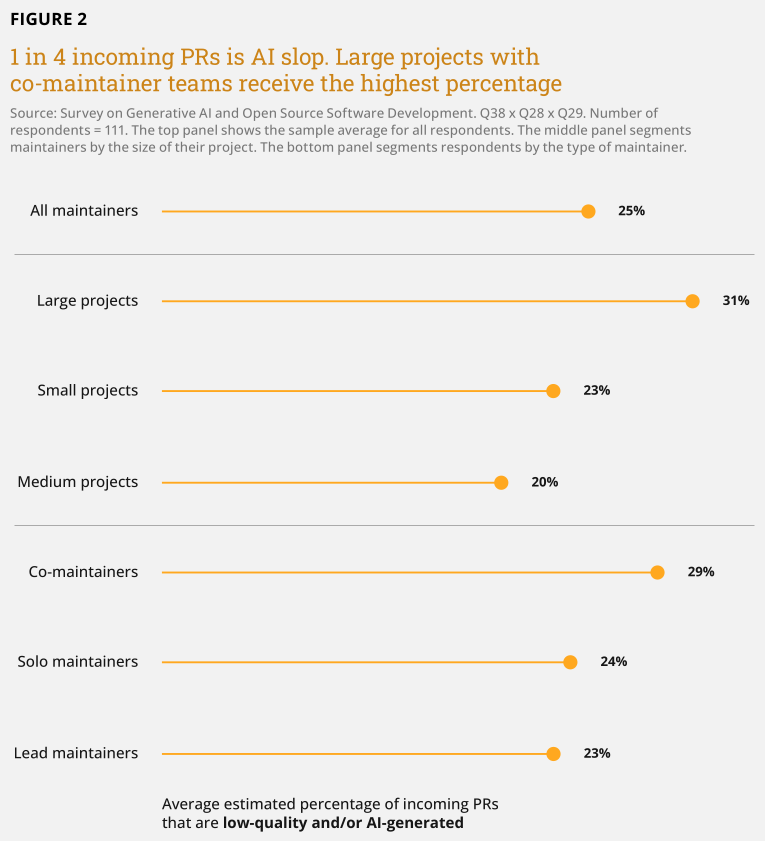
Согласно оценкам респондентов, около четверти (25%) всех входящих pull requests представляют собой низкокачественный контент, созданный с помощью искусственного интеллекта. Стоит уточнить, что показатель в 25% представляет собой оценку от 111 респондентов, а не точный замеренный подсчет. В крупных проектах, где задействовано более 50 контрибьюторов, этот показатель возрастает до 31%. Руководители таких масштабных репозиториев сталкиваются с серьезной нагрузкой: 69% из них отмечают рост числа входящих предложений (против 59% в среднем по всем проектам), а 64% указывают на увеличение времени, необходимого для их проверки и ревью.
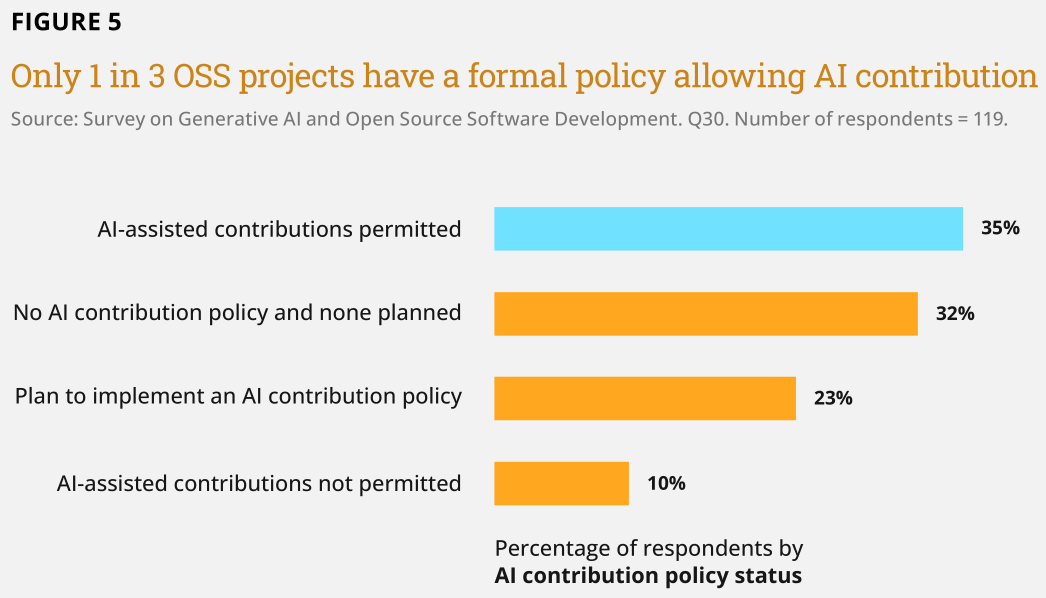
Главным поводом для беспокойства мейнтейнеров крупных проектов становится профессиональное выгорание, о котором заявили 63% опрошенных. На втором месте с небольшим отрывом находится проблема качества поступающего кода — ее отметили 60% специалистов.
Регулирование и корпоративные правила
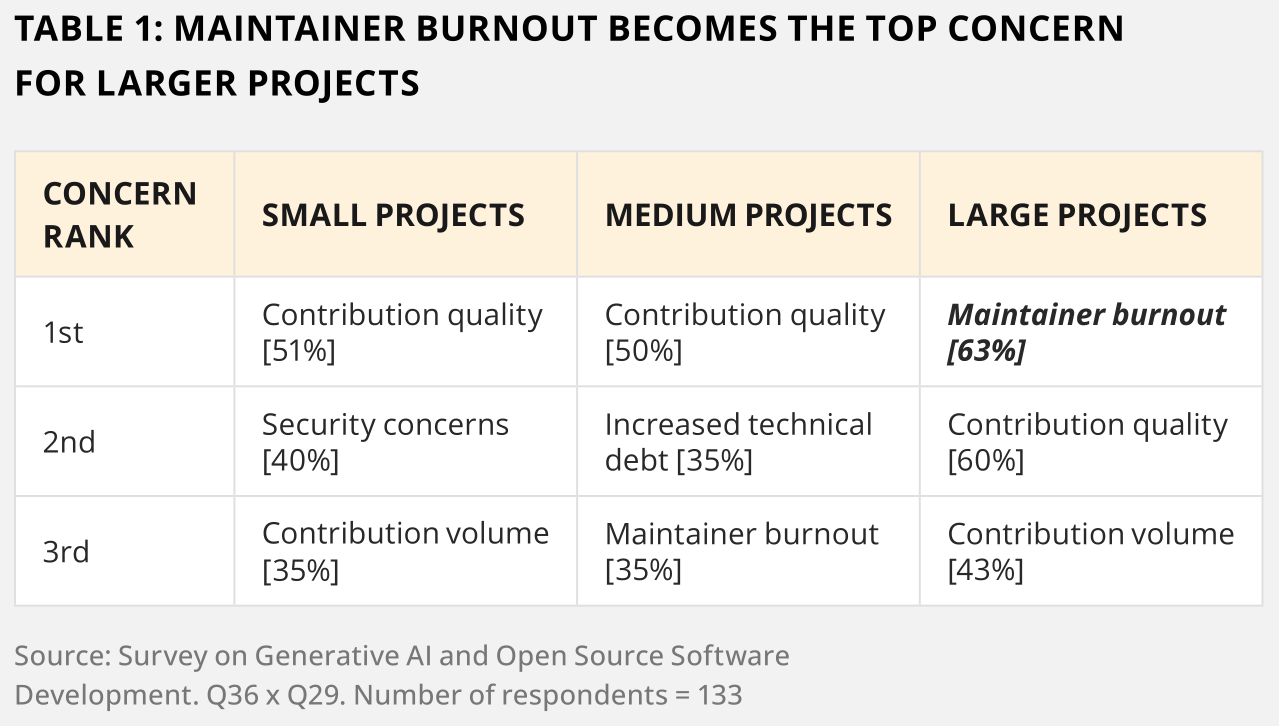
Организационные политики пока не успевают за темпами распространения ИИ-инструментов для написания кода и уязвимостей. Из 119 респондентов, ответивших на профильный вопрос, лишь 35% сообщили, что в их проектах действуют формальные правила, разрешающие использование искусственного интеллекта.
Около 32% команд не имеют подобных регламентов и не планируют их внедрять, 23% собираются разработать такие правила в будущем, а 10% полностью запретили контрибьюторам применять ИИ. При этом некоторые крупные проекты, включая LLVM, допускают использование сгенерированного кода, но на определенных условиях. В опубликованном докладе содержится призыв к контрибьюторам уделять больше усилий письменным правилам, раскрытию фактов использования ИИ, а также тестированию и документированию. Кроме того, четверть всех проектов (26%) на данный момент вообще не имеют технических возможностей для проверки происхождения кода, созданного с помощью нейросетей, поскольку раскрытие информации в основном остается личным выбором каждого, а те, кто отправляет некачественный контент, редко утруждают себя подобными деталями.
Влияние ИИ на продуктивность и новичков
С практической точки зрения инструменты искусственного интеллекта действительно сокращают затраты времени разработчиков. По оценкам участников опроса, написание исходного кода с поддержкой ИИ занимает в среднем на 52% меньше времени. Тем не менее, при решении более сложных задач 21% респондентов указали, что рабочий процесс, напротив, затянулся.
Большинство руководителей проектов (71%) согласны с тем, что ИИ упрощает вхождение в проект для новых участников. Однако мнения по поводу общего доверия сообщества разделились: чуть более половины респондентов (53%) считают, что ситуация не улучшилась, и лишь 13% фиксируют рост доверия.