
Мой блог
Как я избавил локальный ИИ-агент от нехватки контекста: замена Claude Code

Подробности изложены в материале первоисточника. Переход на локальные искусственные интеллекты привлекает многих пользователей своей конфиденциальностью и отсутствием подписок. Однако многошаговые задачи быстро исчерпывают память модели, вызывая сбои в работе.
В этой статье я расскажу, как оптимизировать настройки контекста и VRAM на видеокарте с 8 ГБ, чтобы локальный агент стабильно справлялся со сложными сценариями. Local AI agents открывают отличные возможности для приватной работы без отправки данных на сторонние сервера.
Почему локальные агенты мгновенно расходуют доступную память
Под контекстом понимается объем текстовых данных, которые модель способна удерживать в поле зрения одновременно. В этот лимит входят не только ваши сообщения, но и ответы нейросети. Когда запускается многошаговый процесс, нагрузка возрастает лавинообразно. Агент отправляет инструкции, перечень доступных инструментов и каждый прочитанный файл с каждым новым шагом.
В качестве одного из основных инструментов для такой работы я использую 오픈сорсный проект Eigent, который подключается к любой локальной LLM на диске. Ошибки превышения лимита контекста возникали у меня регулярно при попытке запустить первые объемные задачи на стандартных параметрах. Программа разбивала задачу на подзадачи, но возвращала сообщения об исчерпании лимита памяти.
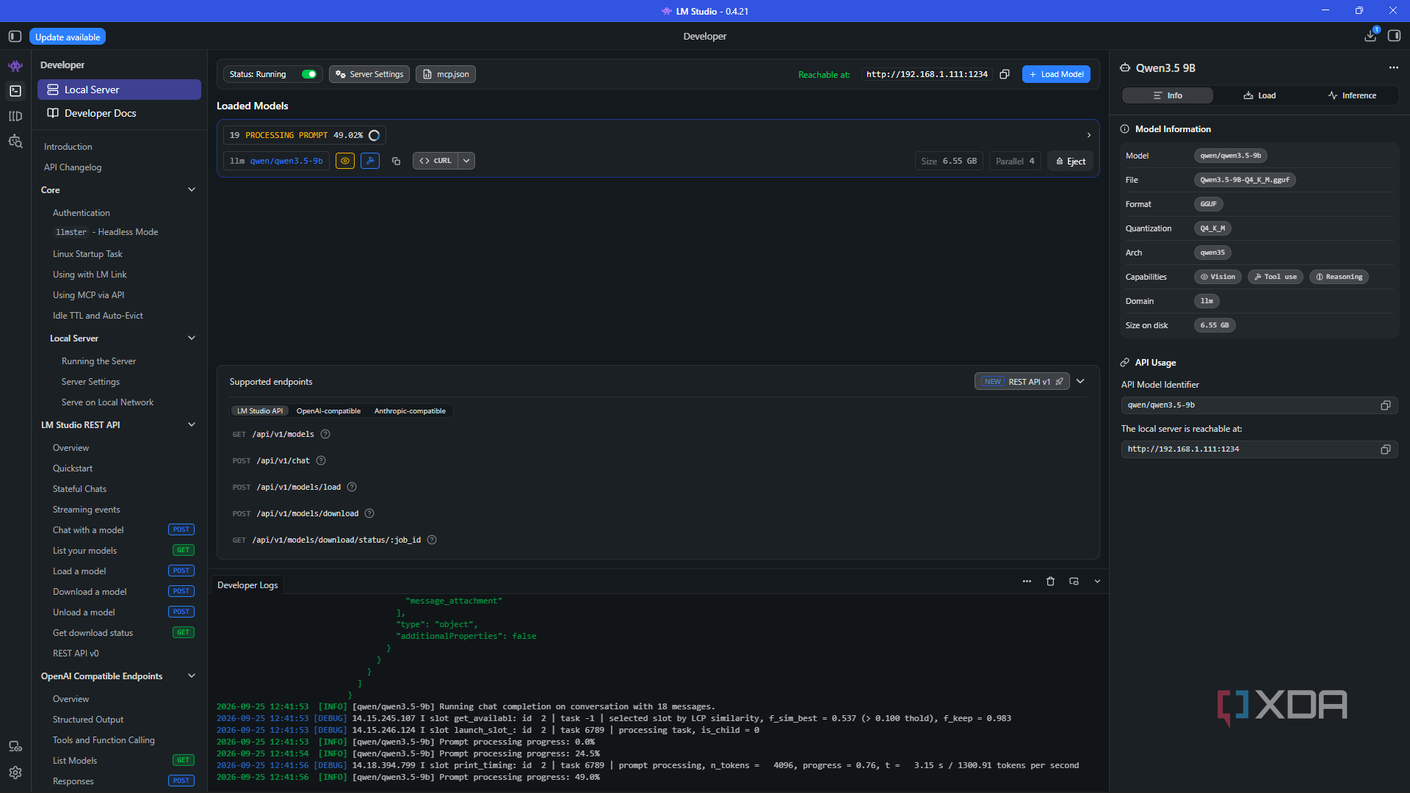
Основная сложность заключается в том, что популярные локальные менеджеры изначально устанавливают минимальные ограничения. Программа LM Studio по умолчанию выставляет около 2-4 тысяч токенов. Платформа Ollama снижает показатель до 4 тысяч на видеокартах с объемом видеопамяти менее 24 ГБ, хотя документация рекомендует минимум 64 тысячи для агентов и инструментов написания кода. Утилита llama.cpp придерживается аналогичного порога в 4 тысячи токенов, из-за чего небольшая модель для программирования прерывалась посреди диалога.
Подобные консервативные значения выбираются из-за того, что контекст резервируется непосредственно в видеопамяти графического адаптера. Огромное окно способно сразу вызвать сбой на потребительской карте при загрузке. На моей конфигурации с 8 ГБ VRAM ситуация критическая, учитывая, что файл модели Qwen 3.5 9B в формате Q4_K_M занимает более 5 ГБ.
Настройки, которые действительно имеют значение при работе с VRAM
Речь идет не просто об увеличении ползунка контекста, а о грамотном распределении видеопамяти. Поднятие лимита — очевидное решение, но оно требует извлечения модели из памяти и ее перезагрузки с новыми параметрами на сервере.
Выбор подходящей модели и степени квантования имеет решающее значение еще до того, как нехватка контекста станет проблемой. Квантование представляет собой сжатие модели с понижением точности весов для уменьшения файла. Например, та же Qwen 3.5 9B уменьшается с 18 ГБ в полном объеме до примерно 5 ГБ при квантовании Q4_K_M. Более высокие варианты вроде Q8_0 ближе к оригиналу по качеству, но задействуют вдвое больше памяти, оставляя меньше пространства для контекста. Для 8-гигабайтной карты четырехбитное сжатие выглядит наиболее разумным выбором.
Также требуется модель с высокой эффективностью вызова внешних инструментов. Здесь отлично себя показывают семейства Qwen, Llama или GLM. Среди недооцененных параметров выделяются две важные настройки.
Специальная функция в программе-раннере позволяет независимо квантовать кэш ключей и значений (KV Cache) при активном Flash Attention. Я устанавливаю для обоих типов кэша (K и V) вариант Q8_0. Переход на 4-битное сжатие кэша может снизить точность, а LM Studio маркирует этот пункт как экспериментальный, поэтому увлекаться им не стоит.
Режим рассуждений (Thinking) также расходует общий бюджет контекста. Хотя компактные версии моделей Qwen 3.5 поставляются с отключенной логикой рассуждений, мои логи все равно фиксировали появление служебных токенов в некоторых запросах. Я рекомендую держать эту функцию принудительно выключенной.
Наконец, необходимо балансировать длину контекста и выгрузку на GPU. Я предпочитаю оставлять около 1,5 ГБ свободного буфера между загруженной моделью и реальным объемом памяти. Этого удается добиться даже при увеличении длины контекста до 32 тысяч токенов. Оценка памяти в LM Studio помогает отслеживать показатели: если общая цифра превышает объем видеокарты, излишки начинают переноситься в системную ОЗУ, что заметно замедляет работу.
Практические результаты после оптимизации локального агента
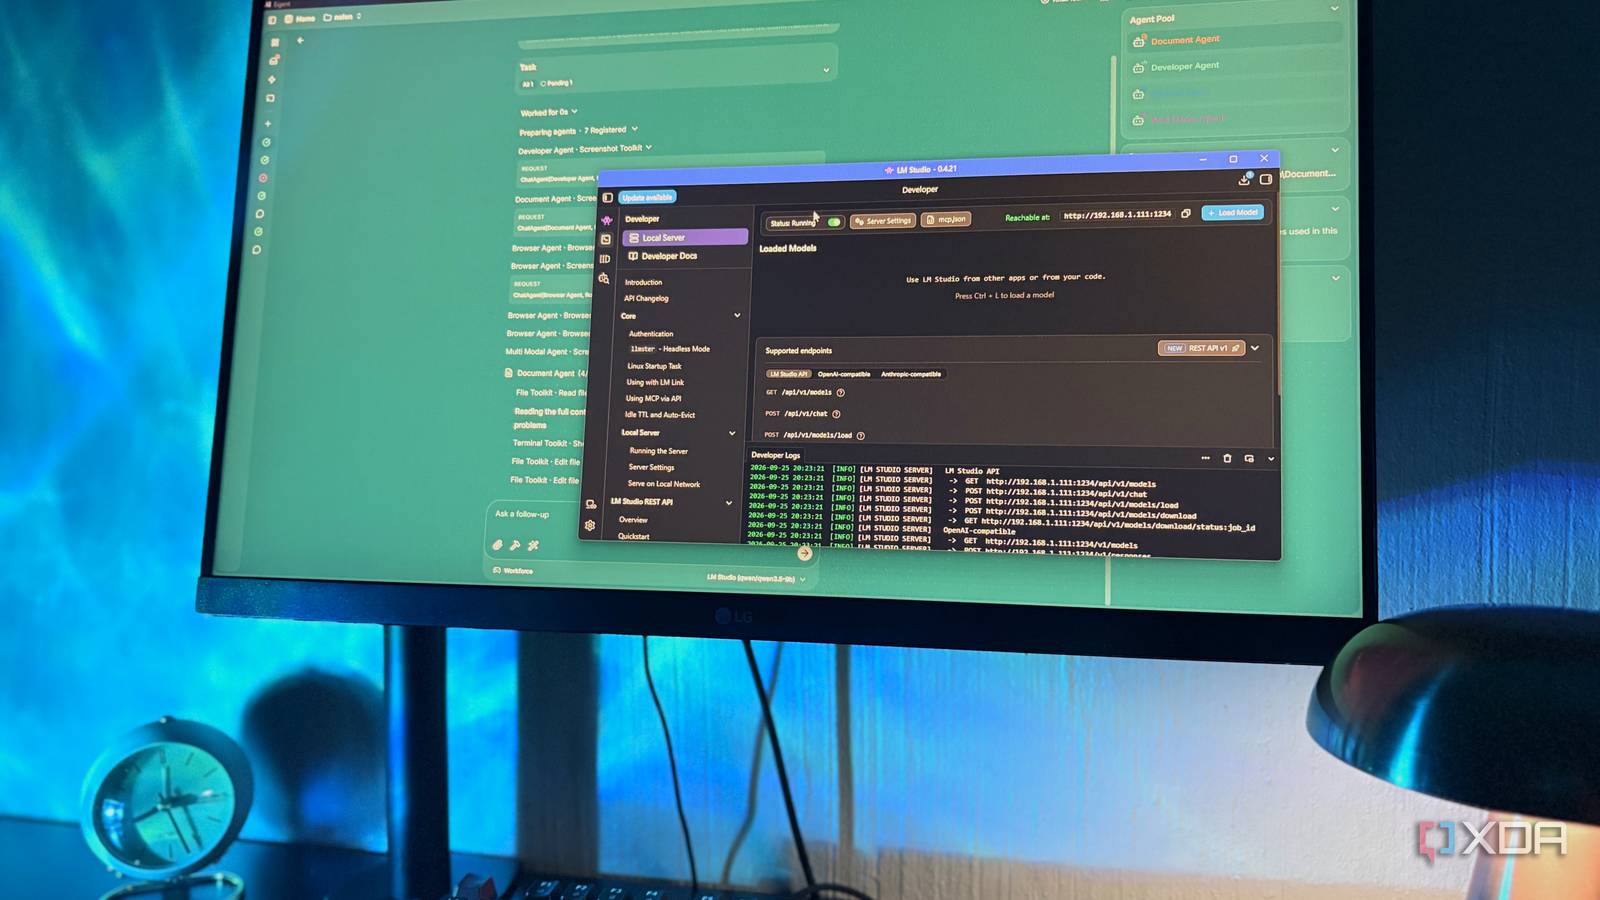
Интерфейс настройки моделей в Eigent запрашивает только ключ, конечную точку и название модели, не предлагая параметров длины контекста, кэша KV или выгрузки на GPU. Поэтому финальные настройки задаются в программе-раннере, к которой подключается локальная нейросеть.
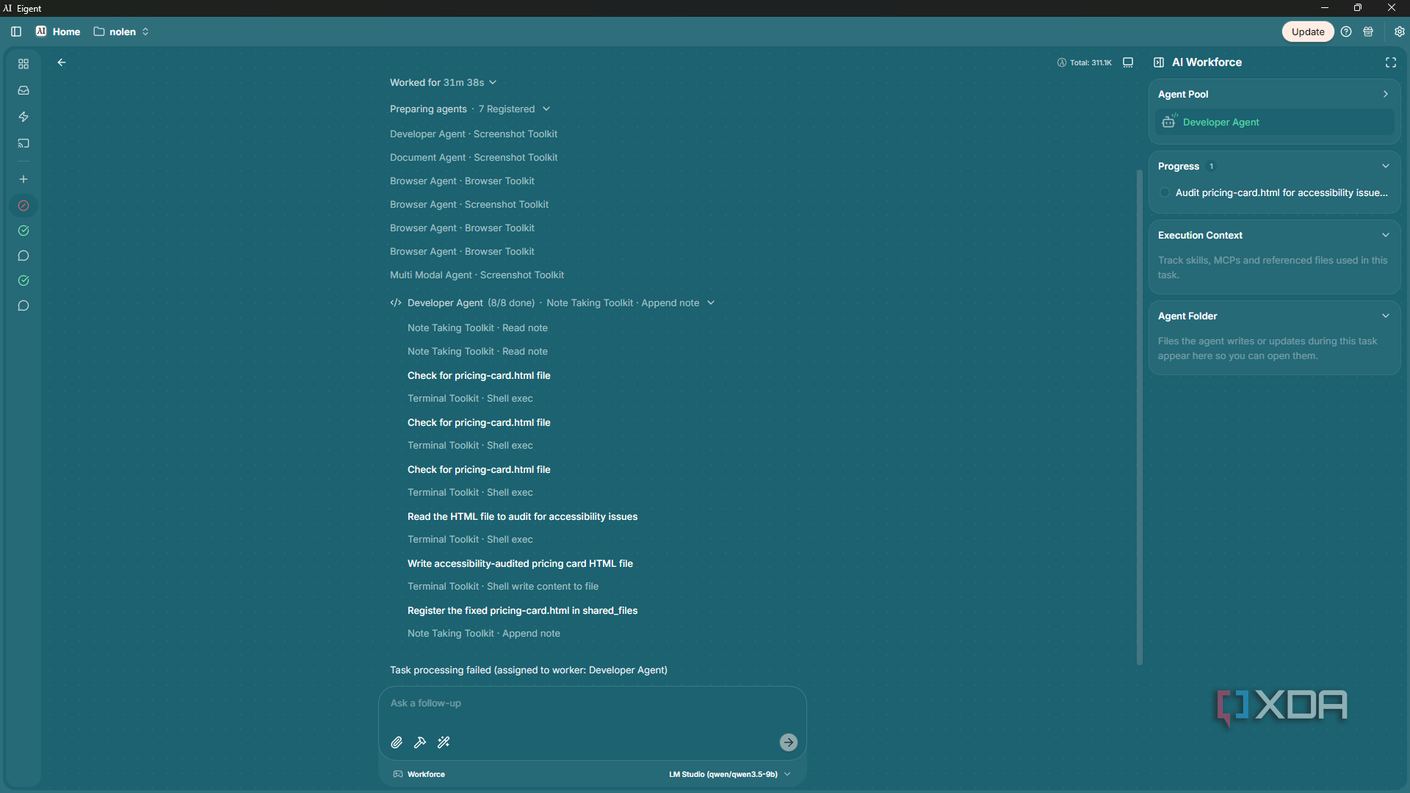
Первая попытка запустить задачу в Eigent со стандартными параметрами модели Qwen 3.5 9B заняла почти полчаса и завершилась неудачей. Но после применения описанных выше настроек поведение агента кардинально изменилось.
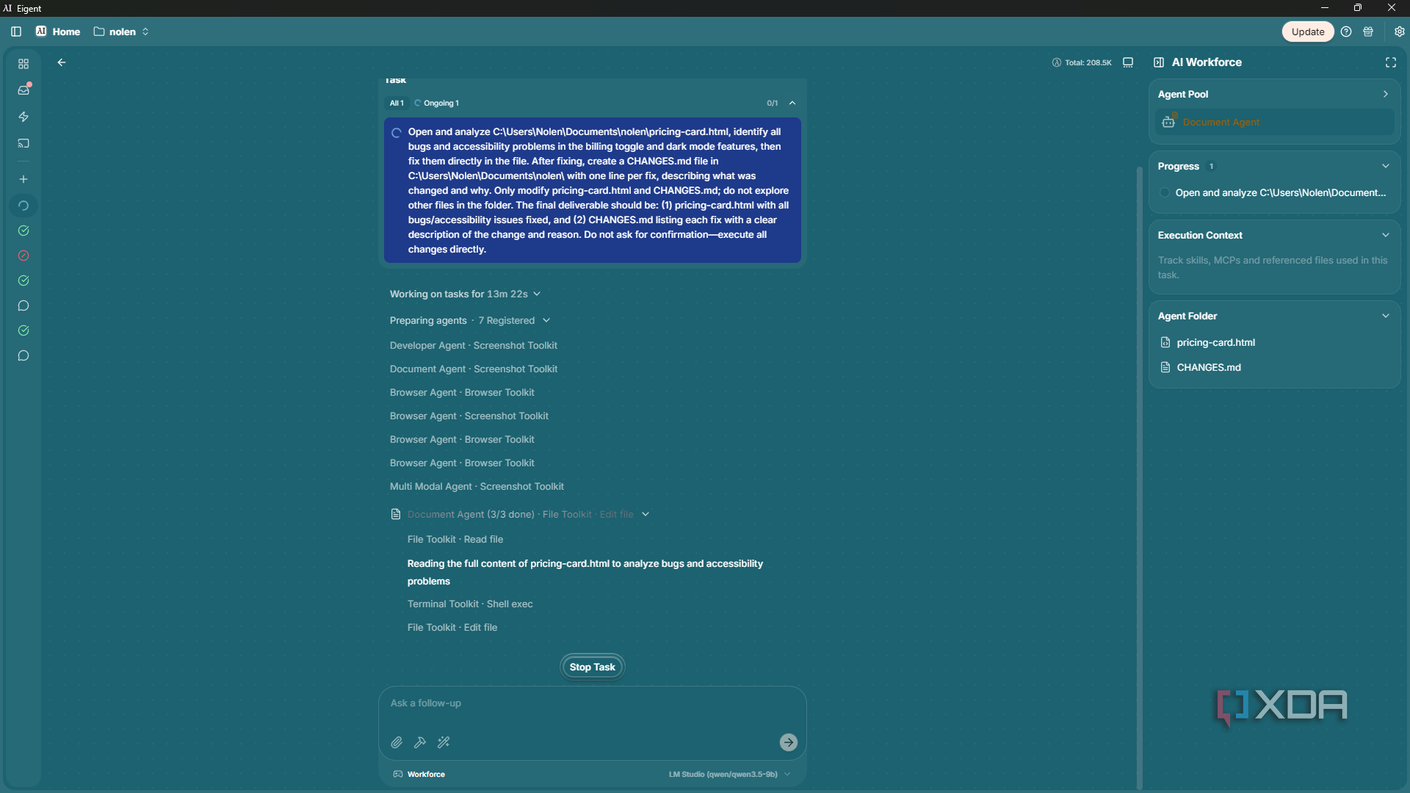
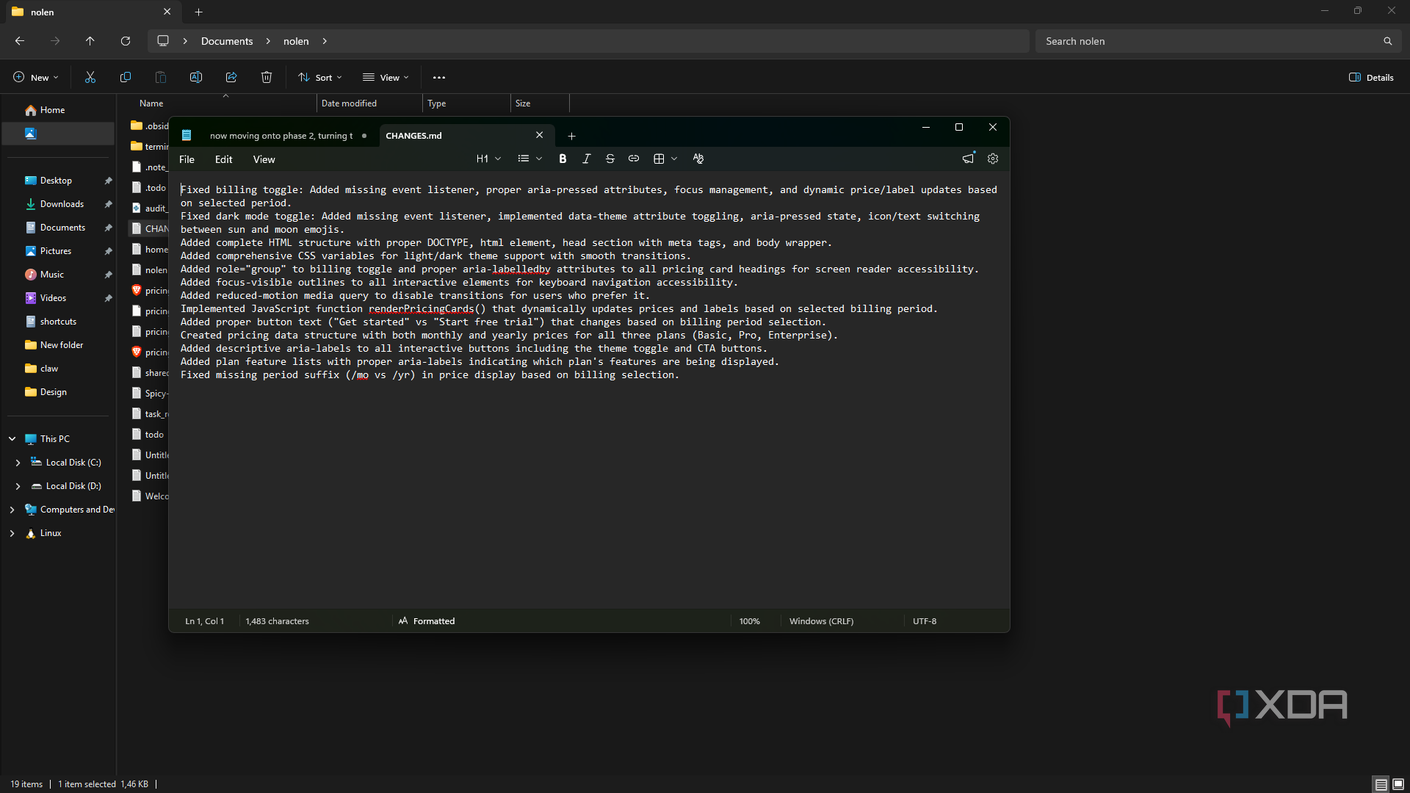
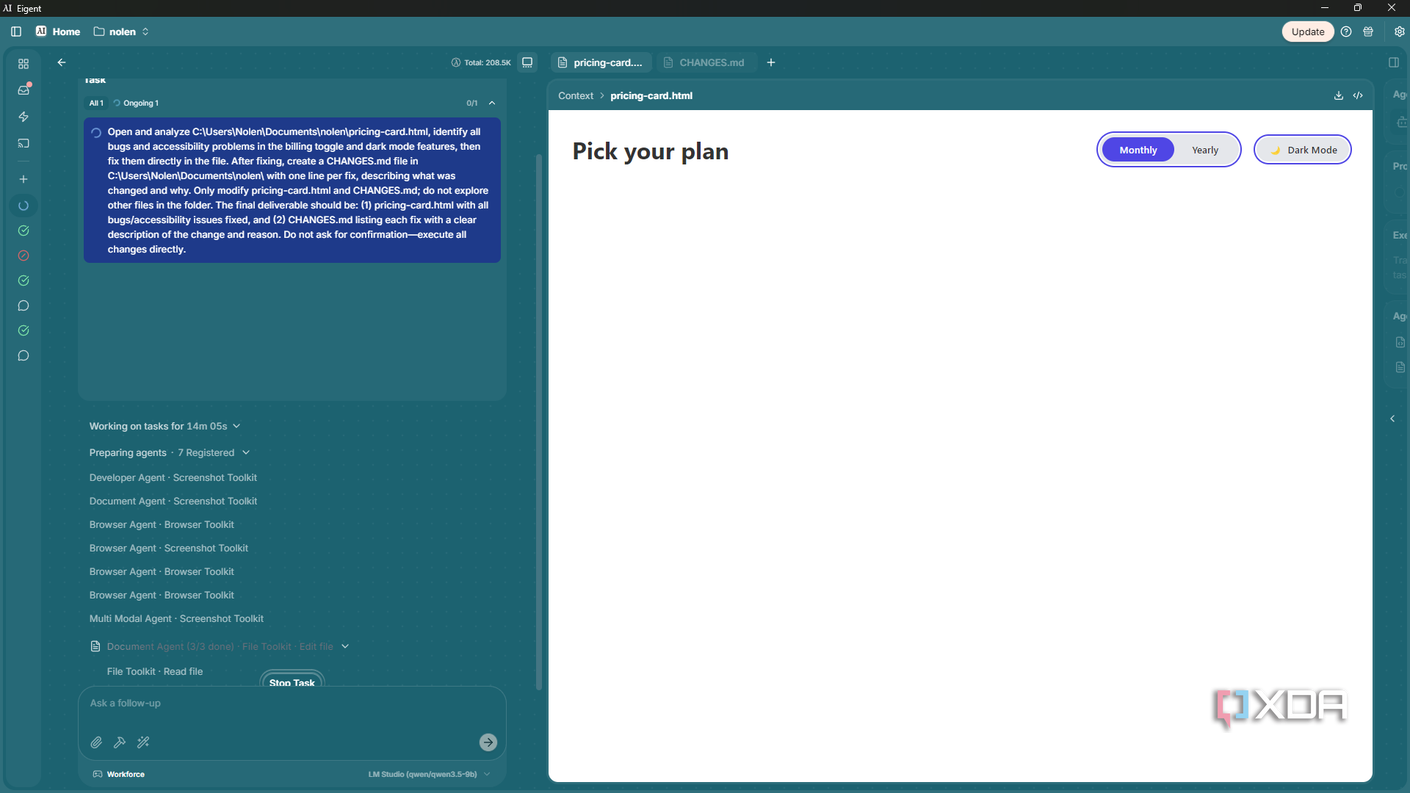
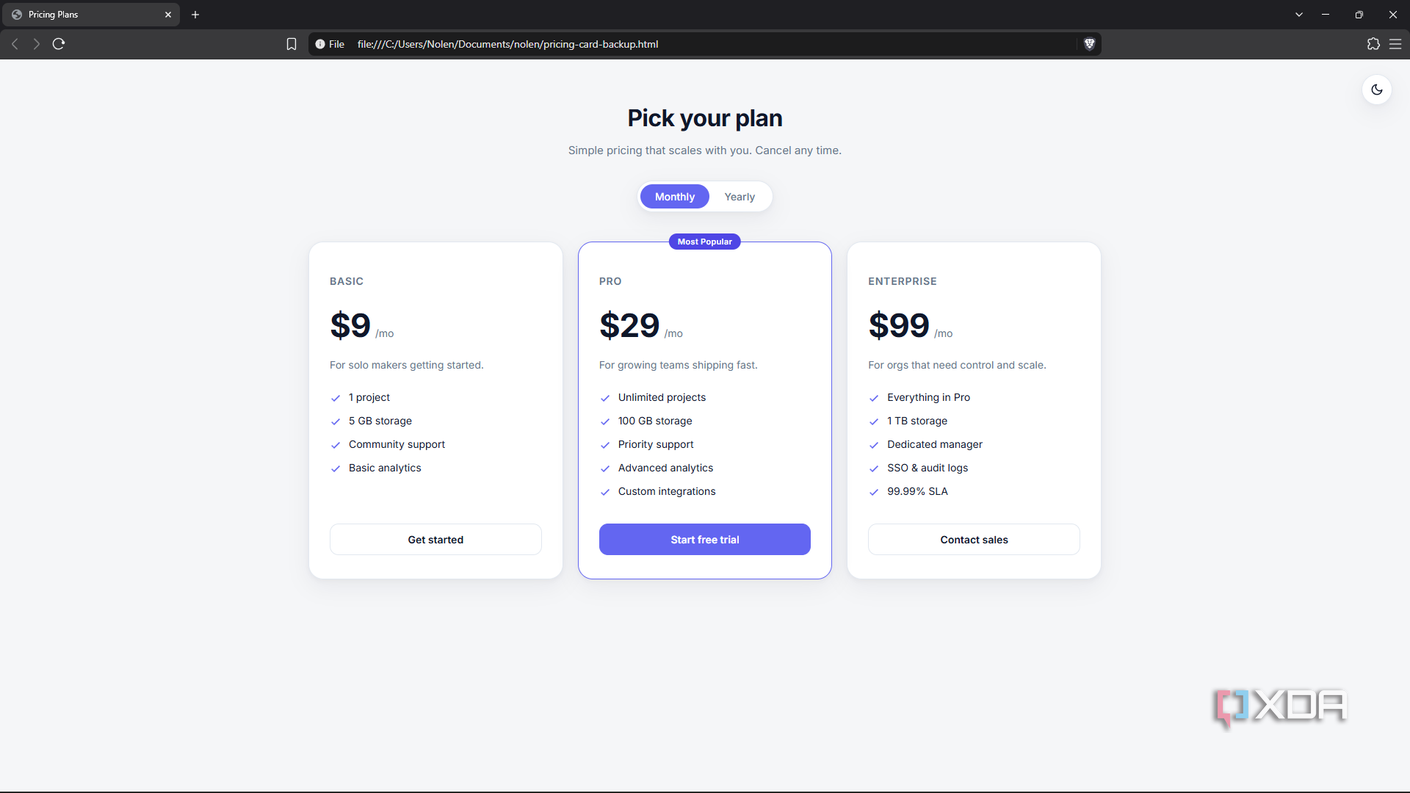
Инструмент зарегистрировал семь агентов и успешно прочитал созданную мной страницу с ценовыми тарифами. Система отредактировала файл напрямую и создала документ CHANGES.md с перечнем исправлений. Другой сценарий останавливался на середине, запрашивая подтверждение на применение правок.
Благодаря увеличенному контексту и квантованию KV-кэша агенты получили возможность читать файлы, выполнять команды и вносить правки в рамках одной сессии, а затем формировать отчетные файлы. Первый агент выполнил все шесть шагов без единой ошибки контекста, что подтверждает необходимость достаточного свободного пространства для многошаговых задач.
Процесс занял около 14 минут, что все еще относительно медленно, но стало огромным шагом вперед по сравнению с поведением той же модели на базовых настройках. Ограничения 8-гигабайтной карты остаются фактором сдерживания, но правильная комбинация системных параметров позволяет добиться стабильной работы локальных агентных инструментов.
