
Мой блог
Локальная транскрибация аудио в текст: почему одной нейросети мало для русской речи с терминами

Когда рабочие созвоны содержат конфиденциальные данные, бюджеты и обсуждения внутренних проектов, использование облачных сервисов распознавания речи становится небезопасным. В таких сценариях единственным надежным решением остается локальная транскрибация аудио в текст, при которой файлы не покидают компьютер пользователя. Однако на практике выясняется, что ни одна популярная нейросеть в одиночку не способна одинаково качественно расшифровать бытовую русскую речь и специфический технический сленг.
В детальном исследовании автора проекта «Рекордер» была поставлена задача создать автономный пайплайн для macOS. Для этого разработчик протестировал 32 конфигурации распознавания, сопоставив возможности популярных архитектур Whisper, Parakeet и GigaAM на реальных записях рабочих встреч. Итогом работы стало создание двухмодельного каскада, позволившего уменьшить суммарный уровень ошибок WER с 27,0% до 21,7%.
Причины отказа от облачных решений и первичный выбор архитектур
Большинство готовых инструментов для расшифровки встреч работают через внешние серверы либо отправляют аудиопотоки в API OpenAI или Anthropic. Передача корпоративных переговоров сторонним провайдерам несет прямые риски утечки конфиденциальной информации. Поэтому главным критерием отбора стала полностью автономная работа на устройстве.
Среди открытых решений, которые активно применяются в офлайн-приложениях вроде MacWhisper, Buzz или SuperWhisper, базовым ориентиром долгое время считалось семейство моделей Whisper. Однако при обработке смешанной русско-английской речи Whisper работает относительно медленно и регулярно ошибается. Изучение открытых бенчмарков и публикаций подтолкнуло к более глубокому сравнению трех ключевых кандидатов: Whisper (в версиях large-v2, large-v3 и turbo), Parakeet TDT v3 от NVIDIA и отечественной модели GigaAM-v3. Позже к тестам добавили Breeze-ASR и Qwen3-ASR.
Субъективный анализ первых расшифровок показал выраженную специализацию каждой модели:
- GigaAM-v3 демонстрирует высокую точность на естественном русском языке и корректно расставляет знаки препинания, но практически полностью теряет англоязычные ИТ-термины и продуктовые наименования.
- Parakeet TDT v3 отлично распознает технический сленг, англицизмы и латиницу, выполняя вычисления вчетверо быстрее аналогов, однако результирующий русский текст уступает по грамматической стройности.
- Whisper способен улавливать мелкие детали контекста, но требует значительно больше аппаратных ресурсов, медленнее работает на процессоре и нередко страдает галлюцинациями, дописывая в расшифровку фразы, которых не было в оригинале.
Методика тестирования моделей ASR и подготовка датасета
Для перехода от субъективных впечатлений к объективным замерам был собран специализированный аудиосет общей продолжительностью 1 час 38 минут, содержащий 8,7 тысячи размеченных слов. В него вошли четыре изолированных сегмента:
- Рабочие созвоны: 82 проблемных фрагмента, где нейросети давали наибольшие расхождения, дополненные 82 случайными записями для баланса (суммарно 24 минуты, доля терминов около 5%).
- ИТ-доклады и диалоги: аудиозаписи с высокой концентрацией технической лексики (24 минуты, доля терминов около 41%).
- Связный рассказ: начитанный двумя дикторами текст об умных устройствах, сочетающий бытовой язык и терминологию (24 минуты, доля терминов около 14%).
- Синтетические данные: озвученные через Silero TTS фразы с профильными терминами (26 минут). Из-за неестественного распределения метрик синтетика в итоговых оценках не учитывалась.
Замеры проводились на процессоре Intel Core i9 без использования графического ускорителя. Аудиопоток предварительно разрезался на сегменты длиной до 20 секунд по естественным паузам с помощью детектора активности речи Silero VAD. Базовым критерием точности выступал WER (Word Error Rate), оценивающий долю замен, пропусков и лишних слов по отношению к эталонному тексту после приведения к нижнему регистру и удаления пунктуации.
Результаты тестов одиночных моделей распознавания
Сравнение на размеченном материале подтвердило, что универсального фаворита среди одиночных систем не существует. Каждая нейросеть имеет узкую специализацию, что наглядно отражено в показателях WER (чем ниже процент, тем чище текст):
- GigaAM-v3 e2e: показала лучший результат на бизнес-встречах (14,8%), но провалилась на насыщенной терминами ИТ-речи (52,9%). Суммарный WER составил 27,0%.
- Parakeet TDT 0.6B v3: продемонстрировала 24,6% на встречах, 40,0% на ИТ-терминах и 13,9% на смешанном тексте, показав лучший баланс со средним WER 24,6%.
- Whisper large-v2: зафиксировала 30,1% на встречах и 39,0% на технической лексике. Общий результат — 24,8%.
- Whisper large-v3: уступила предшественнице на англицизмах (59,8%), хотя на обычных созвонах оказалась чуть точнее (27,1%). Суммарная ошибка выросла до 30,3%.
- Breeze-ASR-25: дообученная модель показала отличную работу на подготовленном связном материале (9,6%), но на живых неподготовленных диалогах допустила 35,4% ошибок.
Квантование моделей до форматов Q8 и Q6_K практически не повлияло на точность. У Parakeet показатель WER на встречах сместился с 24,6% на F32 до 25,5% на Q8 и 25,7% на Q6_K, что открывает возможность запускать вычисления на менее производительных процессорах без критической деградации качества.
Ограничения метрики WER и фонетическая нормализация
Классический алгоритм подсчета WER одинаково штрафует систему за пропуск междометия и за искажение критически важного термина. Например, расшифровка «эластик» вместо Elastic в рамках формальной метрики считается грубой ошибкой, хотя для читателя смысл реплики сохраняется полностью.
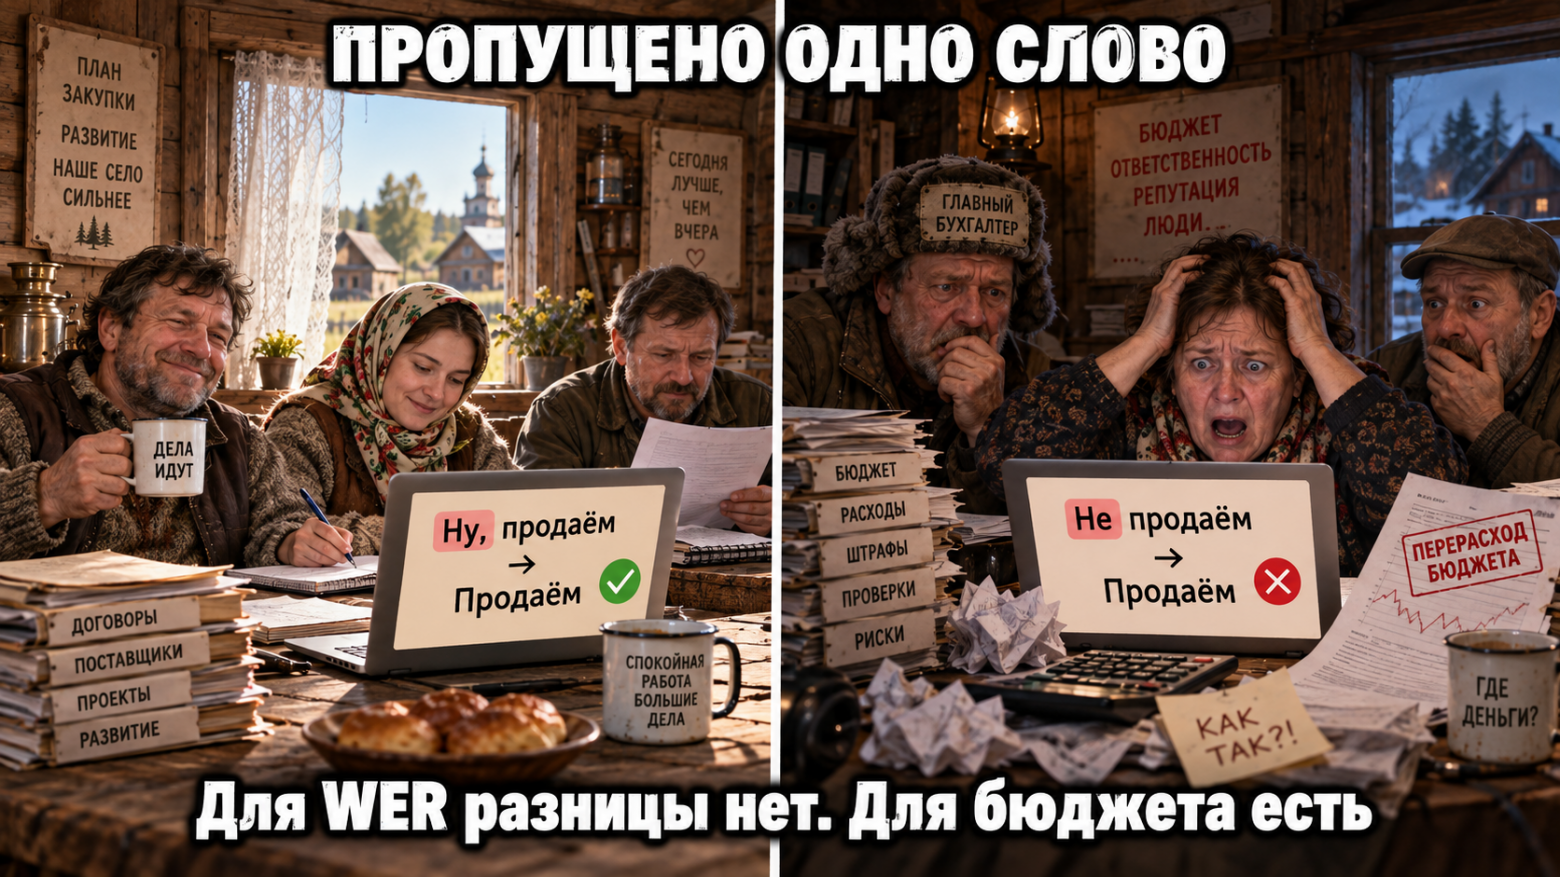
Чтобы вычленить реальные семантические сбои, автор первоисточника внедрил вспомогательный алгоритм фонетической оценки (WERx). Логика скрипта переводит латинские слова в кириллический фонетический ключ (устраняя дефисы, пробелы и мягкие знаки) и сравнивает созвучие согласных. При такой оценке «Cloud-MD» и «клауд мд» признаются идентичными.
Анализ по WERx показал, что у GigaAM на ИТ-материале ошибка снизилась с 52,9% до 40,6%, а доля правильно сохраненных терминов составила всего 19%. У Parakeet показатель WERx улучшился с 40,0% до 30,7% (при 47% точных терминов), а у Whisper large-v2 — с 39,0% до 30,3% (54% точных терминов). Это подтвердило: проблемы GigaAM вызваны не только написанием названий кириллицей, но и физической неспособностью разобрать иностранную лексику на слух.
Каскадный пайплайн: объединение GigaAM и Parakeet
Для преодоления ограничений отдельных систем была разработана двухэтапная схема обработки звука. За основу расшифровки берется результат GigaAM, сформированный на чистом русском языке. Параллельно аудиопоток обрабатывается легковесной и быстрой моделью Parakeet.
Специальный алгоритм сопоставляет оба полученных текста, находит расхождения и точечно подставляет вариант из Parakeet, если соблюдены два условия: кандидат содержит латиницу и фонетически близок к соответствующему кириллическому отрезку GigaAM. При оптимально подобранном коэффициенте сходства 0,4 каскад продемонстрировал следующие показатели:
- На бизнес-встречах WER составил 14,5% (против 14,8% у чистой GigaAM).
- На техническом датасете ошибка сократилась до 41,9% (против 52,9% у GigaAM), а процент корректно распознанных терминов вырос более чем в два раза — с 19% до 44%.
- На связном комбинированном тексте WER упал до 12,0%, превзойдя обе модели, работавшие порознь (16,3% у GigaAM и 13,9% у Parakeet).
Инверсия ролей, когда за основу брался текст Parakeet с последующей правкой через GigaAM, показала худшие результаты из-за высокого уровня ошибок в базовой русской лексике. Скорость работы финального каскада составила около RTF 0,3 на процессоре Intel, что соответствует 18 минутам фонового вычисления на один час аудиодорожки.
В тестах на роль «модели-корректора» также проверялся Whisper medium. Он обеспечил суммарный WER на уровне 21,4%, но потребовал втрое больше времени на обработку (RTF до 0,68), поэтому Parakeet был выбран как более сбалансированный инструмент по соотношению точности и нагрузки на систему.
Неудачные эксперименты при оптимизации транскрибации
В процессе экспериментов несколько интуитивно понятных инженерных решений показали отрицательный результат на контрольных данных:
- Жесткие словари терминов: подстановка известных слов по словарю из 8 130 позиций на тестовых файлах убирала ошибки, но на длинных архивах приводила к ложным срабатываниям. Например, союз «нет» автоматически заменялся на «.NET» сотни раз, а местоимение «нас» — на сетевую аббревиатуру «NAS». Положение исправила лишь фильтрация замен по частотным словарям.
- Нарезка аудио с перекрытием (overlap): добавление двухсекундного нахлеста между 20-секундными фрагментами улучшило распознавание коротких фраз на 0,4%, однако на цельных записях подняло WER с 30,8% до 31,3% из-за артефактов на границах склейки.
- Текстовые системные промпты: попытка подсказать модели Whisper правила записи терминов снизила ошибку на ИТ-лексике с 59,8% до 58,1%, но на обычных диалогах обрушила точность — WER подскочил с 27,1% до катастрофических 66,7%.
- Машинное обучение для селектора замен: отдельная ML-метрика повысила AUC с 0,926 до 0,941, но не улучшила итоговый WER каскада, поскольку ошибочные и корректные варианты зачастую обладают абсолютно идентичным фонетическим профилем.
Практическое воплощение в утилите «Рекордер»
Архитектурные выводы легли в основу бесплатного инструмента для macOS. Чтобы избежать компромиссов при записи многопользовательских конференций в Zoom, Google Meet или Яндекс Телемосте, программа захватывает звук через системный фреймворк ScreenCaptureKit без необходимости ставить виртуальные кабели или добавлять в звонки сторонних ботов.
Утилита разделяет звук на два независимых физических канала: микрофон владельца и системный вывод собеседников. Такое разделение упрощает диаризацию (определение того, кто говорит), исключая фазу распутывания единого сведенного трека. Пользователь сразу получает черновой связный текст от первой нейросети, после чего второй слой исправлений автоматически вносит уточненные англицизмы и бренды в фоновом режиме.
