
Мой блог
Как настроить автономный переводчик на видеокарте с помощью локальных нейросетей

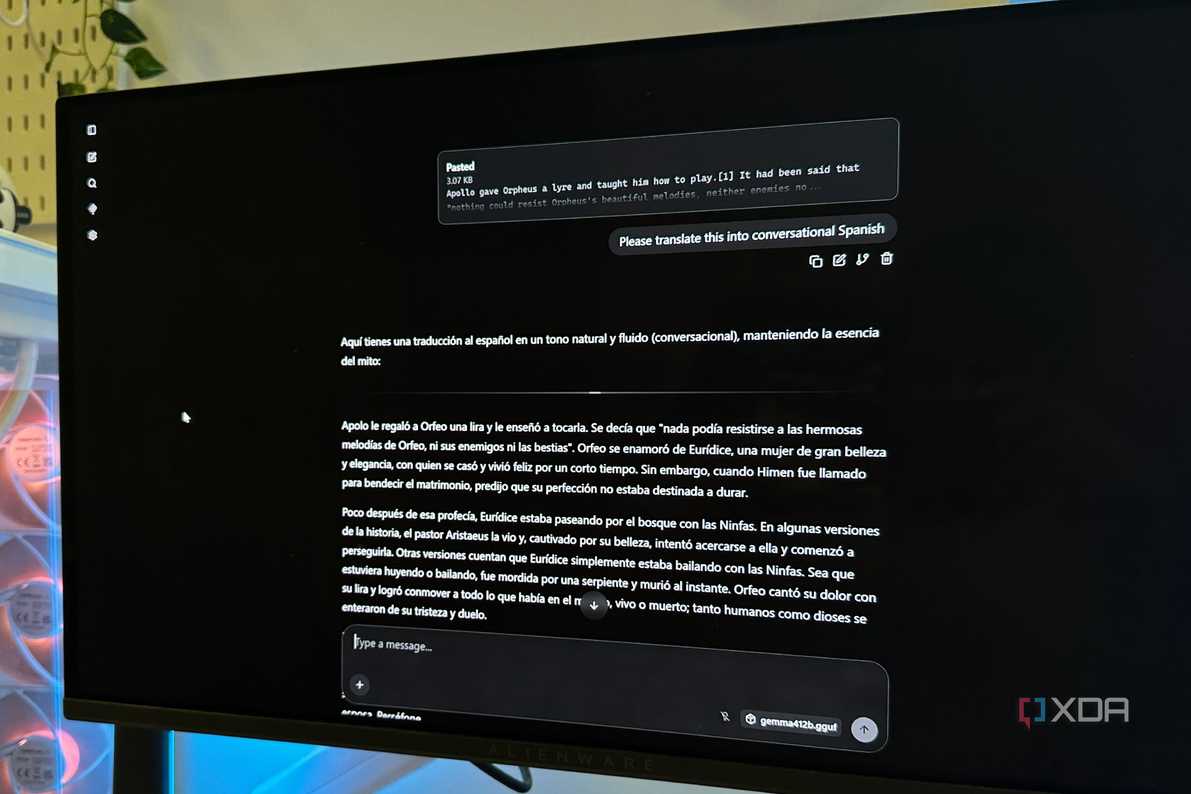
Популярные облачные переводчики давно стали привычным инструментом для быстрого перевода текстов, но развитие локальных языковых моделей позволяет развернуть аналогичную систему прямо на собственном компьютере. В материале рассматривается практический опыт создания автономного сервиса перевода, который работает без подключения к интернету, задействуя вычислительную мощность видеокарты.

Традиционные облачные решения удобны для повседневных задач, однако они имеют ряд ограничений. Главным минусом является зависимость от стабильного интернет-соединения, так как официальные офлайн-пакеты часто уступают по качеству полноценным онлайн-версиям. Кроме того, отправка конфиденциальных документов, коммерческих контрактов или материалов под NDA на сторонние серверы не всегда допустима по соображениям безопасности. Локальный запуск моделей решает эту проблему, обеспечивая полный контроль над обрабатываемыми данными.
Альтернатива облачным сервисам и причины отказа от стандартных инструментов
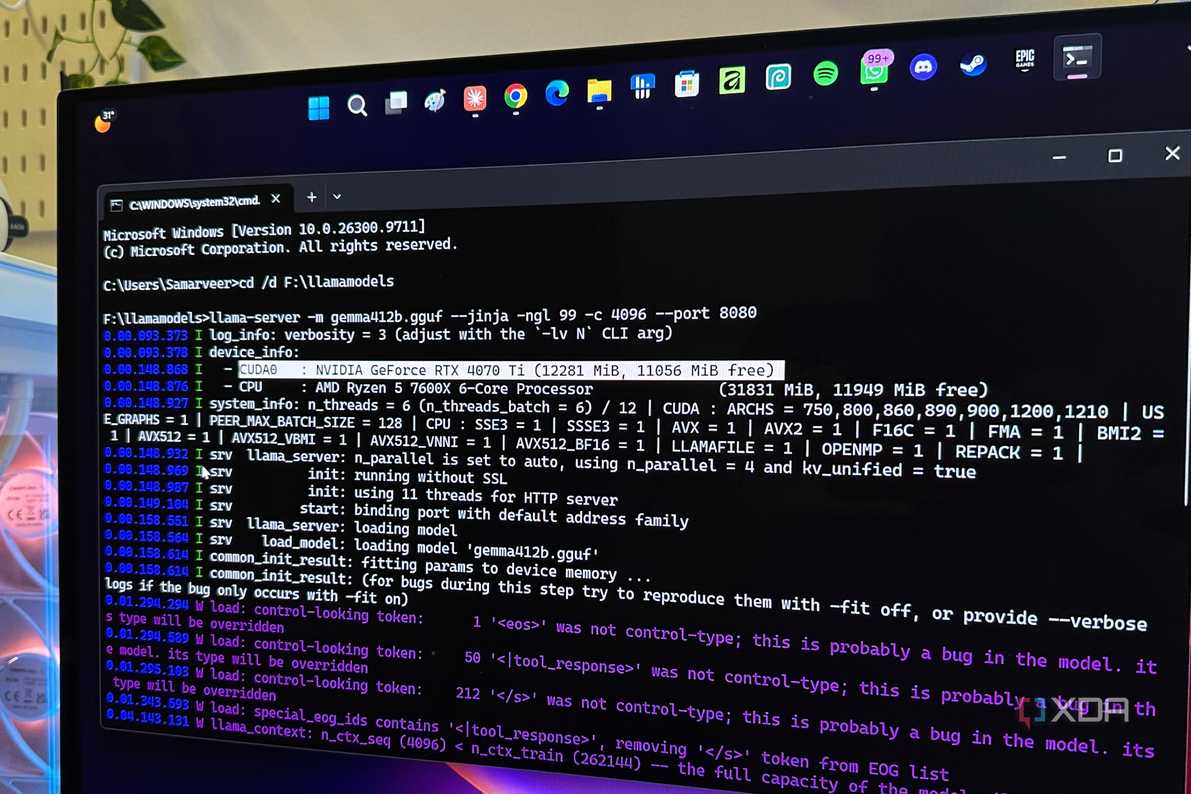
Для реализации проекта используется связка из нескольких компонентов: серверного движка llama.cpp для запуска моделей, непосредственно самих файлов нейросетей и специального расширения для браузера, связывающего инфраструктуру с веб-интерфейсом.
Архитектура локальной системы перевода
Выбор пал на llama.cpp, поскольку его встроенный сервер предоставляет готовый эндпоинт, совместимый с выбранным браузерным расширением. При объеме видеопамяти в 12 ГБ на графическом ускорителе RTX 4070 Ti необходимо подбирать модели оптимального размера, чтобы они целиком помещались в VRAM и не обращались к более медленной системной оперативной памяти. В ходе экспериментов были отобраны Gemma 4 12B (Q4_K_M) и Qwen3.5-9B (Q5_K_M), способные справиться с различными языковыми парами.
Интеграция в браузер через расширение Margin
После активации llama.cpp с поддержкой аппаратного ускорения на GPU и запуска веб-интерфейса настраивается взаимодействие с браузером. Для этого устанавливается расширение Margin, которое позволяет напрямую обращаться к локальному серверу для перевода веб-страниц «на лету».
Вместо ручного копирования текста в интерфейс генеративной модели расширение само отправляет запросы на локальный адрес. Для европейских языков успешно применяется Gemma, обеспечивающая естественное звучание текста без потери контекста. В свою очередь, для работы с восточными языками, такими как китайский, японский или корейский, более эффективной оказывается модель Qwen3.5, сохраняющая высокую грамматическую точность.
Сценарии использования и преимущества автономного подхода
Полноценный перенос процессов на локальное железо актуален не для каждого пользователя, поскольку для перевода простых фраз или меню стандартные облачные сервисы по-прежнему остаются проще. Однако работа с технической документацией, специализированными исследованиями или юридической документацией требует максимальной конфиденциальности.
Помимо приватности, языковые модели предоставляют гибкость, недоступную обычным переводчикам. Пользователь может явно задать требуемый тон сообщения, сохранить специфическую терминологию, объяснить культурные нюансы или отредактировать текст в диалоговом режиме до достижения желаемого результата. Подобный подход превращает игровой ПК в универсальный инструмент для работы с текстом без необходимости доверять сторонним облачным платформам.
