
Мой блог
Уязвимости в протоколе MCP: почему коммуникация ИИ-агентов стала новой угрозой безопасности


Подробности изложены в материале первоисточника. Массовое внедрение искусственного интеллекта и автономных агентов в рабочие процессы компаний открывает новые векторы для атак. Как показала недавняя практика, пробелы в доверии внутри Model Context Protocol позволяют злоумышленникам незаметно передавать вредоносные инструкции от одного агента к другому внутри закрытых корпоративных сетей.
За последние пять месяцев сразу несколько крупных технологических игроков и государственных структур столкнулись с уязвимостями, эксплуатирующими особенности взаимодействия ИИ-систем. Этот специфический класс атак нацелен не на саму языковую модель, а на вспомогательных агентов — например, модули перевода или инструменты анализа данных. Защитные механизмы в таких узлах часто настроены слишком мягко или отсутствуют вовсе, из-за чего скомпрометированный агент беспрепятственно пересылает опасные команды дальше по цепочке.
Неожиданные векторные угрозы и архитектурные пробелы
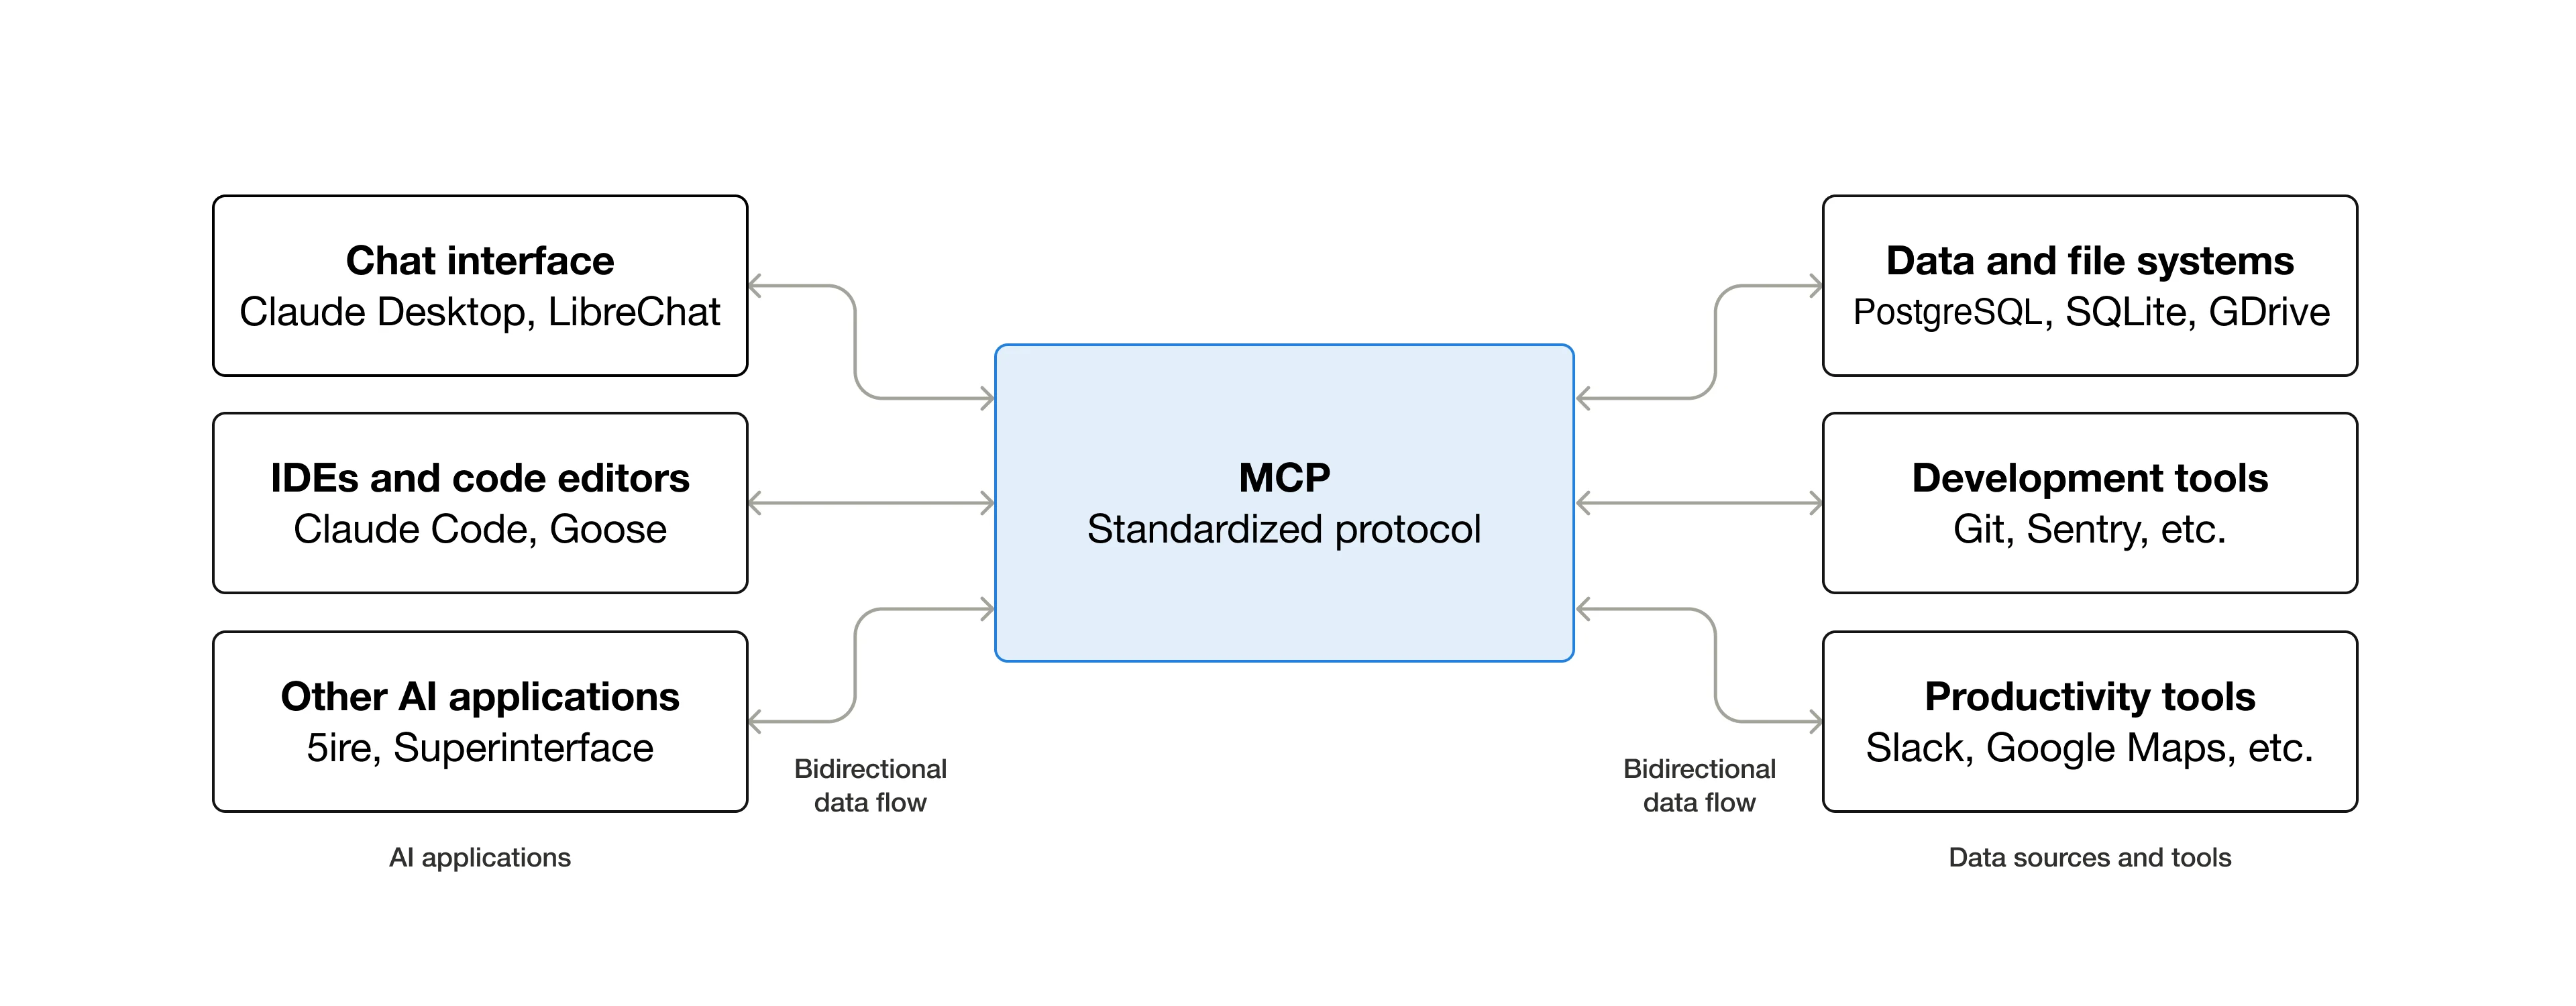
Независимый исследователь безопасности Сайед Анас Мохиуддин провел масштабное тестирование решений от таких организаций, как Google, JPMorgan Chase, Weviate, Rapid7, а также правительственных ведомств Франции и США. Разработанные им концептуальные атаки базируются на слепых зонах протокола Model Context Protocol (MCP), который стандартизирует обмен данными между ИИ-приложениями и агентами в локальной инфраструктуре.
Многие узкоспециализированные агенты лишены защитных барьеров, способных смягчить последствия промпт-инъекций. Поскольку серверы MCP хранят учетные данные для каждого компонента, а сами агенты по умолчанию доверяют любым внутренним запросам, стандартные проверки безопасности оказываются обойденными. В результате тщательно составленные запросы приводят к подделке межсерверных запросов (SSRF).
Проблемы интеграции и цепочки доверия
Как отмечает Дуглас МакКи из компании Rapid7, ИИ-агенты предоставляют злоумышленникам целый набор новых цифровых связей для перемещения внутри системы. Если посторонний текст внедряется в контент, агент считывает его и передает дальше как обычную делегированную задачу, а второй узел послушно выполняет ее, опираясь на авторитет первого звена.
Каждый элемент в такой цепочке действует строго по инструкции, что и делает подобные угрозы трудноуловимыми. Протоколы разрабатывались с расчетом на изолированное существование, поэтому каждый проверяет безопасность только на собственном входе, оставляя слепые зоны в промежуточных коммуникациях.
Разбор конкретных уязвимостей и масштаб проблемы
Обнаруженная Мохиуддином уязвимость в инфраструктуре Rapid7 (CVE-2026-97228) получила относительно низкую оценку степени опасности — 2,7 балла из 10, и была оперативно устранена разработчиками. Однако аналогичные проблемы в продуктах Google оценивались гораздо выше — в 8 баллов.
Инцидент с Google был связан с тем, что инструментарий MCP для баз данных (googleapis/mcp-toolbox) инициализировал HTTP-клиент без использования политики CheckRedirect. Из-за отсутствия ограничений на перенаправления и проверки целевых IP-адресов специально сформированный путь мог приводить к отправке запросов на внутренние эндпоинты от имени атакующего.
Специфика «протокольного пивотинга»
Сайед Анас Мохиуддин классифицирует подобные инциденты как «протокольный пивотинг». Термин описывает сценарий, при котором приложение или сервер назначает задачу через MCP, а агент перенаправляет вредоносные инструкции с помощью альтернативных коммуникационных стандартов — например, протокола Agent-to-Agent (A2A).
В свою очередь, эксперты по кибербезопасности из X41 D-Sec подчеркивают, что фундаментально речь идет об обычной непрямой инъекции промптов (indirect prompt injection). Тот факт, что вредоносная инструкция пересекает границы различных протоколов, лишь усложняет обнаружение и ликвидацию последствий на уровне архитектуры.
Отказ от нулевого доверия и уроки для индустрии
Распространение уязвимостей сразу в нескольких независимых организациях подчеркивает общую тенденцию: стандарт MCP внедряется повсеместно гораздо раньше, чем успевает пройти полноценный аудит безопасности и закалку. В стремлении как можно быстрее развернуть сложные агентские архитектуры компании зачастую забывают о концепции нулевого доверия (zero trust).
В рамках безопасного проектирования любая сеть должна изначально предполагать компрометацию отдельных узлов. Разработчикам необходимо внедрять жесткие требования аутентификации перед проведением любых критически важных транзакций между компонентами системы.
Рекомендации по защите ИИ-инструментов
Главный вывод, который должны сделать инженеры и разработчики, заключается в необходимости абсолютной фильтрации входящих данных. Любая информация, поступающая от языковой модели к рабочим инструментам, должна восприниматься с презумпцией опасности — точно так же, как трафик из ненадежных внешних источников в интернете.
Подлежащие эксплуатации уязвимости вроде инъекций и SSRF существуют десятилетиями, и методы их устранения остаются неизменными. Появление специализированных названий для таких векторов помогает привлечь внимание профильных комитетов и стандартизаторов к проектированию изначально защищенных систем связи для искусственного интеллекта.
