
Мой блог
Meta представила Muse Voice Transcribe: единую ИИ-модель для потокового распознавания речи, диаризации и отслеживания пауз

Большинство современных продакшен-систем для голосовой аналитики и диалогового ИИ представляют собой сборку из трех независимых компонентов. Первая модель отвечает за расшифровку аудио в текст (ASR), вторая занимается разделением спикеров (диаризацией), а третий модуль отслеживает паузы и момент, когда пользователь закончил говорить (endpointing). Каждая передача данных между этими звенами неизбежно увеличивает задержку обработки и создает дополнительные точки отказа.
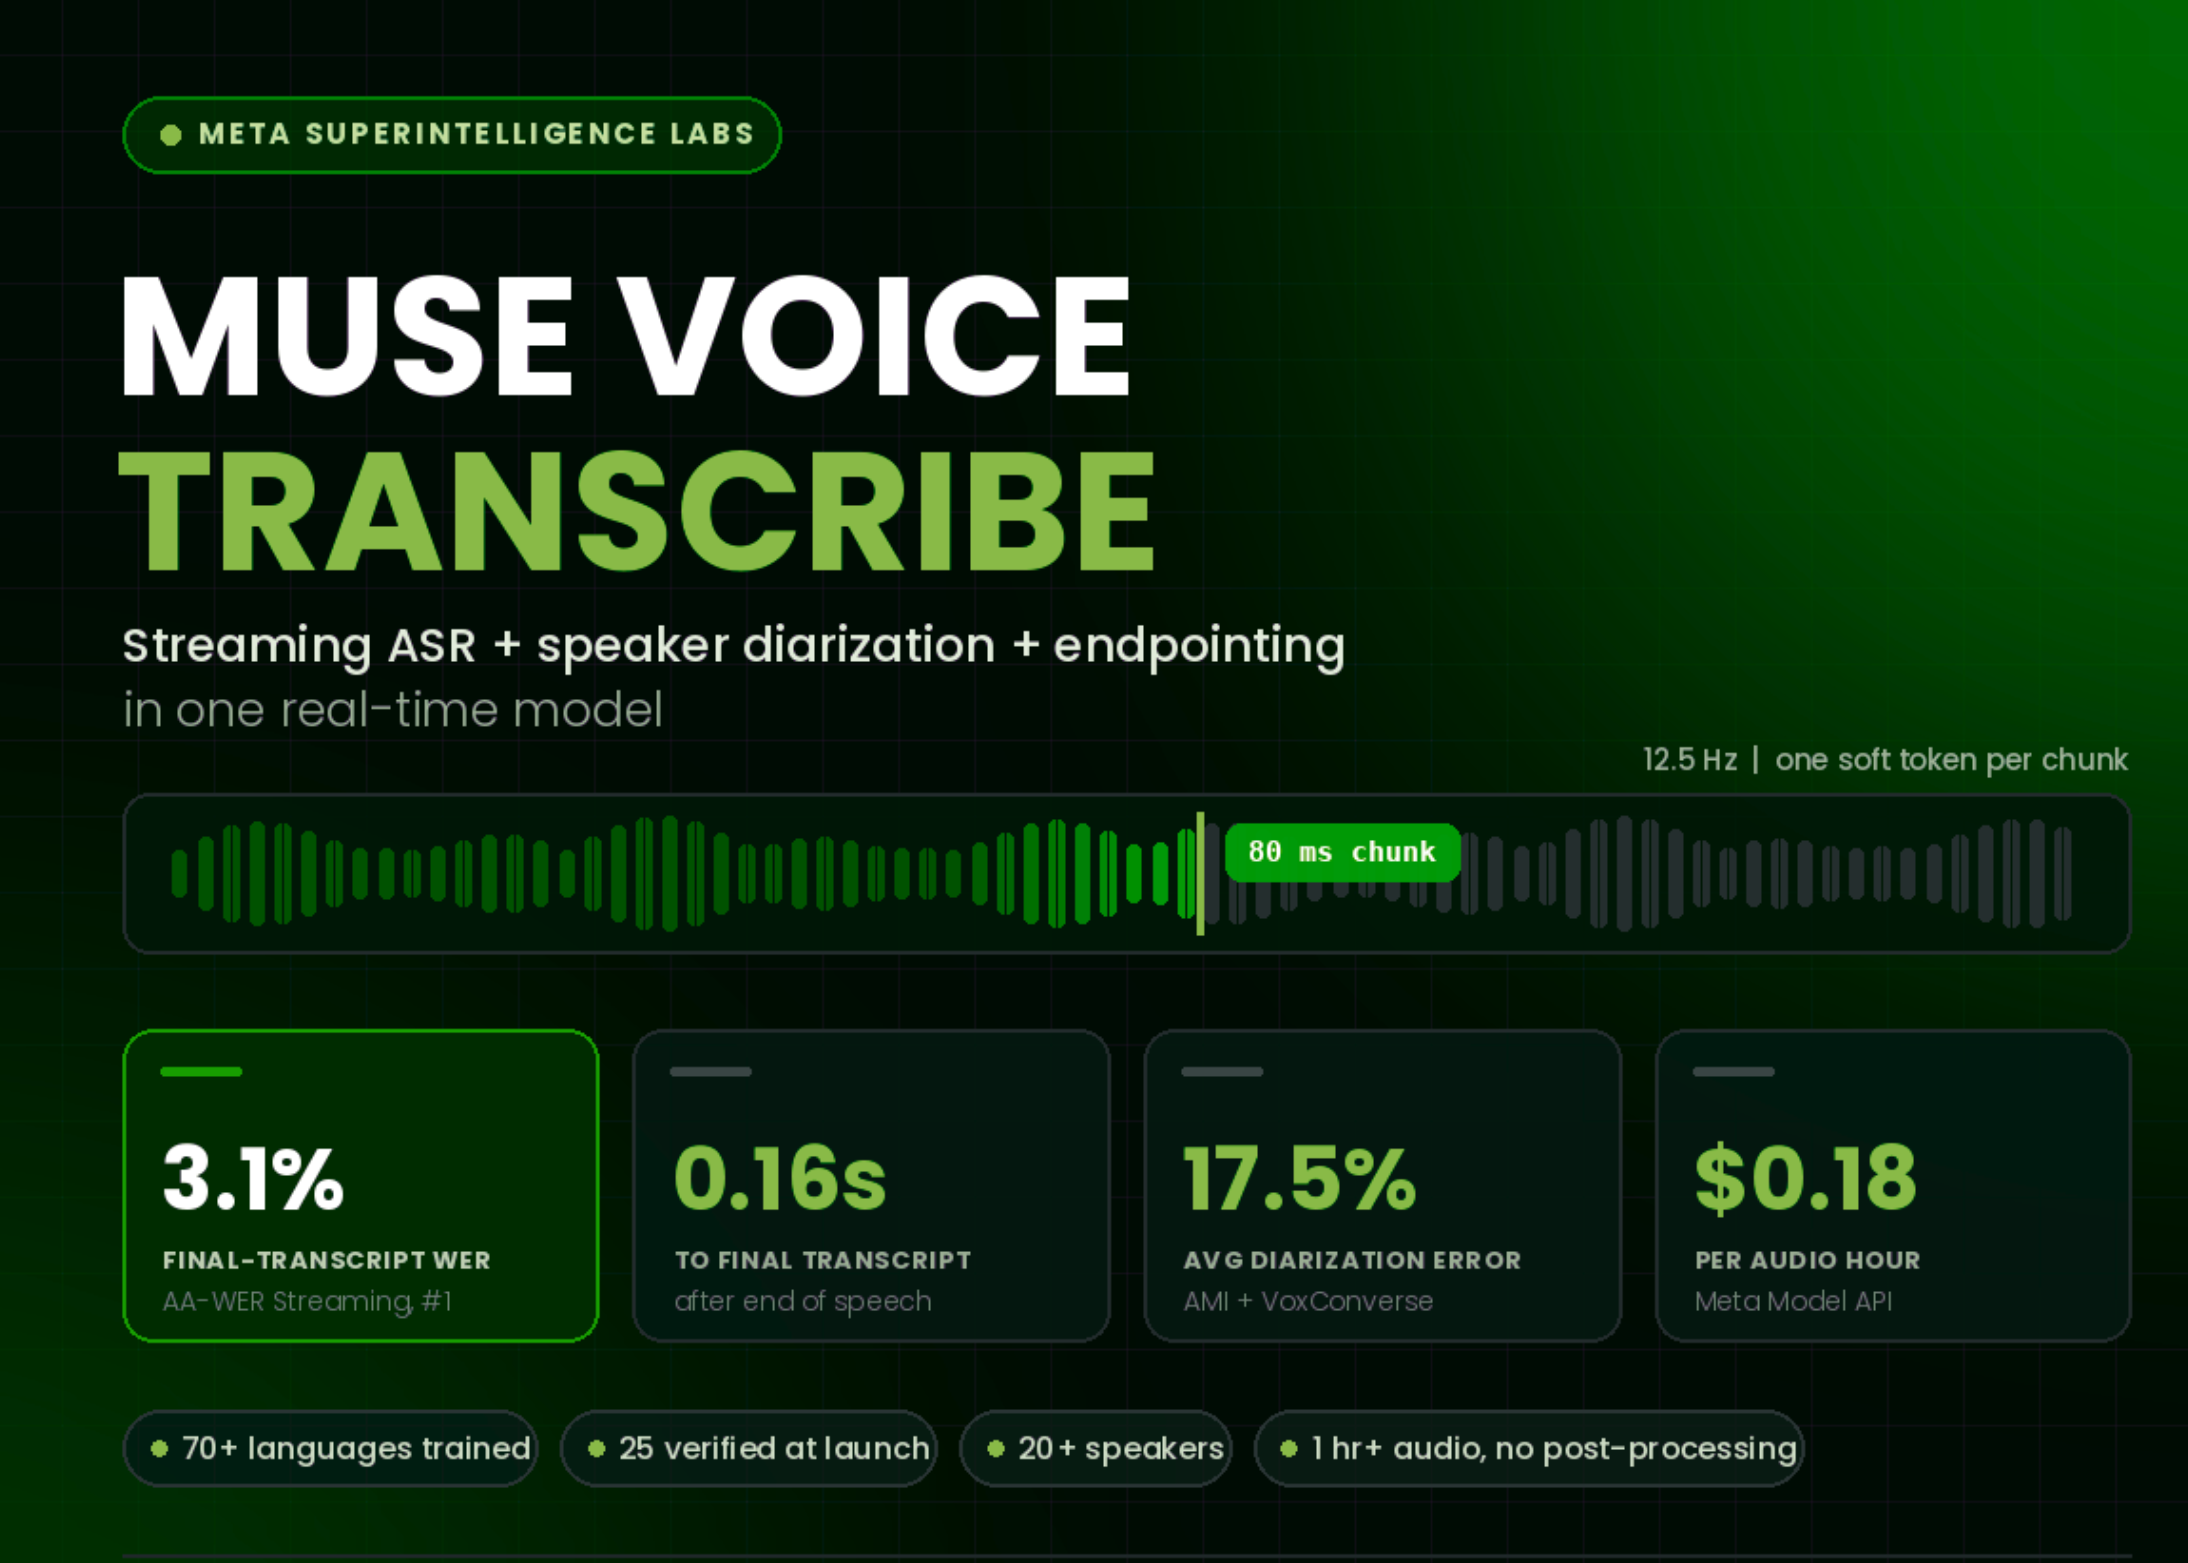
Подразделение Meta Superintelligence Labs анонсировало модель Muse Voice Transcribe, которая объединяет все три задачи в рамки единой авторегрессионной нейросети. Разработчики позиционируют её как первую модель реального времени для комплексного восприятия звука. Она выполняет потоковое распознавание речи, разделяет более 20 спикеров и фиксирует границы речевых фраз за один проход без необходимости привлекать сторонние алгоритмы пост-обработки.
Для практического использования модель уже доступна в виде облачного сервиса через Meta Model API под идентификатором muse-voice-transcribe-1.0 по тарифу 3,00 доллара США за 1000 минут аудио (что составляет 0,18 доллара за час). Кроме того, она уже интегрирована в функции диктовки в Meta AI для Mac и в инструмент Muse Code. Публичный релиз весов модели не планируется, поэтому развернуть её на собственных серверах невозможно.
Потоковое распознавание речи как основа архитектуры
В техническом плане Muse Voice Transcribe представляет собой мультимодальную авторегрессионную модель, принадлежащую к семейству Muse Spark. Обработка входящего аудиопотока происходит порциями (чанками) длительностью по 80 миллисекунд с частотой 12,5 Гц. Каждая такая порция преобразуется системой в единый «мягкий» токен (soft token).
После получения каждого аудиочанка модель принимает одно из двух бинарных решений: сгенерировать специальный токен <|next_audio|> и продолжить прослушивание потока либо выдать текстовый токен. Когда нейросеть выбирает <|next_audio|>, этот элемент автоматически замещается следующим реальным фрагментом аудио из входящего потока. Когда аудиопоток завершается, в систему подается токен <|empty_audio|>, после чего модель выгружает весь оставшийся текст без ожидания новых порций звука.
Процессы прослушивания и генерации текста объединены в один общий цикл декодера. Благодаря этому в архитектуре отсутствует отдельный этап выравнивания временных меток, который в традиционных системах часто приводит к рассогласованию текста и звука.
Адаптивная задержка и обучение с подкреплением
Поскольку нейросеть сама определяет момент перехода в режим прослушивания, она самостоятельно регулирует объем звукового контекста, находящегося за каждым распознанным словом. Этот временной разрыв специалисты Meta называют «задержкой» (delay). Чем глубже контекст и больше задержка, тем выше точность итоговой расшифровки, но вместе с тем растет и латентность отклика.
Инженеры Meta не стали задавать жесткий фиксированный баланс между скоростью и точностью, а обучили систему находить оптимальный режим с помощью обучения с подкреплением (Reinforcement Learning). В процессе обучения функция вознаграждения за точность (Word Error Rate, WER) перемножалась с функцией вознаграждения за минимизацию задержки. В результате модель сформировала динамическую стратегию, меняющую задержку для каждого конкретного слова в зависимости от сложности акустического контекста.
По данным Meta, такой подход вывел модель на границу Парето по соотношению скорости и точности расшифровки, превзойдя показатели специализированных решений от Soniox, Cartesia и ElevenLabs.
Диаризация и определение конца речи через специальные токены
Вместо подключения отдельного модуля для распознавания дикторов разработчики внедрили служебные токены прямо в основной поток генерации.
Для задачи диаризации используется токен <|start_of_turn|>, фиксирующий возможную смену говорящего, а также тег <|speaker_{A-Z}|>, определяющий конкретного спикера. Токен смены реплики срабатывает мгновенно при первой возможности, в то время как идентификатор диктора задерживается до завершения аудиочанка. Речь одного и того же человека может разбиваться на несколько последовательных сегментов, каждый из которых будет помечен одинаковым тегом спикера.
Для отслеживания границ речи (endpointing) применяются токены <|speech_onset|>, фиксирующий начало фразы, и <|speech_endpoint|>, обозначающий момент, когда пользователь закончил говорить. Обучение этим задачам проводилось совместно с потоковым ASR путем наложения дополнительных наград поверх базовой функции вознаграждения распознавания речи.
Поддерживаемые языки и практические возможности
Модель проходила обучение на материалах более чем 70 языков. При этом для 25 из них проведена глубокая верификация, и именно они официально рекомендованы к использованию на этапе запуска. Модель нативно поддерживает смешение языков (code-switching) — как в пределах одного предложения, так и между фразами, что критически важно для двуязычных пользователей.
Для повышения точности расшифровки в специфических доминах предусмотрена поддержка подсказок (biasing) по языку, ключевым словам и контексту. Отдельно я отмечу способность модели работать с длительными аудиозаписями: заявлена нативная поддержка аудиофайлов и потоков длительностью более 1 часа с участием более 20 спикеров без необходимости разбиения записи или пост-обработки.
Результаты в бенчмарках и стоимость использования
По состоянию на 1 сентября 2026 года Meta заявляет о первом месте Muse Voice Transcribe в независимом рейтинге Artificial Analysis для потокового распознавания речи, а также в публичных тестах диаризации.
В бенчмарке Artificial Analysis AA-WER Streaming модель показала уровень ошибок итогового текста (final-transcript WER) 3,1% при задержке всего 0,16 секунды после окончания речи. Для сравнения:
- Cartesia Ink-2 (с семантическим endpointing): WER 3,4% при задержке 0,43 с;
- ElevenLabs Scribe v2 Realtime: WER 3,6% при задержке 0,14 с;
- Cartesia Ink-2 (с внешним endpointing): наименьшая задержка 0,07 с, но с увеличением ошибки до 4,0% WER.
При оценке первой частичной расшифровки (first partial transcript) Muse Voice Transcribe демонстрирует показатель WER 3,6% при задержке 0,13 секунды.
В тестах диаризации средний показатель ошибок (Diarization Error Rate, DER) на наборах данных AMI-IHM, AMI-SDM и VoxConverse составил 17,5%. Другие пять популярных систем в этом же сравнении показали результаты в диапазоне от 21,1% до 28,6%.
Ценовой фактор также выглядит убедительно: тариф $3,00 за 1000 минут обходит Cartesia Ink-2 ($4,00) и оказывается более чем в два раза дешевле решений ElevenLabs Scribe v2 Realtime ($6,50) и Deepgram Flux ($6,50).
Главные выводы о релизе
- Единая нейросетевая архитектура выполняет потоковое ASR, диаризацию для 20+ спикеров и отслеживание пауз без внешних компонентов;
- Точность итогового текста составляет 3,1% WER при задержке 0,16 секунды;
- Обучение с подкреплением автоматически регулирует задержку генерации для каждого слова в зависимости от сложности аудио;
- Поддерживается свыше 70 языков (25 полностью верифицированы) с нативным распознаванием смешанной речи;
- Модель доступна исключительно по API по цене $0,18 за час аудио, веса модели закрыты.
Источник: www.marktechpost.com
