
Мой блог
Microsoft представила MAI-Transcribe-2-Streaming: лидер среди моделей распознавания речи

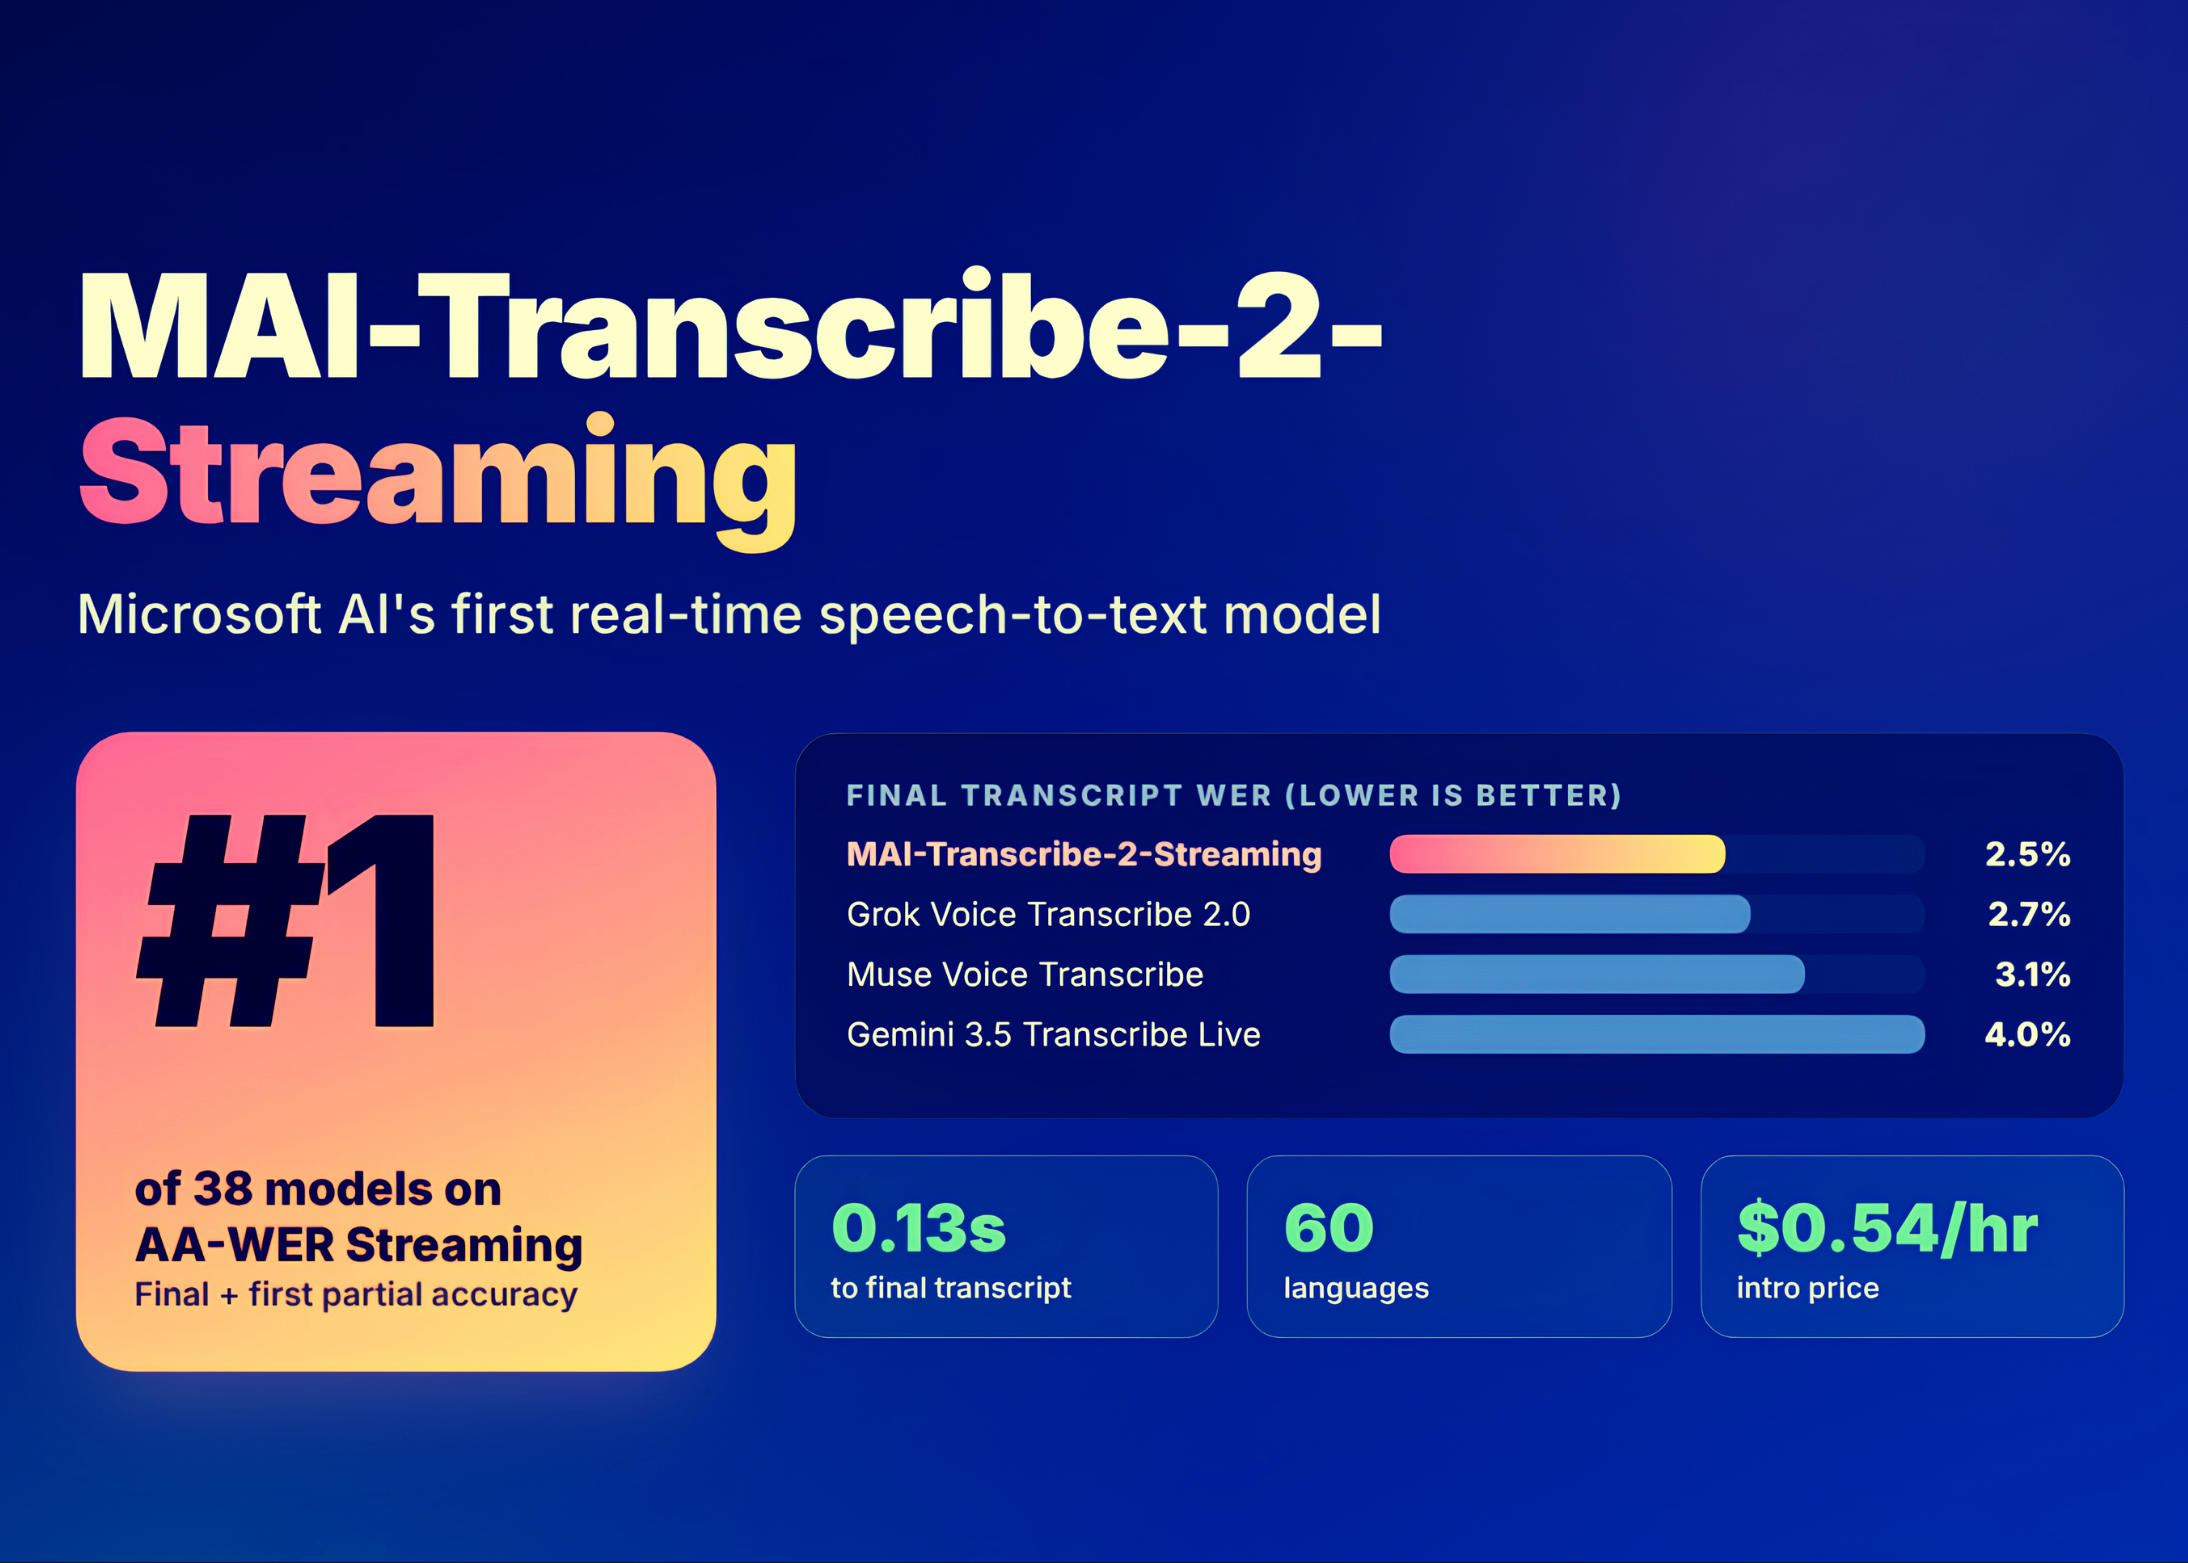
Подразделение Microsoft AI выпустило новую модель распознавания речи MAI-Transcribe-2-Streaming, которая стала первым потоковым решением компании в этой категории. Релиз состоялся в начале октября 2026 года одновременно с двумя генеративными моделями синтеза голоса — MAI-Voice-2.1 и MAI-Voice-2.1-Flash. Согласно независимым тестам платформы Artificial Analysis, эта разработка заняла первое место среди 38 протестированных систем по точности финальной транскрипции и качеству первых промежуточных гипотез.
Инструмент ориентирован на разработчиков голосовых ассистентов, систем интерактивной диктовки и сервисов живых субтитров, где задержка обработки критически влияет на восприятие. Модель демонстрирует высокую скорость работы и способна интегрироваться в современные диалоговые интерфейсы.
Что именно выпустила Microsoft
Новинка представляет собой потоковую версию пакетного аналога MAI-Transcribe-2, представленного месяцем ранее. Система поддерживает распознавание 60 языков с функцией автоматического и непрерывного определения языка на лету. Аудиопоток обрабатывается непрерывно, а текст начинает поступать обратно еще в тот момент, когда пользователь продолжает говорить.
Архитектура выдает первые гипотезы (так называемые partials) уже спустя чуть более 100 миллисекунд после получения звукового сигнала. По мере поступления новых речевых контекстов эти предварительные варианты уточняются, после чего фиксируется окончательный стабильный текст. Благодаря этому алгоритму ИИ-агент может задействовать логику или вызывать внешние инструменты прямо посреди фразы. По данным внутренних испытаний разработчиков, слова в потоке появляются вдвое быстрее, чем у ближайших конкурентов.
Результаты измерений от Artificial Analysis
Специализированный индекс AA-WER Streaming рассчитывается на основе примерно 8 часов аудиоматериалов, разбитых на категории: AA-AgentTalk (50%), VoxPopuli (25%) и Earnings22 (25%). Измерение задержек производится с момента окончания речи, который фиксируется детектором активности SileroVAD.
Итоговые показатели модели впечатляют: коэффициент ошибок (WER) составляет 2,5% при времени отклика 0,13 секунды после завершения фразы, что выводит систему на первую строчку из 38 участников. Первый предварительный вариант также показывает 2,5% ошибок при задержке всего 0,12 секунды. Ближайшими преследователями стали Grok Voice Transcribe 2.0 (2,7% и 0,49 с) и Muse Voice Transcribe (3,1% и 0,16 с). При этом некоторые решения, например Cartesia Ink-2, выдают финальный текст за 0,07 секунды, но жертвуют точностью, допуская 4,0% ошибок. Высокая точность самых ранних гипотез критически важна для агентов, действующих опережающе.
Ценовая политика
Базовая стоимость использования MAI-Transcribe-2-Streaming составляет 0,54 доллара за один час обработанного аудио. Эта цена действует как вводное предложение до конца 2026 года. В пересчете на нормативы Artificial Analysis это эквивалентно 9 долларам за 1 000 минут. Для сравнения, пакетная версия MAI-Transcribe-2 обходится значительно дешевле — в 0,10 доллара за час.
В сегменте потоковой транскрипции ценовая планка Microsoft установлена выше предложений от xAI и Meta, но находится примерно на одном уровне с ориентировочными расценками Google. Разработчикам стоит учитывать временный характер текущих расценок.
Варианты интеграции для разработчиков
Интерфейс сервиса поддерживает два основных пути интеграции. Первый использует Realtime API и подходит для приложений, уже адаптированных под WebSocket-соединения, совместимые с OpenAI Realtime. Второй способ опирается на Azure Speech SDK, который берет на себя управление сетевыми подключениями, повторные попытки и передачу аудиопотоков. Оба варианта возвращают как промежуточные, так и окончательные текстовые результаты.
Кроме того, инструмент доступен в среде MAI Playground, через платформы Vercel и Azure Voice Live, а в ближайшем будущем ожидается интеграция с LiveKit. Для создания полноценных голосовых циклов разработчики могут комбинировать модель с MAI-Voice-2.1-Flash, которая генерирует 45 секунд аудио с задержкой 150 мс за 15 долларов на 1 миллион символов, либо со стандартной MAI-Voice-2.1, поддерживающей 23 языка за 22 доллара на тот же объем.
Сравнение MAI-Transcribe-2-Streaming с конкурентами
На рынке потоковых инструментов распознавания речи наблюдается жесткая конкуренция. Решение от Microsoft соседствует с разработками xAI (Grok Voice Transcribe 2.0), Meta (Muse Voice Transcribe) и Google (Gemini 3.5 Transcribe Live). По критериям точности AA-WER и времени генерации финального транскрипта продукт американской корпорации удерживает лидерство, предлагая при этом автоматическое определение языков и удобные интерфейсы подключения на базе WebSocket.
Все рассмотренные модели распространяются на закрытой основе без публикации открытых весов, а доступ к ним предоставляется через облачные API. Выбор конкретного инструмента зависит от требований к задержкам в реальном времени и бюджета проекта.
Основные итоги релиза
Новая языковая модель продемонстрировала выдающиеся результаты в тестах, заняв первое место в рейтинге точности и скорости потоковой транскрипции. Система обрабатывает 60 языков «на лету» и выдает качественные промежуточные результаты быстрее конкурентов.
Несмотря на более высокую стоимость по сравнению с некоторыми аналогами от xAI и Meta, гибкие варианты интеграции через Azure и API делают решение привлекательным для создания продвинутых голосовых интерфейсов нового поколения.
