
Мой блог
Модель на 360M параметров: как заставить языковую модель имитировать терминал

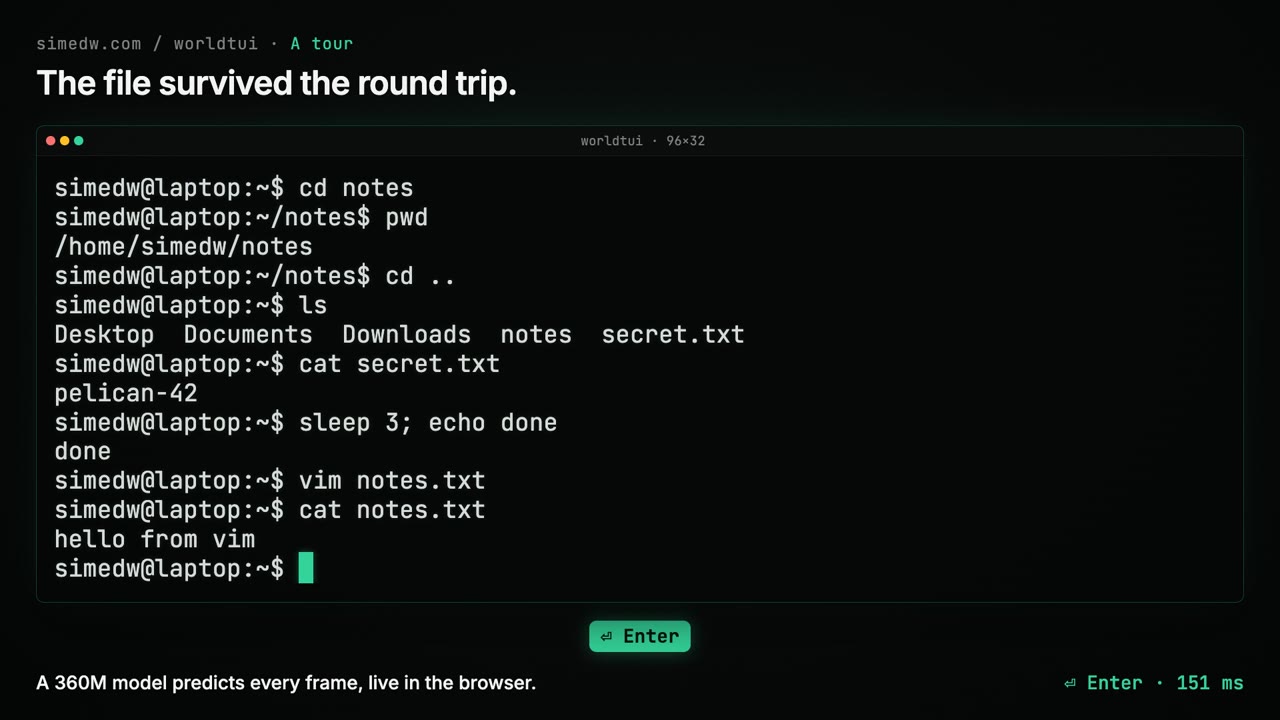
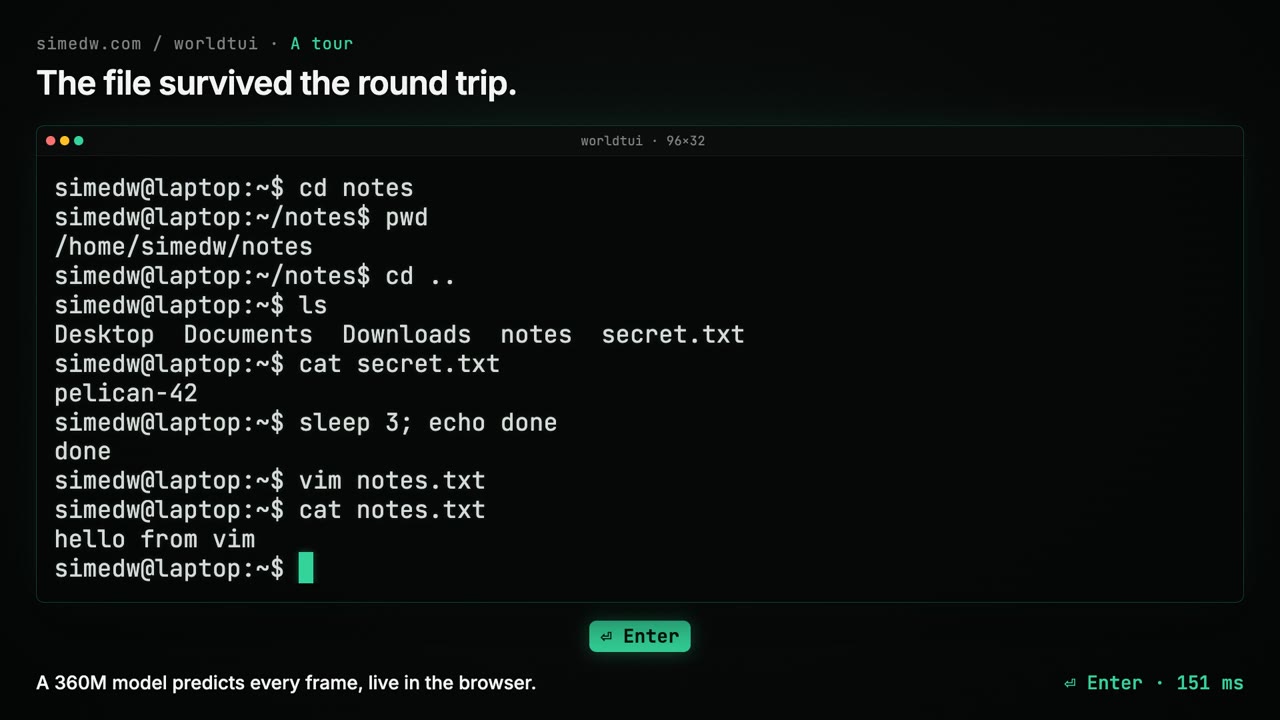
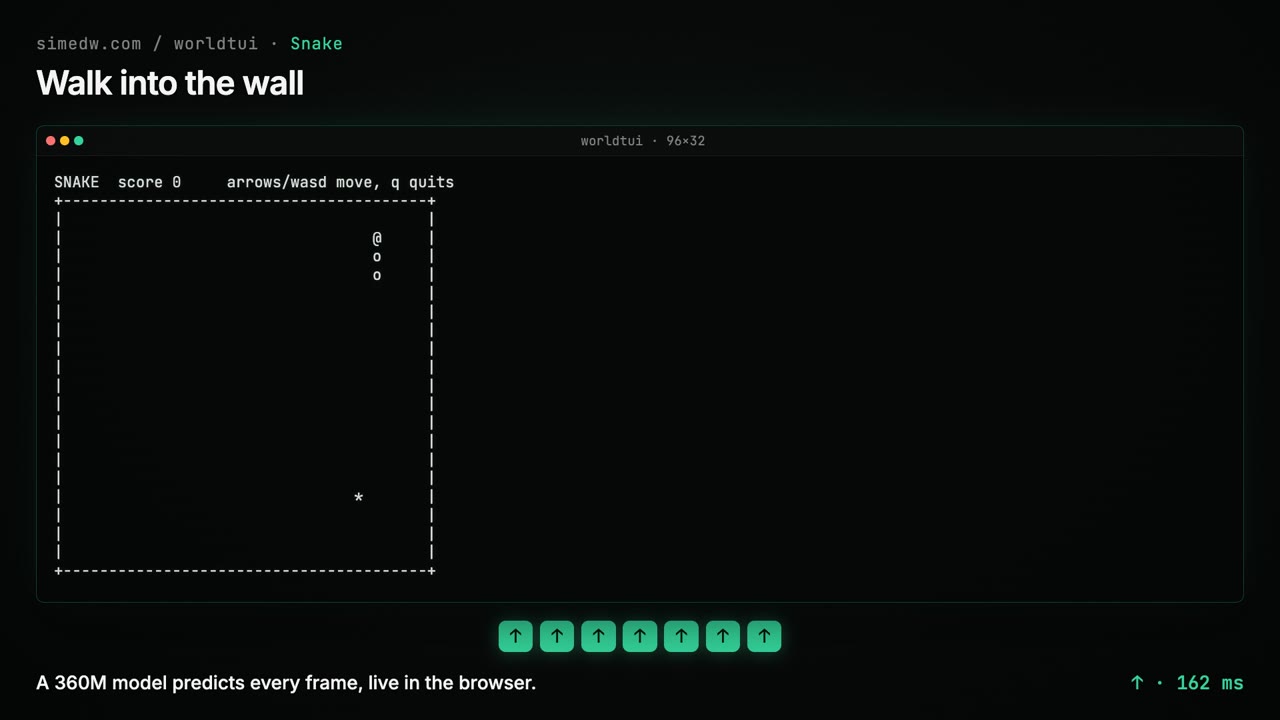
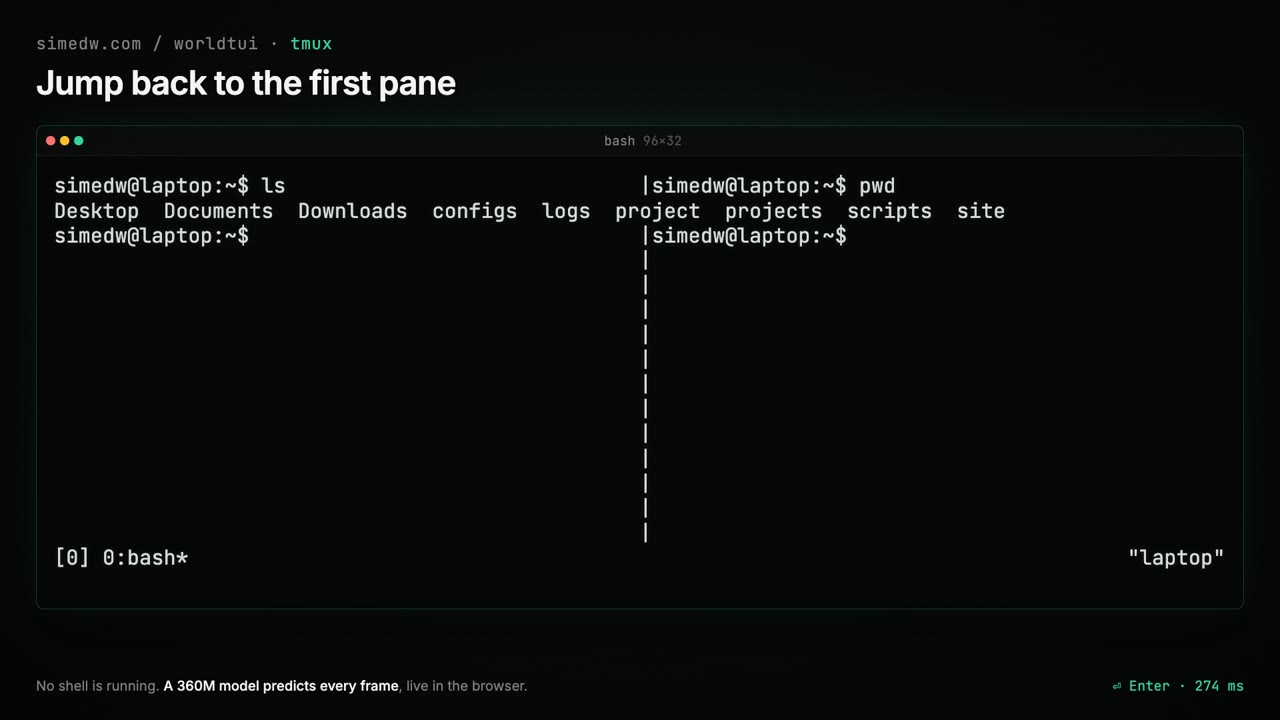
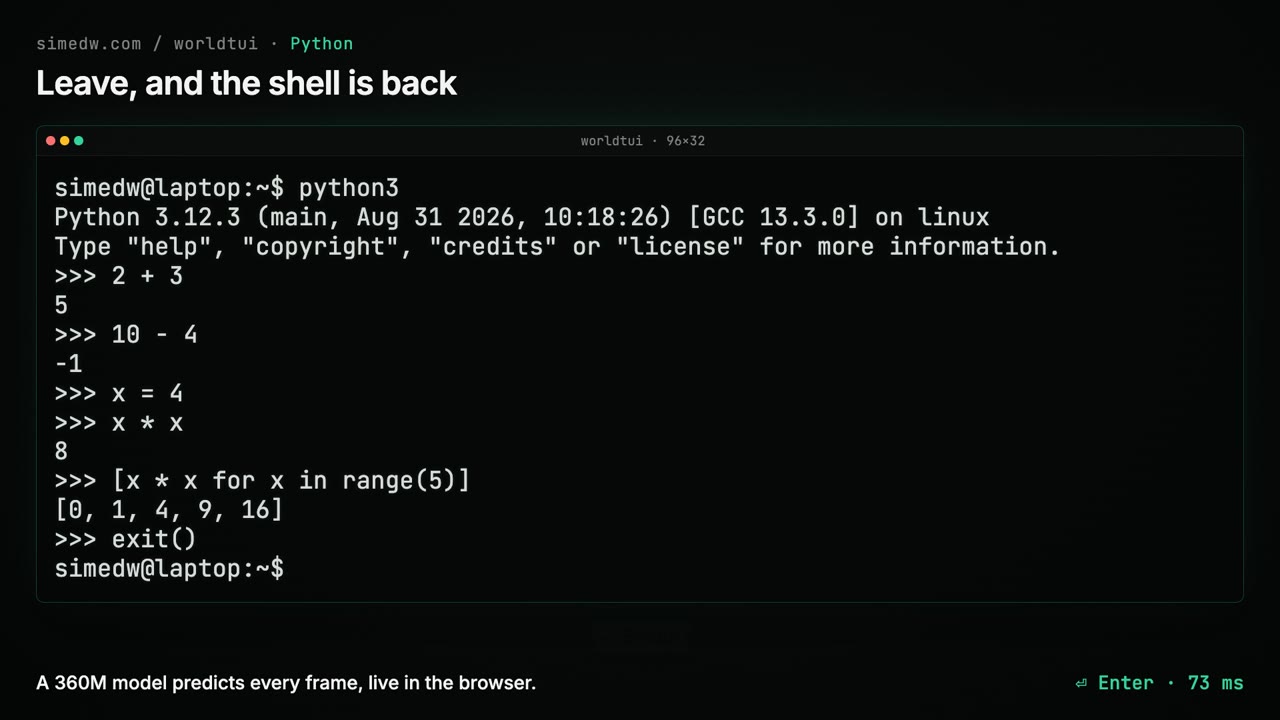
Современные языковые модели способны на многое, однако проект энтузиаста по созданию текстового интерфейса демонстрирует нестандартный подход к инференсу. В центре внимания оказалась компактная языковая модель на 360 миллионов параметров, обученная имитировать работу командной строки, текстового редактора vim и оконного менеджера tmux прямо в окне браузера.
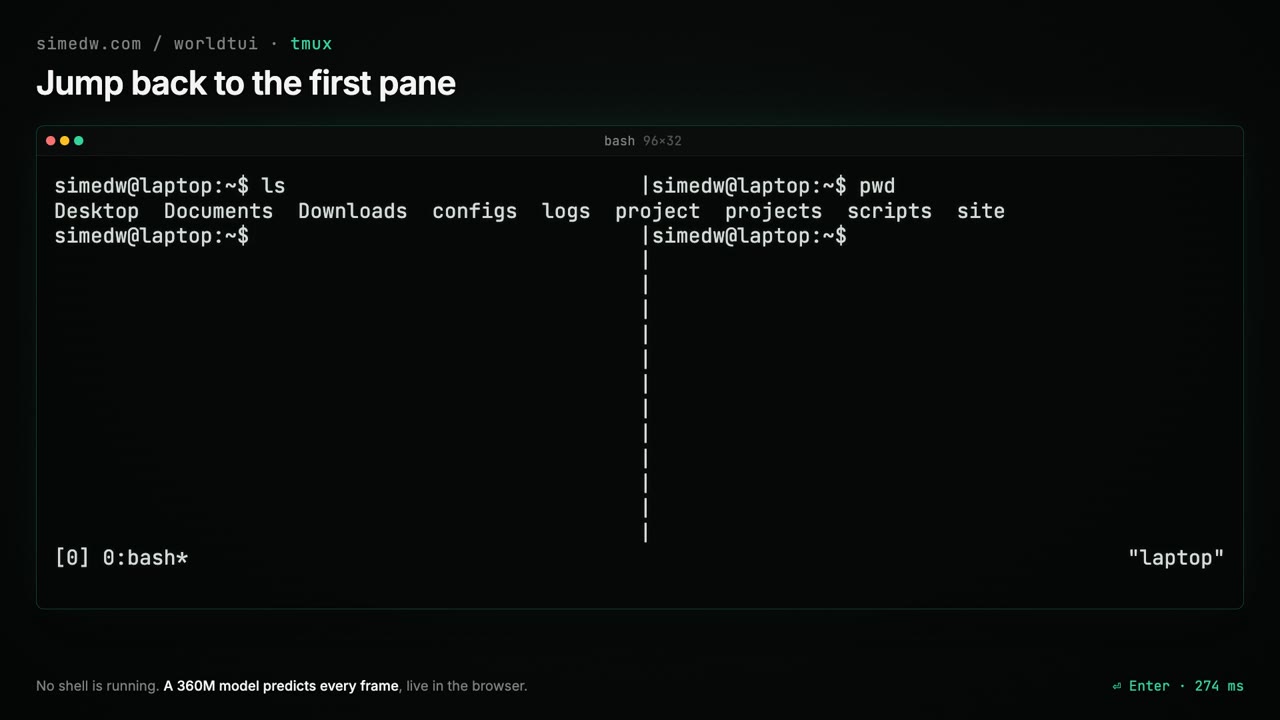
В основе разработки лежит идея симуляции интерфейса без реальной файловой системы и шелла. Вместо генерации текста модель предсказывает изменения символьной сетки экрана в ответ на каждое нажатие клавиши, обрабатывая команды локально через WebGPU.
Как модель видит терминал
Традиционные архитектуры LLM генерируют токены последовательно дописывая их к промпту. Для командной строки такой сценарий подходит плохо, поскольку единичное нажатие клавиши может запускать сложные процессы, а вывод не всегда добавляется снизу — например, команда очистки экрана полностью стирает рабочую область.
Интерфейс в проекте представлен в виде символьной матрицы, где каждый элемент занимает отдельную ячейку. Сама сетка не передается модели напрямую; вместо этого система обрабатывает непрерывную последовательность токенов, фиксирующих изменения на экране.
Организация сессии
Любая рабочая сессия стартует со снимка состояния, содержащего габариты окна, текущий текст и позицию курсора. Параметры экрана не фиксированы жестко, поэтому при запуске демонстрации пользователь может задать произвольное количество строк и столбцов.
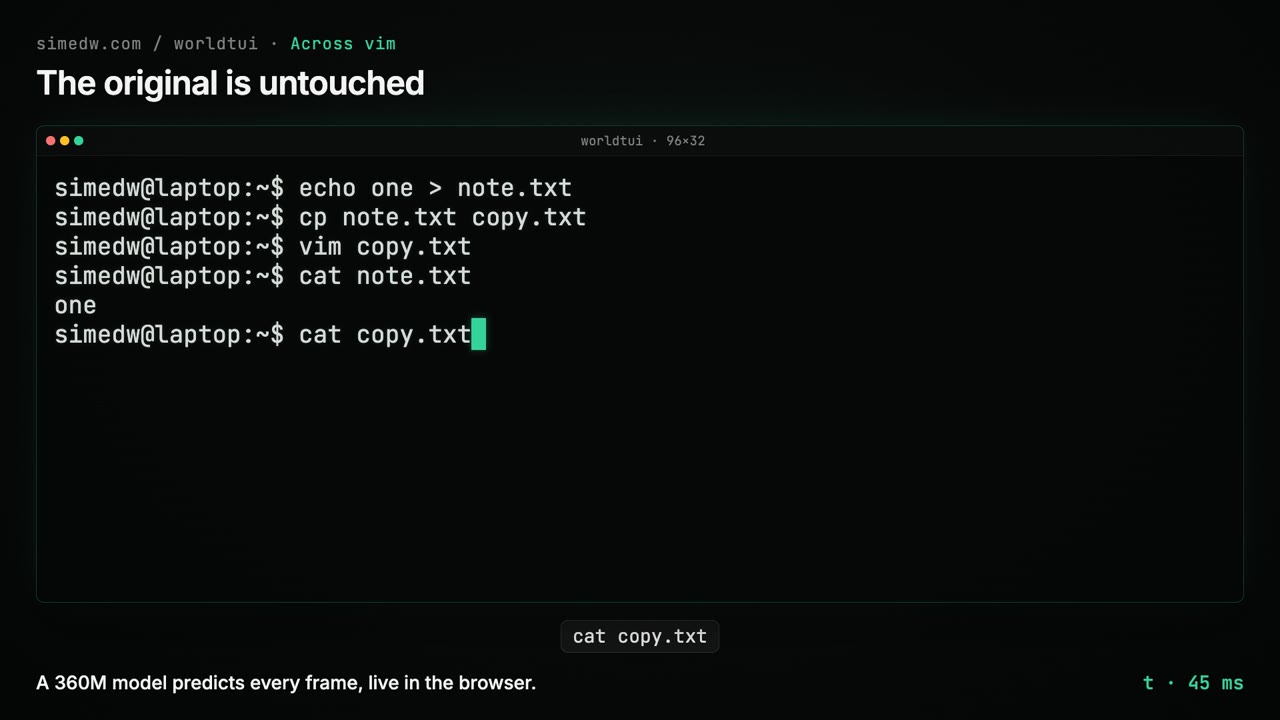
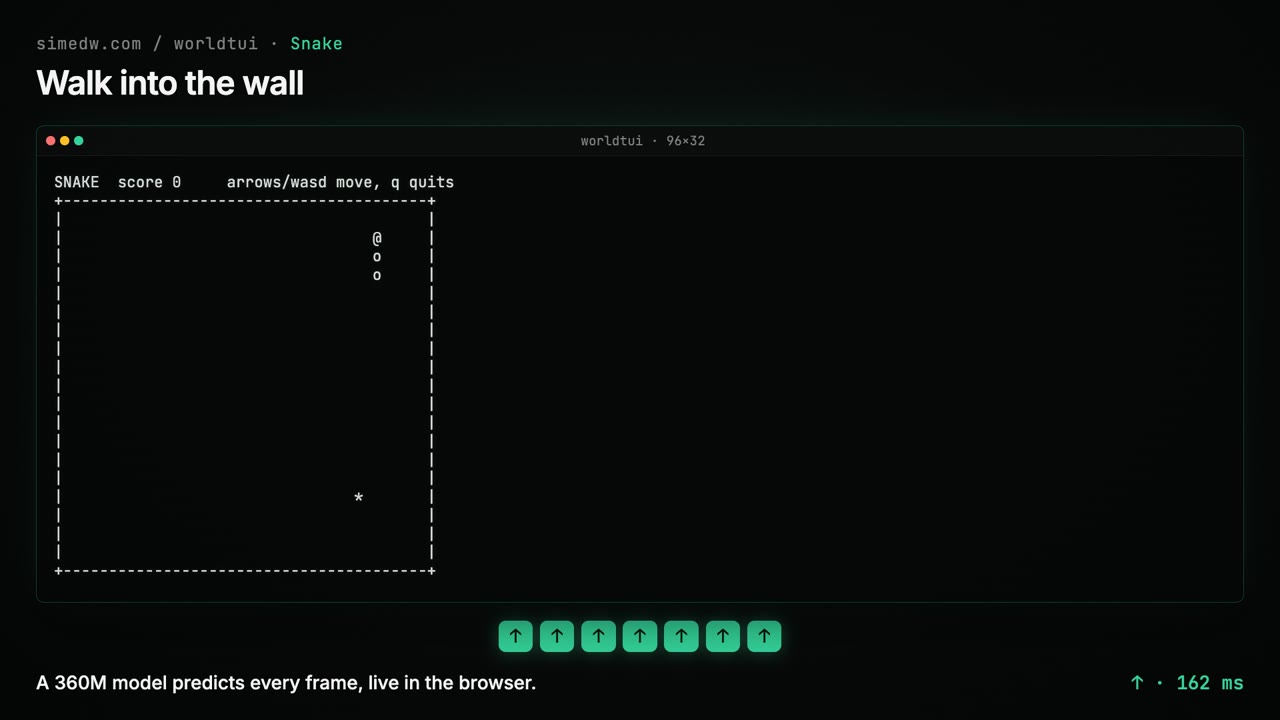
Подобный подход позволяет возобновлять процесс с произвольного момента. Достаточно передать модели приглашение оболочки, содержимое буфера редактора или игровое поле, чтобы продолжить выполнение. Нажатия клавиш транслируются в виде стандартных байтовых последовательностей, отправляемых реальными терминалами.
В ответ алгоритм определяет, какие именно строки подлежат перезаписи и куда переместится курсор. Новые символы накладываются поверх старых без предварительной очистки области. Использование встроенных в токенизатор байтовых значений позволило обойтись без выделения дополнительных токенов под символы и небольшие координаты.
Копирование строк
При достижении нижней границы экрана и нажатии клавиши ввода строки должны смещаться вверх. Прямая перерисовка каждой строки потребовала бы отправки около трех тысяч токенов за раз, поэтому для оптимизации была внедрена специальная операция копирования строк с предыдущего кадра.
Такой механизм задействуется при очистке экрана, операциях со строками в редакторе и просмотре документации, снижая затраты токенов на прокрутку в десятки раз. Сокращенный словарь из 333 токенов упростил интеграцию модели в браузерную среду.
Генерация обучающих данных
Поскольку готовые наборы записей с точным соответствием «нажатие клавиши — реакция экрана» отсутствовали, автору пришлось разработать собственный пайплайн синтетических данных. Реальные команды выполнялись внутри изолированных контейнеров Docker, фиксируя каждое действие пользователя и последующий отклик интерфейса.
В процессе генерации случайным образом варьировались параметры хоста, имена пользователей, структура каталогов и размер окна терминала. Набор сценариев охватывал редактирование документов, выполнение скриптов и навигацию в tmux. Итоговый датасет составил около 336 тысяч эпизодов, что эквивалентно двум миллиардам токенов.
Обучение и исправление ошибок
Базовой архитектурой была выбрана модель Qwen2.5-Coder-0.5B, обладающая базовыми навыками работы с кодом и командной строкой. На начальном этапе применялось стандартное обучение с учителем, однако на длинных дистанциях неизбежно накапливались ошибки — например, искаженное имя файла портило всю последующую сессию.
Борьба с накоплением ошибок
Для стабилизации работы была задействована методика самокоррекции: модель обучалась не только на идеальных демонстрациях, но и на собственных ошибочных состояниях. Алгоритм анализировал расхождения между предсказанным и реальным экраном, формируя корректирующее воздействие.
Главным условием для исправления было наличие информации на предыдущих экранах, что исключало появление неконтролируемых галлюцинаций. Такой подход позволил значительно повысить стабильность работы системы в тестах.
Проверка производительности
Для оценки возможностей модели применялись бенчмарки ShellBench, PresetBench и специализированный тест памяти на сохранение состояния файлов. Эксперименты показали, что обученная система успешно справляется со знакомыми сценариями, хотя работа со сложными комбинациями команд пока остается ограниченной.
Ускорение и оптимизация
Стандартная авторегрессионная генерация полной перерисовки экрана занимала слишком много времени, что делало работу с интерфейсом некомфортной. Проблему удалось решить за счет параллельной генерации строк и применения спекулятивного декодирования, когда модель сначала формирует черновик независимых строк, а затем проверяет его последовательно.
Для запуска в браузере исходная модель была существенно уменьшена: удалена большая часть неиспользуемой таблицы эмбеддингов, а оставшиеся веса квантованы до четырех бит. Итоговый объем файла составил 208 мегабайт, а исполнение кода в браузере реализовано с помощью кастомного декодера на JavaScript и WebGPU-шейдеров.
Возможности и ограничения
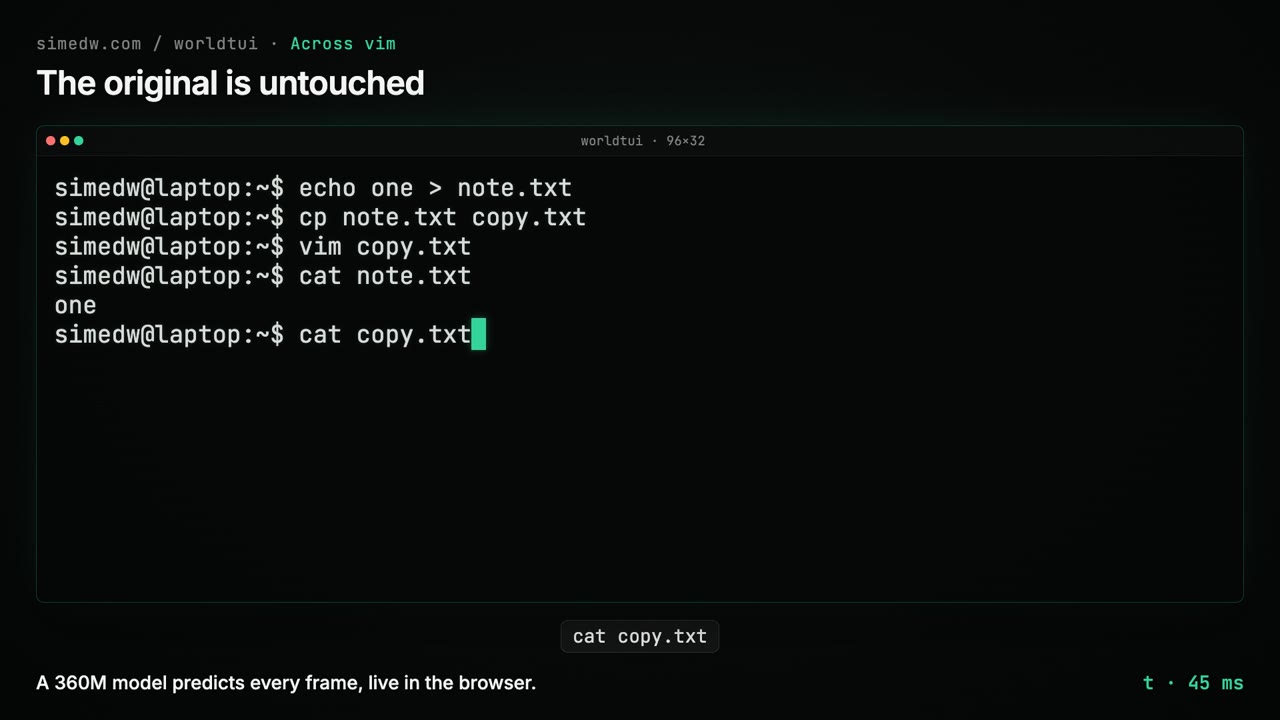
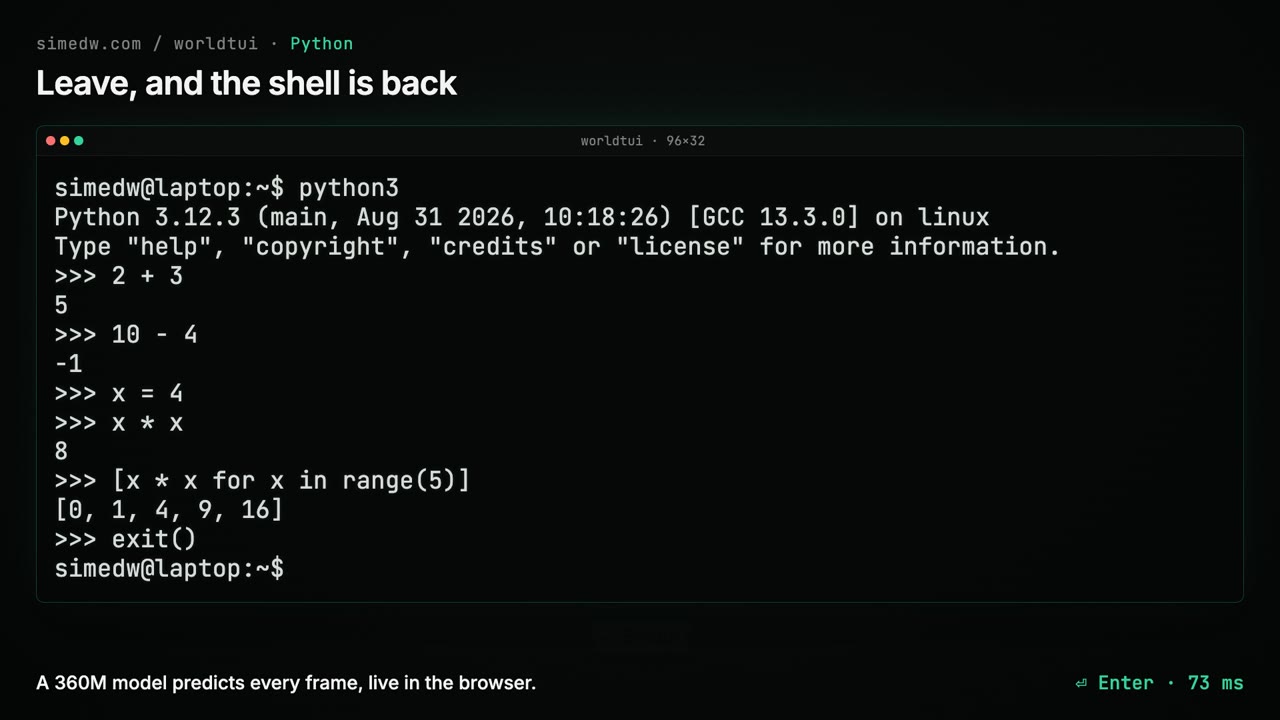
Эксперимент подтвердил жизнеспособность концепции: система способна поддерживать состояние файлов, обрабатывать переключение режимов в редакторе vim, выполнять базовые вычисления в REPL Python и управлять панелями tmux. Тем не менее, реализация полноценной файловой системы и работа со сложными вложенными каталогами требуют дальнейших доработок.
