
Мой блог
Open ASR Leaderboard впервые добавляет языки Глобального Юга: бенчмарки Monsoon для индийского английского и хинди


Эффективность развития моделей автоматического распознавания речи (ASR) во многом определяется метриками и наборами данных, на которых их тестируют. Если модель демонстрирует высокий результат на публичной рейтинговой платформе Open ASR Leaderboard, разработчики активно внедряют её и оптимизируют дальнейшие версии. Напротив, те характеристики системы, которые не измеряются бенчмарком, обычно остаются без должного внимания. В последнее время создатели Open ASR Leaderboard направили немало усилий на повышение объективности тестирования: были введены закрытые тестовые выборки (held-out private splits), методы анализа подгонки под бенчмарк (benchmark-fitting) для оценки реальной качества транскрибации, а также доработки нормализаторов текста, устраняющие нерасправедливые штрафы за допустимые орфографические варианты.
Все эти меры усложнили манипулирование итоговым показателем частоты ошибок в словах (WER). Однако единый усреднённый индекс по-прежнему не отражает полной картины. Многочисленные исследования подтверждают, что ошибки распознавания речи распределяются неравномерно между различными группами пользователей. В частности, коммерческие ASR-системы демонстрируют существенно худшую точность для темнокожих дикторов по сравнению со светлыми, а дополнительный дисбаланс возникает в зависимости от пола, возраста и регионального акцента. Стандартные бенчмарки скрывают эти проблемы просто потому, что их тестовые наборы содержат только аудиозапись и расшифровку, практически не сохраняя сведений о личности диктора.
Чтобы устранить данный пробел, на Open ASR Leaderboard были интегрированы два новых оценочных набора данных: Monsoon en-IN (индийский английский) и Monsoon hi-IN (хинди). Хинди, на котором говорят более 500 миллионов человек, стал первым индийским языком во вкладке многоязычных моделей, где ранее были представлены исключительно европейские языки. Каждый из двух наборов разбивается на открытую часть (public split) для самостоятельной оценки и закрытую часть (private split), недоступную разработчикам напрямую. Все четыре выборки не пересекаются по дикторам и суммарно охватывают 4888 человек, для каждого из которых зафиксировано 12 демографических и технических атрибутов.
Принципы проектирования выборки Monsoon
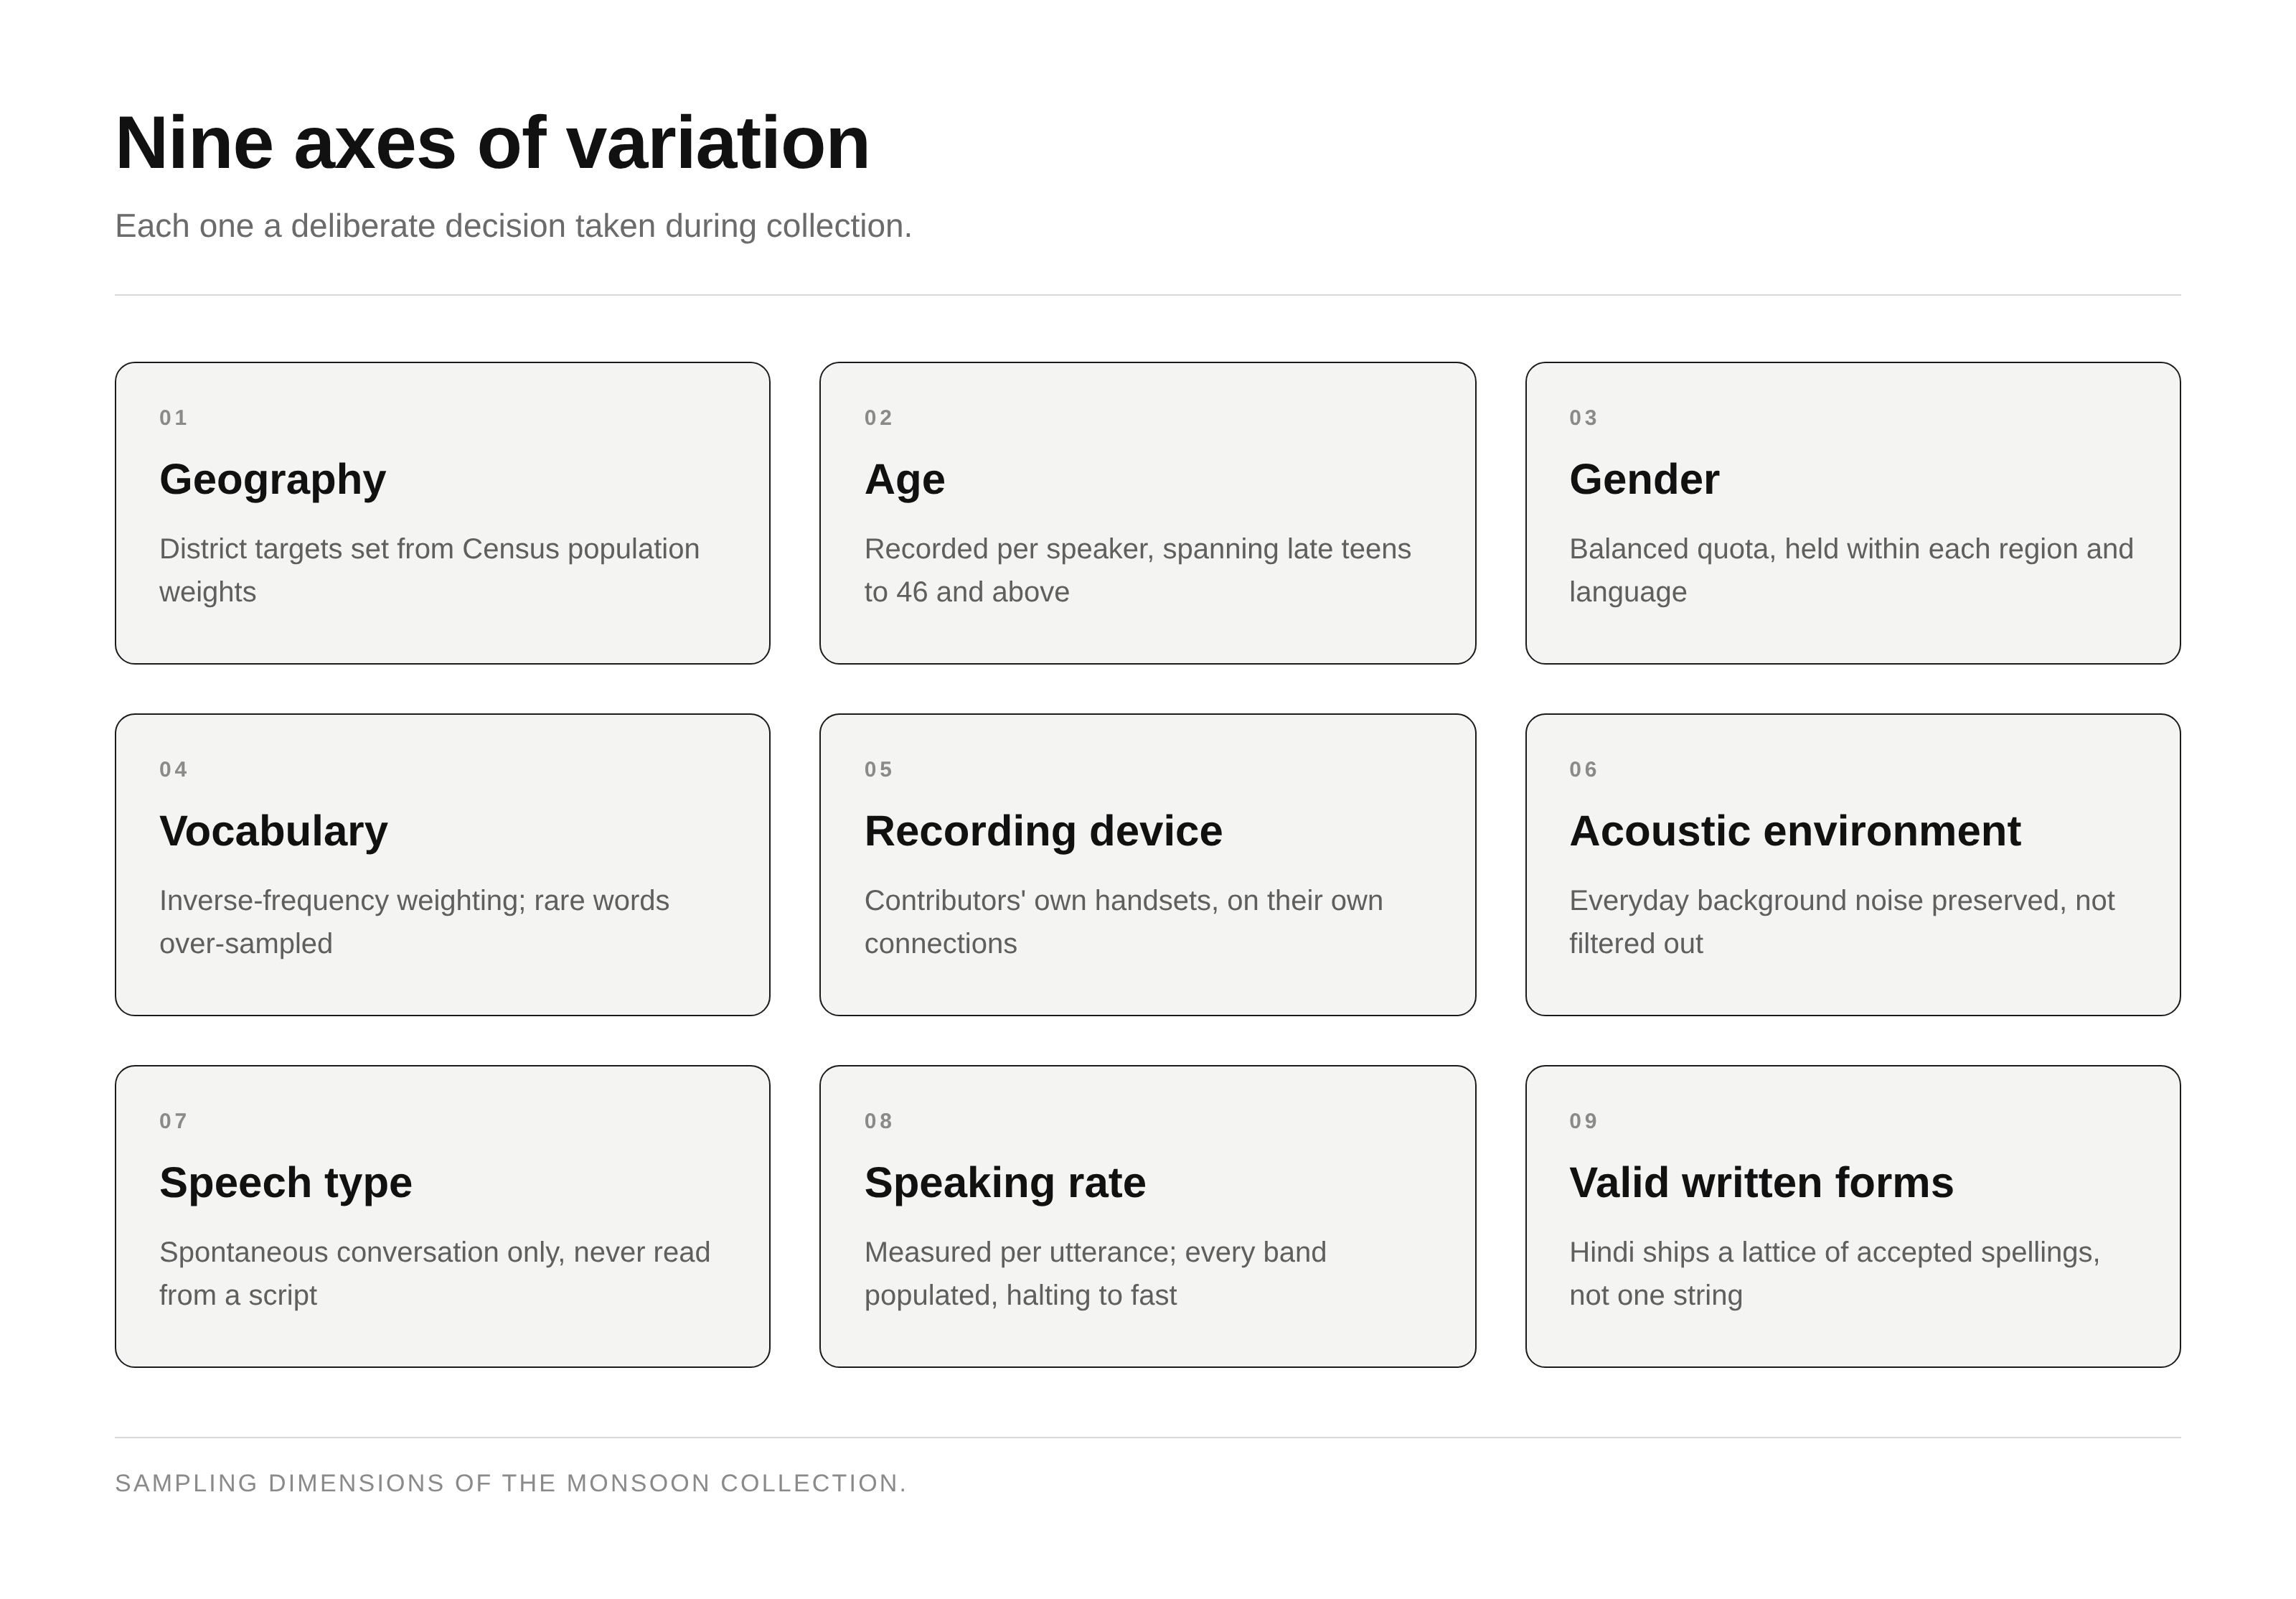
Тестовый набор способно вскрыть только те уязвимости алгоритмов, по которым в нём предусмотрено разнообразие. Большинство популярных бенчмарков создавалось из случайных доступных аудиозаписей. Набор Monsoon с самого начала проектировался так, чтобы обеспечить контролируемую вариативность по девяти ключевым параметрам: география, возраст, пол, словарный запас, типы используемых устройств, акустическое окружение, стиль речи, темп речи и наличие нескольких допустимых вариантов орфографической записи одного и того же высказывания. Отклонение по любому из этих параметров может привести к ситуации, когда итоговый WER кажется отличным в среднем, но показывает неприемлемое качество для конкретной группы людей.
Специфика проектирования предопределила метод сбора данных. Вместо длительных записей небольшого числа участников авторы проекта провели масштабный рекрутинг в сотнях административных районов. Акустическое и техническое разнообразие было достигнуто благодаря тому, что участники записывали речь на собственные смартфоны в реальных условиях — в помещениях и на улице, а не в изолированной студии на эталонном оборудовании. Лексическое разнообразие и естественный темп речи стимулировались вводными вопросами на повседневные темы, побуждавшими к спонтанным рассуждениям, спорам и воспоминаниям, что неизбежно привлекает имена собственные, числительные и нерепетируемые фразовые обороты.
Состав и параметры датасета
Все четыре подвыборки созданы в рамках единого технологического пайплайна и основаны на естественных двухканальных диалогах. Записи разбиты на фрагменты по отдельным каналам, чтобы каждый отрезок содержал речь строго одного диктора.
Основные количественные характеристики выборок распределились следующим образом:
- Monsoon en-IN (открытая): объём 5,62 часа, 1444 диктора, средняя и медианная длина фрагмента — 9,6 с и 10,4 с соответственно, соотношение мужчин и женщин — 50/50, охват 428 районов в 24 штатах и 6 союзных территориях, 556 моделей устройств. Относится к спонтанной разговорной речи с текстовой нормализацией и сохранением слов-паразитов.
- Monsoon en-IN (закрытая): объём 5,58 часа, 1405 дикторов, средняя и медианная длина — 9,6 с и 10,4 с, соотношение по полу — 45/55, охват 420 районов (24 штата и 6 территорий), 560 моделей смартфонов.
- Monsoon hi-IN (открытая): объём 1,33 часа, 468 дикторов, средняя и медианная длина — 6,4 с и 5,0 с, соотношение по полу — 54/46, 202 района в 11 штатах и 3 территориях, 315 типов устройств. Расшифровка выполнена в виде графа (lattice) допустимых орфографических вариантов.
- Monsoon hi-IN (закрытая): объём 4,47 часа, 1571 диктор, средняя и медианная длина — 6,6 с и 5,3 с, соотношение по полу — 55/45, 295 районов в 12 штатах и 3 территориях, 582 модели устройств. Расшифровка также выполнена графом вариантов.
Помимо демографических сведений, для каждого сегмента сохранены такие метаданные, как профессия диктора, уровень образования, семейное положение, уровень дохода, бренд устройства, текущий город проживания и стаж проживания в данном районе. Например, открытая выборка индийского английского включает записи 29-летней студентки из Западной Трипуры (смартфон Samsung SM-G781B), 32-летней временно неработающей женщины из Сатны, Мадхья-Прадеш (Samsung SM-E146B), 22-летнего студента из Рохтаса, Бихар (Motorola Moto G54 5G), 27-летней женщины из Варангала, Телангана (Vivo V2247) и 57-летнего сотрудника частной компании из Пудучерри (Xiaomi M2006C3LI).
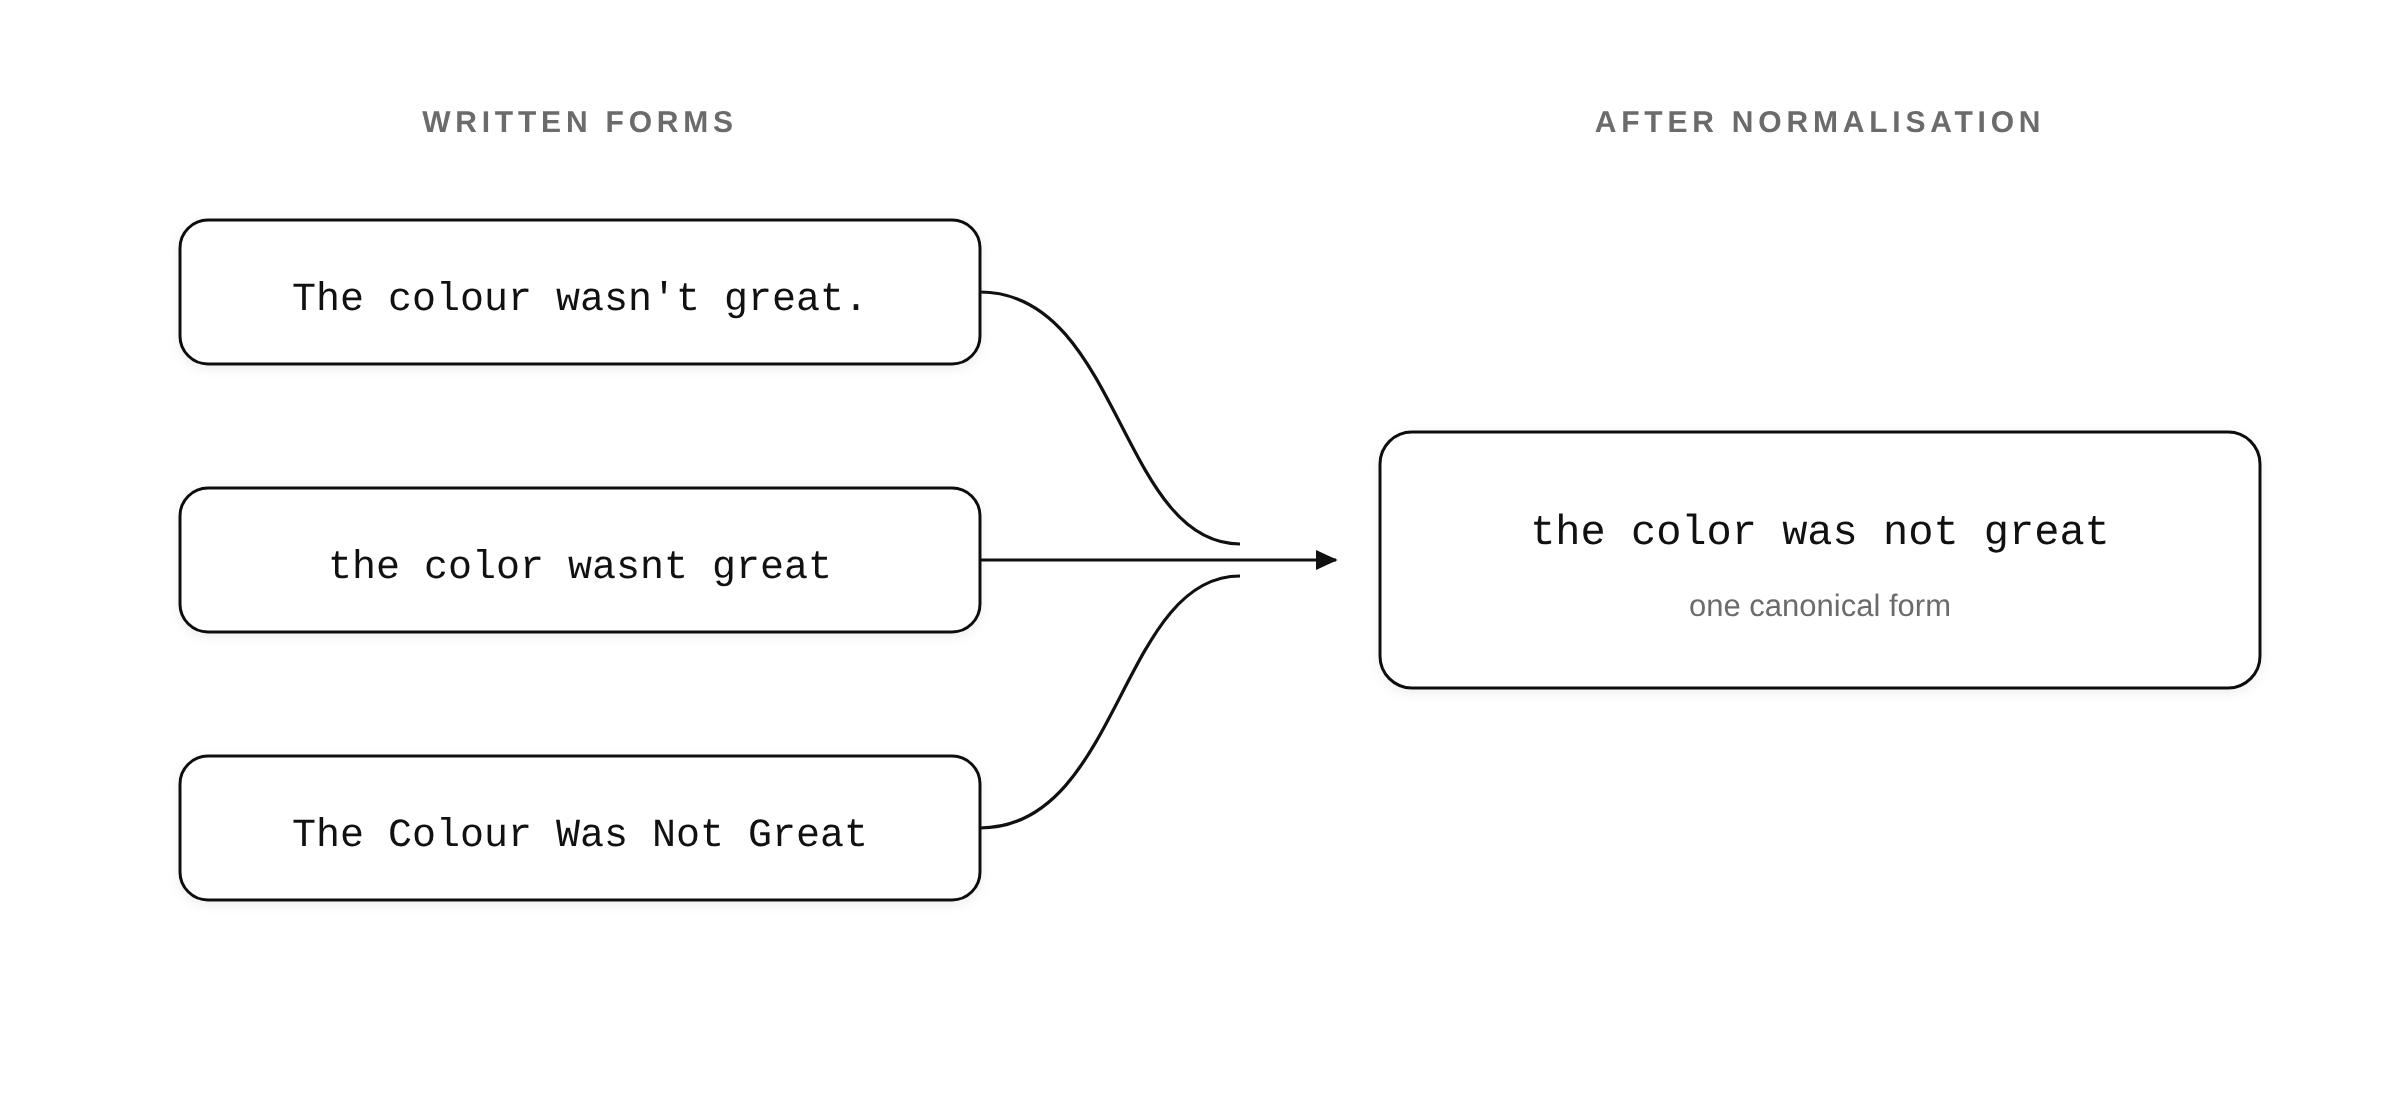
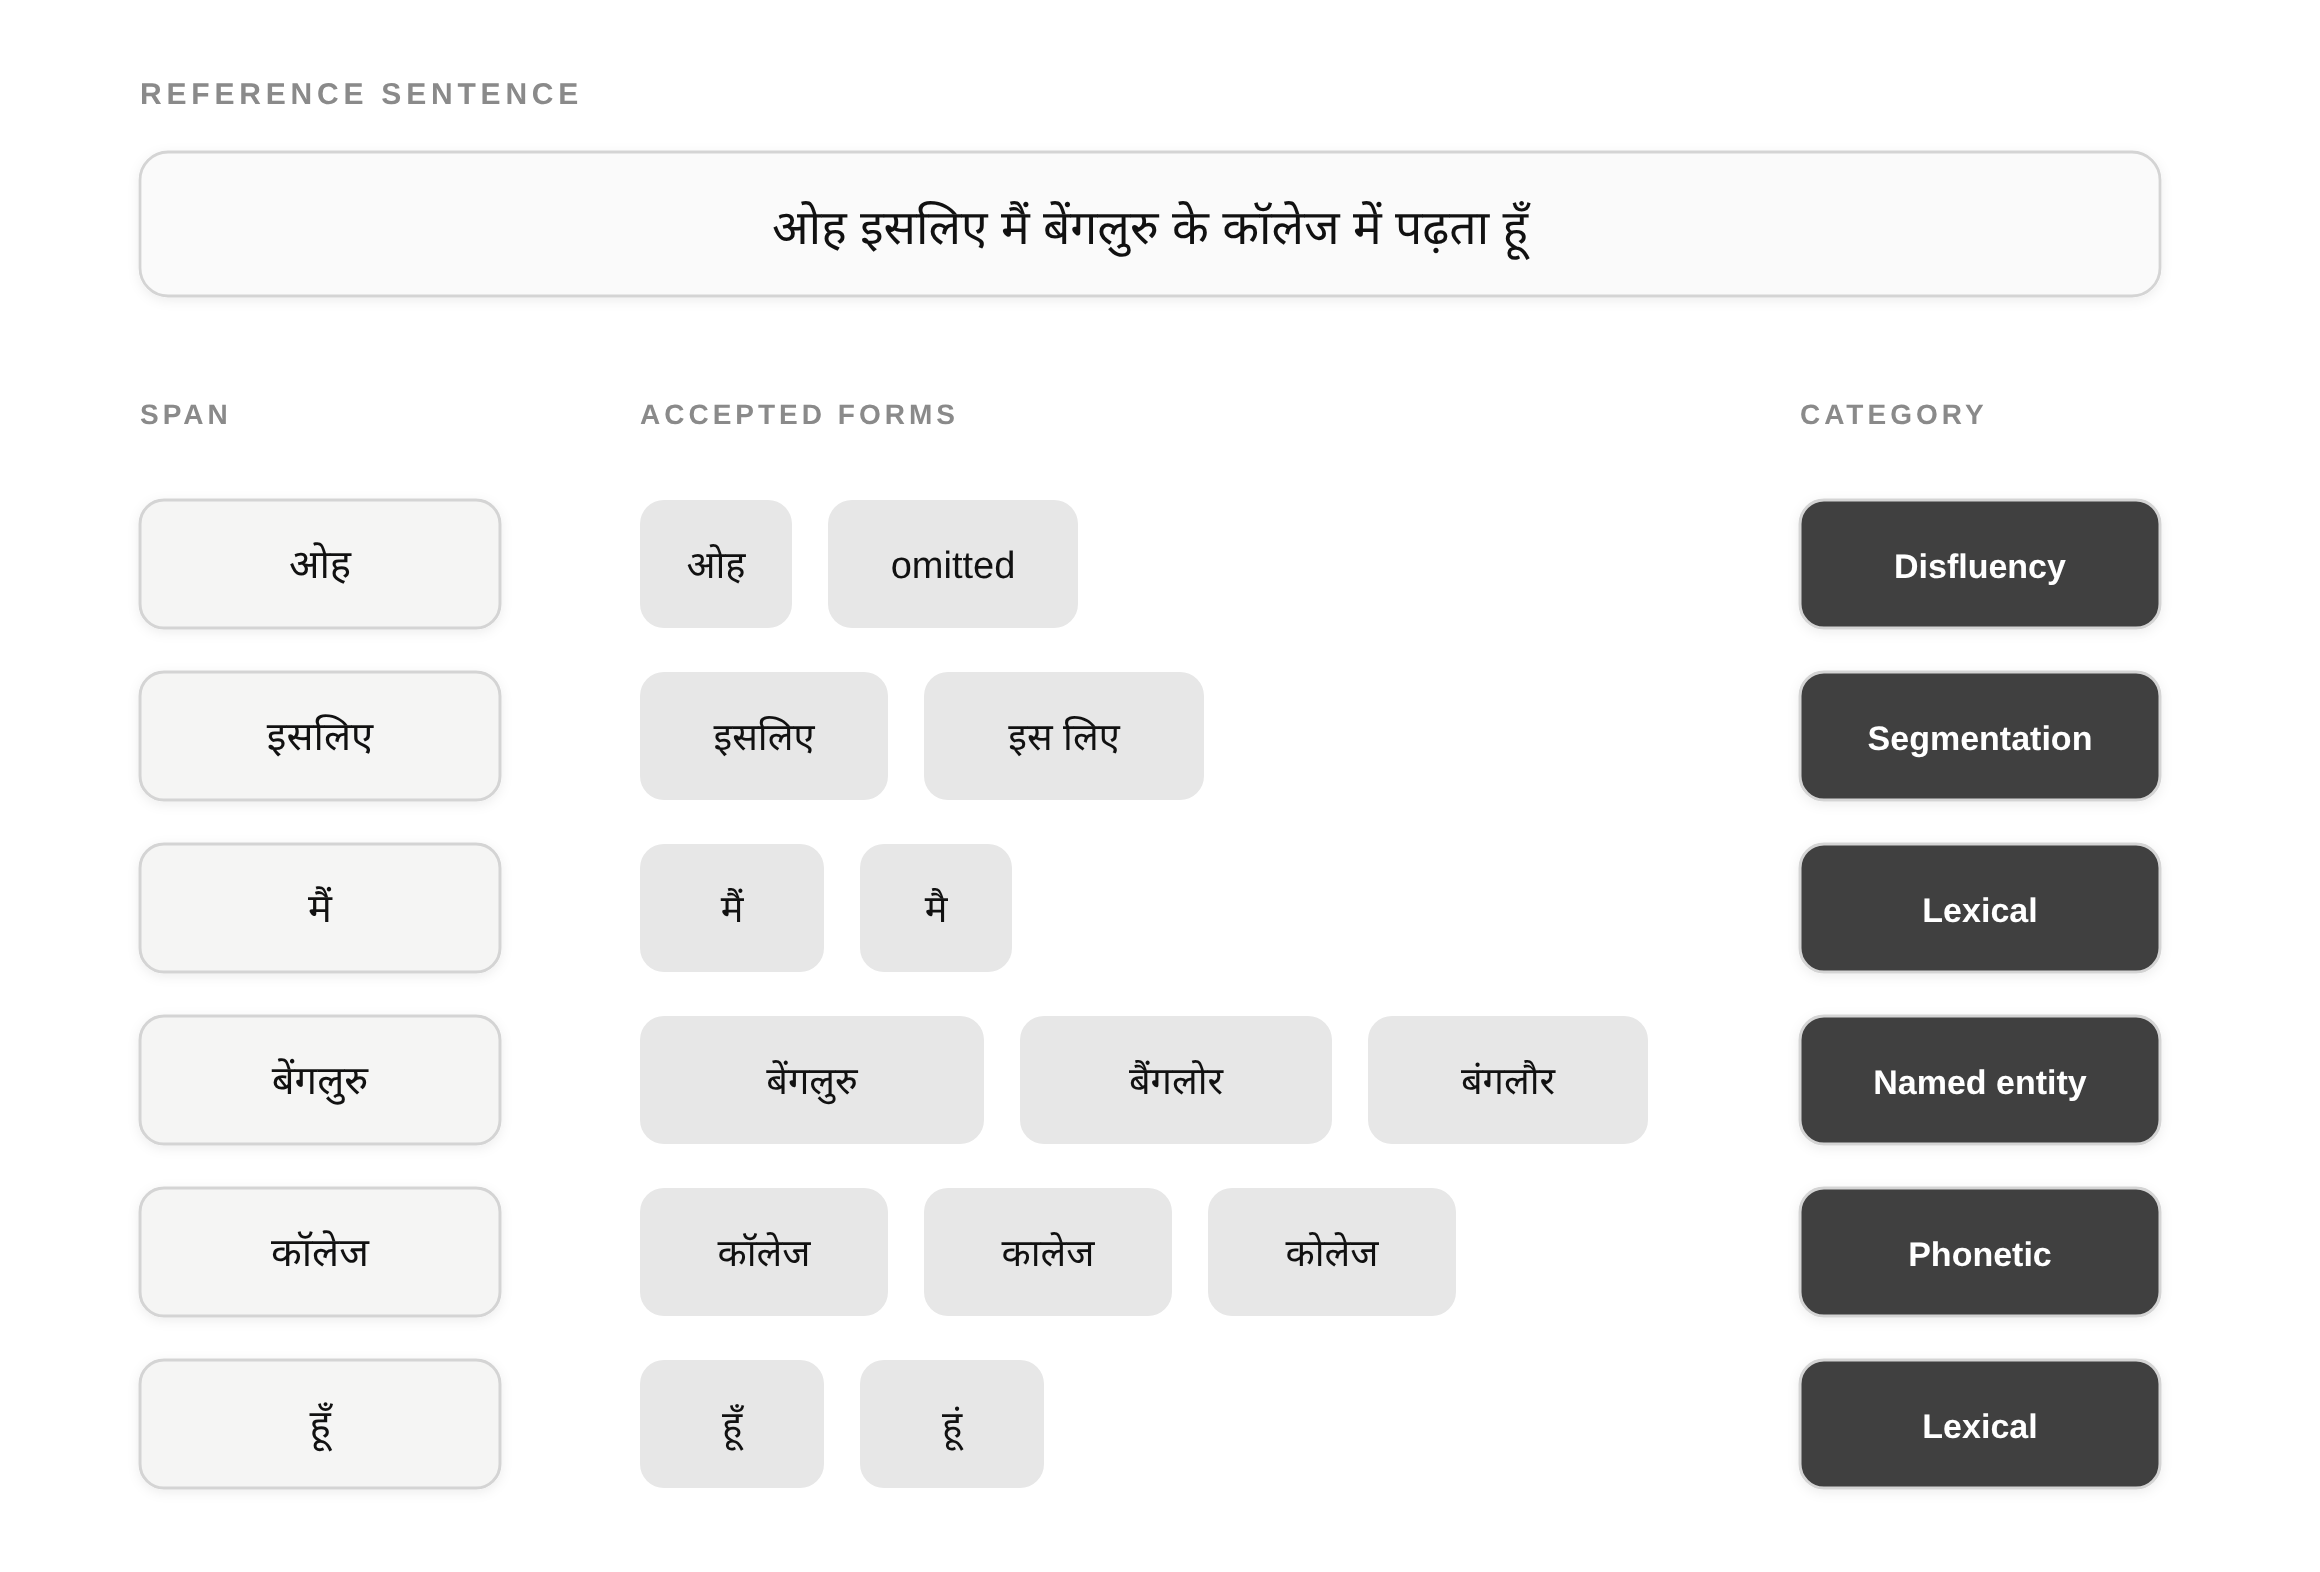
Важным отличием наборов является форма текстовой эталонной записи. Для английского языка применяются стандартные текстовые строки, так как нормализатор лидерборда успешно сводит вариации написания. В хинди вариативность намного выше и не поддаётся однозначному сведению через фиксированные правила, поэтому эталоны для хинди поставляются в виде графов (lattices), содержащих список всех допустимых вариантов написания для каждого участка текста.
Охват и разнообразие дикторов
Датасет Monsoon имеет относительно небольшой суммарный хронометраж в часах, но отличается огромным числом участников. В этом заключается ключевая концептуальная ценность бенчмарка:
- Отсутствие доминирующих голосов: На долю 10 наиболее активных дикторов приходится от 2,8% до 6,8% от общей длительности аудиозаписей в зависимости от подвыборки. Более половины всех участников появляются в датасете ровно по одному разу. Таким образом, итоговый бал модели представляет собой результат усреднения по сотням уникальных голосов, а не по длительным монологам узкой группы людей.
- Широта географии и оборудования: Открытый набор индийского английского охватывает 428 родных районов участников из 30 регионов страны. Аудиозаписи получены с 315–582 различных моделей смартфонов, причём ни одна конкретная модель не превышает 2,1% от общего количества сегментов. Это исключает переобучение алгоритмов под специфическую АЧХ одного микрофона.
- Многообразие акцентов: Индийский английский представлен не единственным стандартным произношением, а в полной географической полноте: в открытой выборке 35% сегментов записаны дикторами с юга страны, 18% — с востока, 18% — из центральных регионов, 16% — с севера и 11% — с запада.
Структура полей метаданных
Каждый сегмент Monsoon сопровождается 18 информационными колонками, 12 из которых содержат детальные метаданные. Все участники дали явное согласие на сбор и публикацию этих сведений. Данные сгруппированы по пяти блокам:
- Идентификаторы сегмента: ID записи, аудиофайл, длительность в секундах, язык, эталонный текст или граф орфографии.
- Данные о дикторе: Уникальный ID диктора, пол, дата рождения.
- Социальный профиль: Профессия, уровень образования, семейное положение, категория дохода.
- География: Родной район, родной штат, текущий город, число лет проживания в текущем районе.
- Оборудование: Производитель смартфона, конкретная модель устройства.
Географическое распределение участников точно отражает реальную демографию. Выборки хинди сконцентрированы в так называемом «поясе хинди», где на штат Уттар-Прадеш приходится около 40% дикторов. В выборках индийского английского распределение намного более равномерное: ни один штат не занимает более 13%, а треть участников проживает за пределами восьми крупнейших регионов.
Процесс сбора данных и контроль качества
Организация масштабного сбора речи в сотнях провинциальных районов требует защиты от рисков: недобросовестного выполнения заданий, попыток загрузки воспроизведённых аудиозаписей вместо живого голоса и ошибок аннотирования.
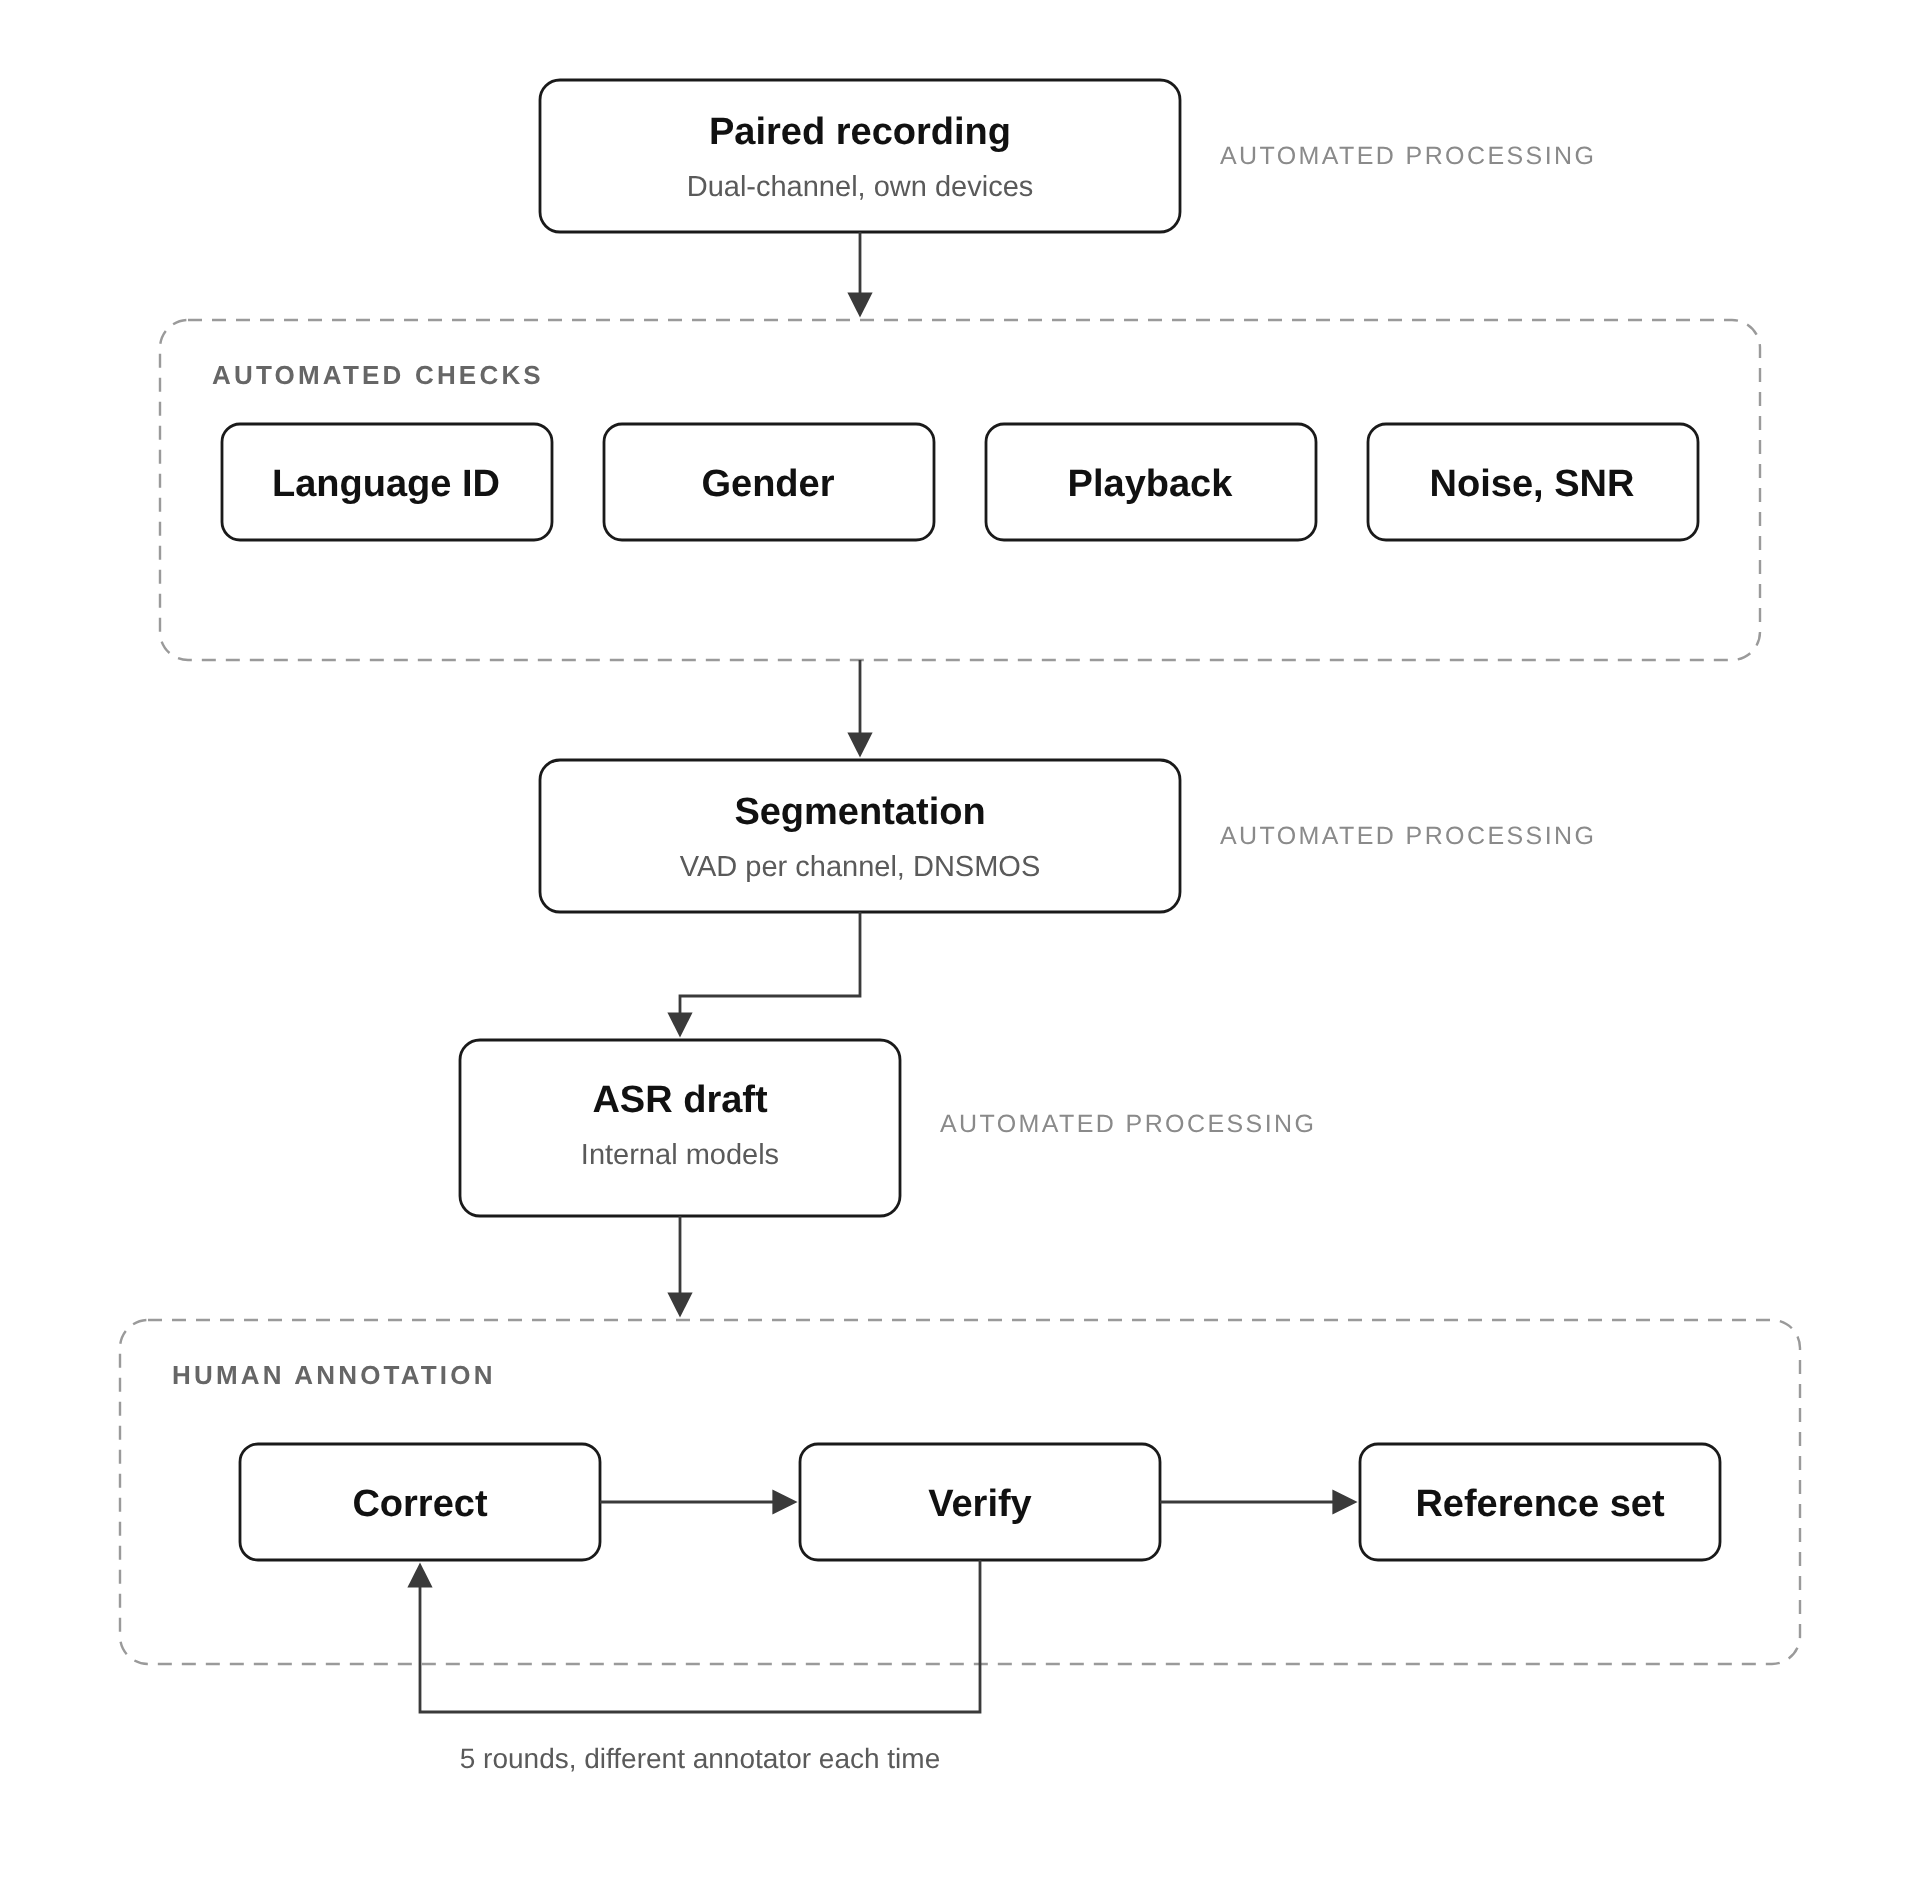

Сбор данных проходил через платформу Voice Arena. Участники объединялись в пары и записывали диалоги в режиме реального времени на личные смартфоны, находясь в привычных акустических условиях (включая нестабильные каналы связи и бюджетные гаджеты). Кандидаты предварительно проходили тест на владение языком, получали финансовое вознаграждение и подписывали согласие на обработку данных. Для предотвращения перекоса выборки действовало жёсткое ограничение на суммарную длительность записей от одного диктора.
Для стимулирования естественной речи разговор направлялся с помощью открытых вводных тем и уточняющих вопросов по темам здравоохранения, путешествий, сельского хозяйства, образования и цифровых сервисов. Сценарии вопросов генерировались языковыми моделями и локализовались лингвистами — носителями языка.
Перед этапом транскрибации все файлы проходили многоступенчатую фильтрацию:
- Автоматическая проверка языка специализированными модельными классификаторами (обученными на 30+ языках).
- Подтверждение пола диктора сверкой с самодекларируемыми данными через отдельный классификатор.
- Фильтрация синтезированных записей и аудио, перезаписанного с динамиков.
- Оценка соотношения сигнал/шум (SNR) для отсева неразборчивых фрагментов при сохранении естественных фоновых шумов.
- Сегментация по детектору речевой активности (VAD) с отсечкой при 2 секундах тишины или при достижении 15 секунд длительности.
- Финальный контроль качества сегментов по стандарту DNSMOS P.808.
Создание эталонных текстов выполнялось носителями языка по пятиуровневому протоколу с полным разделением труда: ни один аннотатор не проверял собственную работу. Первичный черновик генерировался внутренней ASR-системой, не участвующей ни в каких публичных лидербордах. Затем лингвисты последовательно вносили правки, сверяя аудио с текстом, согласовывали неоднозначные фонетические формы, границы переключения языков (code-switching), имена собственные и числовые значения (числа записывались строго словами).
Региональные различия в распознавании речи
Наличие богатых метаданных позволяет проводить глубокий анализ ошибок, недоступный на традиционных бенчмарках. В качестве демонстрации авторы оценили 8 популярных нейросетевых моделей на открытой выборке индийского английского.

По общему показателю WER все 8 моделей расположились в узком диапазоне от 4,81% до 4,99% (разница всего 0,18 процентного пункта). На одном лишь общем датасете эти модели выглядят практически идентичными. Однако при группировке дикторов по пяти макрорегионам (Zonal Councils Индии) выявляется существенный разброс:
- Модель
openai/whisper-large-v3-turboдемонстрирует колебание WER в пределах 0,46 процентного пункта между регионами. - Модель
mistralai/Voxtral-Mini-3B-2507показывает разброс уже в 1,68 процентного пункта (от 4,38% в Центральном регионе до 6,06% на Востоке).
Более того, регион с наибольшим количеством ошибок различается от модели к модели. Так, ibm-granite/granite-speech-3.3-2b показывает наихудшую точность на Севере, microsoft/VibeVoice-ASR-HF — на Юге, а mistralai/Voxtral-Mini-3B-2507 — на Востоке. Это доказывает, что сложность распознавания связана не со свойствами самой аудиозаписи, а со спецификой обучения конкретных ASR-моделей.

Проблема орфографической вариативности в хинди и метрика OIWER
В отличие от английского языка, где вариативность написания легко устраняется стандартным текстовым нормализатором, в хинди ситуация сложнее. Массовое смешение языков (хинглиш), отсутствие единого стандарта деванагари для заимствованных английских слов и различное написание сложных составных слов приводят к тому, что одна и та же произнесённая фраза может иметь десяток равноправных версий записи.
Если оценивать модель по единственному текстовому эталону через классический WER, система будет штрафоваться просто за то, что её орфографический выбор не совпал с мнением конкретного аннотатора. Для решения этой проблемы в подвыборках хинди применяется графовая структура эталонов и метрика OIWER (Orthographically-Informed Word Error Rate), разработанная институтом AI4Bharat. При расчёте OIWER гипотеза модели сравнивается с множеством допустимых вариантов в каждой позиции, и любая корректная запись засчитывается как верная.
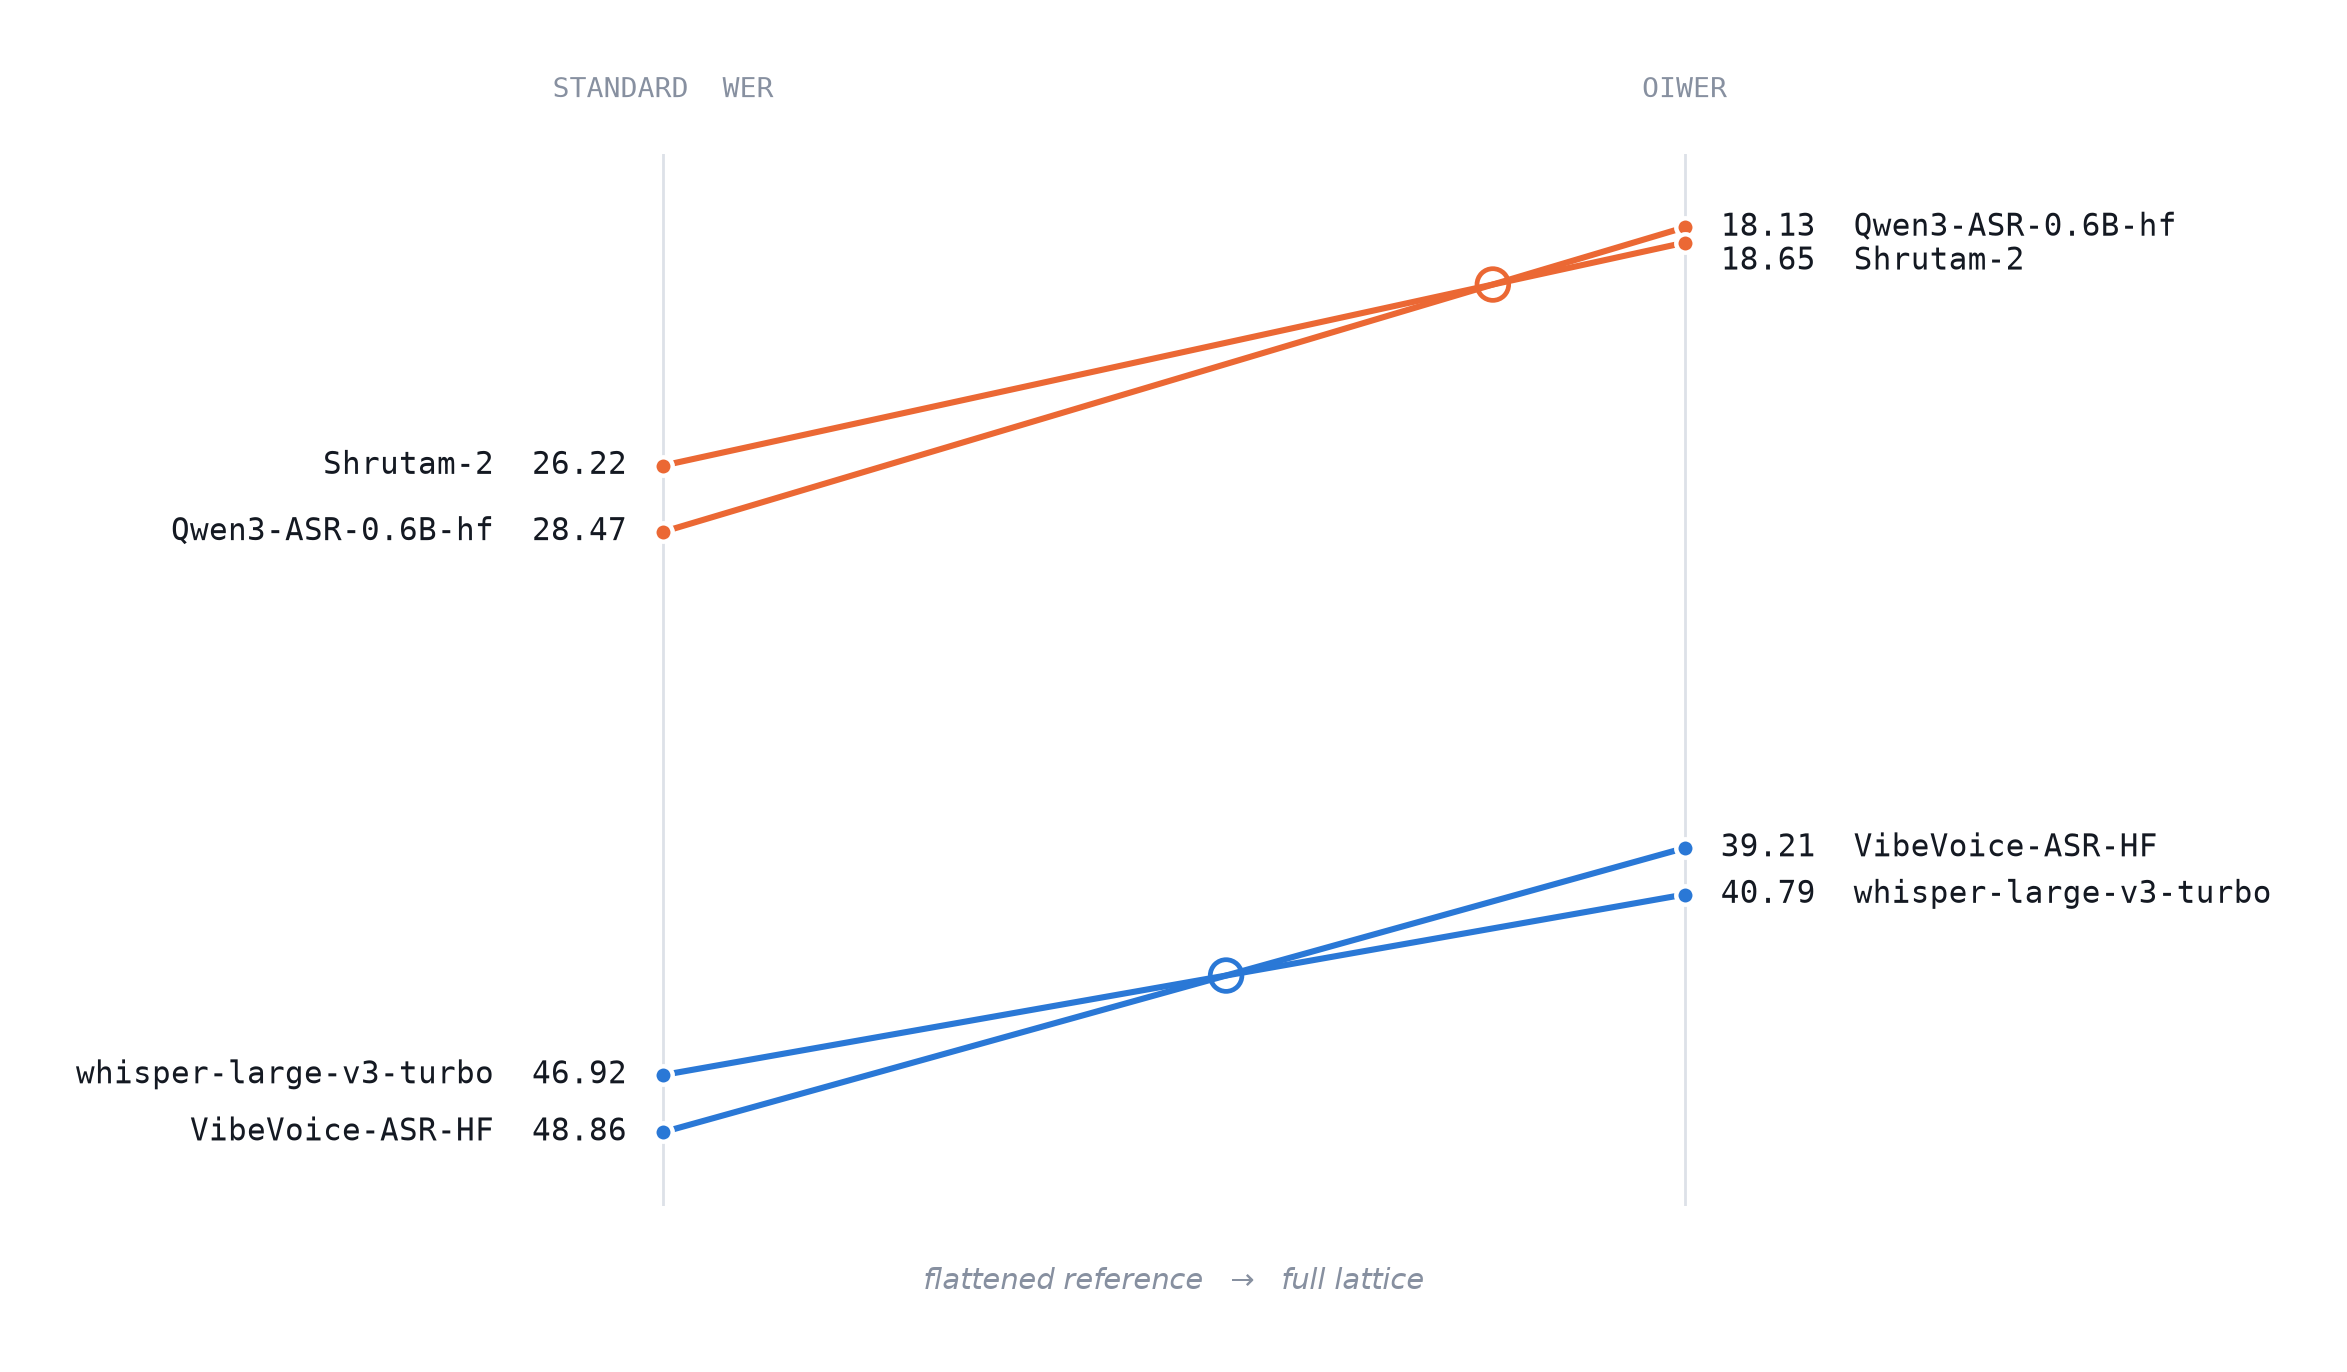
Экспериментальное сравнение показало: если «сплющить» граф вариантов хинди до одиночной текстовой строки, показатель ошибок возрастает у всех моделей без исключения, причём неравномерно. В результате модели меняются местами в рейтинге. Для обеспечения воспроизводимости результатов авторы выложили в открытый доступ библиотеку voi-oiwer.
Подача моделей на тестирование
Для проведения оценки на закрытых частях Monsoon разработчикам необходимо подать заявку в репозитории Open ASR Leaderboard на GitHub через Pull Request. После проверки результатов на публичных наборах команда Hugging Face автоматически рассчитывает метрики на закрытых датасетах.
Индийский английский интегрирован в основной состав лидерборда под названием Voice Arena Monsoon и влияет на итоговый средний балл (Average WER) каждой модели. Данные хинди доступны во вкладке Multilingual, а также в выпадающем меню фильтрации по языкам.
Перспективы развития платформы
Проблемы, выявленные на примере хинди и индийского английского, характерны для большинства языков мира, обладающих высокой орфографической вариативностью или выраженным диалектным разнообразием. Выход наборов данных Monsoon в рамках инициативы Voice Arena открывает возможность объективного аудита ASR-систем и создает условия для построения более сбалансированных и инклюзивных речевых технологий для пользователей Глобального Юга.
Источник: huggingface.co
