
Мой блог
OpenAI представила бенчмарк MultiLangBench и оценила возможности моделей в работе с COBOL

Компания OpenAI представила бенчмарк MultiLangBench, ориентированный на проверку работы нейросетевых моделей с так называемыми малоресурсными языками программирования. В фокус внимания разработчиков попали COBOL, Fortran, OCaml и Visual Basic — языки, которые широко применяются в критической инфраструктуре, но слабо представлены в открытых репозиториях для обучения алгоритмов.
Вместе с открытым тестовым стендом OpenAI раскрыла результаты закрытых испытаний по миграции устаревших программ. Представители индустрии активно ищут способы автоматизировать перенос легаси-кода, однако переход на современные стеки сопряжен со специфическими техническими рисками, требующими ручной верификации каждого этапа.
Почему генеративным моделям сложно дается код на COBOL
Разработанный в 1959 году язык COBOL до сегодняшнего дня остается базисом глобальной финансовой инфраструктуры. По внутренней статистике IBM, на которую ссылается OpenAI, на решениях под управлением COBOL строится более 40% систем онлайн-банкинга, около 80% платежей по банковским картам и до 95% транзакций через банкоматы. В сходной ситуации находится и Fortran, код которого задействован в расчетах безопасности ядерных реакторов и прогнозировании метеоусловий.
Главная сложность для нейросетей заключается в природе обучающих выборок. Большие языковые модели формируются на основе открытого кода и дискуссий программистов в сети. Корпоративный код на COBOL почти никогда не покидал контуры закрытых банковских инфраструктур. В результате модели сталкиваются с дефицитом качественных примеров логики и синтаксиса.
Независимые исследования ранее подтверждали низкую точность работы с такими технологиями. В частности, замеры в рамках проекта COBOL-Coder показали, что модель GPT-4o создавала компилируемый COBOL-код лишь в 41,8% случаев, а выдача корректного решения с первой попытки фиксировалась лишь в 16,4% сценариев. Открытые архитектуры уровня CodeLlama, StarCoder2 и CodeGemma практически не справлялись даже с компиляцией, а трансляция алгоритмов с Java на COBOL показывала околонулевую эффективность.
Методология бенчмарка MultiLangBench и тесты на миграцию
Опубликованный набор тестов MultiLangBench отходит от формата коротких синтетических задач и предлагает моделям комплексное системное задание. Нейросети требуется с нуля спроектировать движок баз данных, полностью совместимый со спецификацией SQLite 3.40.1, на одном из двадцати языков программирования, включая Zig, Lean, Fortran и COBOL. Тестирование исключает доступ к интернету и исходникам SQLite: в окружении предоставляется исключительно документация.
Для верификации разработанных программ OpenAI модифицировала 24 тысячи официальных проверок SQLite из исходных 51 тысячи, сформировав компактную выборку из 272 ключевых тестов. Чтобы получить зачет, модель должна скомпилировать исполняемый файл, корректно обработать базу данных и выполнить входящий SQL-запрос так, чтобы итоговое состояние совпало с результатом оригинальной СУБД.
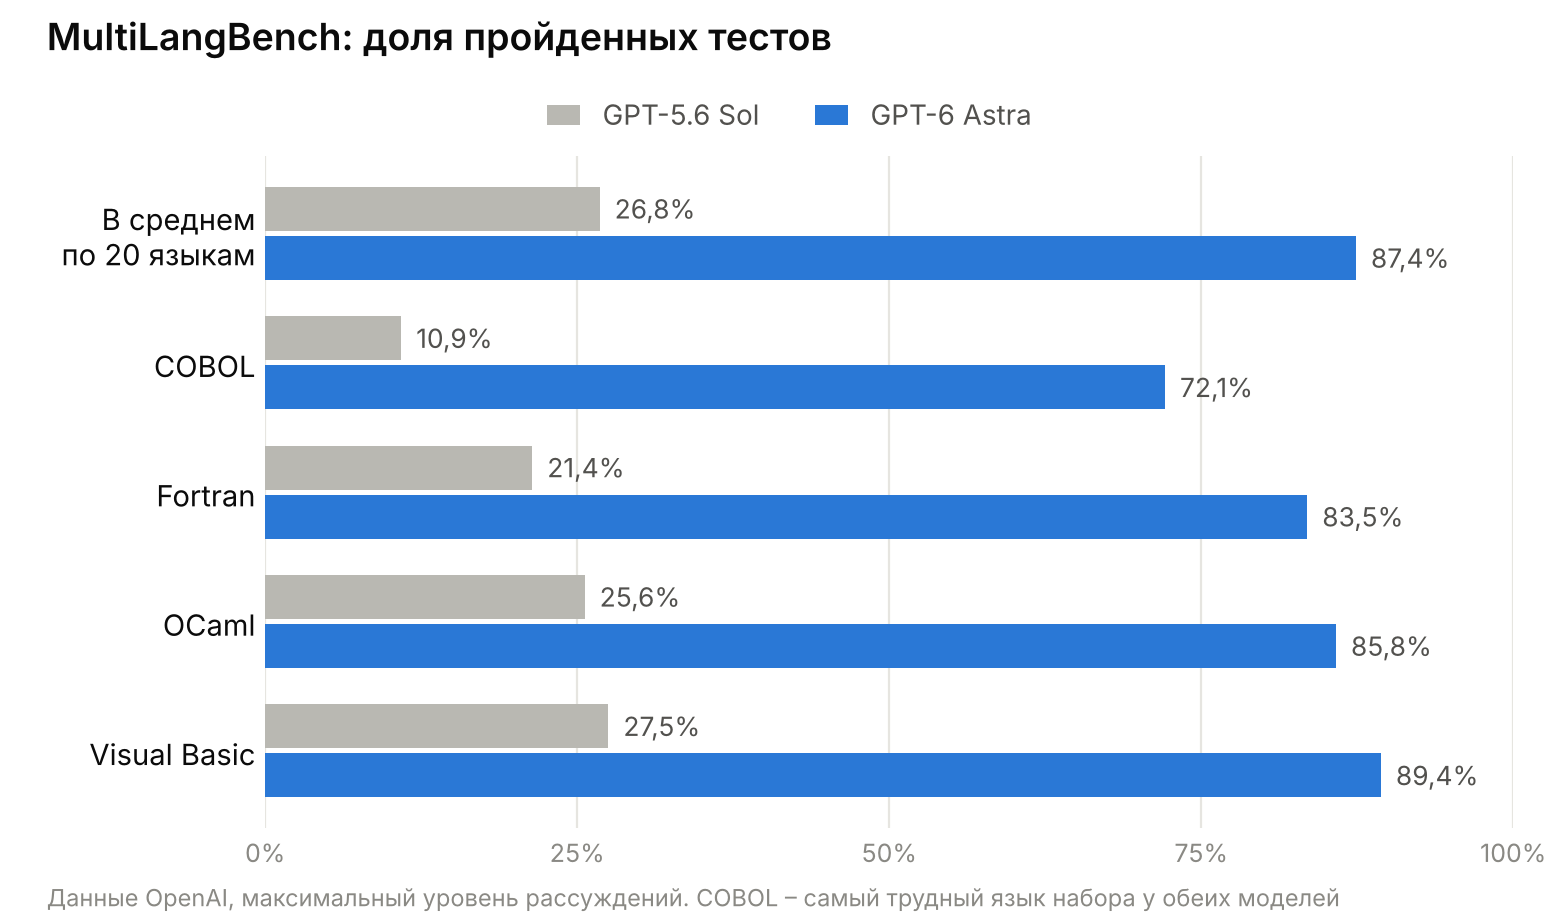
По результатам испытаний GPT-6 Astra показала среднюю успешность 87,4% по 20 языкам против 26,8% у предшественницы GPT-5.6 Sol. В разрезе конкретных сред зафиксированы следующие сдвиги:
- Fortran: подъем точности с 21,4% до 83,5%;
- Visual Basic: повышение с 27,5% до 89,4%;
- OCaml: рост с 25,6% до 85,8%;
- COBOL: увеличение с 10,9% до 72,1%.
Несмотря на прогресс, COBOL оказался единственным языком в выборке, на котором флагманская модель не смогла преодолеть барьер в 83% успешно пройденных тестов. Компактная версия GPT-6 Luna при цене порядка $0,77 за прогон достигла 40,3% успешных решений, превзойдя показатели полноразмерной GPT-5.6 Sol ($3,48 за итерацию).
Оценка побайтовой трансляции легаси-программ
Второе испытание, организованное OpenAI в закрытом контуре, имитирует непосредственные банковские задачи: переписывание COBOL-исходников на C++, Java, Rust, Kotlin или Python. Зачет выставляется только при стопроцентном совпадении выходных бинарных данных на скрытых наборах данных.
Если GPT-5.6 Sol на базовом уровне логических рассуждений давала 5,4% валидных переносов, то GPT-6.1 Sol продемонстрировала 86,6% успешных исходов при снижении затрат на инференс на 39%. Режим с углубленным рассуждением довел показатель модели до 97,9%. Конкретные технические методы дообучения, синтеза данных или фильтрации датасетов создатели моделей в публикации не раскрыли.
Ограничения методологии и специфика реального рефакторинга
Опубликованные результаты содержат ряд методологических ограничений. Сравнение проводилось исключительно внутри поколений моделей OpenAI без привлечения актуальных решений конкурентов, таких как Claude от Anthropic или Google Gemini. Сам датасет для проверки конверсии кода не опубликован, что пока не позволяет сторонним лабораториям воспроизвести метрику в 97,9%.
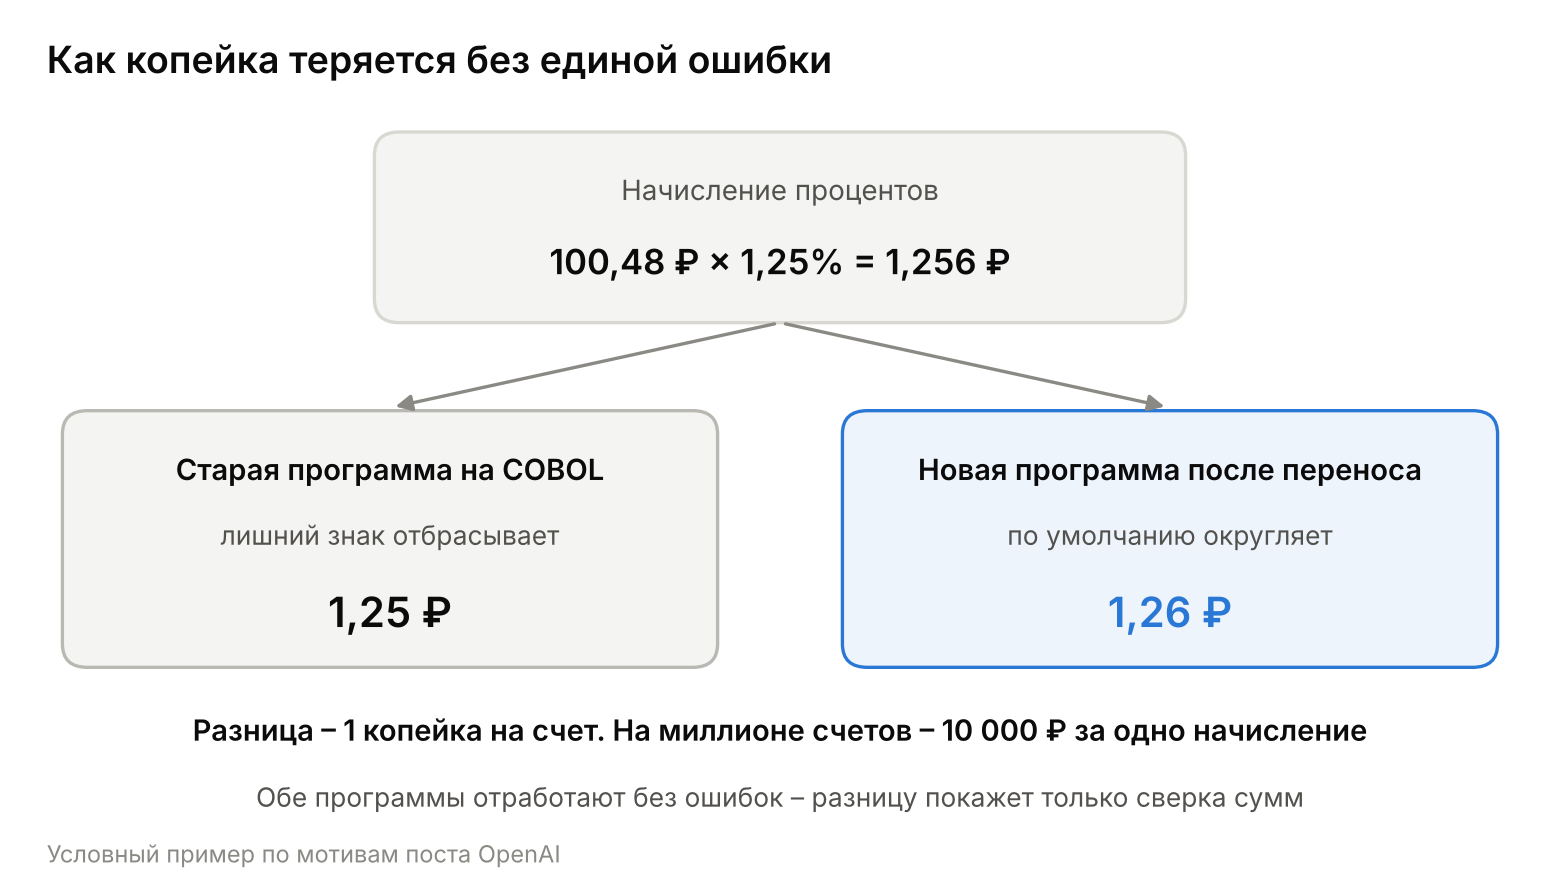
Кроме того, перенос изолированной функции существенно отличается от модернизации цельного репозитория. OpenAI обращает внимание на специфику низкоуровневых операций в COBOL: например, встроенная арифметика с фиксированной точкой отбрасывает лишние знаки дробной части, если в коде нет явной команды на округление. Автоматическая миграция на современные языки, использующие округление по умолчанию, способна визуально проходить тесты компиляции, но искажать финансовые балансы в продакшене.
Масштаб проблемы переноса распределенных систем подтверждают выводы бенчмарка SWE Refactor Bench. В ходе испытаний моделей предыдущих серий на задачах рефакторинга полноценных репозиториев успешными оказались лишь 28 попыток из 520 (около 5,4%). Это демонстрирует разрыв между кодогенерацией отдельных модулей и реальной модернизацией архитектуры, где контроль за бизнес-логикой и краевыми случаями по-прежнему требует экспертного участия инженеров.
