
Мой блог
OpenAI начинает внедрение невидимых водяных знаков в текстах ChatGPT и Codex в ЕС

Компания OpenAI анонсировала внедрение невидимых водяных знаков для контента, создаваемого сервисами ChatGPT и Codex на территории Европейского Союза. Я внимательно изучил технические детали нововведения, которое призвано изменить подход к идентификации машинописного контента с помощью инновационных алгоритмов.
Новая защитная метка остается полностью скрытой при обычном чтении или простом копировании готовых фрагментов. Разработчики пояснили, что фирменная технология textGrain аккуратно модифицирует подбор лексики языковой моделью, формируя устойчивый статистический узор, который в дальнейшем поддается специальному распознаванию.
Особенности развертывания защиты и доступ к детекторам
В ближайшие недели невидимая маркировка станет стандартной для подходящих текстовых ответов ChatGPT и Codex в странах ЕС. При этом масштабный глобальный запуск функции пока не планируется, и компания действует постепенно.
Параллельно разработчики предоставили API-клиентам по всему миру возможность вручную активировать водяные знаки для поддерживаемых языковых моделей, хотя по умолчанию эта опция отключена. Одновременно организация принимает заявки на доступ к официальному детектору, однако на начальном этапе им смогут воспользоваться лишь верифицированные исследователи и профильные экспертные структуры.
Влияние правок и редактирования на эффективность маркировки
Как показывают внутренние тесты компании, технология водяных знаков далека от абсолютной надежности, а стандартное ручное редактирование способно существенно снизить вероятность успешного обнаружения искусственного происхождения.
В ходе оценки фрагментов объемом 400 токенов замена всего 10% слов на синонимы снижала показатель успешного детектирования с 92% до 66%. Если же пользователи переписывали 25% лексики, точность распознавания падала до 17%.
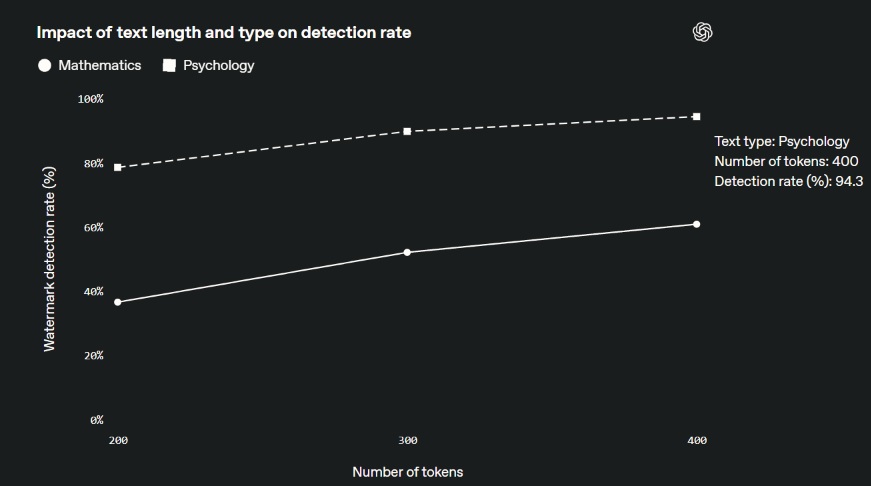
При целевом уровне ложных срабатываний в 1% система успешно выявляла метку примерно в 80% случаев для ответов на вопросы по психологии длиной 200 токенов, тогда как для материалов из 400 токенов этот показатель возрастал до 95%.
Ограничения метода и влияние на производительность моделей
Результаты оказались значительно хуже в точных дисциплинах, например, в математике, где языковая модель имеет меньшую вариативность при выборе синонимов и формулировок.
Специалисты компании особо подчеркивают, что отсутствие обнаруженного водяного знака никоим образом не доказывает авторство человека. Сгенерированный текст может оказаться слишком коротким, подвергнутым правкам или переведенным на другой язык, из-за чего надежная детекция становится невозможной.
Кроме того, наличие метки не позволяет установить конкретную учетную запись, создателя контента, первоначальный промт или особенности диалога, а также определить степень участия человека в финальной доработке.
Тем не менее, внутренние бенчмарки демонстрируют, что задействование механизма textGrain не оказывает существенного влияния на общие возможности и качество работы передовых решений вроде модели GPT-6 Astra, сохраняя прежний уровень производительности.

