
Мой блог
Почему нейросети описывают продукт общими словами: как подготовить сайт к поиску ИИ

Нередко развернутый лендинг или карточка сервиса содержат десятки подробностей, характеристик и сценариев использования, однако чат-боты вроде ChatGPT, GigaChat, Perplexity или Алиса AI пересказывают назначение платформы размытыми клише либо приписывают ей функции конкурентов. Главная причина того, почему нейросети описывают продукт общими словами, заключается в специфике работы поисковых механизмов языковых моделей: они не анализируют веб-ресурс целиком, а выдергивают несколько отдельных текстовых фрагментов из первичного кода.
Если в скачанных фрагментах нет прямого указания на то, что это за продукт, для кого он предназначен и какие задачи решает, ИИ-система не сможет сделать правильный вывод на базе соседних страниц. Ситуация усугубляется технической структурой современных веб-приложений, где значительная часть контента генерируется на стороне браузера и попросту не попадает в базы краулеров.
Как поисковые роботы ИИ-сервисов собирают контент
Принцип обработки сайтов зависит от конкретной архитектуры нейросетевого сервиса. У платформы ChatGPT действуют специализированные роботы компании OpenAI. Основную роль в индексации для поиска играет OAI-SearchBot: именно через него контент попадает в поисковые ответы. При этом краулер GPTBot предназначен для сбора обучающих датасетов и не влияет на отображение ссылок в режиме реального времени, а краулер ChatGPT-User лишь загружает страницу по прямому запросу пользователя, не занимаясь систематическим сканированием сети.
Ассистент Алиса AI использует принципиально иную схему: сервис не имеет отдельного ИИ-краулера для прямого обхода сайтов, а полностью опирается на индекс и ранжирование Поиска Яндекса. Получив запрос, система разбивает его на цепочку подвопросов, находит релевантные документы из верхних позиций поисковой выдачи и формирует ответ по смысловым блокам, к каждому из которых прикрепляется свой первоисточник. Если веб-страница не занимает высоких позиций в традиционном поиске, шансы попасть в ответы голосового помощника минимальны.
Почему краулеры ChatGPT и Claude не читают текст из скриптов
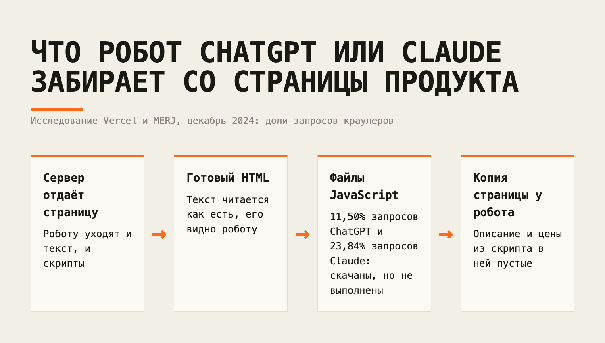
Большинство краулеров нового поколения оптимизируют потребление вычислительных ресурсов и не тратят время на запуск клиентского кода. Роботы ChatGPT и Claude запрашивают у веб-сервера исходный HTML-документ и связанные файлы JavaScript, однако исполнение скриптов не производят. Скачанный JS-код остается для поискового бота просто массивом программного текста, а DOM-дерево, которое обычно собирается в браузере пользователя, робот вообще не видит.
По данным совместного исследования компаний Vercel и MERJ за декабрь 2024 года, скачивание файлов JavaScript составляло 11,50% от общего числа запросов бота ChatGPT и 23,84% запросов краулера Claude. Несмотря на загрузку этих файлов, динамический контент не рендерился. Если описание тарифов, преимуществ или возможностей подгружается через клиентский фреймворк после инициализации скрипта, в сыром HTML эти сведения отсутствуют.
Для исправления проблемы разработчики рекомендуют внедрять серверный рендеринг (Server-Side Rendering, SSR) или генерацию статических страниц. В таком сценарии сервер собирает страницу целиком и отдает боту полноценный HTML с текстом, метаданными и навигационными ссылками. В отличие от роботов OpenAI и Anthropic, поисковый краулер Яндекса умеет рендерить JavaScript по собственному алгоритму, но для ускорения обработки и гарантии видимости отложенного текста вебмастерам также рекомендуется применять SSR либо настраивать ожидание скриптов в панели управления сайтом.
Проблемы с ценами: скрипты и отсутствие открытого прайс-листа
Когда данные о стоимости завязаны на клиентский код, роботы без интерпретатора JavaScript видят пустые блоки. Аналитики агентства Profound изучили 77 публичных страниц с тарифными сетками различных продуктов и зафиксировали, что у 10 из них (примерно каждая восьмая площадка) как минимум 40% базового текста оставалось недоступным для ИИ-краулеров из-за генерации на стороне клиента.
Еще более серьезные искажения происходят, когда веб-ресурс вовсе скрывает тарифы за формой обратной связи или демо-доступом. Оставшись без прямых данных из первоисточника, нейросети обращаются к сторонним сайтам, отзовикам и тематическим веткам на Reddit. В отчете Profound описан пример продукта, где разброс стоимости в ответах ИИ составил от 100 до 2400 долларов за пользователя в месяц. Подобная разница в 24 раза формируется из устаревших комментариев и непроверенных оценок сторонних пользователей.
Почему микроразметка Schema.org не заменяет основной текст
Распространенное предположение о том, что семантическая разметка Schema.org компенсирует отсутствие текста на странице, не подтверждается практикой. Исследователи компании Ahrefs протестировали пять крупных систем — ChatGPT, Claude, Perplexity, Gemini и Google AI Mode. Эксперимент показал, что в режиме веб-поиска в реальном времени все указанные платформы анализируют исключительно видимый HTML-текст. Блоки JSON-LD, скрытая разметка Microdata и RDFa фактически игнорируются механизмами извлечения фактов.
В ходе расширенного наблюдения Ahrefs отслеживал динамику 1885 страниц, внедривших разметку JSON-LD в период с августа 2025 по март 2026 года, сопоставляя их с четырьмя тысячами контрольных URL. Появление структурированных машиночитаемых данных не привело к росту цитируемости в ответах ChatGPT и Google AI Mode, а в блоках AI Overviews показатель даже снизился на 4,6%. Корпорация Google в официальной документации также указывает, что для генеративных поисковых сниппетов наличие специальной разметки Schema.org не является обязательным критерием. Любые характеристики, условия и цены должны присутствовать непосредственно в видимом текстовом слое страницы.
Фрагментация контента и контекстная изоляция абзацев
Архитектура retrieval-augmented generation (RAG), на базе которой функционируют поисковые ИИ, делит документы на небольшие смысловые части (чанки). Если отдельный вырезанный сегмент не содержит прямого названия бренда и четкого определения его сути, модель не свяжет описанные преимущества с конкретной платформой.
Лаборатория Anthropic проиллюстрировала эту уязвимость на примере внутреннего поиска по корпоративным документам: вырванное предложение «выручка выросла на 3%» без контекста не дает ответа, о какой именно компании и каком финансовом периоде идет речь. Для решения проблемы Anthropic рекомендует применять контекстное обогащение чанков — снабжать каждый сегмент префиксом объемом 50–100 токенов с описанием источника. Во внутренних тестах компании такой подход сократил долю неудачных поисковых выборок с 5,7% до 2,9%.
Владелец сайта не может повлиять на алгоритм нарезки текста во внешних системах, но способен защитить свой контент редакторскими методами. Для этого текст избавляют от абстрактных рекламных фраз, привязывая суть продукта к каждому ключевому описанию:
- Абстрактный вариант: «Универсальное решение, которое помогает быстро масштабировать бизнес и автоматизировать рутинные процессы» (нейросеть не поймет, о каком типе софта идет речь).
- Информативный вариант: «Программа Кассир — это облачная касса для небольших интернет-магазинов, которая принимает оплату картами, фискализирует чеки и мгновенно отправляет их покупателям».
Пошаговый чеклист: оптимизация сайта для нейросетей
Для того чтобы роботы корректно извлекали данные о назначении и стоимости сервиса, рекомендуется провести аудит веб-ресурса по шести ключевым направлениям:
- Настройки файла robots.txt. Проверьте директивы для User-agent: OAI-SearchBot. Если прописана блокирующая строка Disallow: /, сайт полностью исключается из поискового индекса ChatGPT. При отсутствии выделенного блока убедитесь, что доступ не закрыт в глобальной секции User-agent: *.
- Проверка сырого HTML-кода без JavaScript. Загрузите страницу без исполнения скриптов и проверьте наличие названия продукта, формулировки позиционирования и цен. Сделать это можно через отключение JS в браузере или с помощью консольной утилиты:
curl -s https://example.ru/product | grep -ci "облачная". Нулевое значение указывает на то, что контент формируется скриптом либо отсутствует в коде. Аналогичным образом нужно проверить содержимое вкладок, аккордеонов и слайдеров. - Перевод динамических блоков на SSR. Если ключевая информация отсутствует в первичном ответе сервера, настройте серверный рендеринг или предварительную генерацию статических страниц. Для роботов Яндекса используйте инструменты контроля рендеринга в панели Вебмастера.
- Сверка JSON-LD с видимым слоем. Убедитесь, что все важные сведения, прописанные в микроразметке, дублируются в основном тексте страницы обычными предложениями.
- Автономия каждого смыслового абзаца. Прочитайте каждый абзац изолированно от основного заголовка H1. Если из текста не ясно, какой инструмент описывается и для кого он создан, добавьте название бренда и класс продукта.
- Тестирование поисковых формулировок в нейросетях. Задайте прямой вопрос о продукте моделям ChatGPT, GigaChat, Perplexity и Алиса AI. При выявлении фактических ошибок изучите список источников, на которые ссылается алгоритм: возможно, устаревшие сведения транслируются со сторонних каталогов.
Приоритеты внедрения и специфика аналитических данных
Оптимизацию структуры разумно начинать с проверки исходного HTML-кода. Пока текстовое описание не отдается сервером напрямую, любые редакторские правки абзацев останутся незамеченными краулерами вроде OAI-SearchBot или бота Claude. Вторым приоритетом выступает переписывание абстрактных маркетинговых конструкций в самодостаточные блоки, устойчивые к механическому дроблению на чанки.
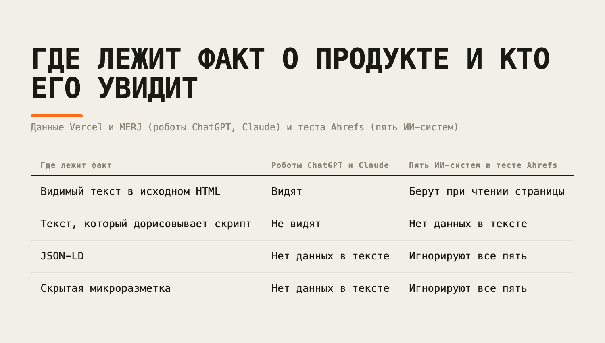
При этом важно учитывать границы применимости текущих исследований: данные Vercel и MERJ получены в конце 2024 года, а специфика работы поисковых сборщиков GigaChat или Perplexity с исполнением скриптов публично не детализирована. Кроме того, системы генеративного поиска регулярно обновляют алгоритмы ранжирования и цитирования источников. Тем не менее размещение фактов в первичном HTML и устранение контекстной двусмысленности остаются базовым техническим требованием для любого сайта, ориентированного на ИИ-трафик.
