
Мой блог
Почему я отказался от платных подписок на ChatGPT и Claude в пользу бесплатной локальной нейросети

Подробности изложены в материале первоисточника. Анализируя свои привычки использования искусственного интеллекта, я обратил внимание на то, какую значительную часть моих ежедневных задач закрывали облачные сервисы. Подписки на флагманские инструменты от разных компаний обходились в круглую сумму ежемесячно, побуждая меня искать альтернативы среди локальных моделей. В итоге я нашел бесплатное решение, которое полностью заменило мне облачные аналоги без потери в качестве.
Затраты на подписки на популярные облачные ИИ-платформы постепенно стали ощутимо бить по кошельку. Попытка подобрать работающий на ПК вариант увенчалась успехом: я обнаружил инструмент, справляющийся с большинством моих повседневных нагрузок. Переход на запуск локального ПО открыл совершенно новый подход к работе с алгоритмами машинного обучения.
Как локальная модель Qwen изменила мой подход к работе
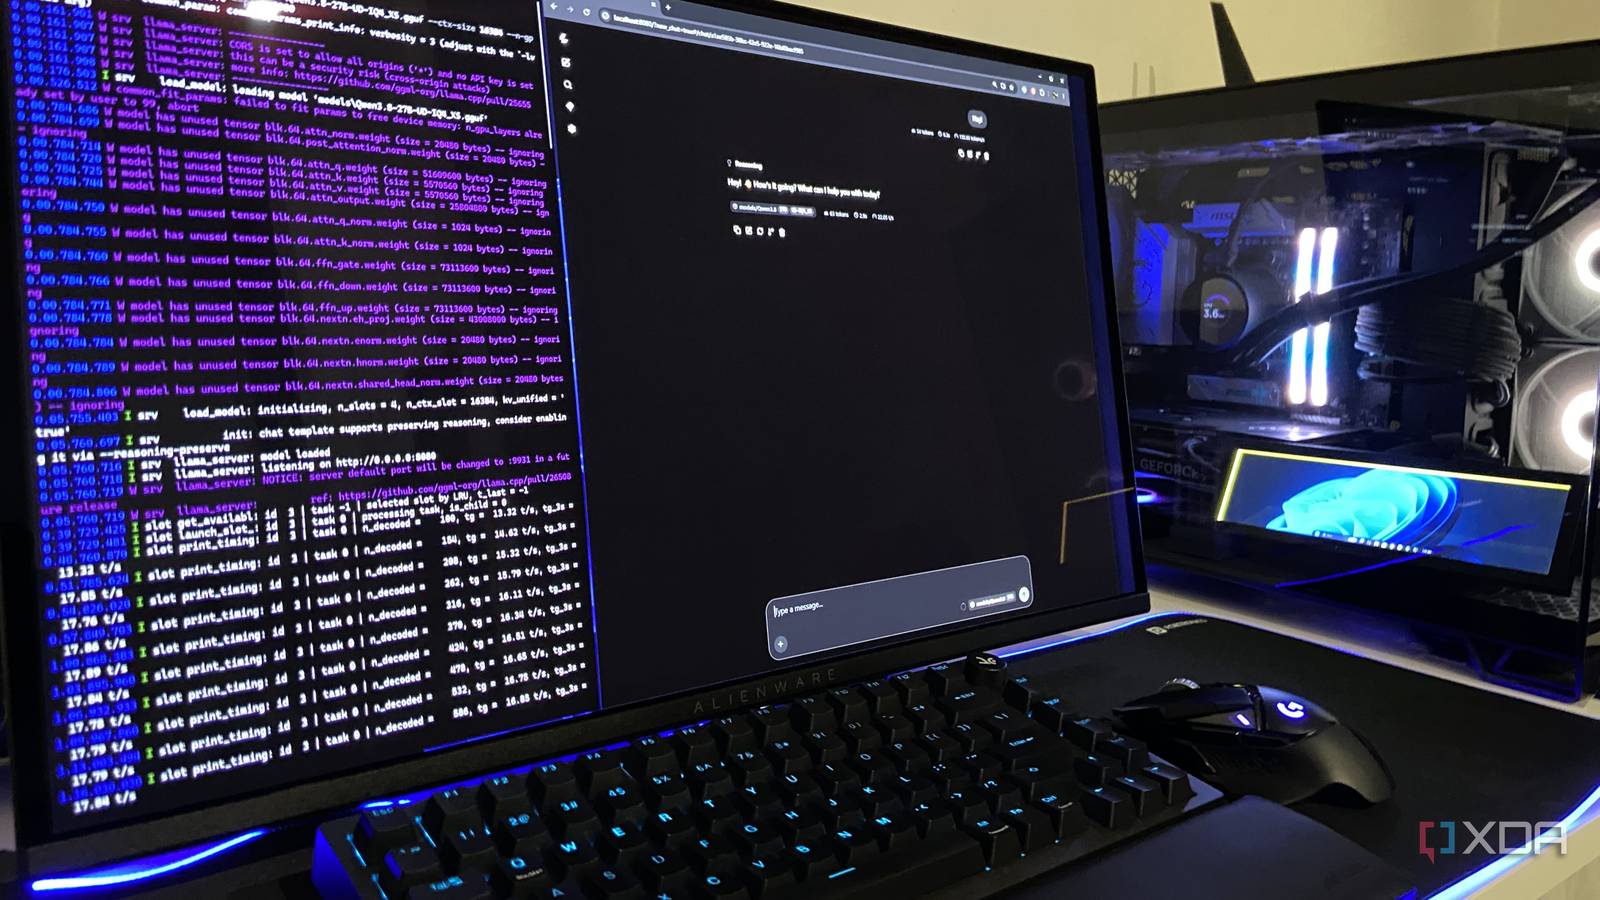
До знакомства с Qwen 3.8-27B я полагал, что запуск искусственного интеллекта на собственном железе потребует компромиссов в виде урезанного функционала или меньшего уровня интеллекта по сравнению с облачными гигантами. Однако практика показала обратное. Сборка UD-IQ4_XS от Unsloth весит 13,3 ГБ и свободно помещается в видеопамять моей видеокарты RTX 4070 Ti Super с 16 ГБ GDDR6X, оставляя достаточный запас для окна контекста на 16K токенов.
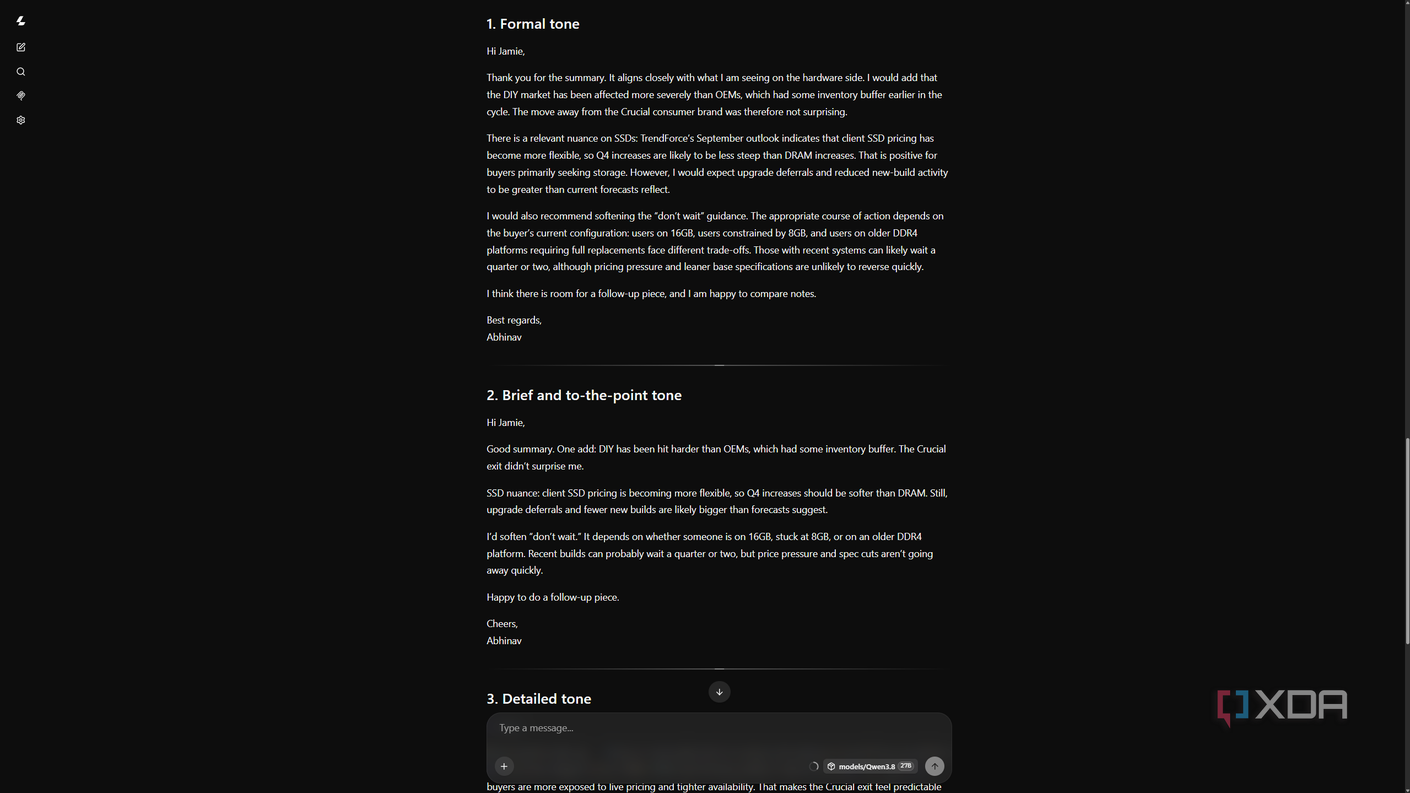
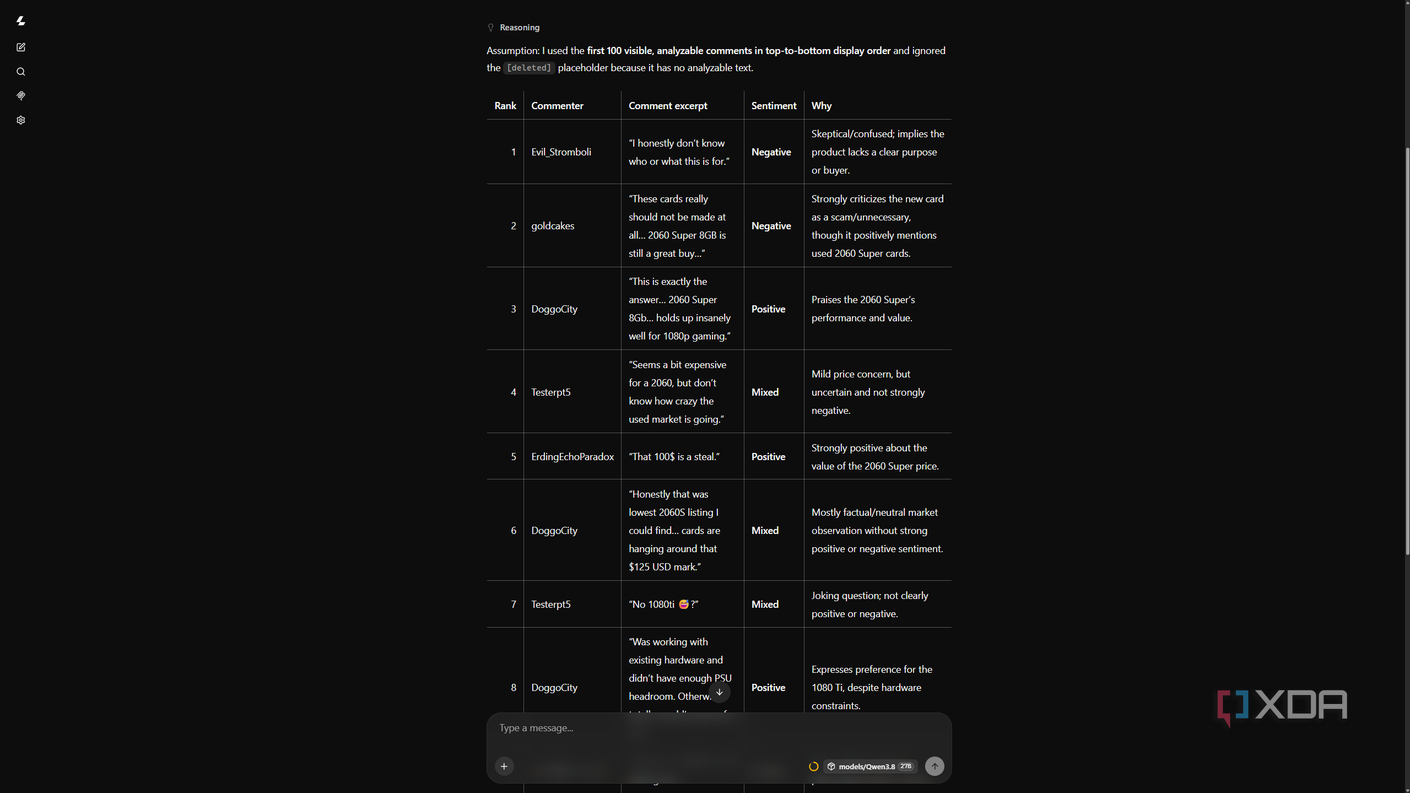
Инструмент llama.cpp развертывает модель через localhost со скоростью, к которой привыкаешь за пару минут использования. Средняя скорость генерации составляет около 33,7 токена в секунду. В тестовом задании на Python/Pygame я попросил нейросеть написать рабочую игру «Змейка» в одном файле, и она справилась с задачей с первой попытки. Текстовые запросы обрабатываются с такой же легкостью — модель превосходно справляется со стандартными задачами суммаризации и анализа, ради которых раньше приходилось обращаться к облаку.
Почему ChatGPT оказалось проще всего заменить локальным аналогом
Большая часть моих сценариев использования ChatGPT вообще не требует задействования удаленных дата-центров. Чаще всего я применяю искусственный интеллект для проверки грамматики, редактирования писем и извлечения ключевых деталей из объемной входящей корреспонденции. Иногда алгоритм помогает сократить перегруженные предложения или переформулировать запутанные мысли в четкие формулировки.
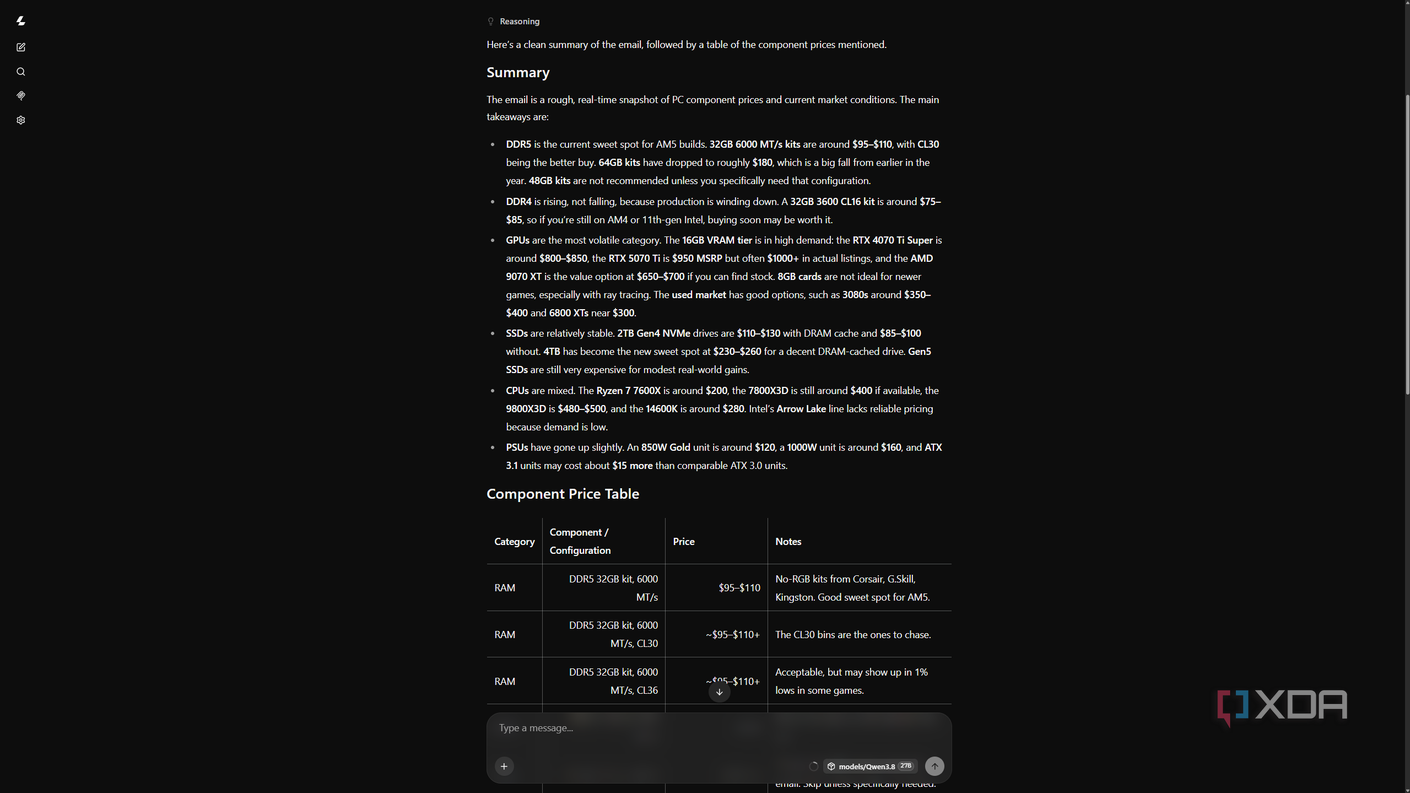
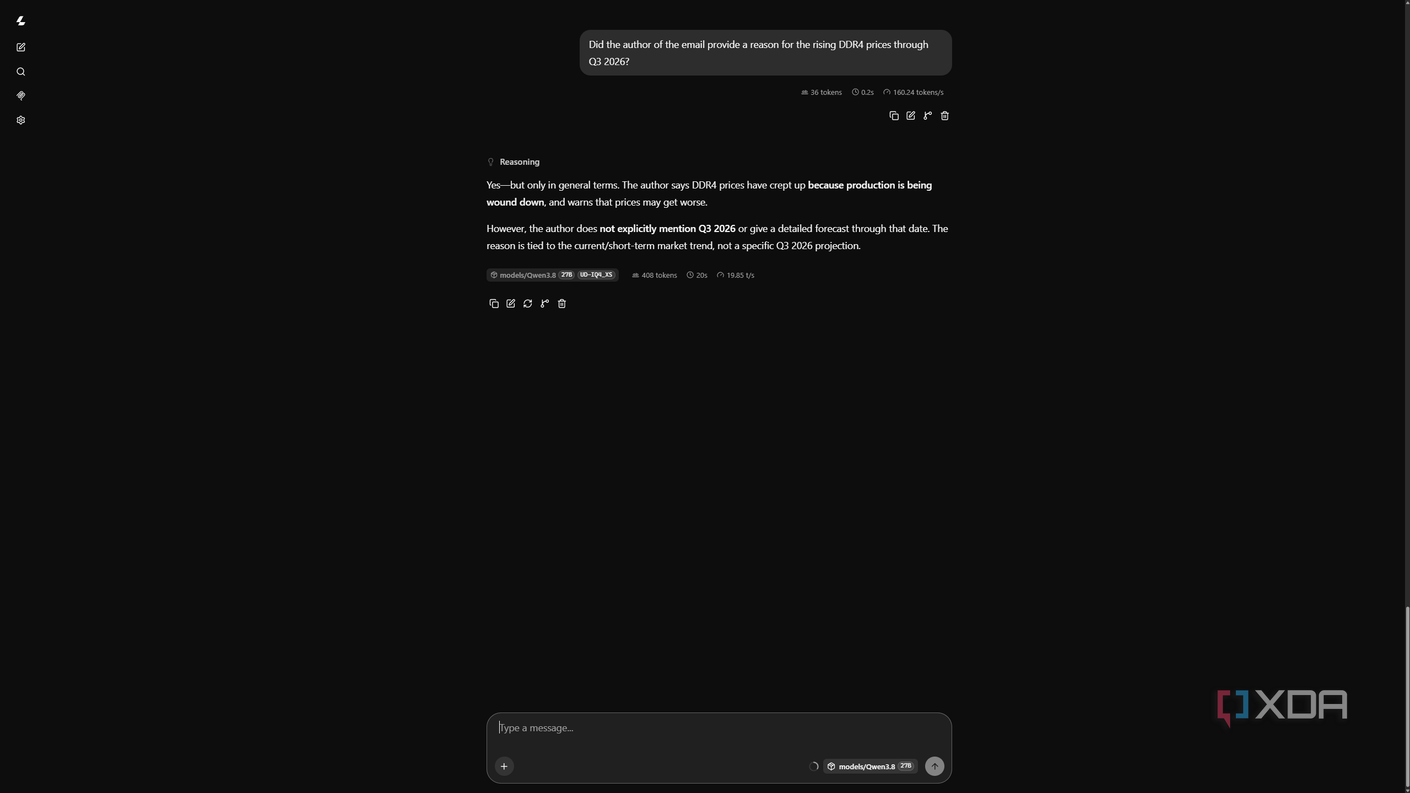
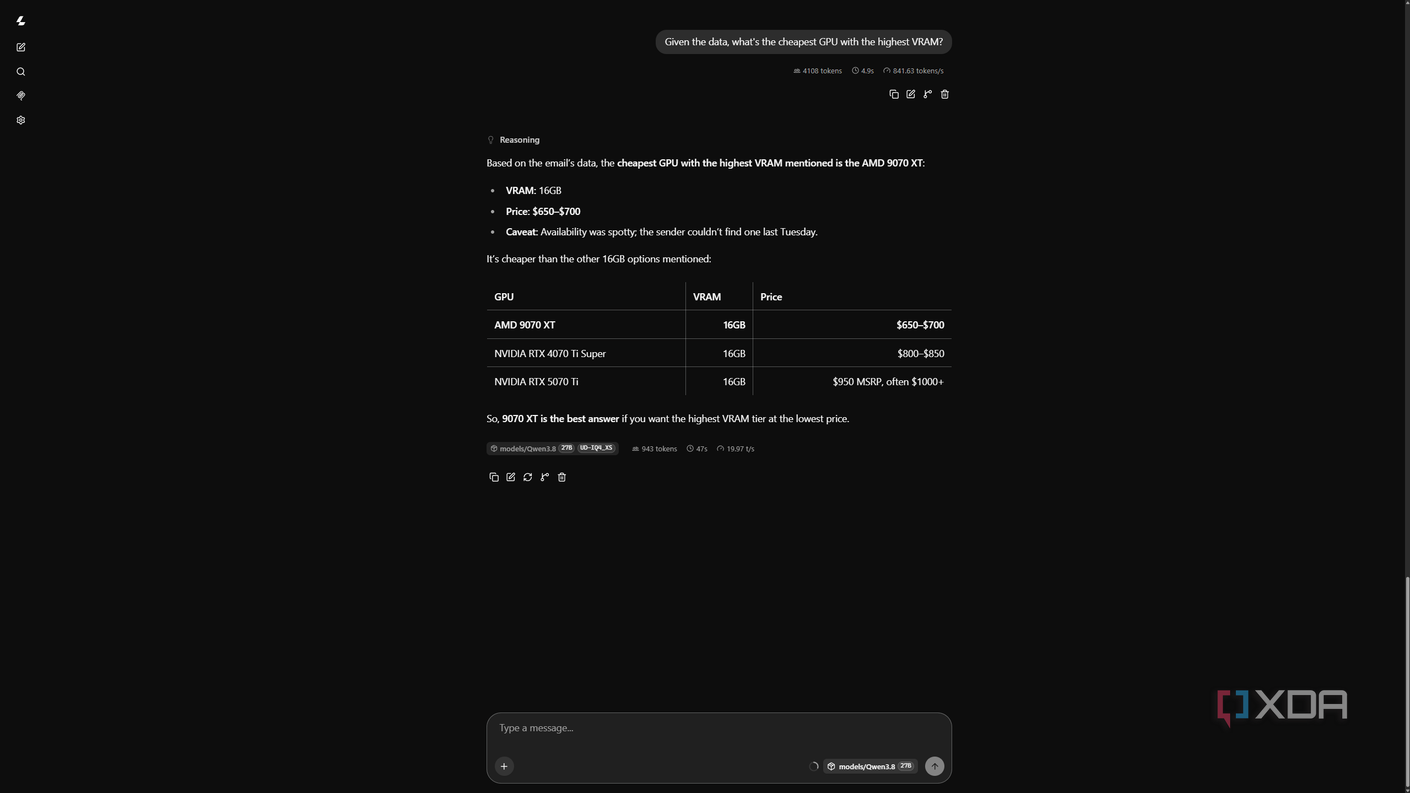
Я также активно использую анализ тональности при исследовании рынков и продуктов, изучая пользовательские форумы и отзывы. Пропустив через Qwen 3.8-27B намеренно хаотичное письмо о ценах на комплектующие ПК с десятком разрозненных цифр, я получил на выходе аккуратно структурированную таблицу со всеми данными. Это стало финальным аргументом для отмены подписки в банковском приложении.
Ограничения Claude и преимущества работы без лимитов
Модели от Anthropic действительно сильны в программировании, и их влияние на рабочие процессы разработчиков трудно переоценить. Я применяю их для итеративных задач в проектах на Python, где требуется постоянный обмен репликами. Главная сложность заключается в жестких лимитах и защитных барьерах компании.
Когда пятичасовой лимит исчерпывается, единственным выходом в облачном варианте остается оформление дополнительной оплаты или ожидание сброса квот, что полностью разрушает продуктивный темп кодинга. Локальный запуск полностью решает эту проблему: здесь нет суточных ограничений, недельных квот или растущих счетов. Проект можно оставить обрабатываться на всю ночь, а единственными затратами останутся потребляемые видеокартой ватты.
Конфиденциальность данных и безопасность на ПК
Важным дополнительным преимуществом стало то, что ни одна строка кода или аналитический отчет не покидают пределы моего компьютера. Все файлы приложений и бенчмарки остаются на локальном диске, не попадая на сторонние серверы с неизвестными правилами хранения данных. Открытый фреймворк llama.cpp позволяет запускать языковые модели прямо на ПК с максимальной эффективностью.
Почему бесплатные локальные модели бесценны для правильного рабочего процесса
Хотя модель Qwen 3.8-27B не бьет рекорды в бенчмарках, для моих практических задач максимальная производительность в тестах не имеет значения. На платформе Hugging Face можно найти подходящую конфигурацию практически для любого железа — от компактных версий Gemma для ноутбуков до небольших сборок Qwen для старых ПК.
Все они бесплатны и требуют затрат только на приобретение оборудования. Подобная гибкость полностью оправдывает эксперименты по настройке собственного ИИ-окружения, избавляя от необходимости регулярно переплачивать за облачные подписки.
