
Мой блог
Как построить надежный пайплайн для оценки агентных систем и LLM-продуктов

Современная разработка продуктов на базе искусственного интеллекта требует глубокого понимания того, как правильно организована оценка агентных систем. В материале рассматривается комплексный подход к замерам качества, построению контрольных точек и тестированию комплексных цепочек взаимодействия моделей с внешними инструментами.
Понимание особенностей работы больших языковых моделей и сопутствующих рисков позволяет выстроить устойчивую инфраструктуру для проверки каждого нового обновления перед его релизом.
Основные понятия и проблемы тестирования
Прежде чем переходить к практическим инструментам валидации, необходимо четко определить ключевые компоненты архитектуры. Языковая модель (LLM) функционирует как стохастическая система предсказания токенов, а инструменты (tools) представляют собой внешние функции и API, вызываемые по ходу генерации структурированных данных. Агент в свою очередь работает в циклическом режиме «рассуждение — вызов инструмента — получение результата», пока не решит поставленную задачу.
Главная сложность тестирования таких систем заключается в их недетерминированности. В классическом программировании применяется жесткое сравнение результатов, тогда как в случае с агентами ошибки имеют свойство накапливаться на протяжении десятков шагов выполнения. Неверное действие на промежуточном этапе может привести к тому, что вся дальнейшая траектория отклонится от целевого сценария.
Многослойная методология тестирования
Для минимизации рисков и покрытия всех возможных сценариев применяется многоуровневая методология, которую часто сравнивают с моделью швейцарского сыра. Ни один отдельный метод не дает стопроцентной гарантии, но их комбинация позволяет выявлять подавляющее большинство дефектов.
- Бенчмарки для широкой оценки качества на стандартизированных наборах данных.
- Функциональные тесты для проверки краевых условий и защиты от регрессий.
- Анализ траекторий выполнения для контроля последовательности вызовов инструментов.
- Использование языковых моделей в роли судей (LLM-as-a-Judge) для автоматизированной оценки.
- Внешняя ручная разметка силами асессоров и экспертная оценка внутренней командой.
- Мониторинг на реальном продакшн-трафике и проведение A/B-тестирования.
Бенчмарки и сбор собственных данных
Бенчмарки содержат входящие данные и эталонные ответы либо проверяемые критерии успешности. Различают открытые публичные решения и самописные базы под конкретный домен компании.
Открытые бенчмарки и их ограничения
Среди популярных публичных платформ выделяются SWE-bench для работы с программным кодом репозиториев, общий ассистентский бенчмарк GAIA для длинных траекторий и BFCL с фокусом на корректность вызова инструментов. Главная проблема таких решений заключается в потенциальной утечке данных в обучающие выборки моделей, из-за чего измеряется не способность рассуждать, а заученная память.
Создание собственного бенчмарка
Для создания релевантного тестового набора используются исторические логи старых систем, синтетическая генерация через языковые модели для покрытия редких сценариев, а также семплированные и размеченные данные реального продакшена. Последний источник считается наиболее ценным для проверки практической работоспособности фичи.
Функциональное тестирование и проверка траекторий
Функциональные тесты делятся на сценарии с фиксированным ответом, где применяются классические утверждения (assert), и сценарии с изменяющимся ответом, требующие привлечения судей. Особое внимание уделяется негативным кейсам, предотвращающим ложное срабатывание защитных фильтров.
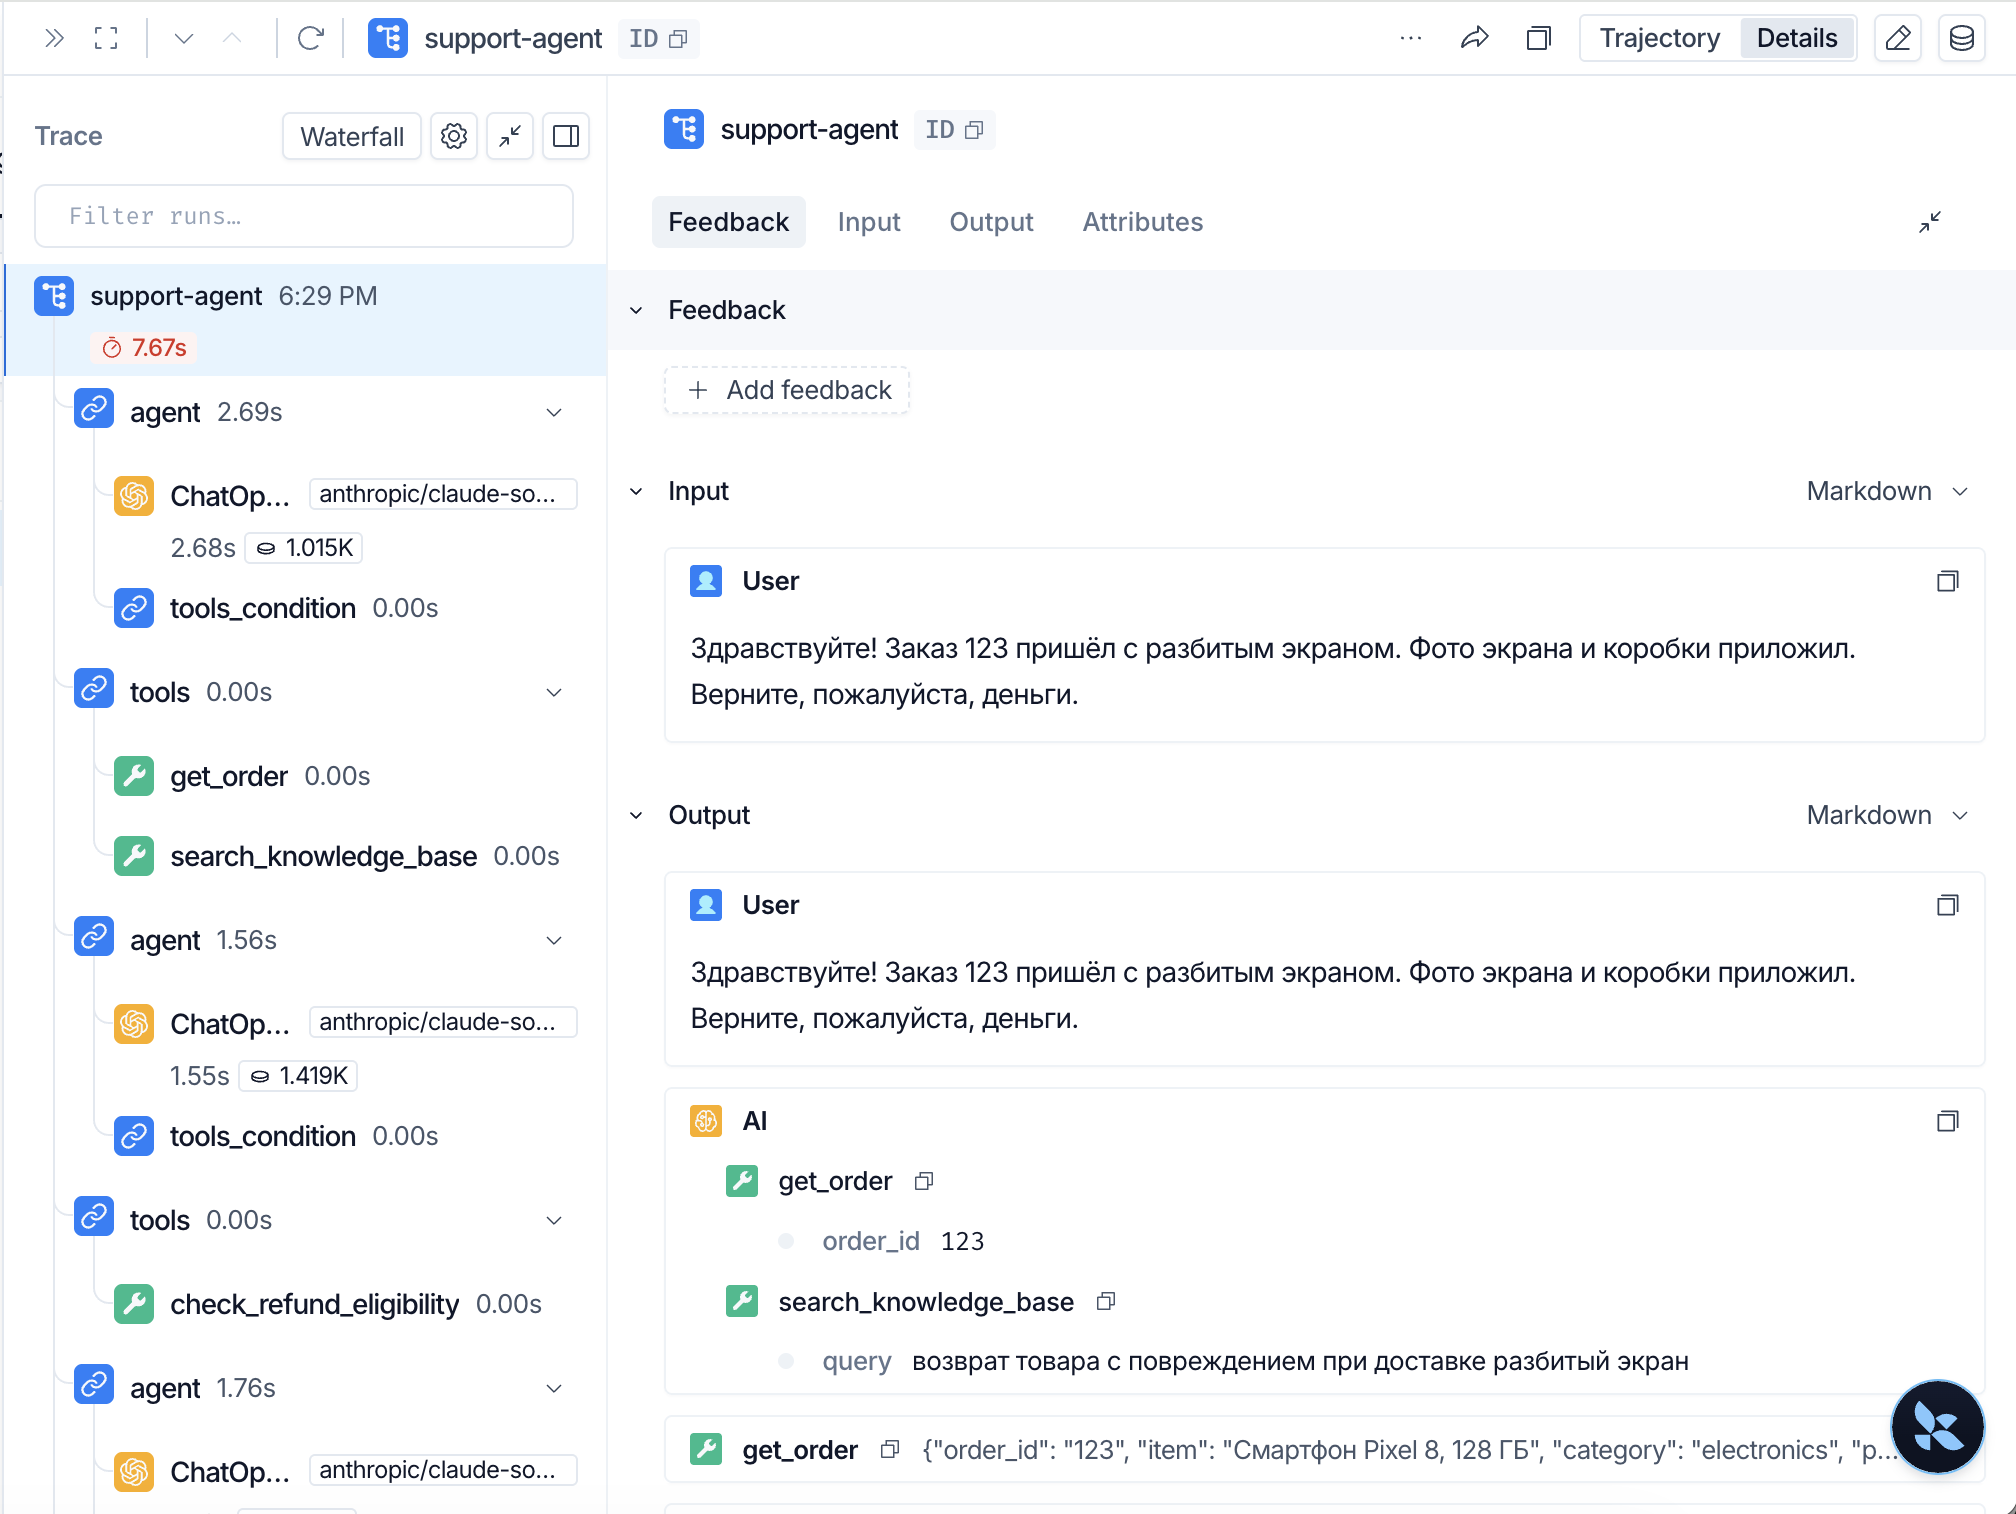
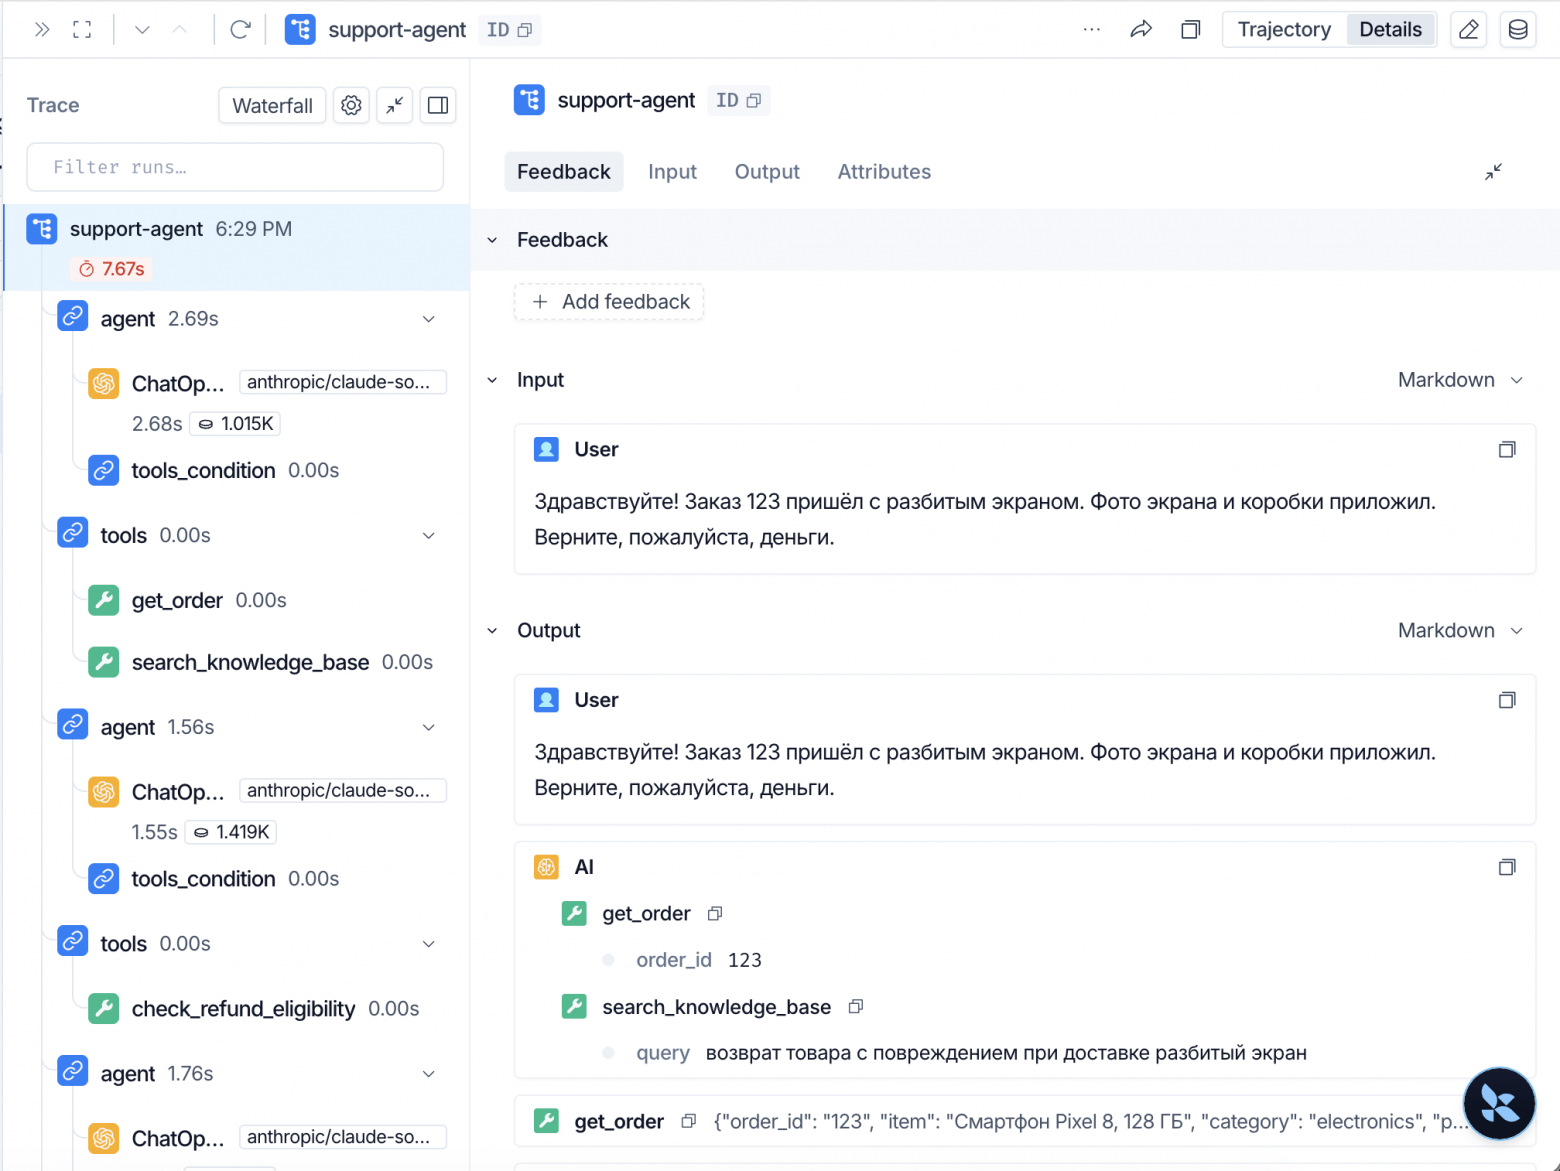
Оценка траектории фиксирует полный лог исполнения: каждый вызов инструмента и каждый промежуточный ответ. Сравнение с эталоном может проводиться в строгом порядке вызовов, без учета порядка, а также в режимах надмножеств и подмножеств. На практике избыточно жесткие проверки могут штрафовать систему за оправданную креативность, поэтому валидируются лишь критически важные ограничения безопасности и прав доступа.
Оценка с помощью LLM-судей и разметка
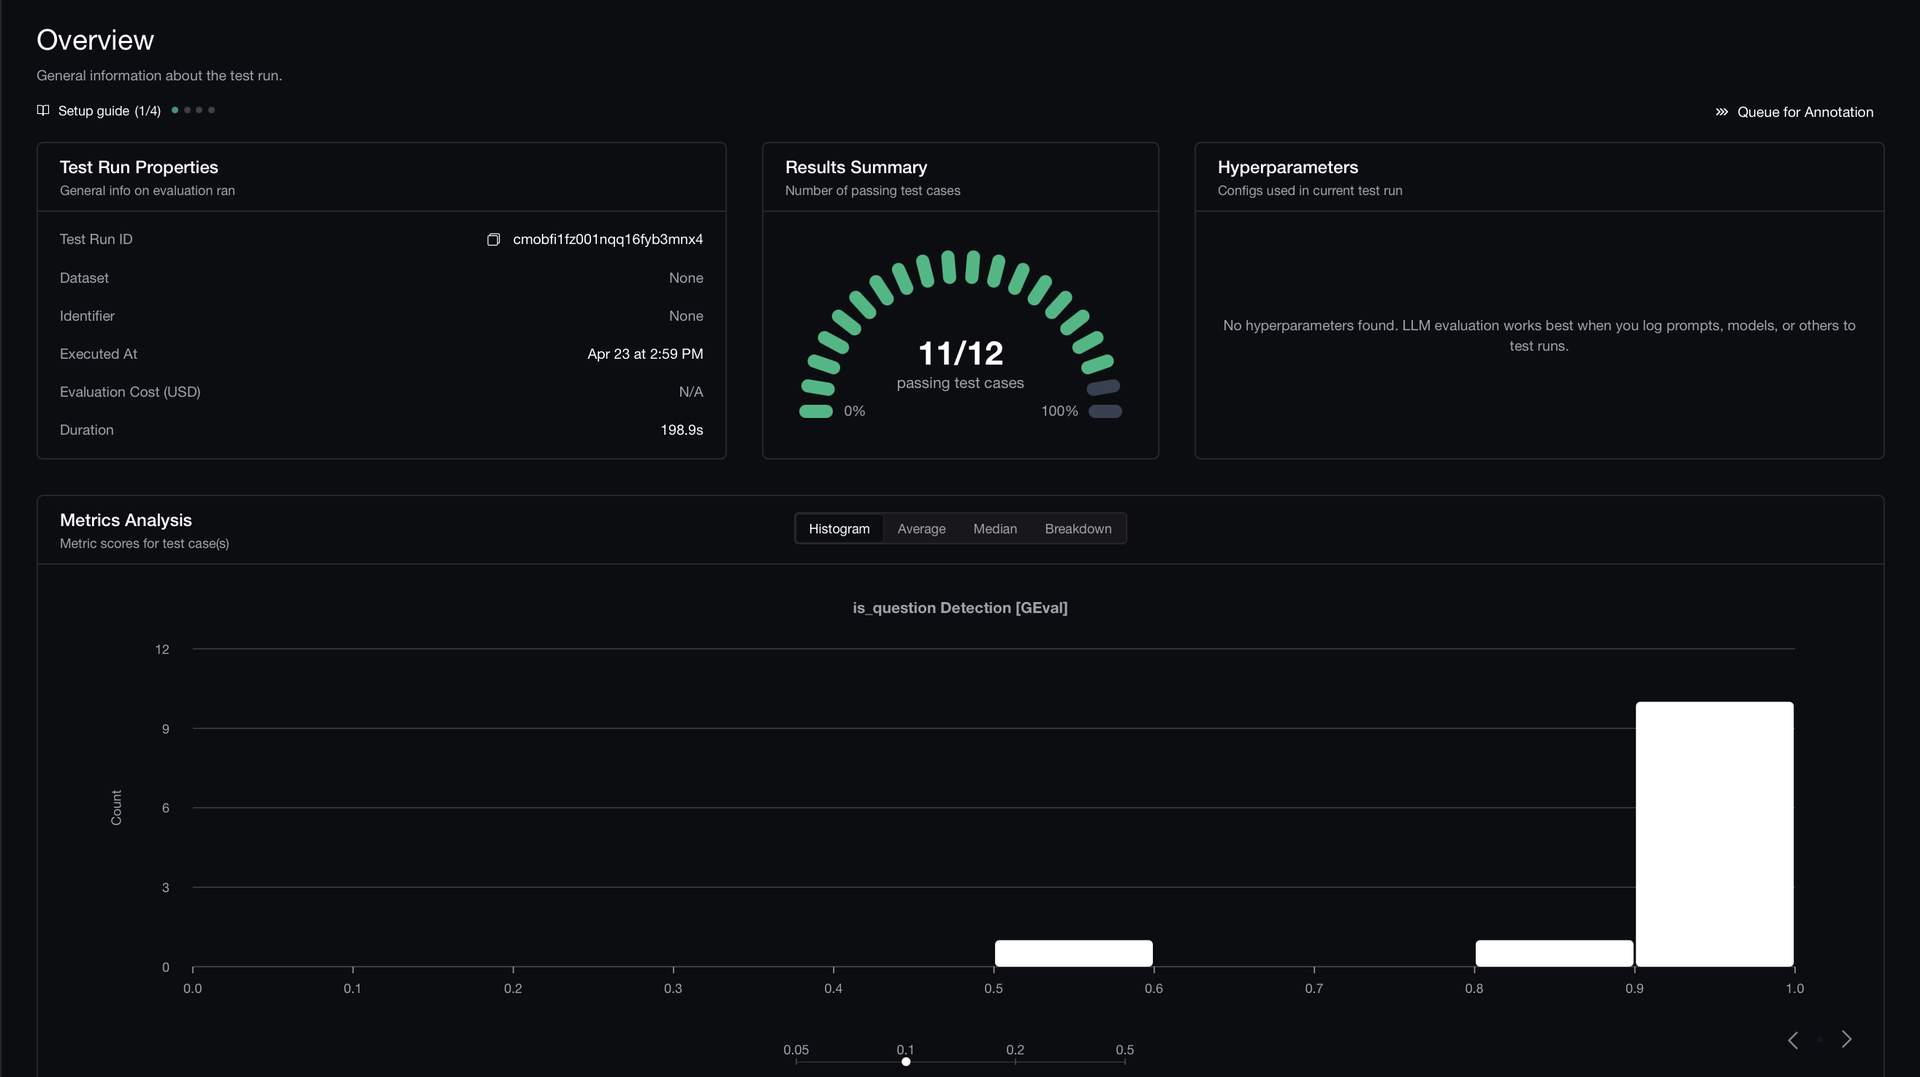
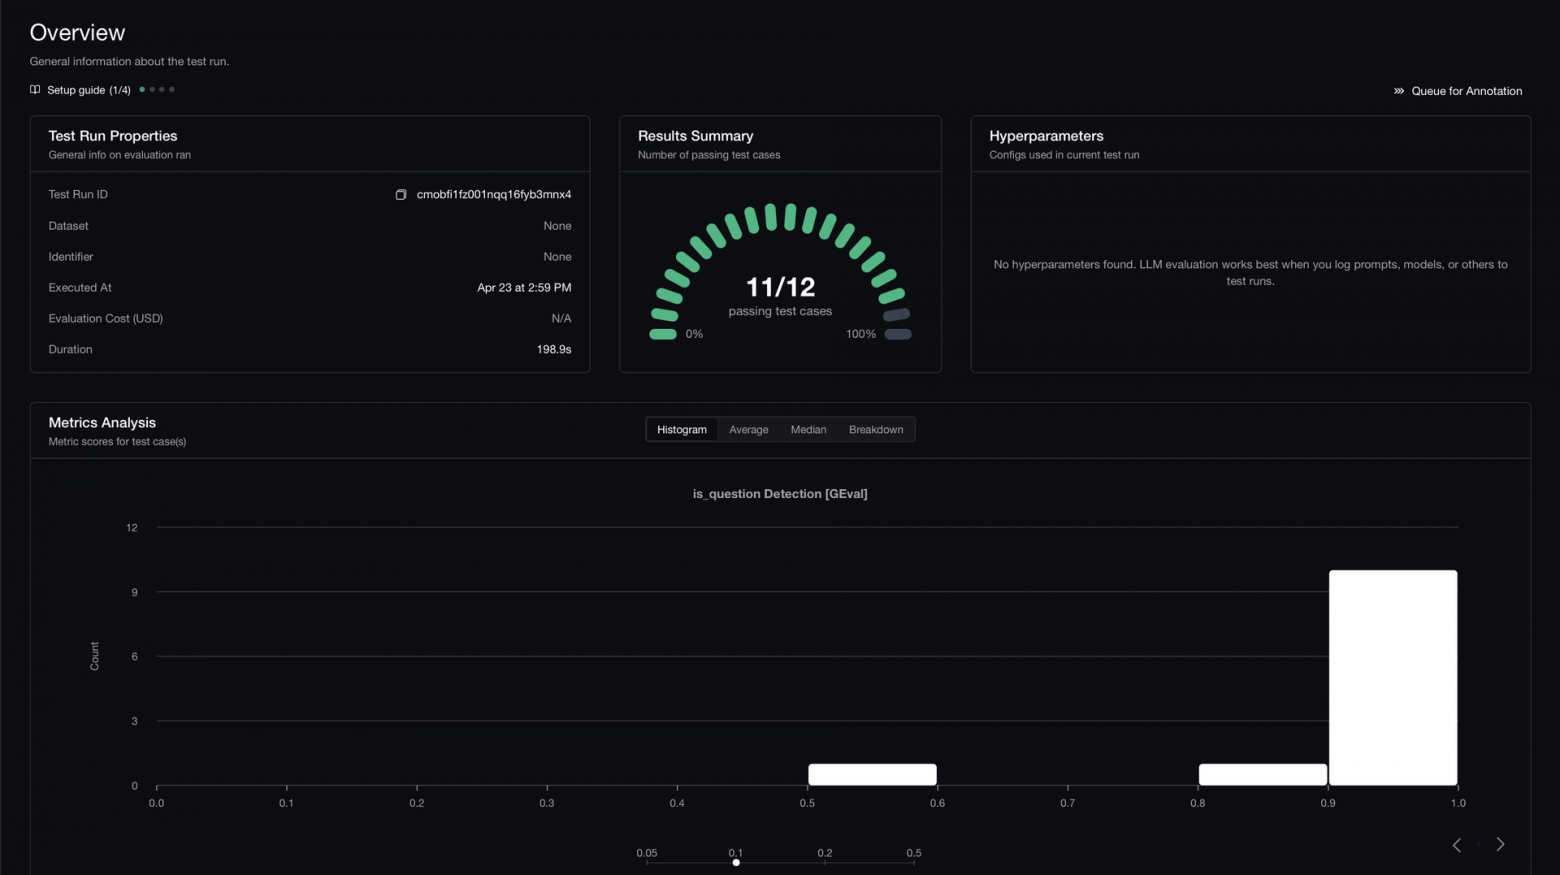
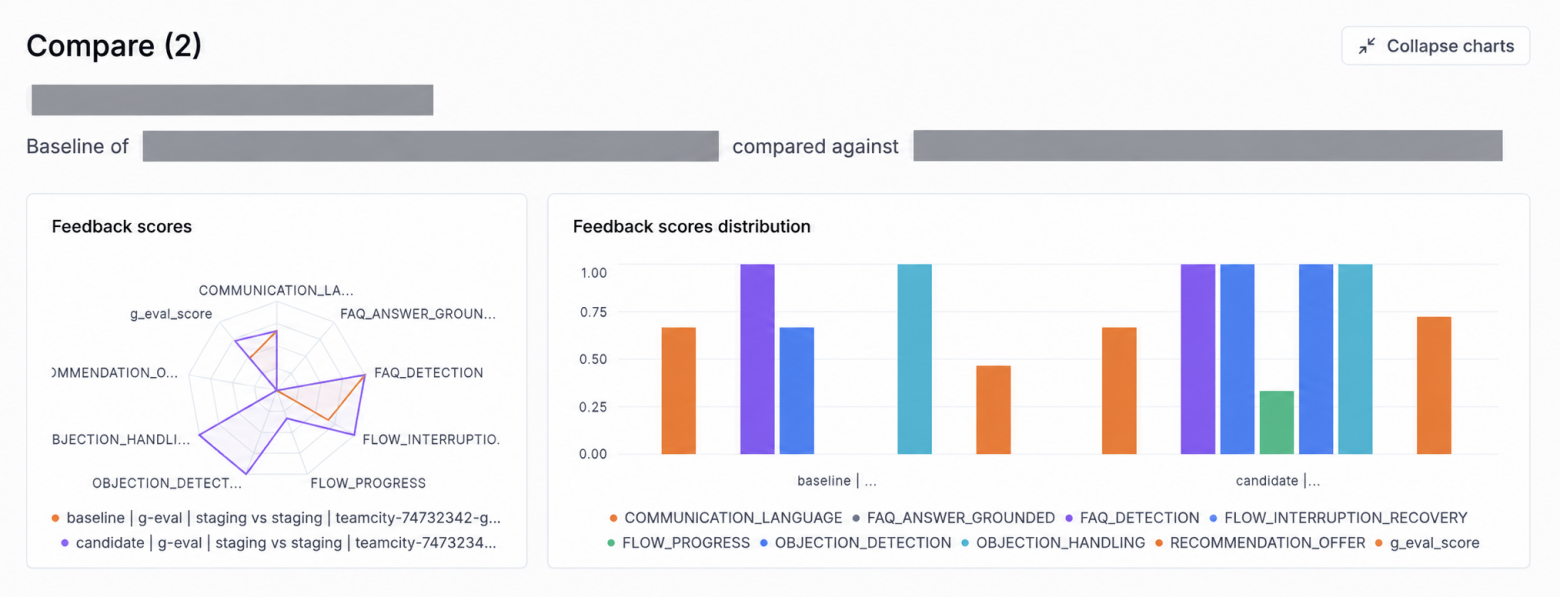
Подход G-Eval подразумевает использование языковой модели в роли арбитра, оценивающего связность ответов, соответствие исходному контексту и соблюдение бизнес-правил. Рекомендуется использовать бинарные шкалы оценивания и проводить тщательную калибровку для предотвращения позиционных искажений или излишней лояльности моделей одного семейства.
Для масштабной разметки привлекаются внешние асессоры через специализированные платформы с внедрением контрольных заданий, экзаменов и перекрестного голосования. На старте проектов аналогичные задачи решает внутренняя команда разработки, формируя базовые критерии качества для будущих релизов.
Автоматизированный пайплайн и продакшн-мониторинг
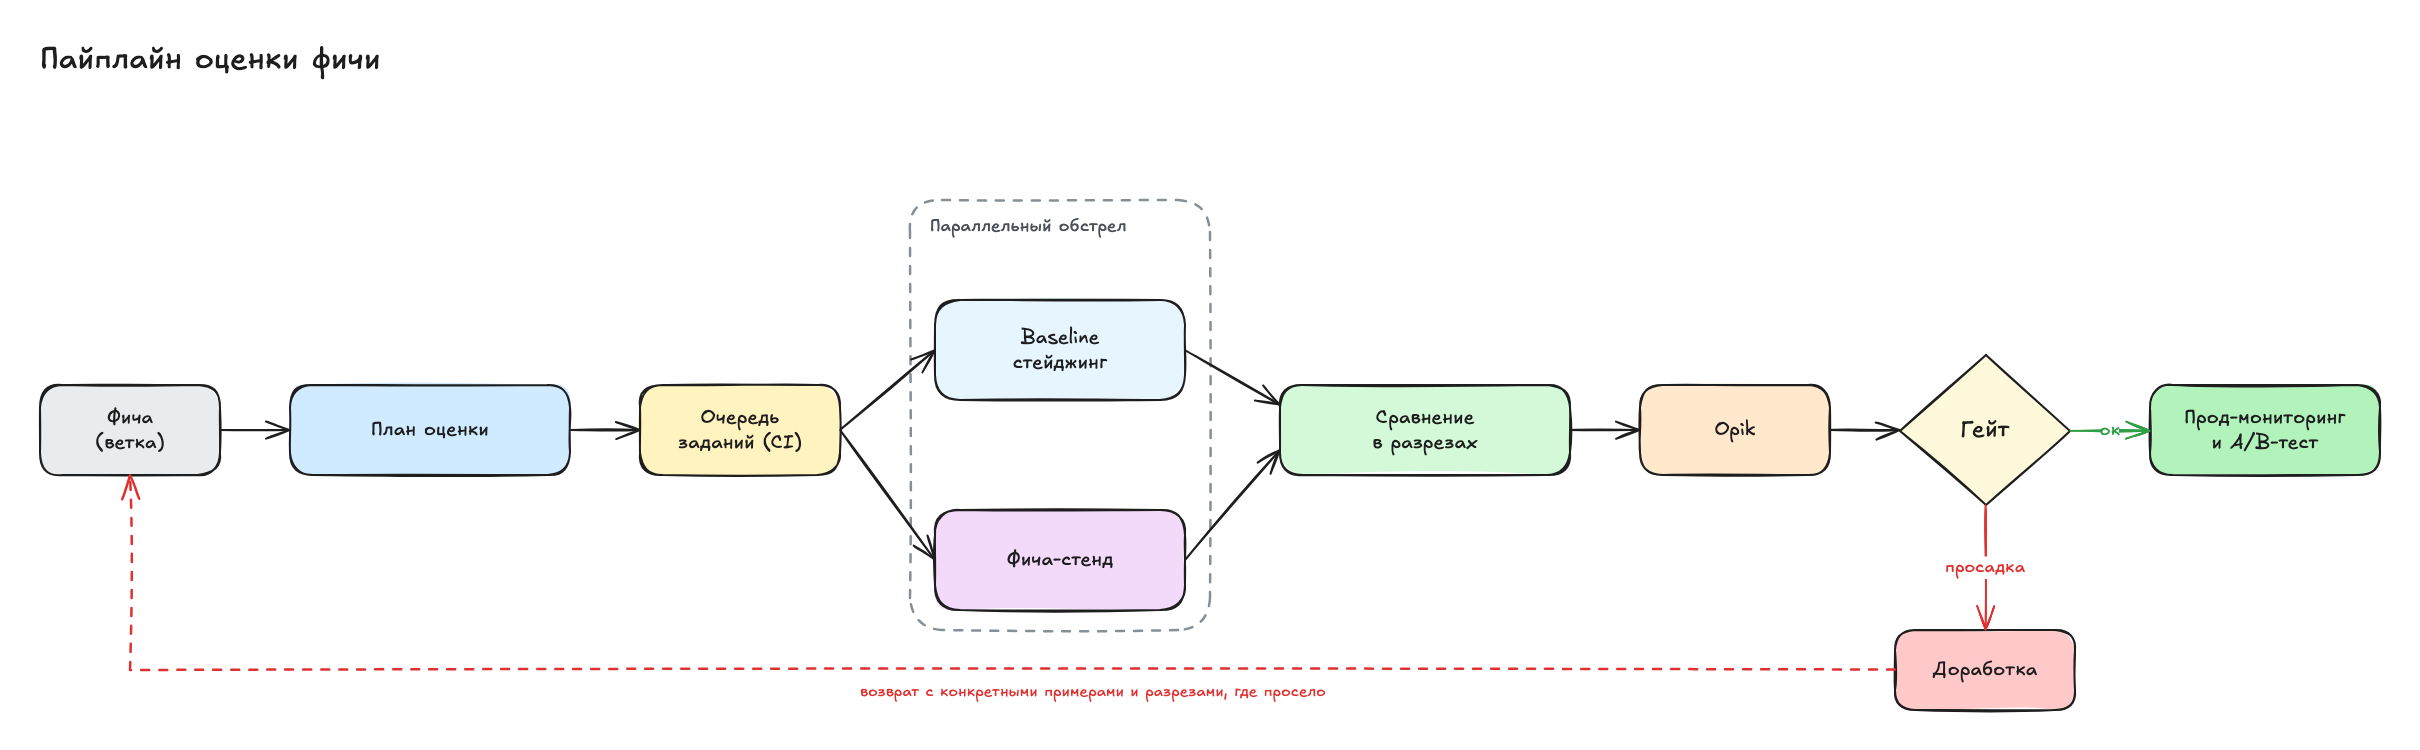
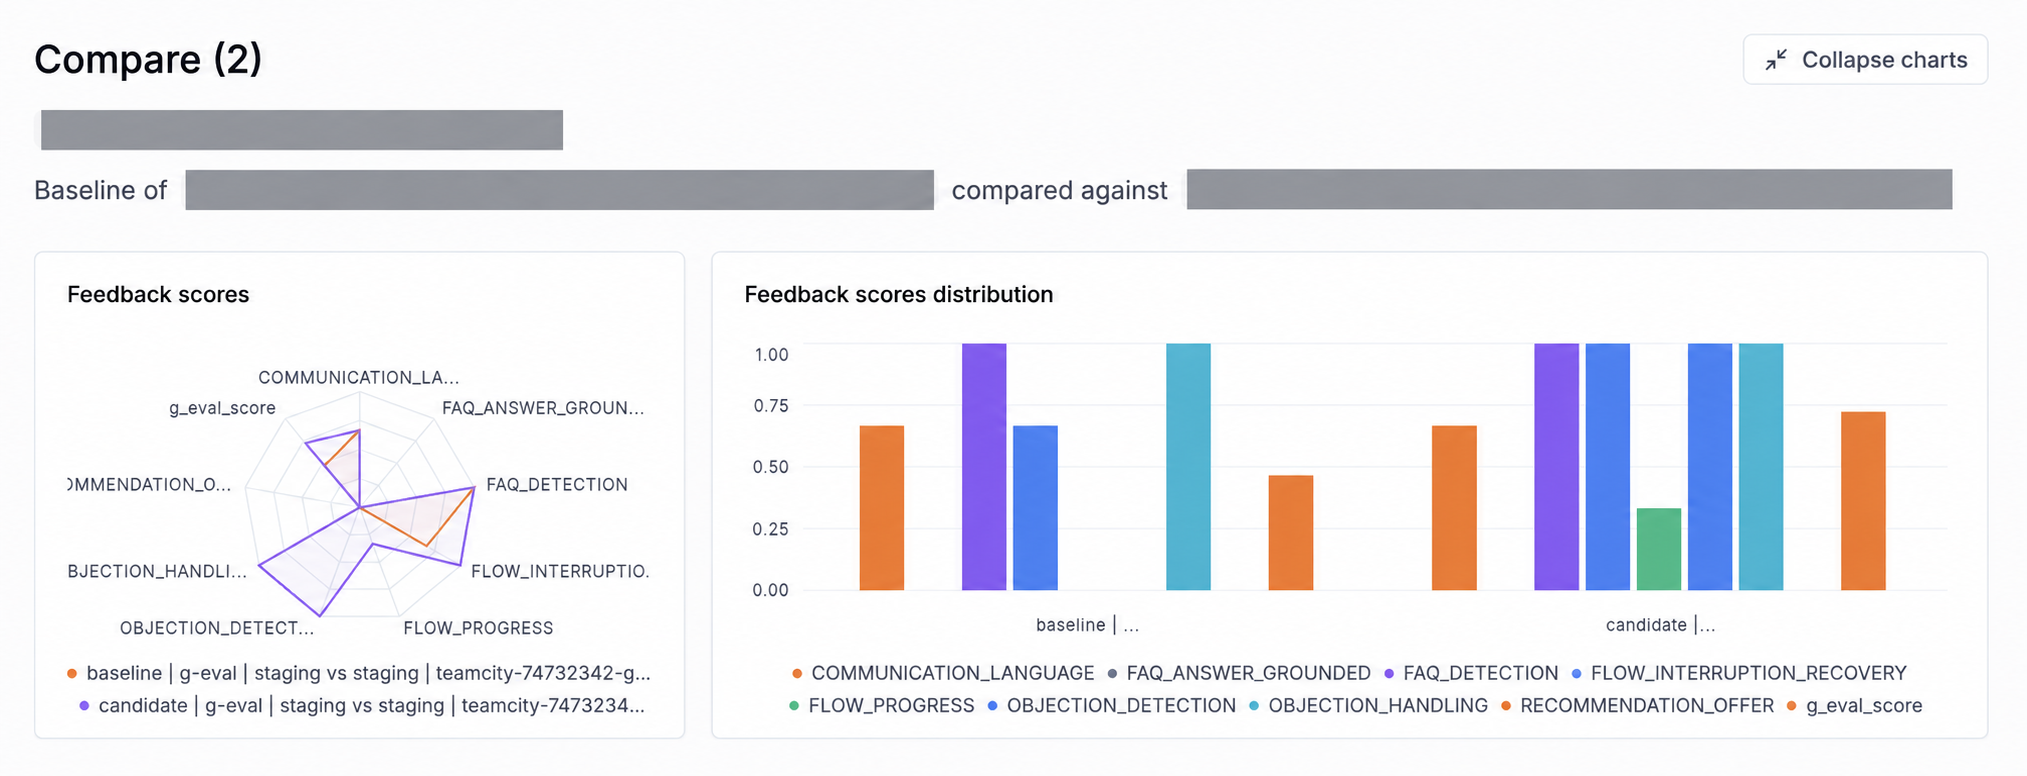
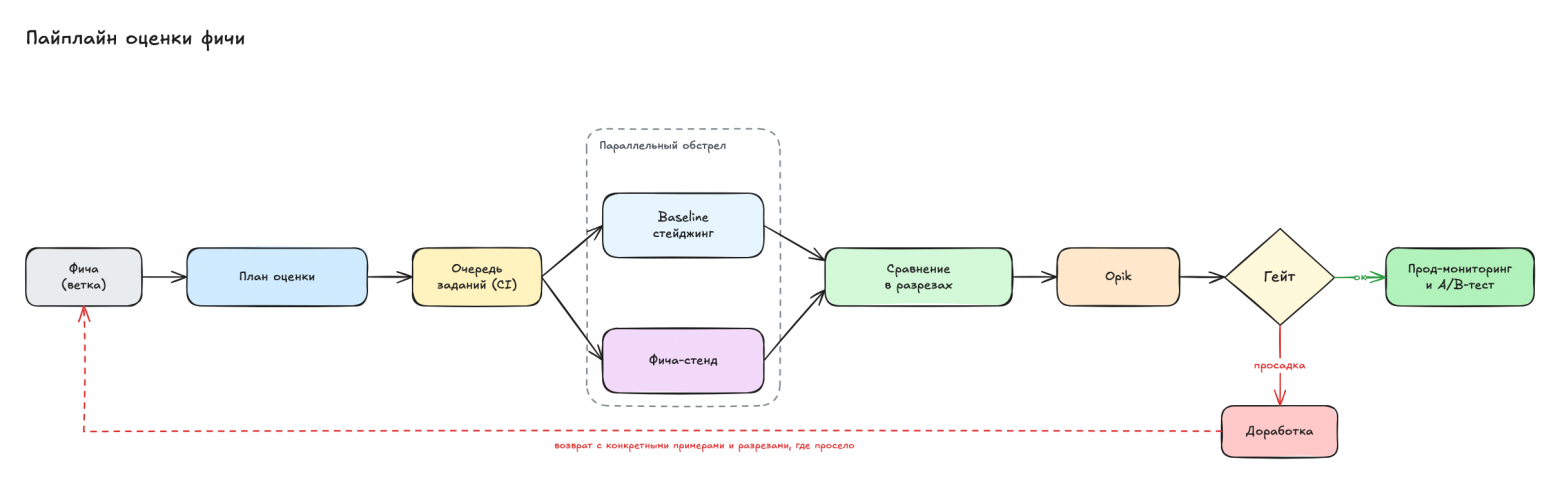
Сборка всех компонентов в единый CI-пайплайн опирается на контрольные точки (гейты), через которые проходит любое изменение. Перед развертыванием в продакшн выполняется параллельное тестирование текущей версии стейджинга и новой ветки на одинаковых наборах данных. Это позволяет нивелировать влияние внешних факторов вроде изменения сторонних API.
На этапе эксплуатации проводится непрерывный мониторинг технических метрик вроде задержки ответа и стоимости токенов, а также поведенческих и продуктовых показателей. Выборочная оценка части диалогов с помощью автоматизированных судей позволяет оперативно отслеживать качество работы системы без ожидания результатов ручной разметки.
