
Мой блог
Переход с Veo 3.1 на Gemini Omni Flash: особенности генерации видео через API

В связи с прекращением поддержки preview-версий Veo 3.1 в Gemini API разработчики и авторы контента вынуждены переносить рабочие сценарии на новые рельсы. Основной альтернативой выступает модель Gemini Omni Flash, которая использует принципиально иной подход к обработке запросов, требует перенастройки скриптов и по-другому справляется с задачами покадровой генерации и ожидания визуального контента.
В данном материале подробно рассмотрен процесс перехода, особенности работы через Interactions API, возникающие технические нюансы, а также проведено сравнение качества и стоимости генерации роликов.
Что поменялось в API
Прежняя линейка Veo функционировала на базе асинхронного метода predictLongRunning, предполагающего отправку задачи, получение операции и её регулярный опрос до завершения процесса. Новая модель задействует Interactions API с отправкой POST-запросов на эндпоинт /v1beta/interactions. Если параметр background установлен в значение false, ответ возвращается непосредственно после окончания генерации видеоматериала.
Для тестовых запусков или небольших скриптов синхронный режим достаточно удобен. Однако для продакшн-окружения документация предлагает использовать фоновый режим background: true, при котором система сразу выдает идентификатор задачи для последующего мониторинга статуса.
Передача изображений и параметры запроса
Текстовые описания, сами графические файлы и их роли теперь передаются в рамках единого массива input. Необходимые роли обозначаются специальными тегами в самом начале промпта, например, через указания вроде FIRST_FRAME, LAST_FRAME или IMAGE_REF с соответствующими индексами элементов массива.
Подобный подход позволяет объединить в рамках одного запроса стартовый кадр, финальный кадр и персонажные референсы, тогда как Veo требовала для этих целей задействовать совершенно разные режимы работы. Ограничением прямого получения файла в ответе через base64 является размер медиафайла до 4 мегабайт. Если сгенерированный ролик превышает данный лимит, в блоке response_format требуется задействовать доставку по URI с последующим опросом через Files API до достижения статуса ACTIVE.
Подводные камни при миграции
Отказ от привычных параметров и переход на новую логику неизбежно сопряжен с рядом архитектурных и практических трудностей, с которыми сталкиваются разработчики при адаптации кода.
Длительность ролика и ограничения формата
В новой модели отсутствует отдельный параметр длительности вроде durationSeconds, который ранее применялся в Veo. Продолжительность видео задается непосредственно внутри текстового промпта (например, указанием «A 4-second video»), после чего нейросеть выдает результат длиной от 3 до 10 секунд. Фактическая длительность может незначительно отличаться, поэтому скриптам требуется дополнительная проверка полученных файлов.
Использование доставки по URI требует обязательного хранения сгенерированных данных на стороне сервиса: документация указывает, что параметр store: true становится обязательным условием при выборе формата video delivery с передачей по ссылке.
Склонность к склейкам и языковой барьер
Без дополнительных инструкций модель склонна разбивать итоговый ролик на несколько самостоятельных планов. Для получения единой непрерывной сцены в промпт необходимо принудительно добавлять директиву об отсутствии монтажных склеек («A single continuous shot, no scene cuts»).
Кроме того, официальная поддержка в полной мере заявлена только для английского языка. Использование русских формулировок допустимо, но снижает предсказуемость результата, поэтому генерацию видео рекомендуется запускать на английском.
Сравнение результатов генерации
Практические тесты показывают неоднозначные результаты при сравнении качества работы старой и новой моделей в различных сценариях.
Переход между двумя кадрами
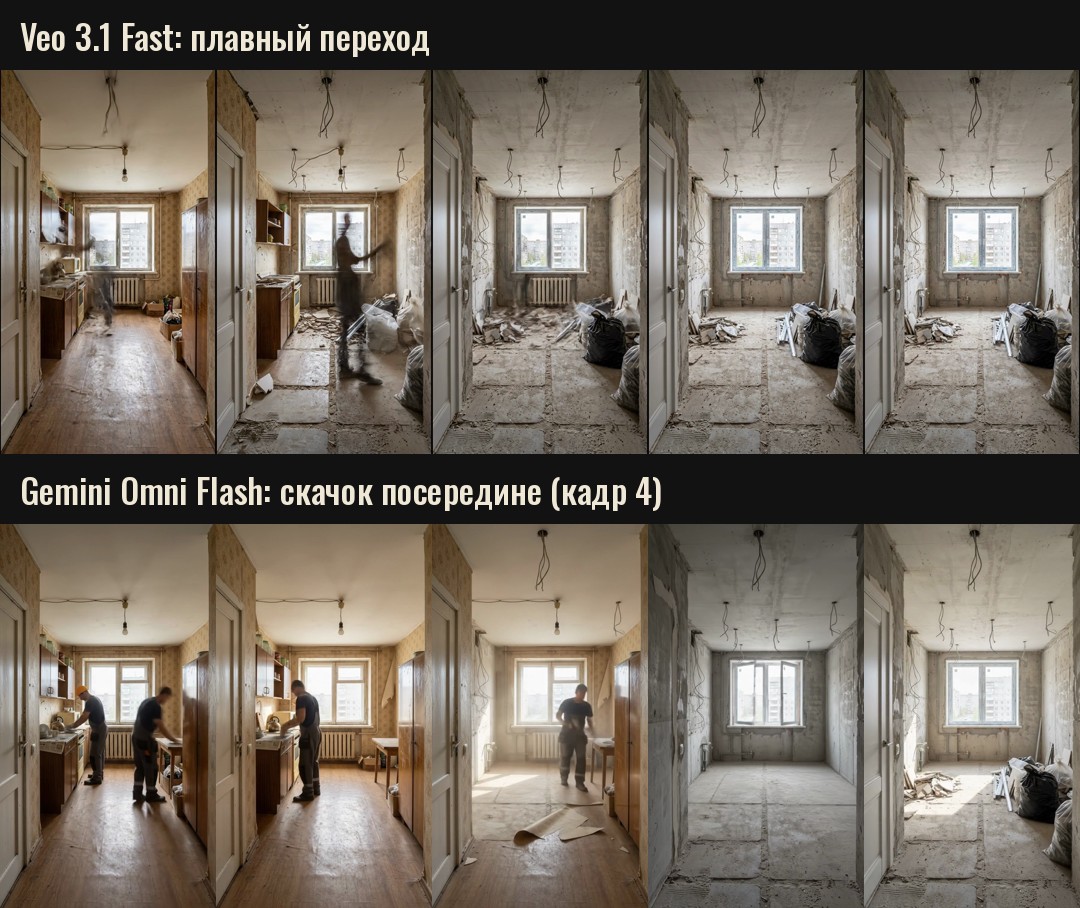
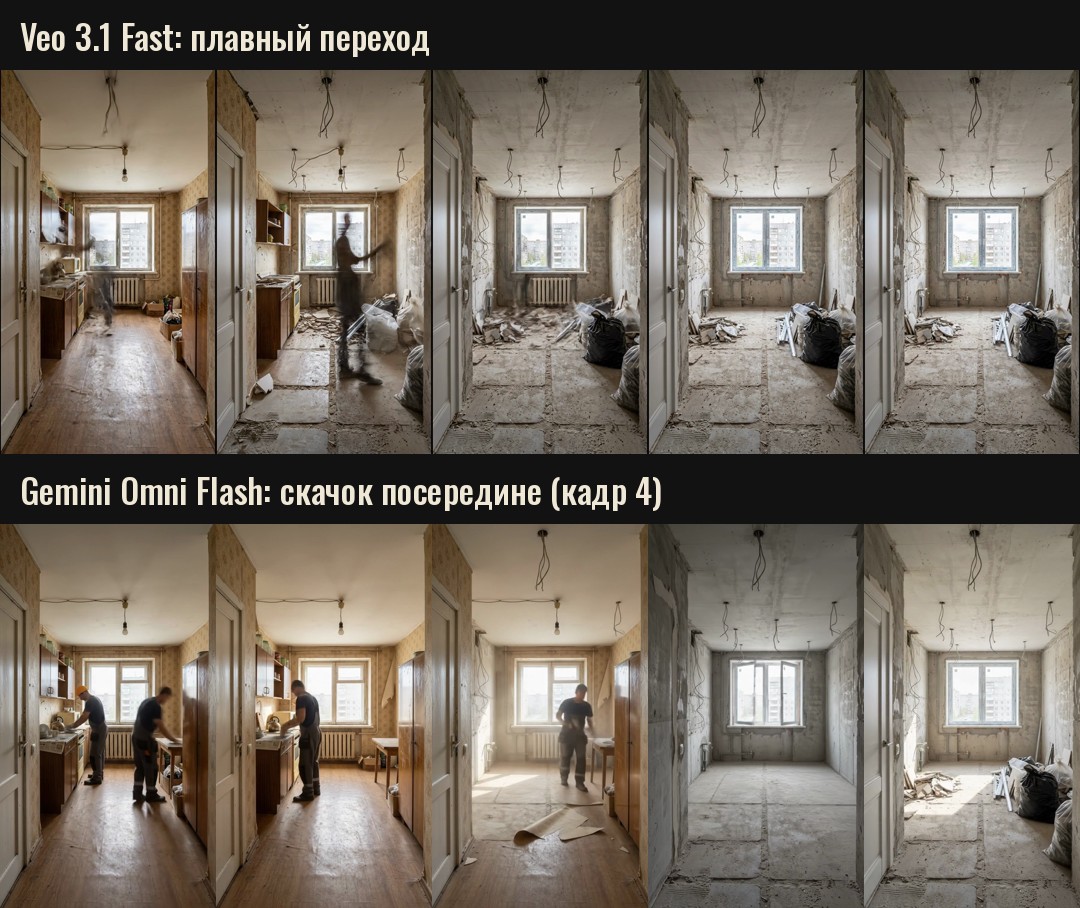
В задачах интерполяции кадров — например, при создании таймлапсов ремонтных работ с использованием начального и конечного состояния помещения — Omni демонстрирует худшие результаты по сравнению с Veo. Вместо постепенного изменения пространства и плавного появления изменений новая модель может резко переключать сцену в промежуточных точках, что делает её менее пригодной для гладких визуальных переходов без дополнительной постобработки.
Оживление изображения и референсы персонажей
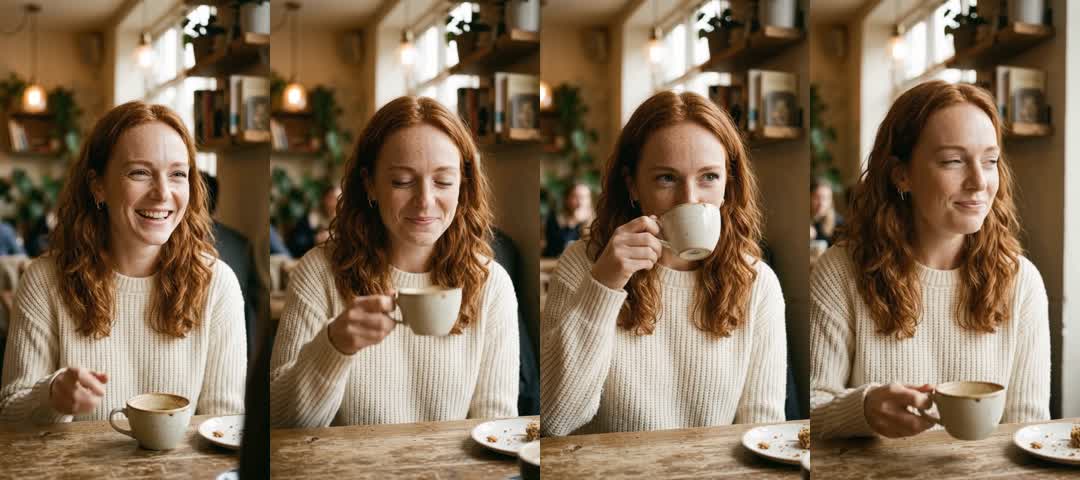
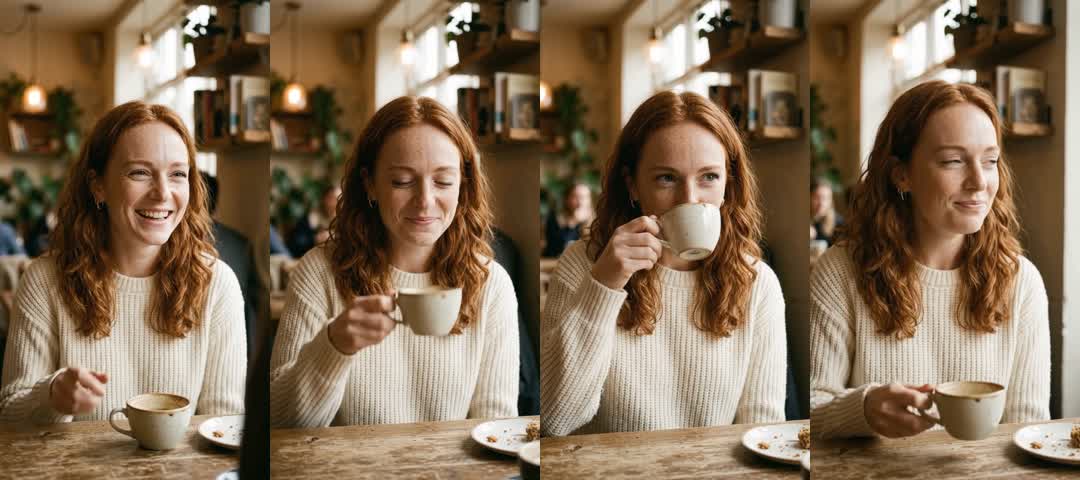
В сценариях «картинка в видео» модель справляется уверенно. Лица героев удерживаются на протяжении всего хронометража без искажений, а чашки, руки и другие мелкие объекты сохраняют целостность. Тестирование работы с несколькими референсами лиц показало, что модель не путает персонажей между собой, хотя точное позиционирование людей в пространстве по текстовому описанию выполняется менее точно.
Расчет стоимости генерации
Тарификация Gemini Omni Flash привязана к объему обрабатываемых токенов. Выходные видеоданные оцениваются по ставке $17,50 за миллион токенов, текстовые токены (включая внутренние рассуждения модели) стоят $9 за миллион, а входные данные тарифицируются по $1,50 за миллион. Секунда видеоматериала в разрешении 720p эквивалентна примерно 5792 токенам.
Итоговая стоимость конкретного клипа складывается из базовой генерации видеоряда, объема входных изображений и текстового промпта, а также затрат на внутренние размышления модели. Рекомендуется фиксировать показатели из поля usage в каждом ответе API для последующего аудита затрат.
Заключение
Перенос генеративных пайплайнов требует предварительного тестирования ключевых сценариев перед полным отключением старых версий API. Сценарии с оживлением статичных изображений и использованием персонажных референсов демонстрируют качество, не уступающее предыдущим решениям, в то время как для сложных переходов между кадрами может потребоваться поиск альтернативных инструментов.
