
Мой блог
Perplexity представила гибридные вычисления для Mac: как локальные модели защищают персональные данные в нейросетях

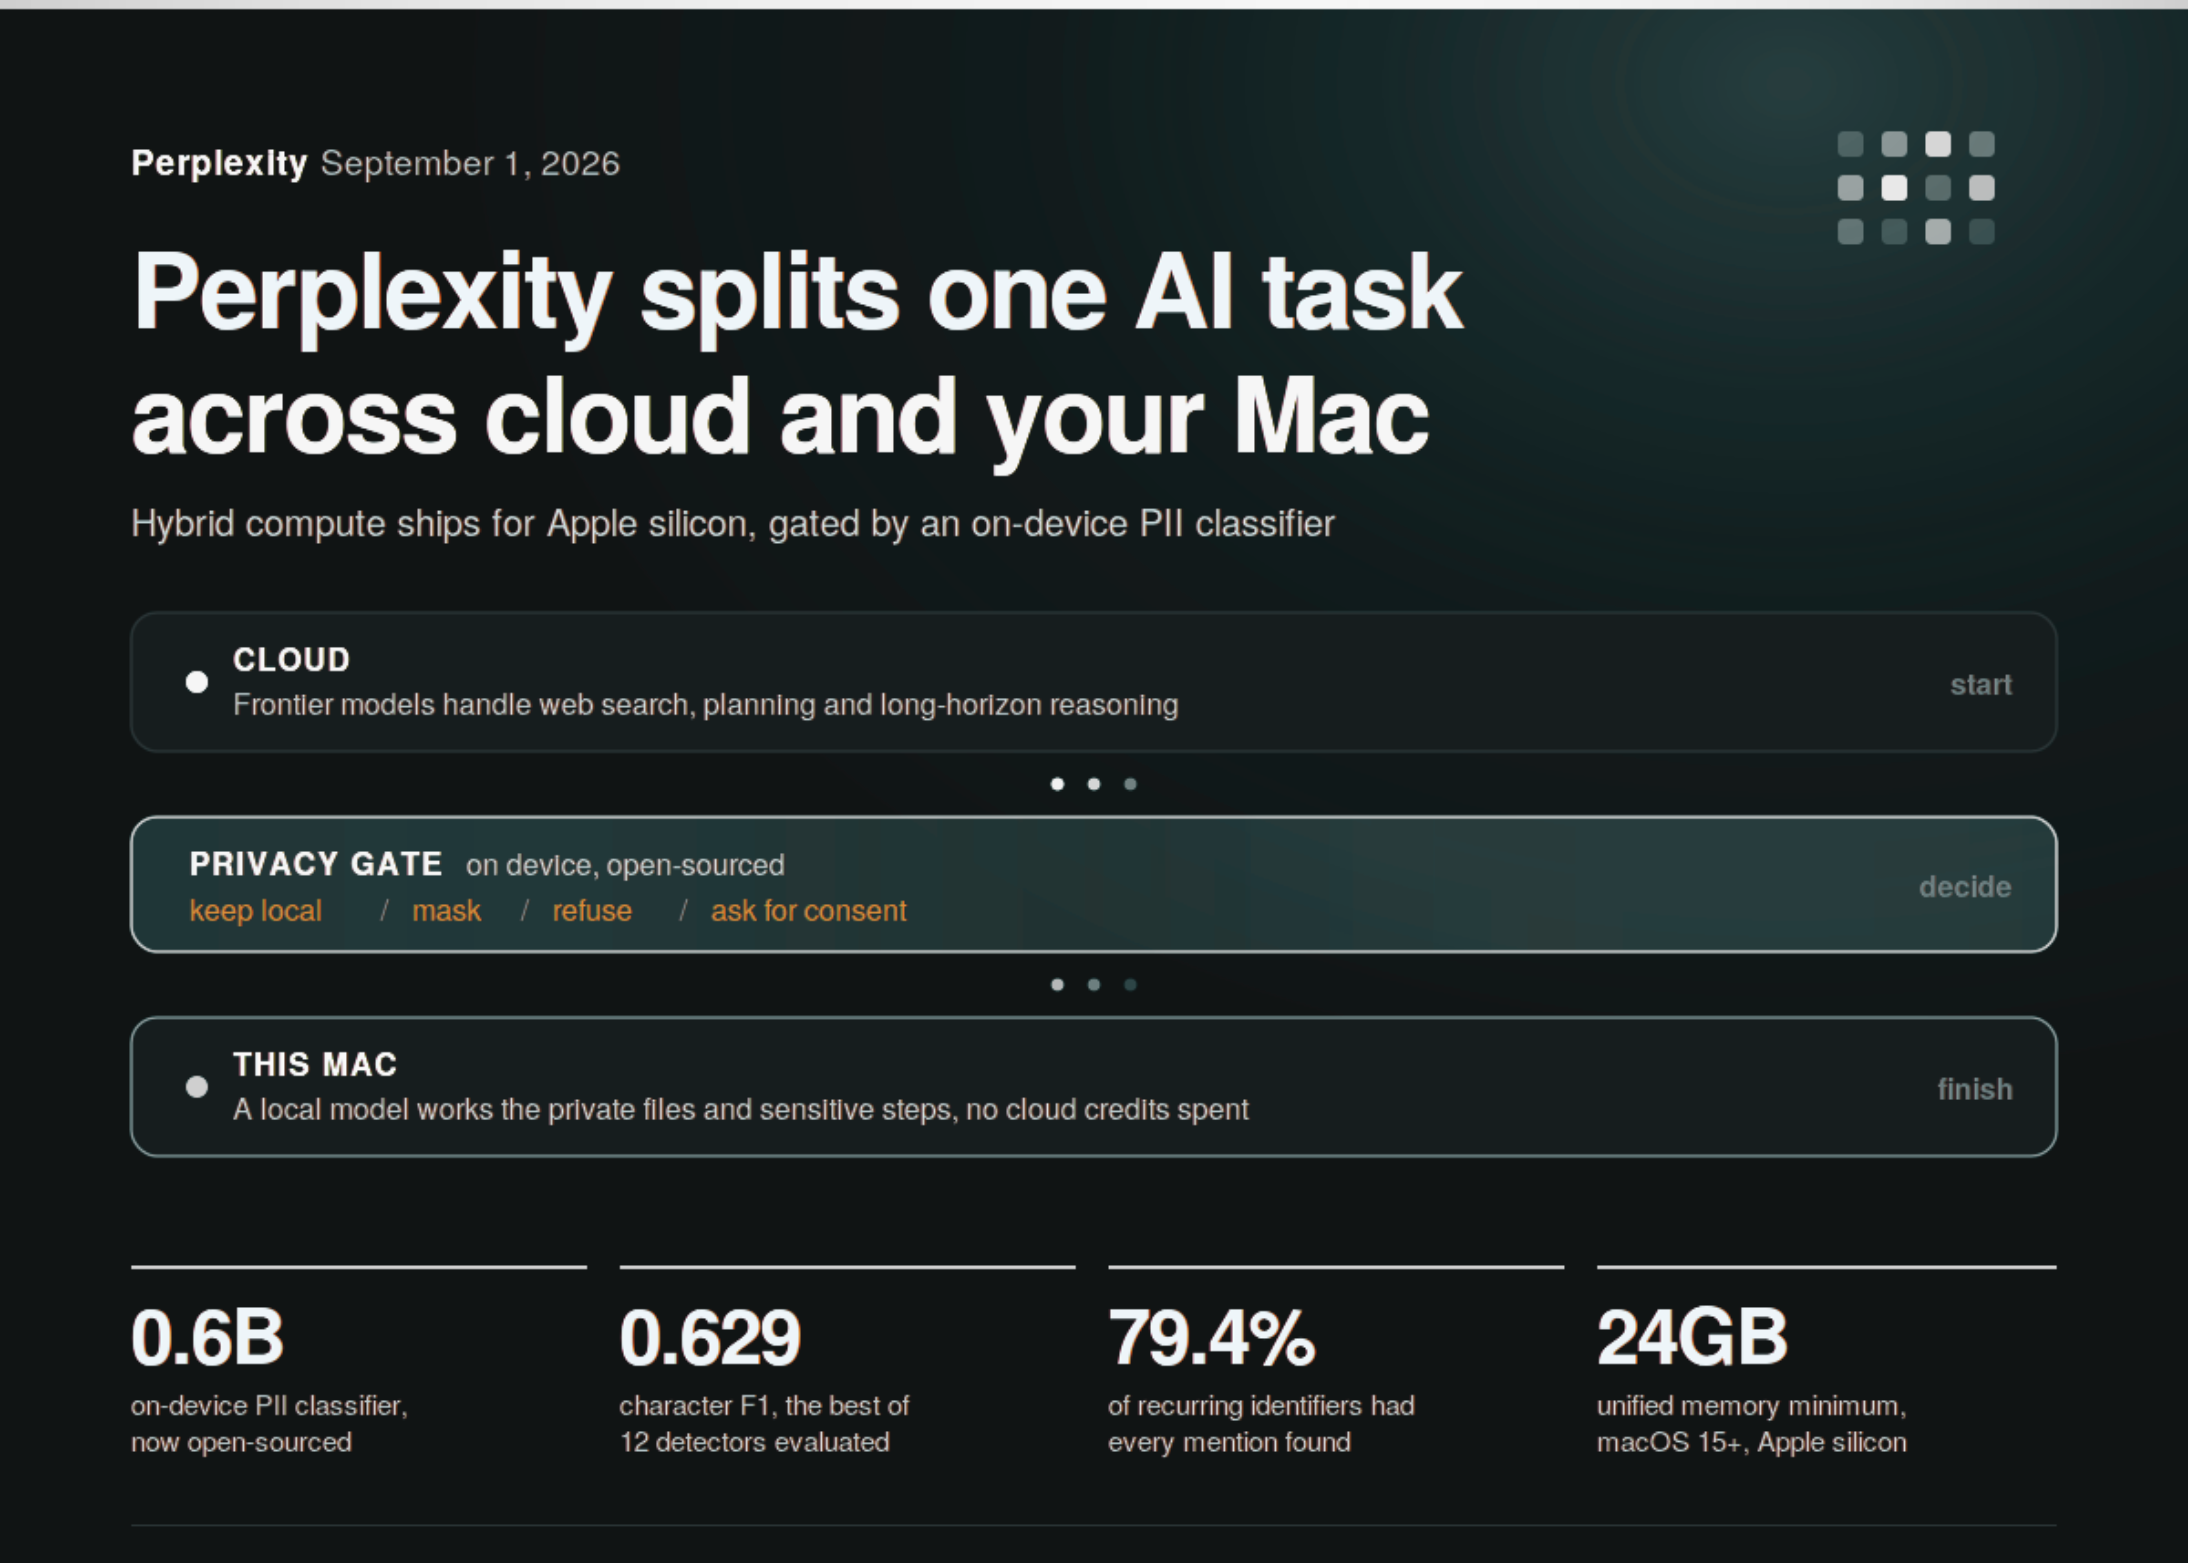
Современные автономные ИИ-агенты сталкиваются со сложной технической и этической дилеммой. С одной стороны, чтобы система приносила максимальную пользу, ей необходим доступ к реальному рабочему контексту: финансовым отчетам, клиентским базам, юридическим договорам и закрытой документации. С другой стороны, отправка столь чувствительных данных на сторонние облачные серверы неприемлема для большинства компаний и частных пользователей. В Perplexity предложили свое решение этой проблемы для экосистемы Apple — архитектуру гибридных вычислений (Hybrid Compute).
Суть концепции заключается в четком разграничении зон ответственности: комплексная задача в рамках инструмента Perplexity Computer делится между мощными флагманскими моделями в облаке и компактной локальной нейросетью, работающей непосредственно на Mac пользователя. За безопасную передачу данных отвечает встроенный локальный шлюз конфиденциальности. Я изучил технические подробности релиза и готов подробно разобрать, как устроена эта система и почему она важна для индустрии.
Функция уже доступна для подписчиков тарифов Pro, Max и Enterprise на компьютерах с чипами Apple Silicon под управлением macOS 15 или новее. Для работы требуется минимум 24 ГБ объединенной памяти (разработчики рекомендуют 32 ГБ). Установка локальной модели происходит буквально в один клик через официальное приложение для Mac: вам не придется разворачивать сторонние контейнеры вроде Ollama, настраивать сторонние среды исполнения или генерировать дополнительные API-ключи. При этом локальная обработка задач не расходует облачные лимиты подписки.
Как устроены гибридные вычисления Perplexity
Ключевая инженерная находка Perplexity заключается в направлении оркестрации процессов. Любая задача в Computer стартует в облаке, где крупные нейросети берут на себя поиск информации в сети, построение сложных планов и длительные логические рассуждения. Однако как только цепочка действий доходит до обработки конфиденциальных файлов или персональной информации, облачный агент перенаправляет этот конкретный шаг локальной модели на Mac.
При этом задача не сбрасывается и контекст выполнения не теряется. После завершения приватного шага на ПК результаты объединяются с общей цепочкой в единый итоговый ответ. Любопытно, что этот подход обратно пропорционален режиму локальных вычислений, который Perplexity анонсировала ранее для систем NVIDIA DGX Spark: там выполнение начинается на локальном железе пользователя и лишь при необходимости поднимается в облако с явного разрешения. В Mac-версии используется тот же оркестратор, но с противоположным сценарием по умолчанию.
Поскольку инструмент Computer интегрирован с экосистемой iOS, пользователю необязательно сидеть за рабочим столом. Можно запустить сложный сценарий с iPhone, находясь в дороге, а все чувствительные этапы будут молча выполнены на настольном Mac. В Perplexity предлагают рассматривать постоянно включенный Mac mini с Apple Silicon как своего рода персональный узловой сервер для локального вывода нейросетей.
Локальный шлюз конфиденциальности — ключевой элемент защиты
Главным барьером на пути утечки данных выступает локальный классификатор. Перед тем как любой фрагмент защищенного документа отправится в облако, специальная модель анализирует текст прямо на устройстве. На основе этого анализа шлюз принимает одно из четырех решений:
- Оставить локально: выполнить обработку полностью на компьютере пользователя без отправки наружу;
- Маскировать: заменить чувствительные фрагменты специальными заглушками перед отправкой в облако и восстановить их обратно при получении ответа;
- Отклонить действие: заблокировать выполнение шага при высоком риске;
- Запросить согласие: спросить подтверждение у пользователя вручную.
Наиболее строгая политика применяется к учетным данным, номерам банковских карт и государственным идентификаторам. В качестве классификатора используется специализированная модель PII-Tracer объемом 0.6B параметров, созданная на базе архитектуры Qwen3. Разработчики заменили причинную маску (causal mask) на двунаправленное внимание с учетом паддинга в окне контекста 4096 токенов. Линейная головка тегирования выдает 37 меток (BIOES-разметка для 9 типов персональных данных плюс нейтральный класс), а вспомогательный модуль оценивает вероятность наличия конфиденциальных сведений во всем диалоге.
Обучение PII-Tracer проходило в течение трех эпох на датасете из 714 000 образцов, а финальная последовательность меток на этапе инференса формируется с помощью алгоритма Витерби. Для валидации работы системы Perplexity представлен бенчмарк PII-TRACE, включающий 13 148 синтетических диалогов на 13 языках с 37 431 упоминанием идентификаторов. Его цель — проверить, способна ли модель находить абсолютно все вхождения персональных данных в длинном контексте, а не просто их большую часть.
В сравнительных тестах среди 12 детекторов PII-Tracer показал наивысший результат по метрике character F1 (0.629) и второй результат по перекрытию спанов, уступив только GPT-5.6-sol. Что касается стабильности распознавания повторяющихся данных, PII-Tracer уверенно лидирует: модель точно определила все упоминания для 79.4% повторяющихся идентификаторов и 77.6% сквозных данных между репликами (у GPT-5.6-sol эти показатели составили 57.0% и 55.1% соответственно). В самом сложном сценарии с 6–10 повторениями PII-Tracer набрал 0.691 балла против 0.464 у GPT-5.6-sol, 0.073 у GLiNER2-PII и 0.045 у Claude Opus 4.8.
Важный нюанс: при анализе единичных окон полнота охвата (recall) у модели падает с 0.975 на коротких текстах (до 1000 символов) до 0.687 на текстах от 10 000 символов. Инженеры Perplexity решили эту проблему без переобучения — за счет декодирования скользящим окном с 50% перекрытием. Это увеличило общий показатель recall с 0.830 до 0.965, а стабильность обнаружения повторяющихся данных выросла с 0.794 до 0.954 на том же чекпоинте.
Доступные модели, администрирование и развертывание
На старте Perplexity заявляет поддержку трех локальных моделей: Gemma 4 E4B, Qwen3.6 35B-A3B и фирменной модели Perplexity, дообученной специально для задач Computer. В мастере настройки приложения предлагается загрузка PPLX Qwen 3.8 27B в один клик. В официальном репозитории компании на Hugging Face представлены сборки pplx-computer-qwen-3-8-27b, а также фильтр pplx-pii-masking-vllm на 0.6B параметров.
Для корпоративных клиентов в тарифе Enterprise предусмотрены гибкие централизованные настройки. Системные администраторы могут жестко задавать правила: какие категории данных обязаны обрабатываться только локально, что подлежит маскированию, а для чего требуется прямое согласие сотрудника. Дополнительно ведутся подробные аудиторские логи всех случаев, когда информация покидает рабочую станцию. Именно этот функционал делает гибридные вычисления применимыми в юриспруденции, медицине и финансовом секторе.
Главные выводы
- Гибридная оркестрация: сложные этапы поиска и планирования выполняет облако, а работу с приватными файлами перехватывает локальная модель на Mac.
- Умный фильтр данных: за безопасность отвечает встроенная 0.6B модель PII-Tracer, принимающая решение о маскировании, блокировке или локальной обработке.
- Высокая точность PII-Tracer: модель превосходит крупные нейросети по полноте обнаружения повторяющихся приватных записей в длинном контексте.
- Скользящее окно декодирования: применение 50% перекрытия окон подняло полноту распознавания персональных данных с 0.830 до 0.965.
- Требования к железу: поддерживаются Mac с чипами Apple Silicon, macOS 15+, от 24 ГБ объединенной памяти (рекомендовано 32 ГБ).
Источник: www.marktechpost.com
