Мой блог
Persistent Planar Memory: как генеративные модели видео обретают память о прошлом

Современные генеративные модели видео сталкиваются с серьезной проблемой сохранения визуальной целостности объектов и локаций при перемещении камеры. Исследователи из Университета Цинхуа представили новый подход под названием Persistent Planar Memory для решения этой задачи, позволяющий моделям удерживать в памяти уже созданные элементы виртуального мира без избыточной нагрузки на вычислительные ресурсы.
Трудности с сохранением постоянства пространства в генеративных видеосистемах обусловлены тем, что алгоритмы непрерывно генерируют новые кадры «на лету». Из-за узкого контекстного окна модель не способна удерживать в памяти удаленные детали, поэтому возвращение в ранее пройденную локацию часто приводит к исчезновению дверей, стен или изменению обстановки. В отличие от традиционных трехмерных сред в компьютерной графике с фиксированными текстурами и геометрией, виртуальные миры нейросетей напоминают вероятностный сон. Подобно людям с антероградной амнезией, такие модели обладают глубоким пониманием различных доменов, но не могут фиксировать новые события и места в долговременной памяти.
Эволюция подходов к пространственной памяти нейросетей
Ранее исследователи применяли различные методы для преодоления этих ограничений. В частности, концепция «банков памяти» сжатых визуальных токенов позволяет персонажам возвращаться в кадр в прежнем виде. Другие системы, включая разработки NVIDIA (Gen3C), а также проекты VMEM и SPMem, используют подходы на основе трехмерных облаков точек. Они фиксируют геометрию сцены в виде наборов точек, помогая поддерживать консистентность при возвращении камеры в ранее исследованные зоны.
Тем не менее, работа с плотной трехмерной геометрией требует больших вычислительных затрат при инференсе. Постоянное построение сложных структур на лету усложняет масштабирование и создает дополнительные узкие места в производительности систем генерации видео.
Особенности технологии Persistent Planar Memory
Новая методика заменяет объемную 3D-память на компактную коллекцию плоских поверхностей. Вместо хранения миллионов точечных координат алгоритм выделяет крупные плоскости стен, полов и мебели, сохраняя их в виде геометрических плоскостных примитивов. Эти элементы непрерывно добавляются в локальное хранилище по мере расширения виртуального пространства.
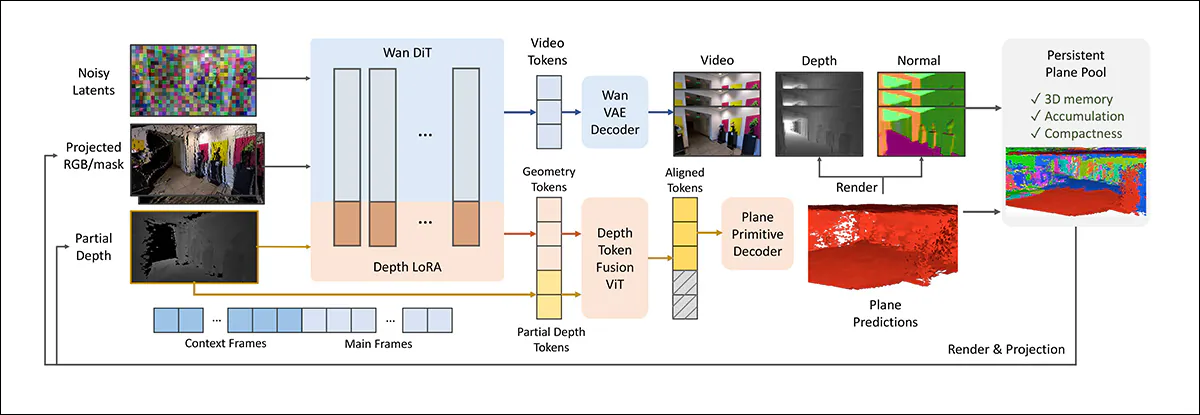
Каждый такой примитив описывается всего семью числовыми параметрами: глубиной центра, двумя прямоугольными размерами и кватернионом вращения. Такой подход в тысячи раз компактнее попиксельного представления или плотных облаков точек. Когда камера возвращается к ранее посещенной точке, сохраненные плоскости проецируются в поле зрения, направляя генерацию новых кадров и предотвращая исчезновение знакомых объектов.
Архитектура и обучение модели
Система базируется на пятимиллиардной диффузионной модели Wan2.2-TI2V-5B, дополненной системой предсказания геометрии на базе Plana3R. Базовый видеокаркас остался замороженным, а компоненты геометрии обучались отдельно. Для тренировки использовалось более 80 000 клипов из датасетов DL3DV и RealEstate10K в разрешении 576×1024 пикселей.
Оценка глубины выполнялась с помощью алгоритмов MoGe-2 и VGGT. Для интеграции геометрии применялась адаптация низкого ранга (LoRA). В процессе инференса генерация видео и извлечение геометрических данных происходят последовательно, а визуальный трансформер на базе DINOv2-Base помогает прогнозировать новые поверхности на основе имеющихся данных глубины.
Результаты тестирования и производительность
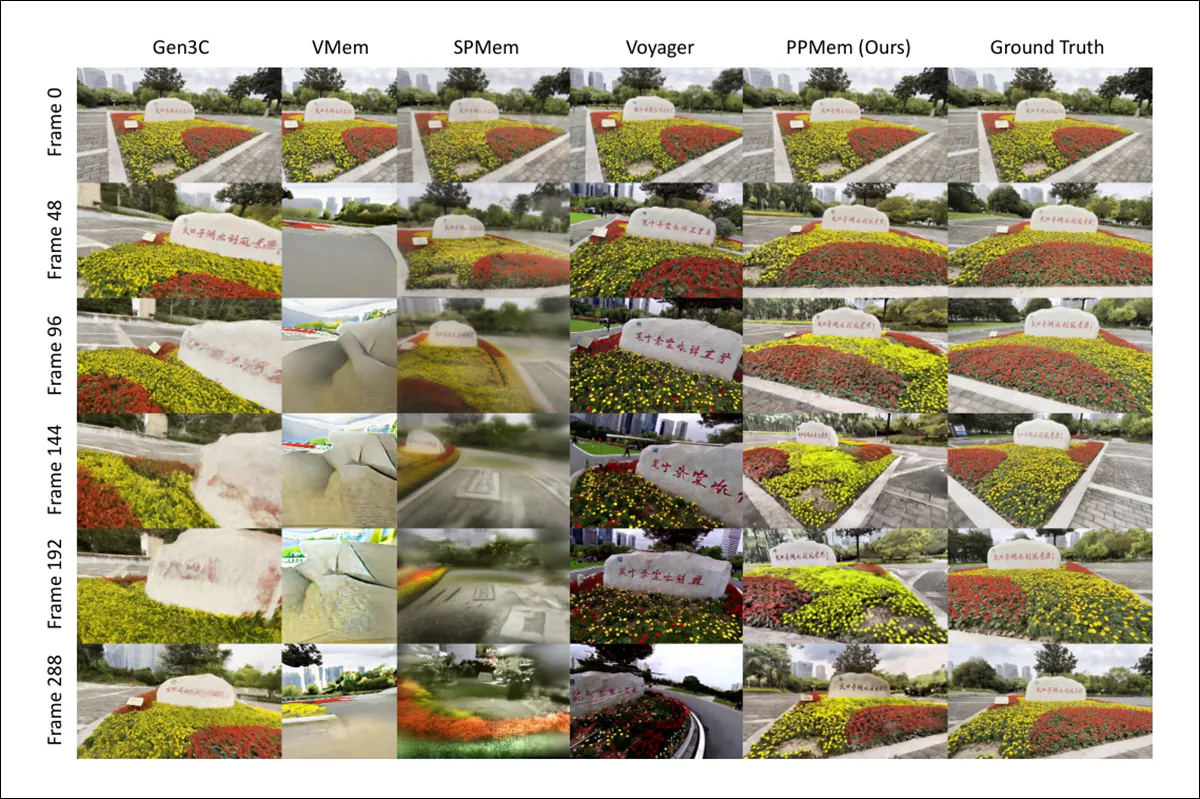
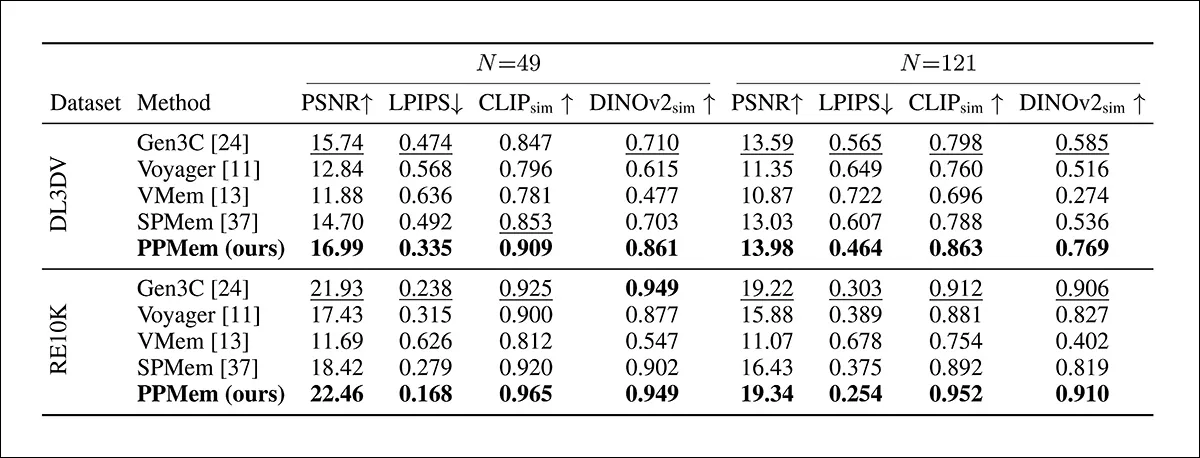
В ходе сравнительных тестов новая архитектура сопоставлялась с моделями Gen3C, Voyager, VMEM и SPMem. Оценка проводилась по метрикам PSNR, LPIPS, сходству CLIP и DINOv2 на последовательностях из 49 и 121 кадра. Разработчики зафиксировали преимущество системы по всем ключевым показателям качества видео на датасетах DL3DV и RealEstate10K.
Качественные тесты на длинных траекториях из 300–400 кадров показали способность метода удерживать структуру окружения без нарастающих искажений. После прохождения сцены из 400 кадров пространство может быть представлено примерно 100 000 примитивов плоскостей, занимающими около 5 МБ памяти, что открывает новые пути для оптимизации генеративных виртуальных миров.