
Мой блог
Как проверка диалогового агента выявила скрытые ошибки в бенчмарках

Высокие баллы бенчмарков не всегда гарантируют корректную работу искусственного интеллекта. В ходе разработки экспериментальной системы автоматизации автор столкнулся с парадоксом, когда заглушка без единого вызова инструментов продемонстрировала высокую результативность.
Для понимания реального поведения ИИ потребовалось провести детальный анализ действий, сопоставить трассы диалогов и протестировать модель в различных управляющих циклах.
Считаю действия рядом с итоговой наградой
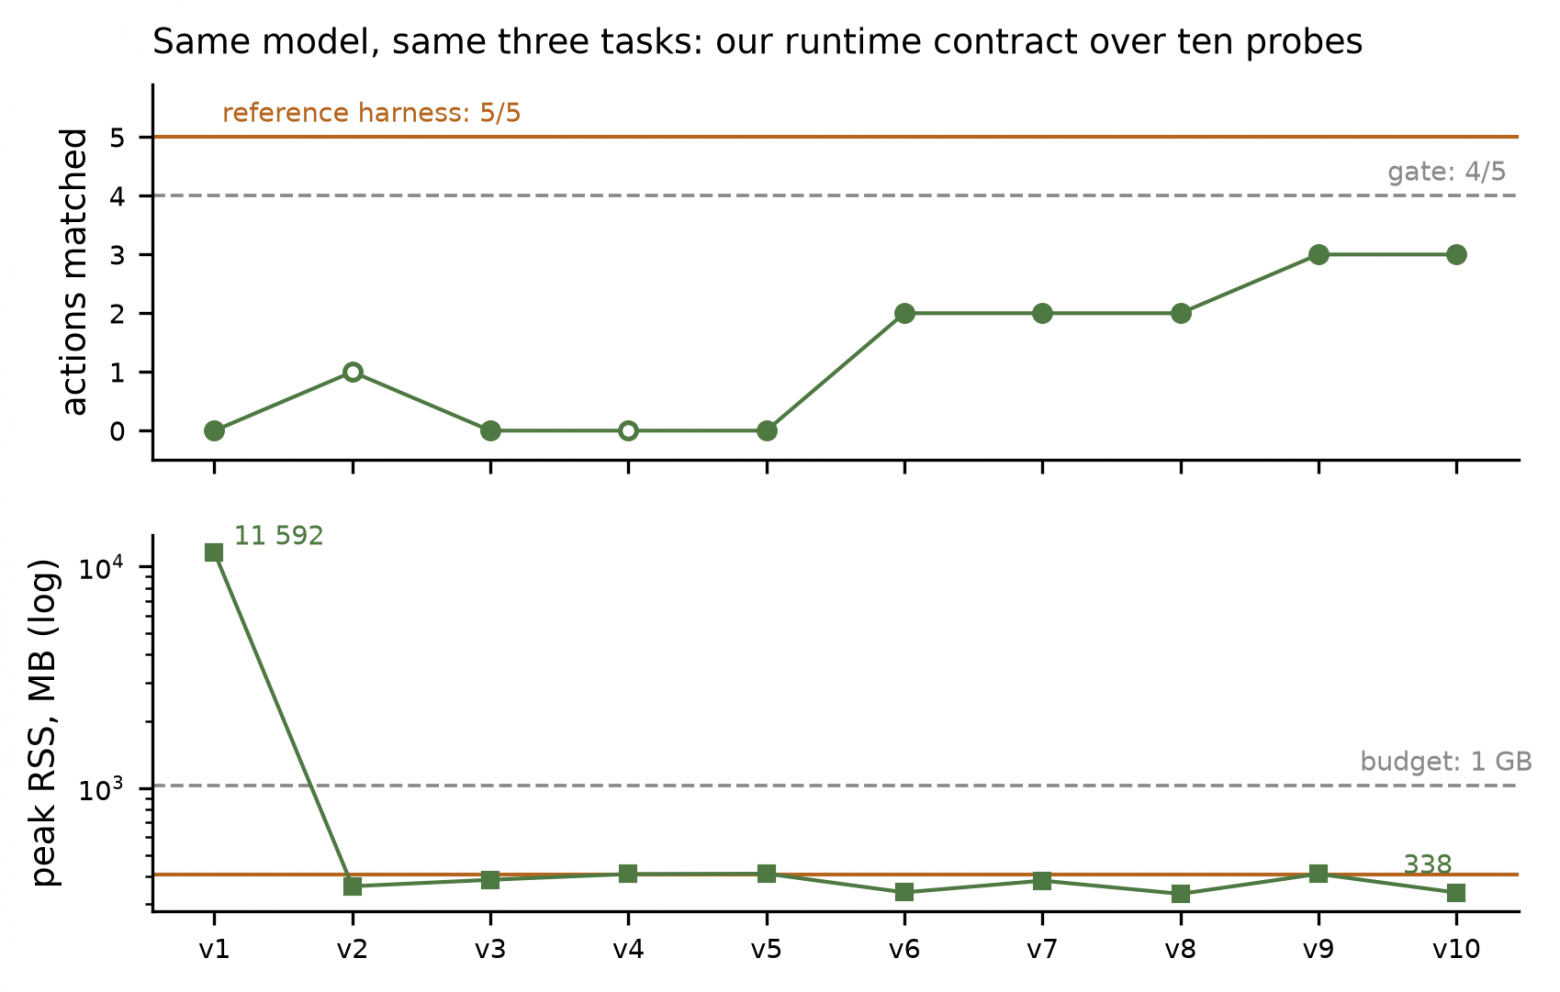
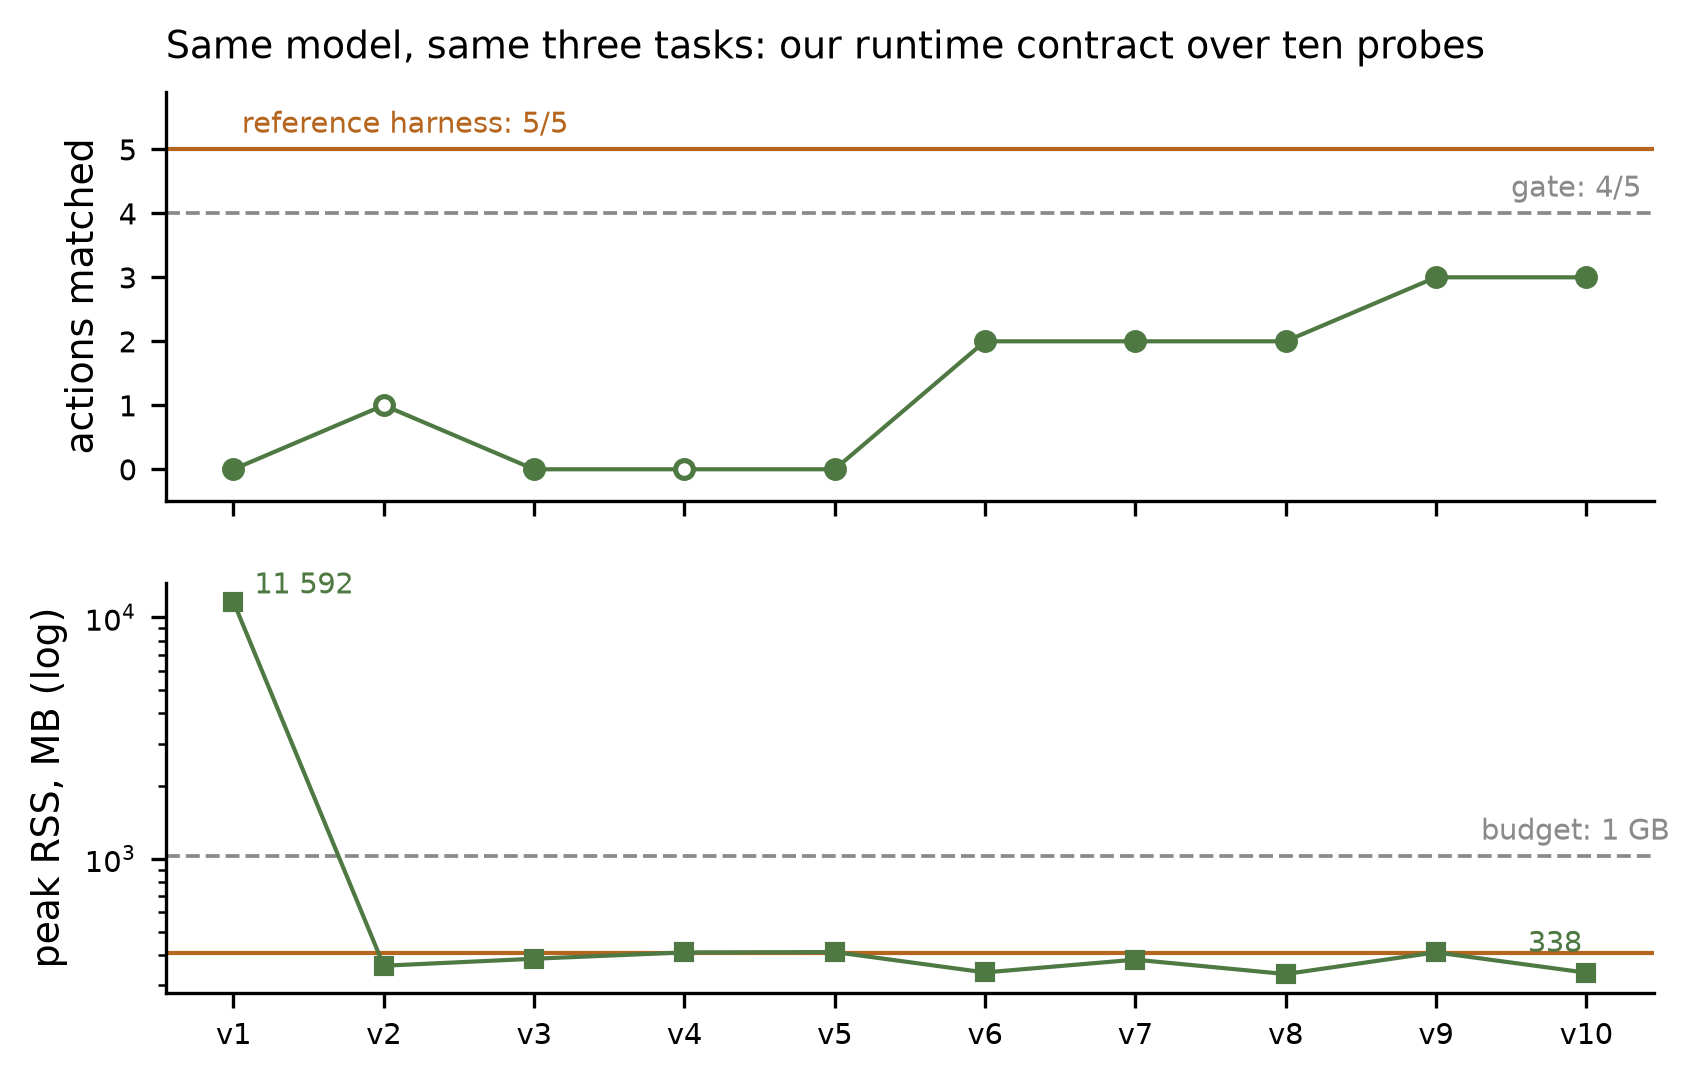
В разрабатываемой системе ELM код формирует набор возможных действий, нейросеть-судья выбирает подходящее, после чего программная среда осуществляет вызов и фиксирует результат. Тестирование проводилось на бенчмарке tau2-bench в сценарии airline, где модель взаимодействует с симулятором пользователя и базой данных бронирований. Первичный запуск продемонстрировал максимальный показатель pass^1 на уровне 1,000, однако детальный аудит показал совпадение с эталонным сценарием всего по двум действиям из тринадцати.
Подобный разрыв объясняется спецификой метрики: итоговая награда проверяет лишь конечное состояние базы данных и условия коммуникации, игнорируя сам путь выполнения задачи. Поскольку во многих стандартных кейсах начальное состояние системы совпадает с целевым, запуск примитивного агента без логики вызовов инструментов дает значительный процент успешных завершений. Встроенный диагностический контроль в виде подсчета имен инструментов и аргументов помогает точнее оценивать корректность прохождения тестов.
Сравниваю ELM с заглушкой на одном наборе
Сравнение базовой версии ELM с заглушкой на тридцати задачах не выявило преимуществ архитектуры: чистая система показала схожие результаты при колоссальном количестве повторных вызовов. Отсутствие жестких ограничений на повторения привело к избыточным трассам диалогов и резкому росту потребления системной памяти, вплоть до принудительного завершения процессов операционной системой.
Главным выводом на данном этапе стало понимание того, что проблемы кроются не в возможностях языковой модели, а в логике контракта между выбором действия, состоянием диалога и механизмами его исполнения.
Сажаю одну модель в два цикла
Для разделения ошибок самой модели и дефектов программного окружения была протестирована единая языковая модель в двух разных управляющих средах: референсном харнессе бенчмарка и кастомном цикле. Контрольная проверка подтвердила, что даже при идеальных итоговых оценках кастомная реализация уступает эталонной по количеству шагов и потреблению ресурсов, что потребовало жесткой доработки логики выполнения.
Разбираю повторы и потерянные задачи
Многочисленные итерации тестов помогли выявить и устранить архитектурные дефекты, включая бесконечные повторы идентичных запросов и сбои парсинга ответов модели. Ошибки разбора ответов приводили к исключениям инфраструктуры, которые теперь корректно фиксируются в метриках провалов. Введение дополнительных регламентных проверок перед записью данных в базу позволило стабилизировать выполнение диалогов, хотя длина цепочки шагов по-прежнему превышает эталонные показатели.
Проверяю цену и чистоту теста
Оценка финансовых затрат показала расхождения в расчете стоимости обращений к рантайму из-за особенностей учета HTTP-запросов на стороне провайдера. Кроме того, повторное использование отладочных задач в основных прогонах нарушило чистоту тестовой выборки, исключив возможность формирования независимого независимого тестирования на нетронутых данных.
Исправляю цикл до следующего сравнения
Дальнейшая работа направлена на оптимизацию выбора бронирований по проверенным параметрам, фиксацию однократного чтения и сокращение длины диалогов. Полученные наработки и методика сопоставления действий с итоговой наградой позволили локализовать ключевые ошибки программного цикла до перехода к оценке качества работы нейросетевых судей.
