
Мой блог
Новинки серверного железа и ИИ-ускорителей: тренды осени, от чипов без HBM до накопителей на 122 ТБ

Индустрия серверных вычислений и искусственного интеллекта активно ищет способы снизить совокупную стоимость владения инфраструктурой. На рынке наметилась отчетливая тенденция к разделению задач и отказу от сверхдорогой памяти там, где этого можно избежать. В свежем обзоре отраслевых новинок рассмотрен очередной дайджест серверного железа и ускорителей, охватывающий разработки от стартапов до технологических гигантов вроде Huawei, Arm и Fujitsu.
Среди ключевых тем месяца — перевод инференса на энергоэффективную память LPDDR, разделение конвейера нейросетей на независимые фазы, расширение линейки Arm-процессоров для центров обработки данных и выпуск твердотельных накопителей рекордного объема для хранения весов моделей.
Заметные события инфраструктурного рынка
Корпоративный сегмент пополнился серией важных аппаратных анонсов, затрагивающих как память, так и вычислительные узлы:
- Модули Micron RDIMM DDR5-9200 емкостью 512 ГБ. Использование вертикальной компоновки с межкремниевыми соединениями (TSV) позволило уместить такой объем на одной планке. Это дает возможность укомплектовать двухсокетный сервер с 24 слотами внушительным пулом до 12 ТБ оперативной памяти. Энергопотребление одной такой планки составляет 16 Вт, тогда как четыре модуля по 128 ГБ суммарно требуют 44,2 Вт. Старт массового производства ожидается во второй половине 2027 года.
- Серверная видеокарта NVIDIA RTX PRO 5500. Решение построено на архитектуре Blackwell (чип GB202, аналогичный RTX 5090) и оснащено 84 ГБ видеопамяти стандарта GDDR7. Плата получила нетипичную разводку шины и охлаждается парой вентиляторов формата 40×40×56 мм, ориентируясь строго на стоечное размещение.
- Бюджетные шестиядерники AMD. Компания тихо расширила каталог двумя чипами: Ryzen 5 7500 для сокета AM5 (фактически версия 7500F с добавленным видеоядром на базе RDNA 2) и Ryzen 5 5500F для платформы AM4 на базе кристалла Vermeer с поддержкой шины PCIe 4.0 и урезанным до 16 МБ кэшем третьего уровня.
- Китайские суперкластеры и чипы. Huawei анонсировала комплекс Atlas 960E SuperPoD, объединяющий 4 096 нейропроцессоров (NPU) с оптической связью Hi-ONE. В то же время Alibaba представила процессор Zhenwu V900, укомплектованный 216 ГБ памяти HBM и межпроцессорным интерконнектом с пропускной способностью 1,2 ТБ/с.
- Практические тесты Alibaba Zhenwu 810E. На практике сервер с 16 подобными ускорителями и совокупным объемом памяти 1,5 ТБ HBM2e продемонстрировал интерконнект ICN со скоростью 89 ГБ/с на сдвоенном линке (44 ГБ/с на одинарном и 14 ГБ/с через PCIe). На этой системе успешно запустили модели DeepSeek-V4-Flash и Kimi K2.6, где узким местом осталась лишь адаптация программного стека.
HyperAccel Bertha: архитектура LPU и отказ от памяти HBM
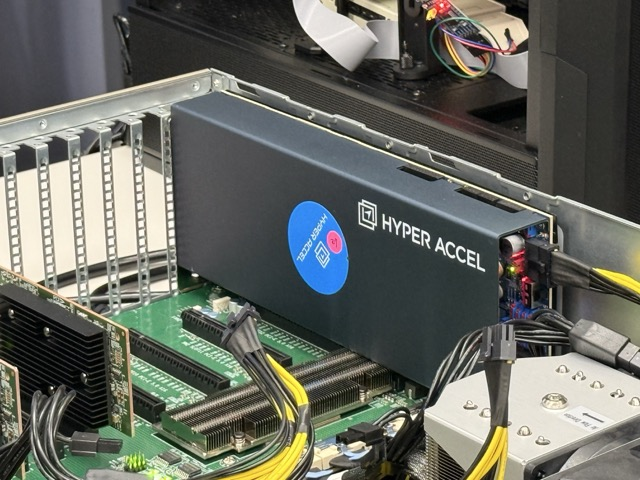
Южнокорейская компания HyperAccel предложила подход к снижению себестоимости генерации токенов, представив ускорители Bertha. Вместо дефицитной и дорогой памяти HBM разработчики сделали ставку на стандартные чипы LPDDR5X. Концепция ориентирована на жесткую синхронизацию вычислительных блоков с пропускной способностью шины, благодаря чему средний уровень утилизации аппаратных ресурсов во время инференса удерживается около отметки 90%.
Флагманская модель Bertha 500 выполнена в двухслотовом форм-факторе и выпускается по нормам 4-нанометрового техпроцесса. Устройство несет 256 МБ быстрой памяти SRAM и 128 ГБ LPDDR5X с суммарной пропускной способностью 546 ГБ/с. Заявленная производительность составляет 768 Тфлопс для формата вычислений FP8 и 384 Тфлопс для FP16, также реализована поддержка FP4, INT8 и INT4. Уровень TDP ограничен 250 Вт. Позже производитель намерен выпустить модификацию с объемом памяти 256 ГБ.
Для компактных систем разработана версия Bertha 100 в формате накопителя M.2. Она предлагает 16 ГБ памяти LPDDR5X с каналом 64 ГБ/с и выдает 32,8 Тфлопс в FP8. Программная среда ускорителей совместима с фреймворками PyTorch, ONNX и средой vLLM. Вендор заявляет о преимуществе по числу токенов на доллар и ватт относительно NVIDIA H100, однако независимых публичных тестов пока не представлено, а сравнение ведется с чипом прошлого поколения.
Серийный выпуск процессоров Axelera Europa
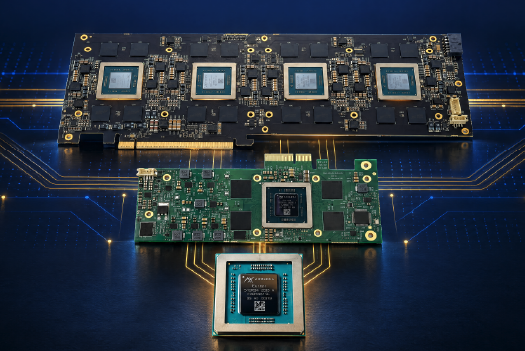
Европейский разработчик Axelera AI объявил о начале коммерческих отгрузок чипов Europa, предназначенных для обслуживания корпоративных нейросетевых нагрузок. В структуру кристалла заложены восемь вычислительных ИИ-ядер с цифровой обработкой данных непосредственно в памяти (Digital In-Memory Computing, D-IMC), 16 векторных ядер на базе архитектуры RISC-V, 128 МБ кэш-памяти L2 SRAM и 256-битная шина LPDDR5 с показателем пропускной способности 200 ГБ/с. В целочисленном формате INT8 процессор развивает до 629 TOPS, что почти втрое превосходит показатели предыдущего поколения Metis.
Поставки Europa организованы в виде отдельных чипов, низкопрофильных карт Edge 232p с одним процессором и полноразмерных ускорителей Server 250p с четырьмя чипами на борту. Одночиповая плата уже прошла сертификацию в серверах Dell XE5 и Supermicro 111AD.
Планы развития линейки ускорителей Huawei Ascend
В рамках мероприятия Connect компания Huawei обнародовала дорожную карту развития семейства Ascend, сместив акцент на специализацию процессоров под конкретные этапы работы нейросетей.
В первом квартале 2027 года ожидается релиз чипа Ascend 960DT (Decode/Training):
- 288 ГБ памяти, предположительно собственной модификации HBM под названием HiZQ;
- пропускная способность стека памяти до 9,6 ТБ/с;
- вычислительная мощность на уровне 4 Пфлопс в FP4 и 2 Пфлопс в FP8.
По подсистеме памяти 960DT сопоставим с NVIDIA B300, однако по чистой производительности в операциях FP8 и FP4 уступает ему в два-три раза.
На третий квартал 2027 года запланирован чип Ascend 960PR, спроектированный под этап prefill и рекомендательные системы. Новинка получит 192 ГБ памяти со скоростью 2,4 ТБ/с и производительность 8 Пфлопс в формате FP4. Такое разделение повторяет логику разнесения фаз контекста и генерации по разным специализированным кристаллам. На 2028 год намечен выпуск модели Ascend 970 (288 ГБ, 14,4 ТБ/с, 14 Пфлопс FP4), а на 2029 год — Ascend 980 (384 ГБ, 38,4 ТБ/с, 28 Пфлопс FP4).
Вычислительная платформа Arm Neoverse CSS N4
Компания Arm представила процессорную подсистему Neoverse CSS N4 под кодовым наименованием Ranger. Это готовый синтезируемый RTL-блок, рассчитанный на интеграцию заказчиками в собственные серверные чипы или процессоры обработки данных (DPU). Подсистема масштабируется от 8 до 128 ядер Neoverse N4 на кристалл и впервые для N-серии способна работать на тактовой частоте до 3,8 ГГц.
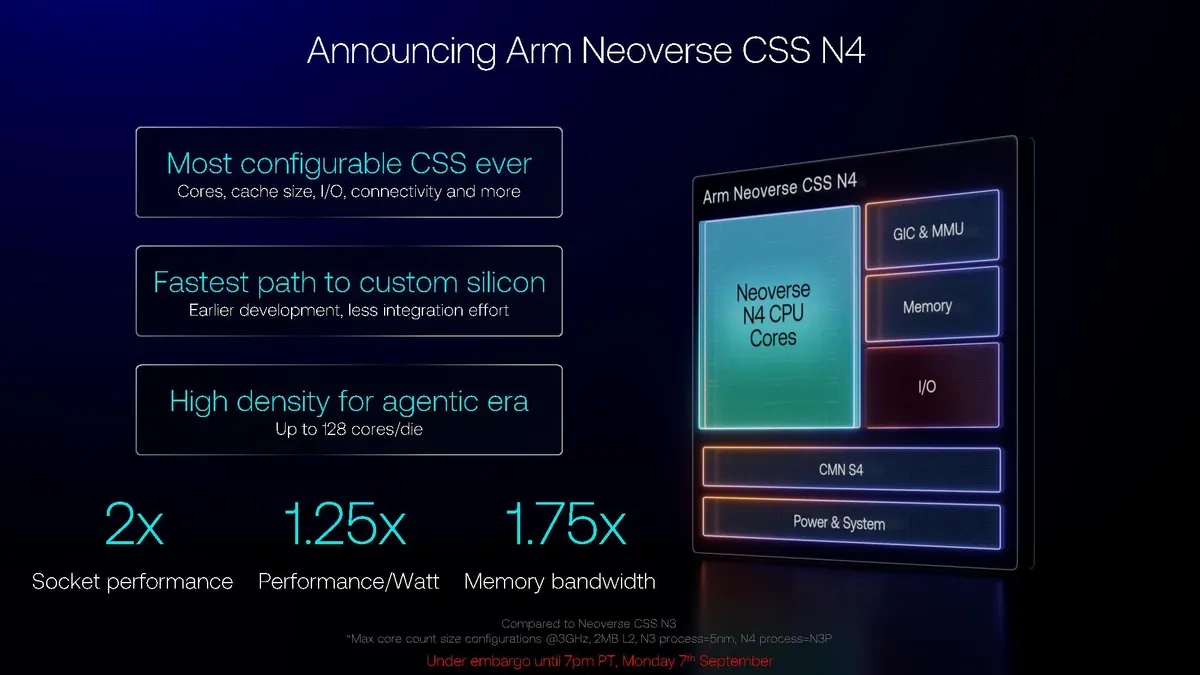
Платформа поддерживает оперативную память стандартов LPDDR6 и DDR5, а подсистема ввода-вывода способна предоставить до 128 линий шины PCIe 7.0. Межъядерное взаимодействие внутри чиплетов обеспечивает mesh-сеть CMN S4 с поддержкой когерентности. Относительно поколения CSS N3 разработчики заявляют двукратный рост производительности на процессорный разъем, улучшение энергоэффективности на 25% и увеличение пропускной способности памяти в 1,75 раза.
Серверный 144-ядерный процессор Fujitsu MONAKA
Fujitsu объявила о старте продаж 144-ядерных Arm-процессоров MONAKA, которые будут доступны как самостоятельные компоненты, так и в составе готовых стоечных серверов. Чип использует пространственную 3D-компоновку: вычислительные ядра изготавливаются по нормам 2 нм, тогда как блоки ввода-вывода и кэш-память производятся по 5-нм техпроцессу. Частота чипа достигает 3,8 ГГц при работе с оперативной памятью DDR5-8800.
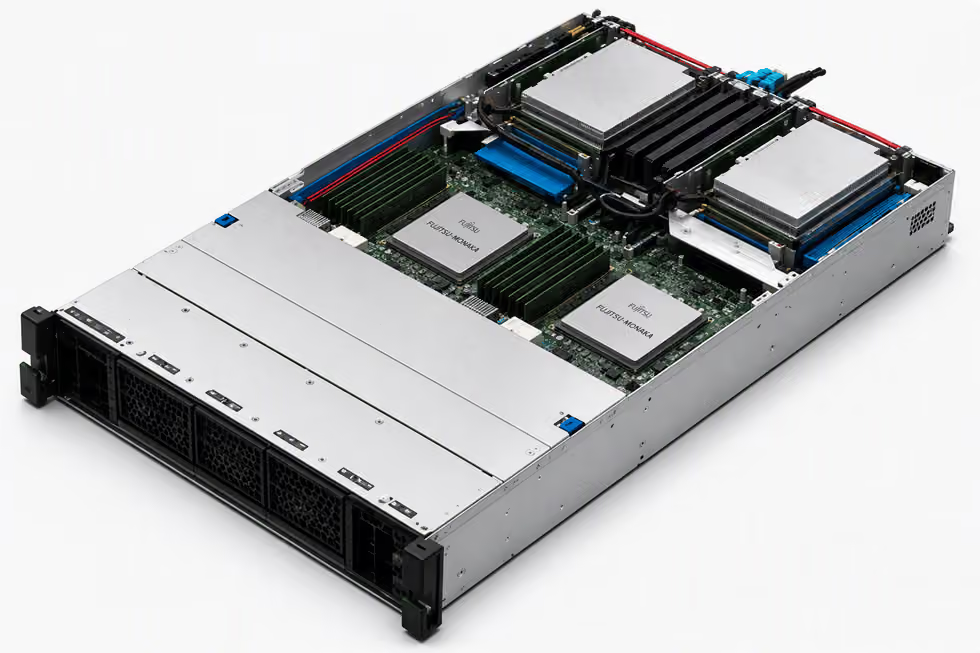
Для ускорения матричных операций процессоры оснащены специализированными векторными расширениями SVE2, что, по расчетам Fujitsu, удваивает скорость выполнения инференса относительно традиционных CPU общего назначения. Системы поддерживают пулы CXL и конструируются в форматах 1U (одно- и двухсокетные), 2U, а также в высокоплотном исполнении 2U4N для научных кластеров.
Накопители Unigen Cheetah для иерархических СХД
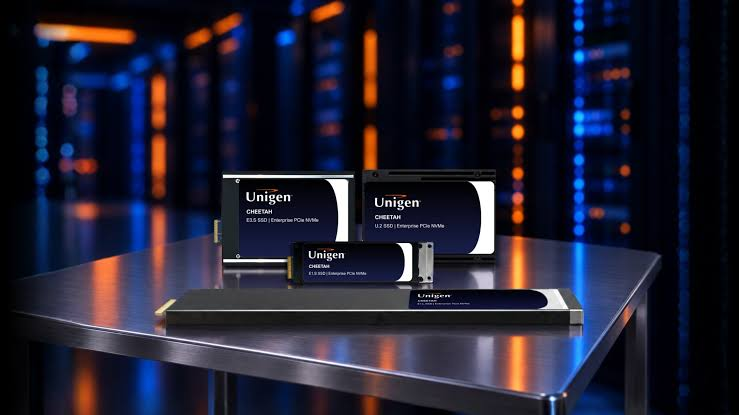
Компания Unigen развернула производство двух линеек корпоративных твердотельных накопителей с шиной PCIe 5.0 x4 по стандарту NVMe 2.0. Обе серии используют 16-канальные контроллеры и оперативную память DDR5 в роли кэша, реализуя двухуровневую структуру хранения:
- Быстрый ярус (Cheetah SCM): накопители на базе ячеек pSLC/eTLC емкостью 1,6 и 3,2 ТБ в форм-факторах E1.L, E3.S, E1.S и U.2. Скорость последовательного чтения достигает 14,7 ГБ/с, а случайный доступ 4 КБ демонстрирует до 3,37 млн IOPS. Показатель выносливости составляет 60 DWPD при случайной записи и 80 DWPD при последовательной, что позволяет перезаписывать до 192 ТБ данных в сутки на старшей модели. Серия ориентирована на кэш, журналы транзакций и временные файлы.
- Емкий ярус (Cheetah HC): плотные накопители на QLC/TLC объемом до 122,88 ТБ в форматах E1.L и U.2. Они обеспечивают скорость чтения до 14 ГБ/с и запись до 2,4 ГБ/с при ресурсе 0,3 DWPD. Устройства позиционируются под неизменяемые массивы, архивы и хранение весов больших языковых моделей.
Серверные платформы ASUS на свежих чипах AMD и Intel
На мероприятии ASUS AI Tech в Сеуле были продемонстрированы пять моделей серверов нового поколения под актуальные процессоры. Для платформы Intel Xeon 6 подготовлены двухсокетные узлы RS700-E12-RS4U (1U) и RS720-E12-RS12U (2U) с поддержкой 32 слотов DDR5-6400 (суммарно до 8 ТБ RAM).
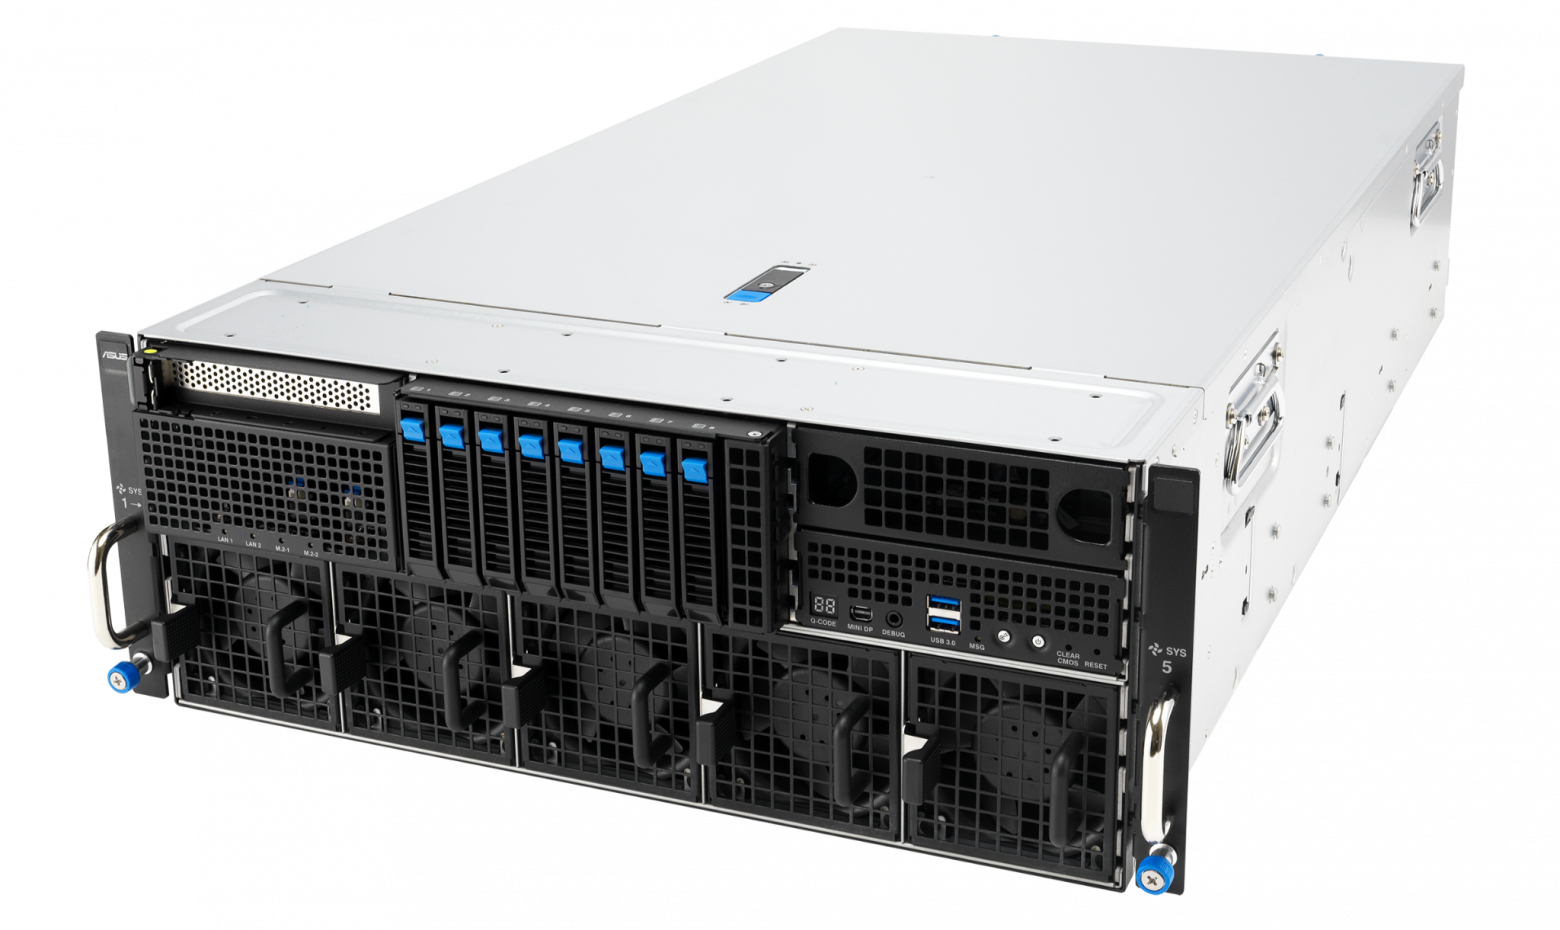
Под процессоры AMD EPYC 9006 поколения Venice созданы серверы RS720A-E14B-R32U (на 32 диска формата E3.S) и односокетный RS500A-E14B-R12U. Обе модели получили поддержку шины PCIe 6.0 и обновленный контроллер управления BMC AST2700. Кроме того, ASUS показала 4U-шасси ESC8000A-E13P на базе двух чипов AMD EPYC 9005 (Turin), способное вместить до восьми двухслотовых ускорителей уровня NVIDIA H200, карт Blackwell Server Edition или AMD Instinct MI350P.
Главный вектор индустрии
Основным лейтмотивом большинства последних анонсов остается оптимизация затрат на инференс нейросетей. Поставщики оборудования либо отказываются от дорогой HBM в пользу LPDDR5X, либо оптимизируют вычисления матриц на уровне центрального процессора, либо технологически разводят этапы обработки входного контекста и генерации токенов по отдельным специализированным кристаллам. При этом значительная часть представленных архитектур доберется до коммерческих серверных стоек ближе к 2027 году.
