Мой блог
Как создавалась тёмная тема для среды разработки: разбор нестандартного проекта

Долгая история запросов на внедрение темного интерфейса в среду разработки привела к созданию независимого приложения для работы с файлами конфигурации. В материале рассматривается разработка утилиты, позволяющей открыть конфигурацию без штатной платформы, изучить внутреннюю структуру контейнеров и реализовать поддержку темных цветовых схем.
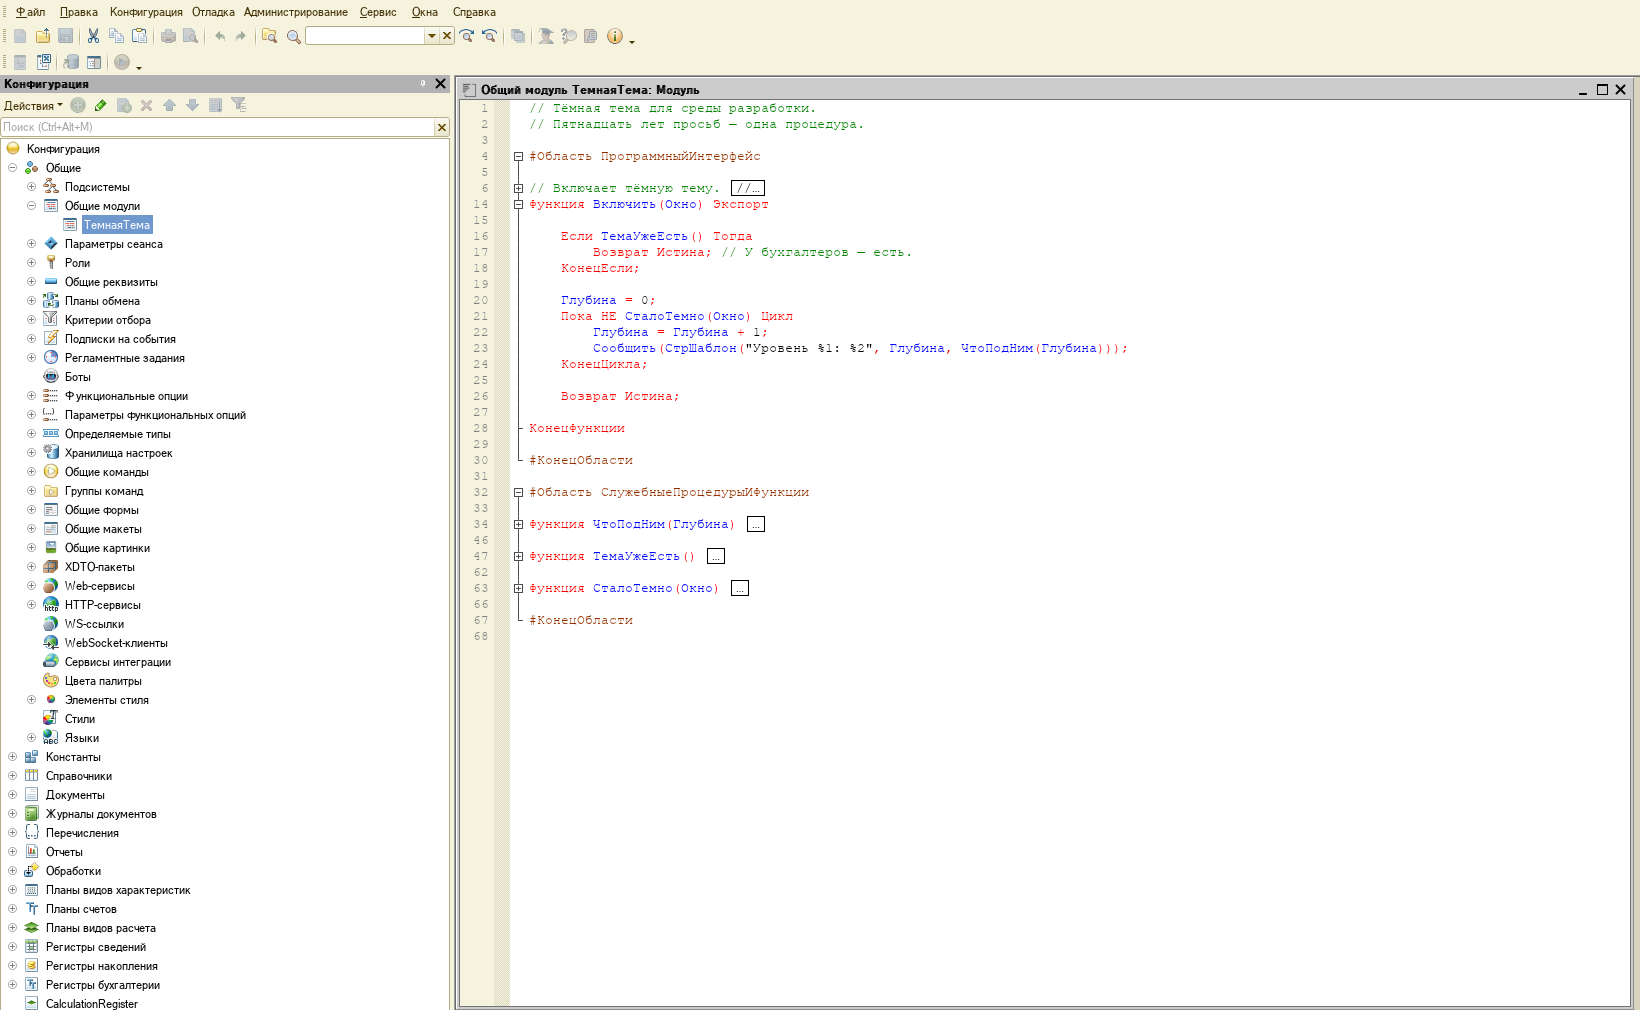
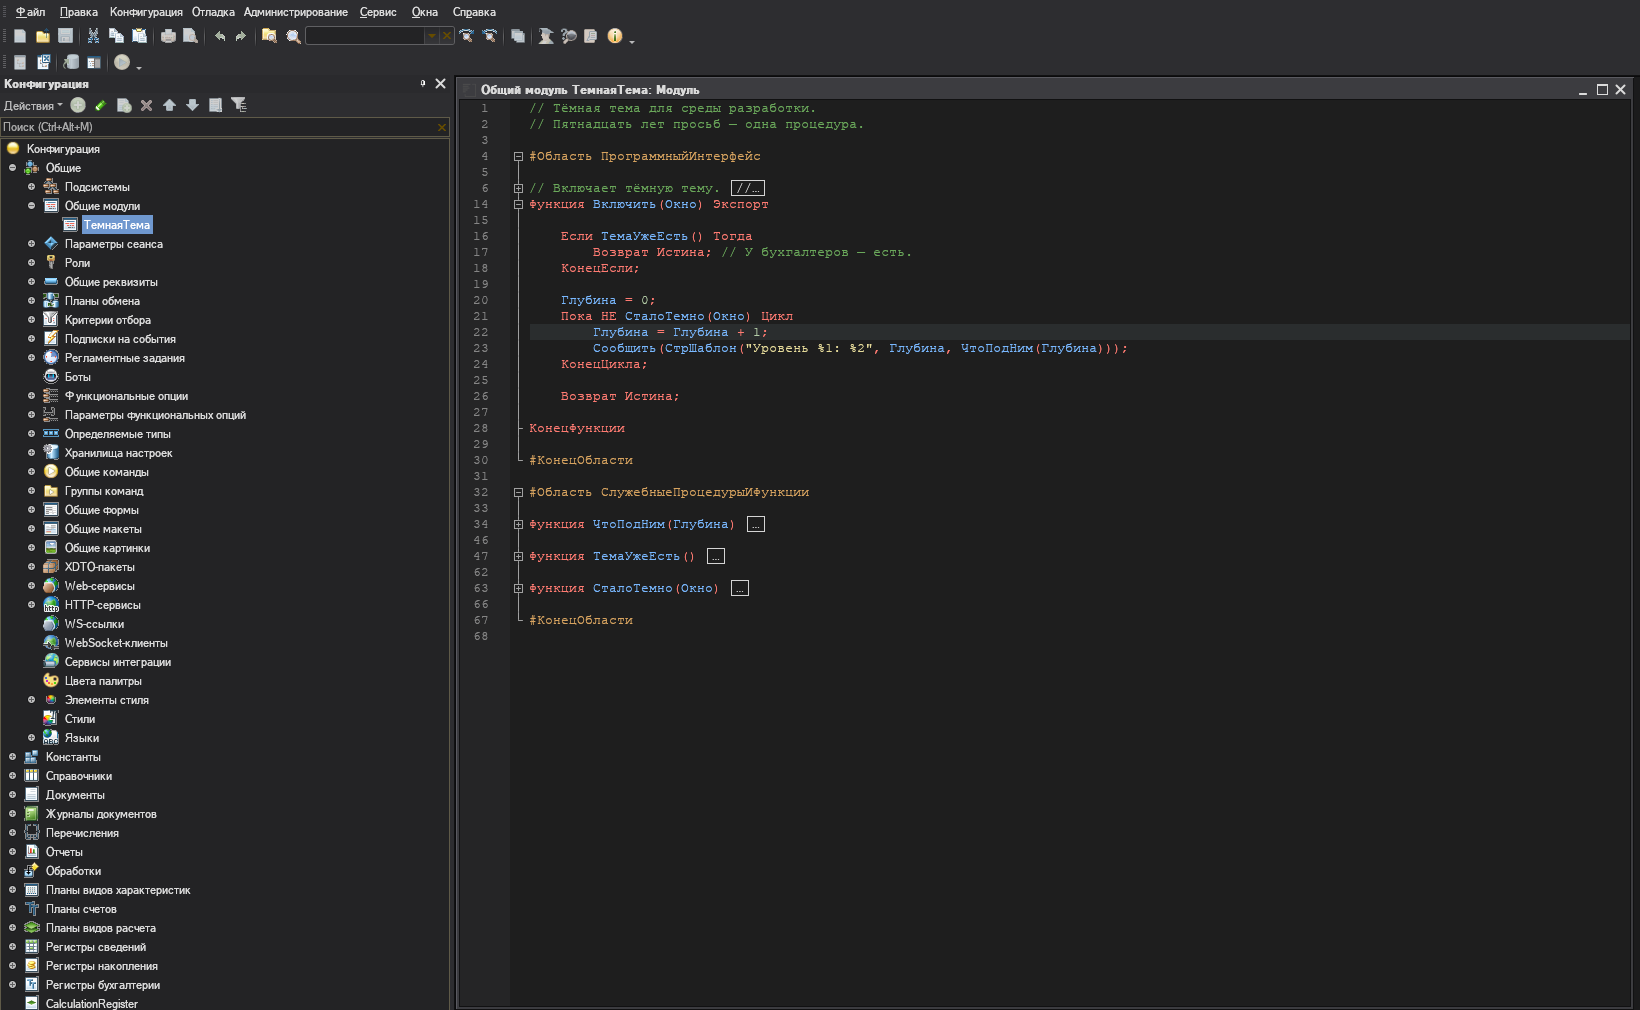
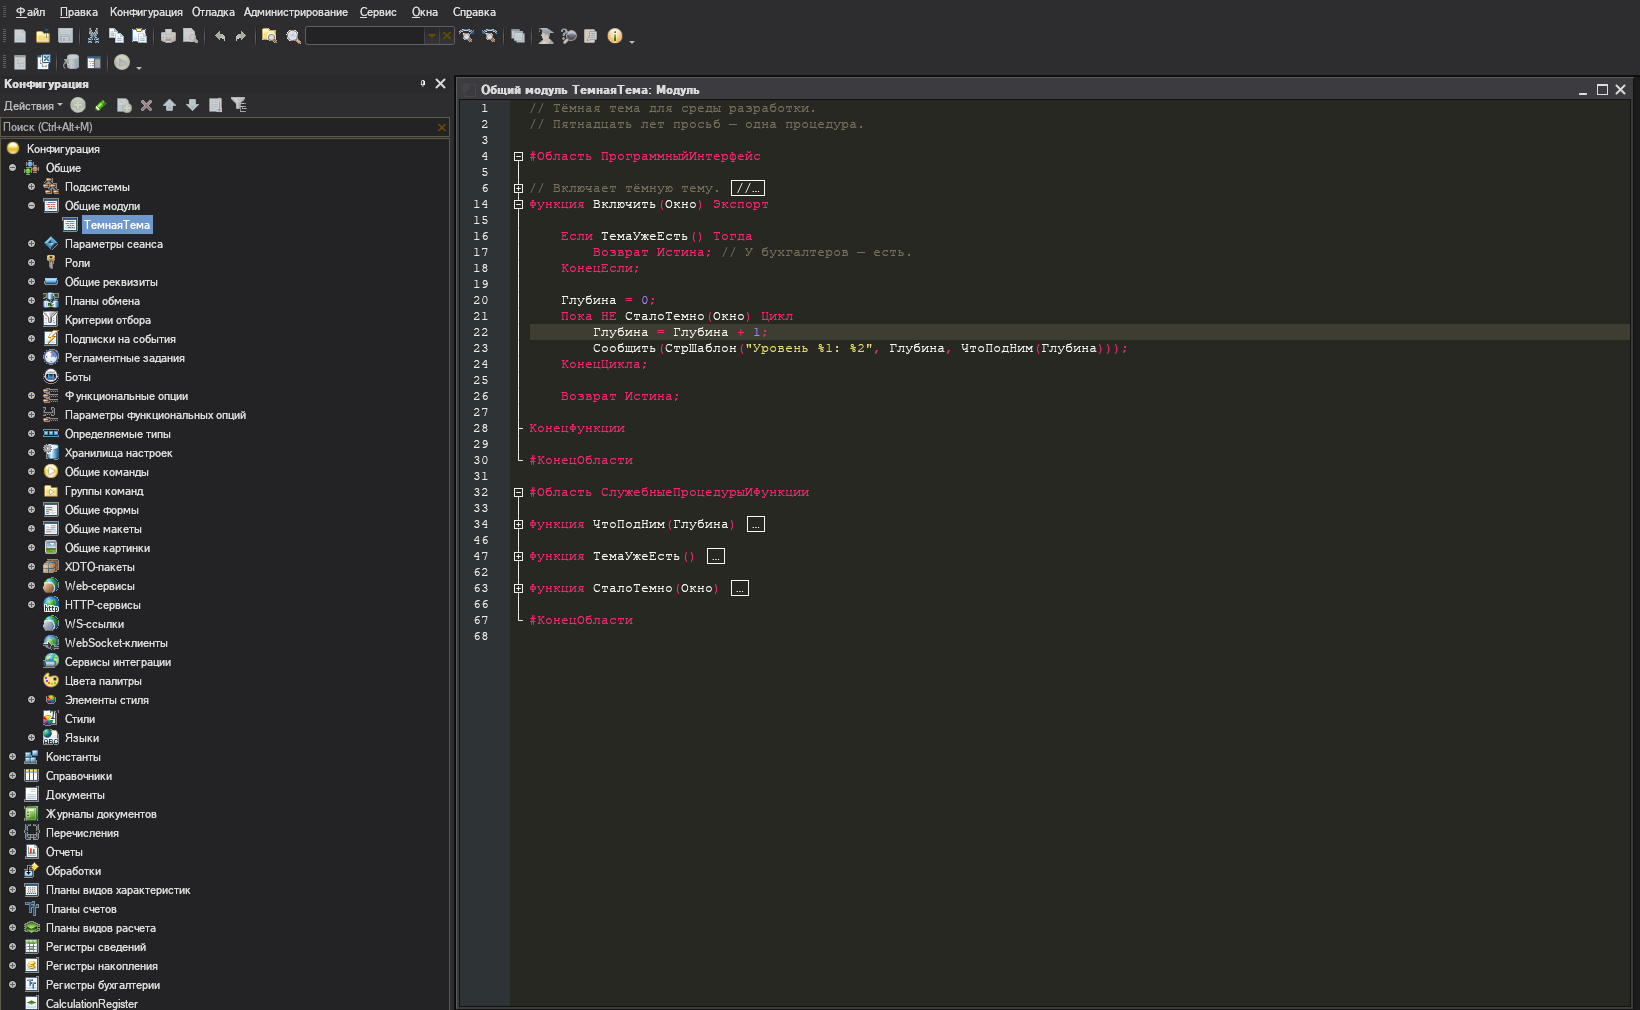
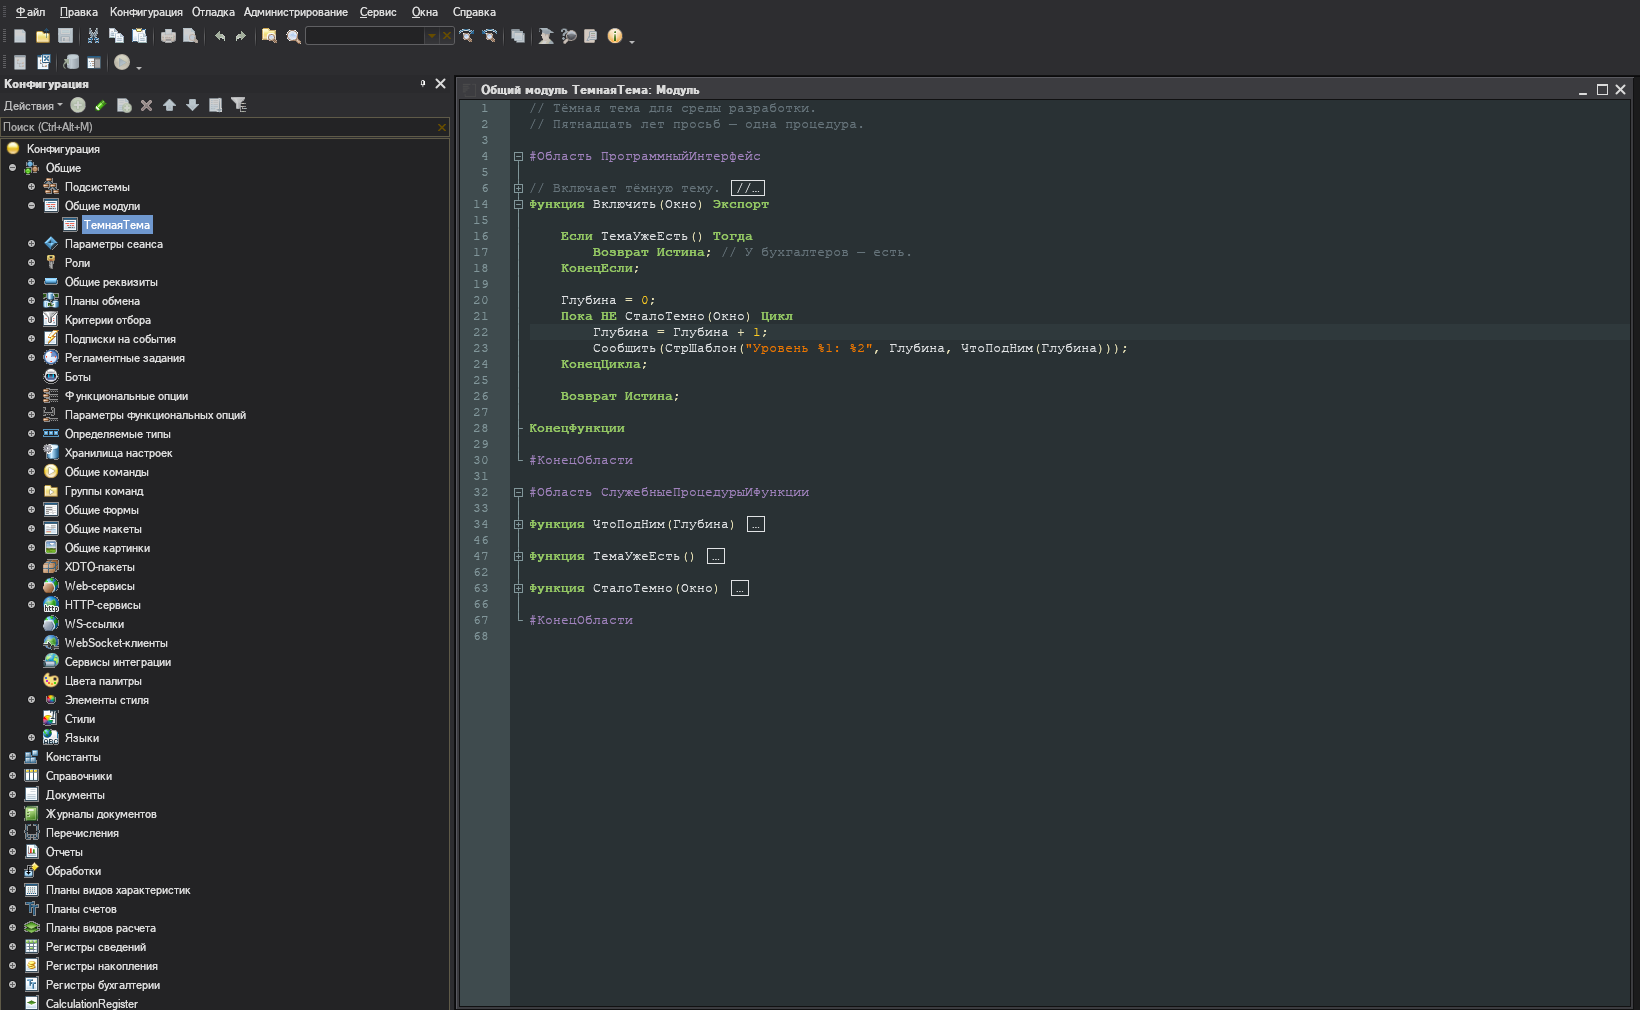
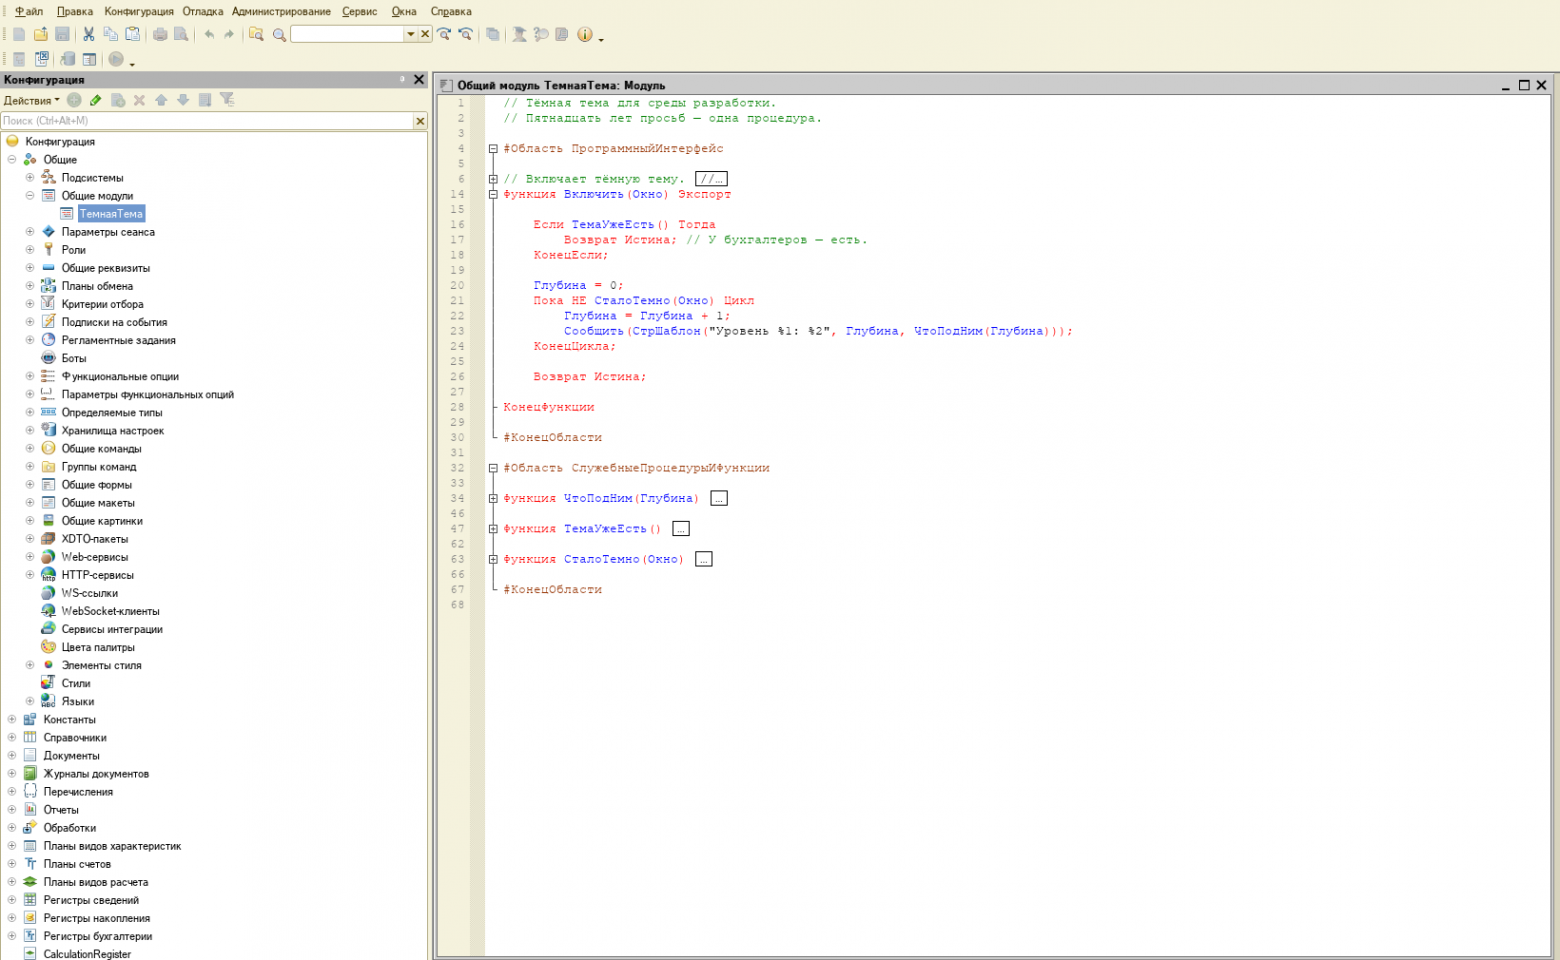
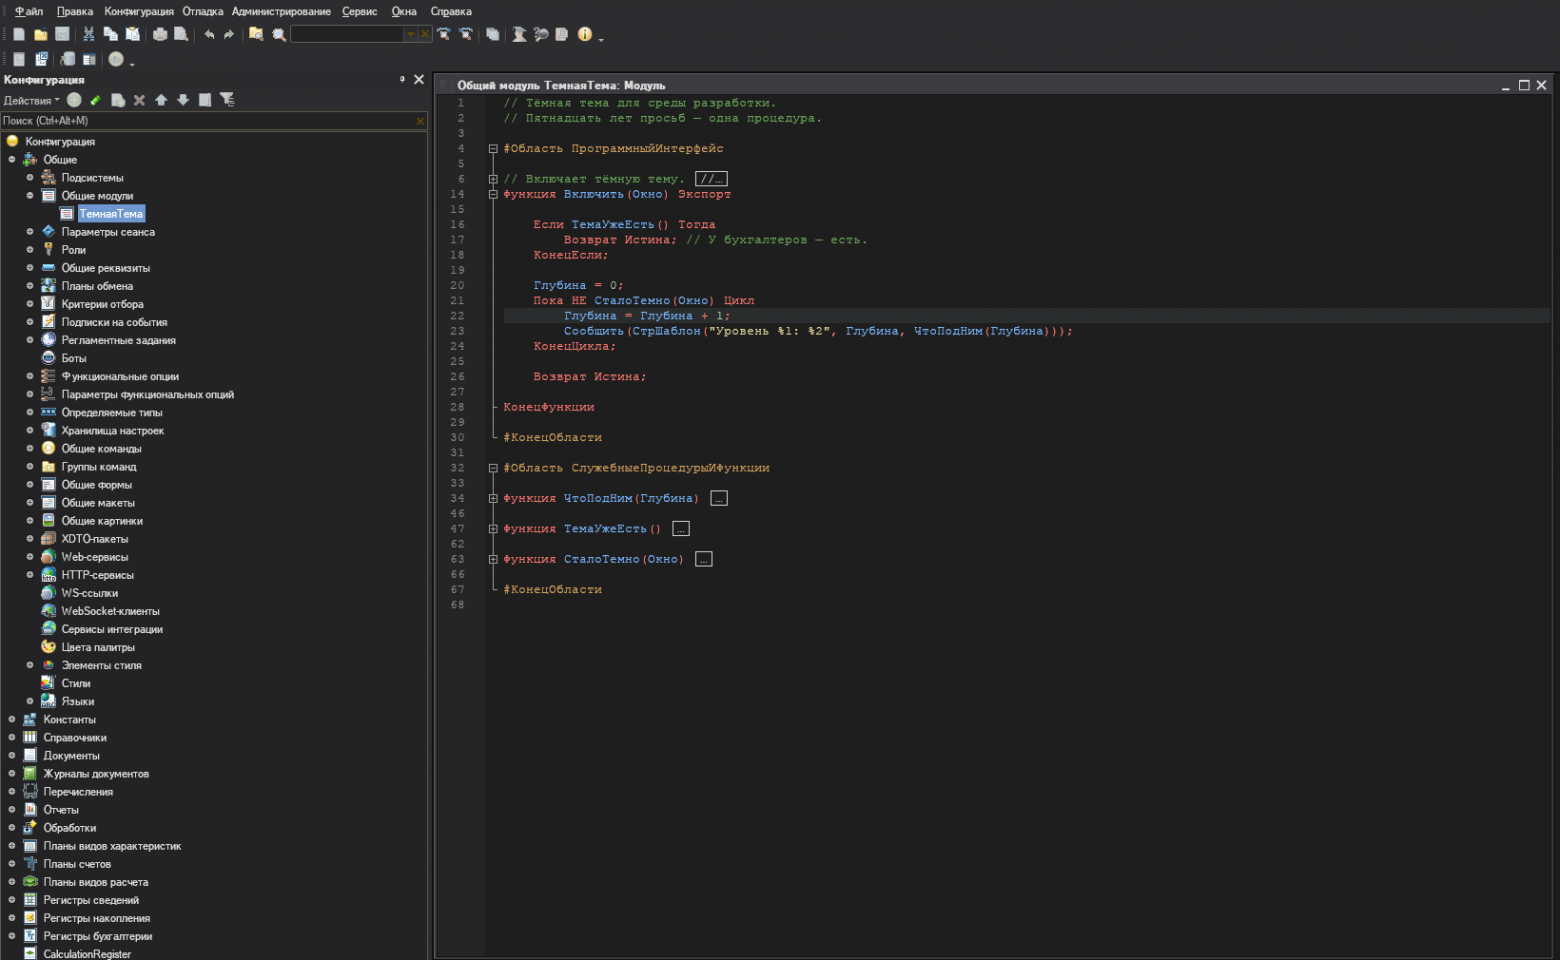
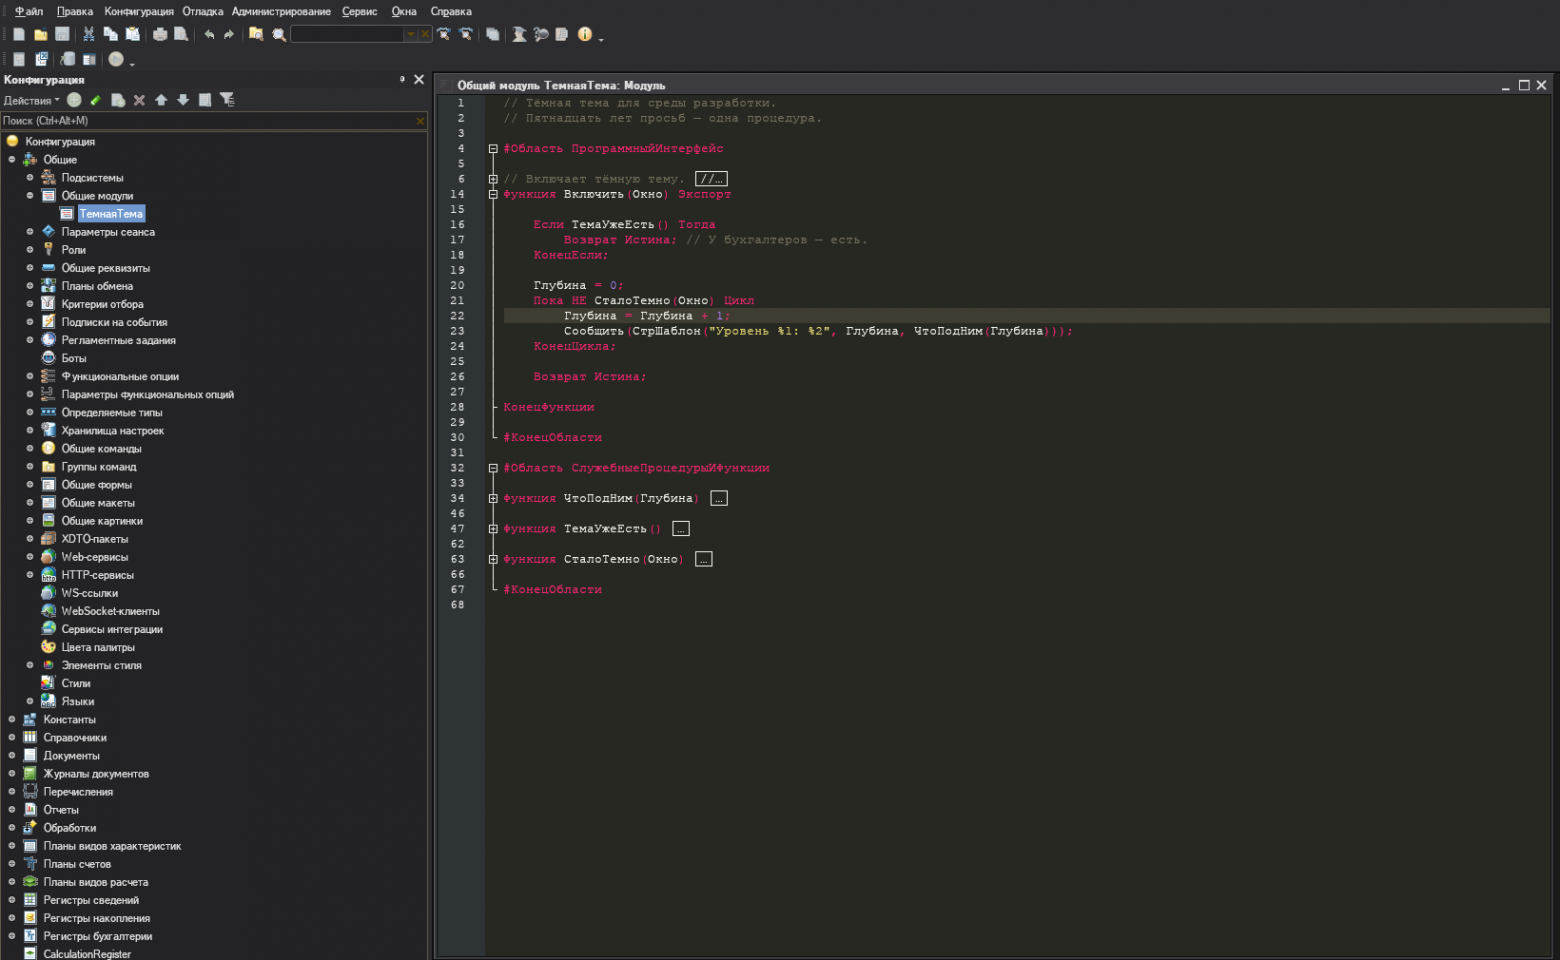
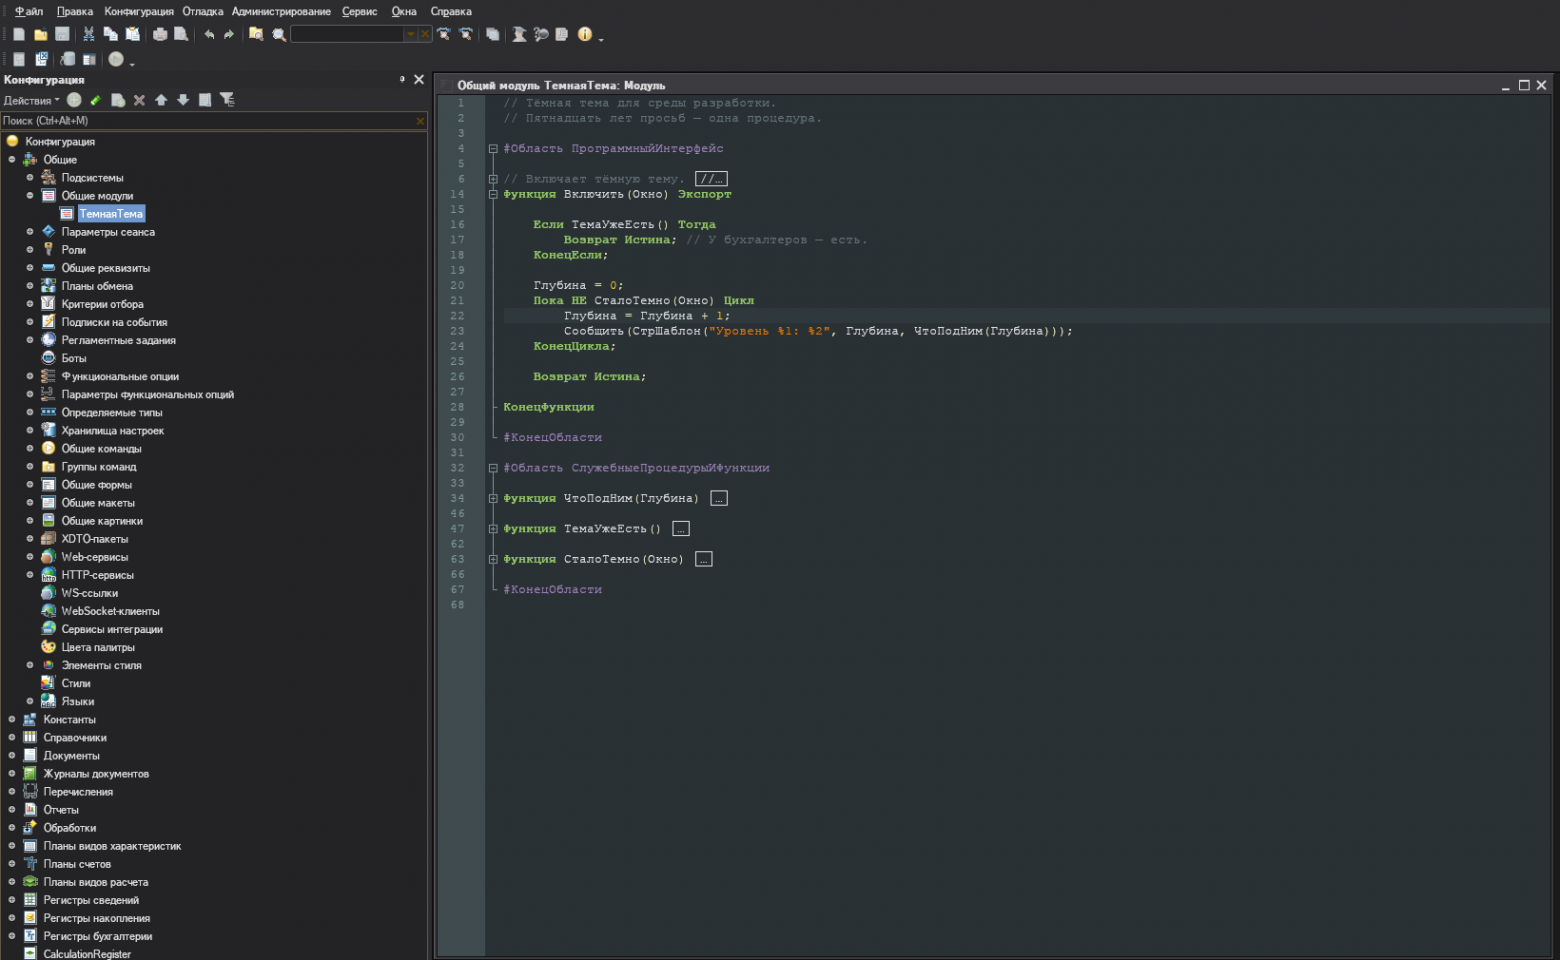
Многолетние попытки пользователей изменить оформление среды разработки обычно ограничивались редактированием подсветки модуля кода. В то время как текстовые редакторы и сторонние инструменты позволяли настраивать цвета, дерево объектов, панели свойств и меню оставались светлыми. Появление официальных обновлений интерфейса затрагивало лишь пользовательскую часть, оставляя разработчиков в привычном светлом контуре.
Архитектура файла конфигурации и матрёшка контейнеров
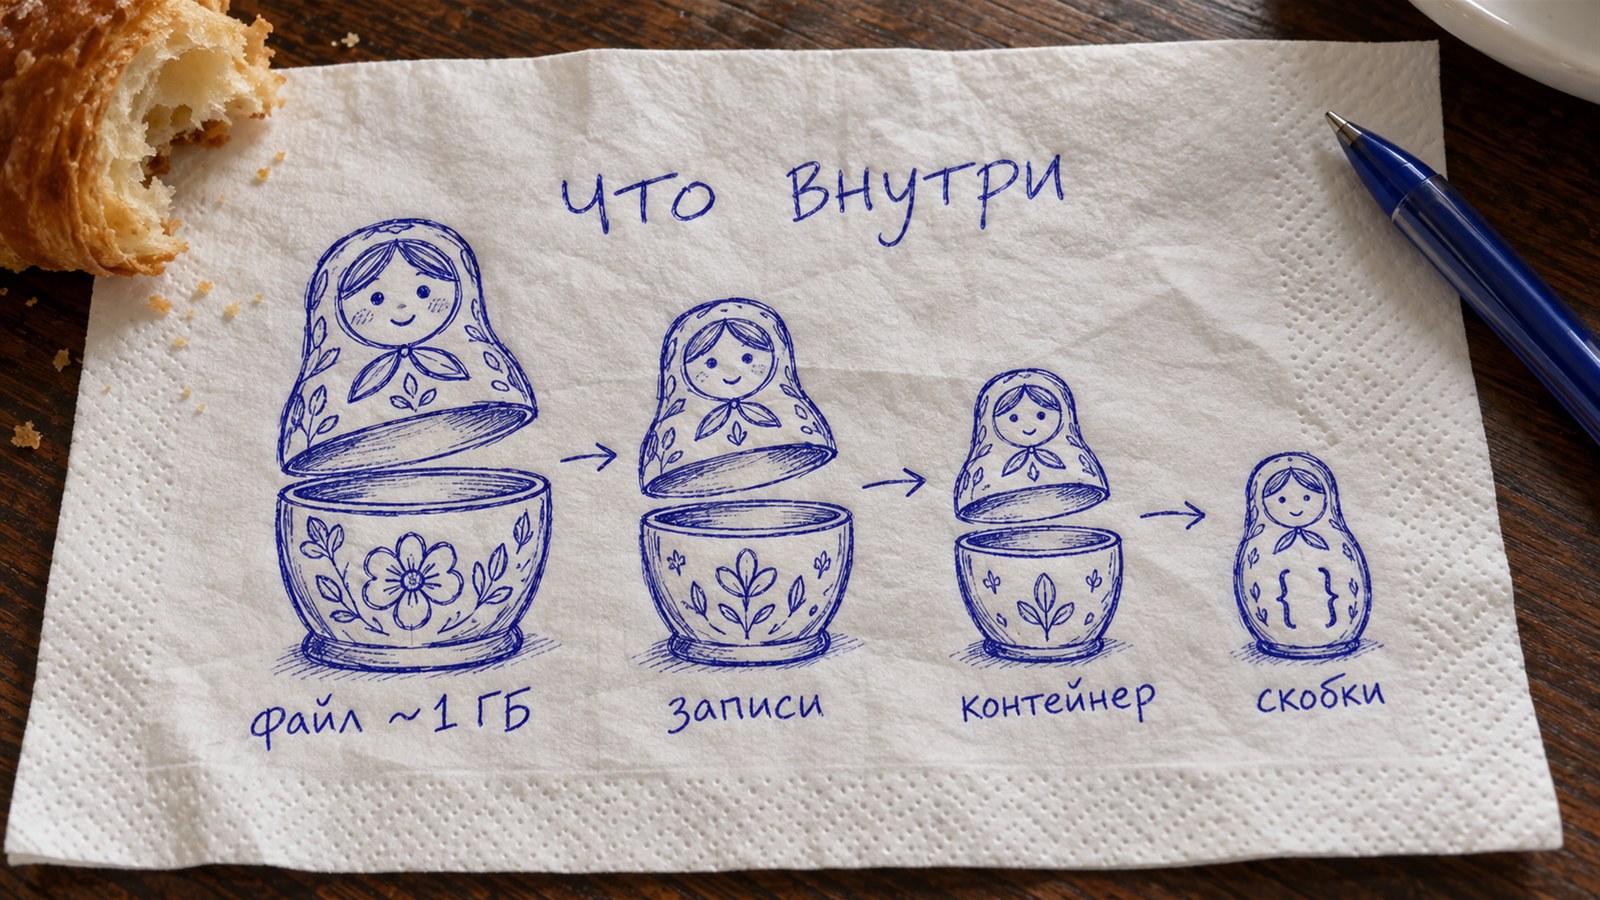
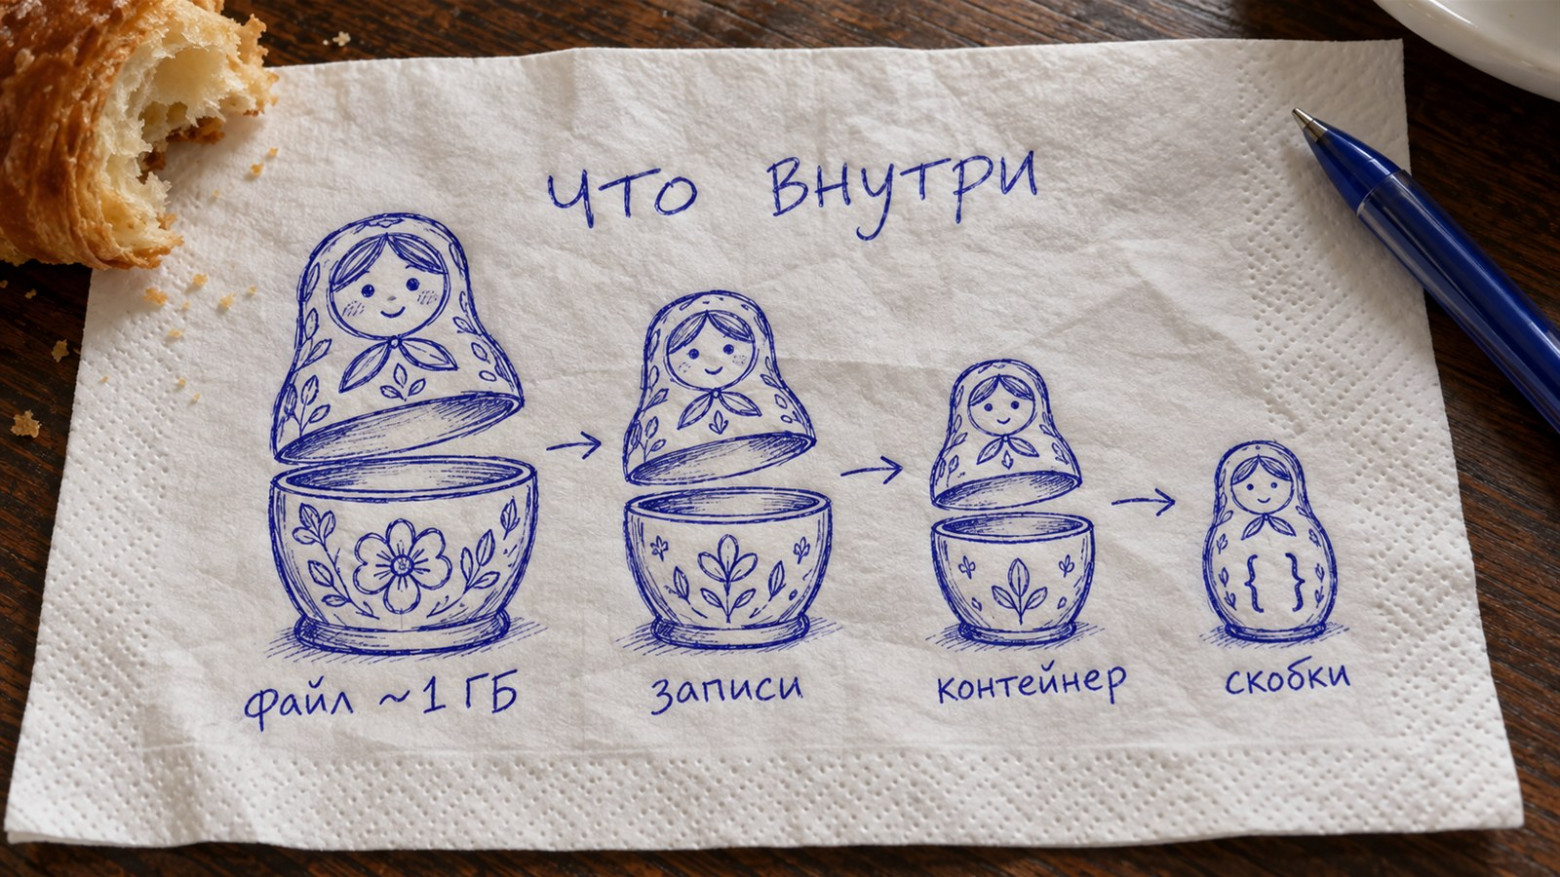
Для создания собственного интерфейса потребовалось напрямую обратиться к файлу конфигурации размером около гигабайта. Внутри он устроен по принципу вложенных контейнеров: страничный каталог содержит оглавление и множество сжатых записей. Некоторые из них скрывают внутри себя другие контейнеры, заполненные специфическими скобочными структурами без явных схем и имён полей.
Извлеченные данные позволяют выстроить дерево объектов, отображающее структуру конфигурации, включая формы и модули. Поскольку штатная среда отображает только видимые строки, даже массивные модули загружаются мгновенно. Реализация собственного движка подсветки позволила интегрировать готовые цветовые схемы из Notepad++, предоставив пользователям выбор из десятков оформлений без ручного ввода шестнадцатеричных кодов.
Контроль точности и проверка байт в байт
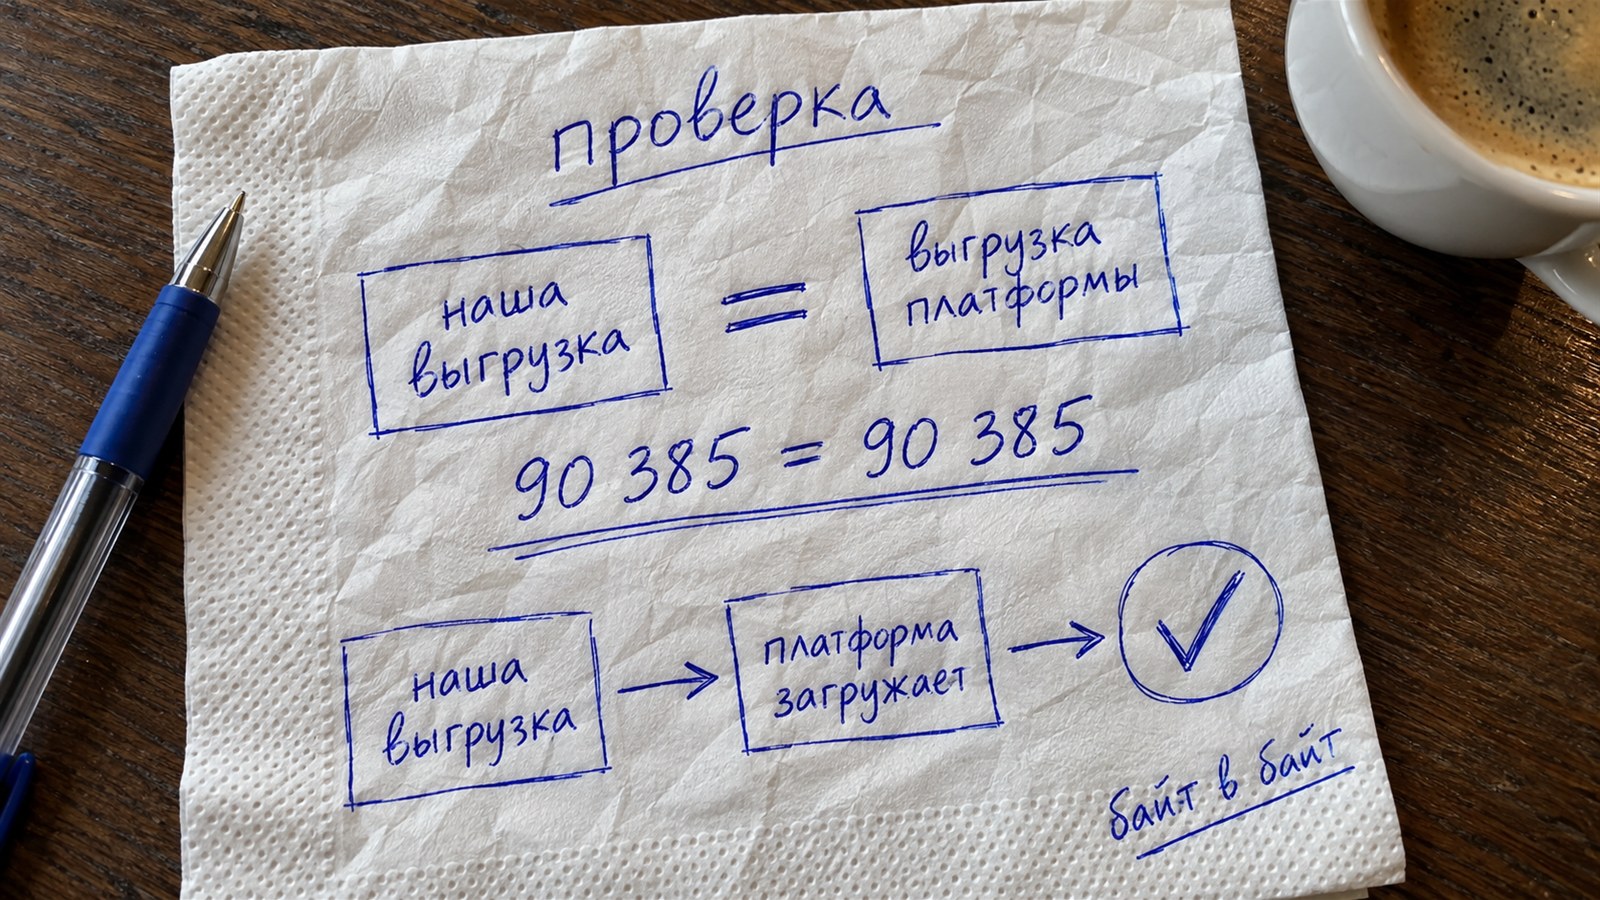
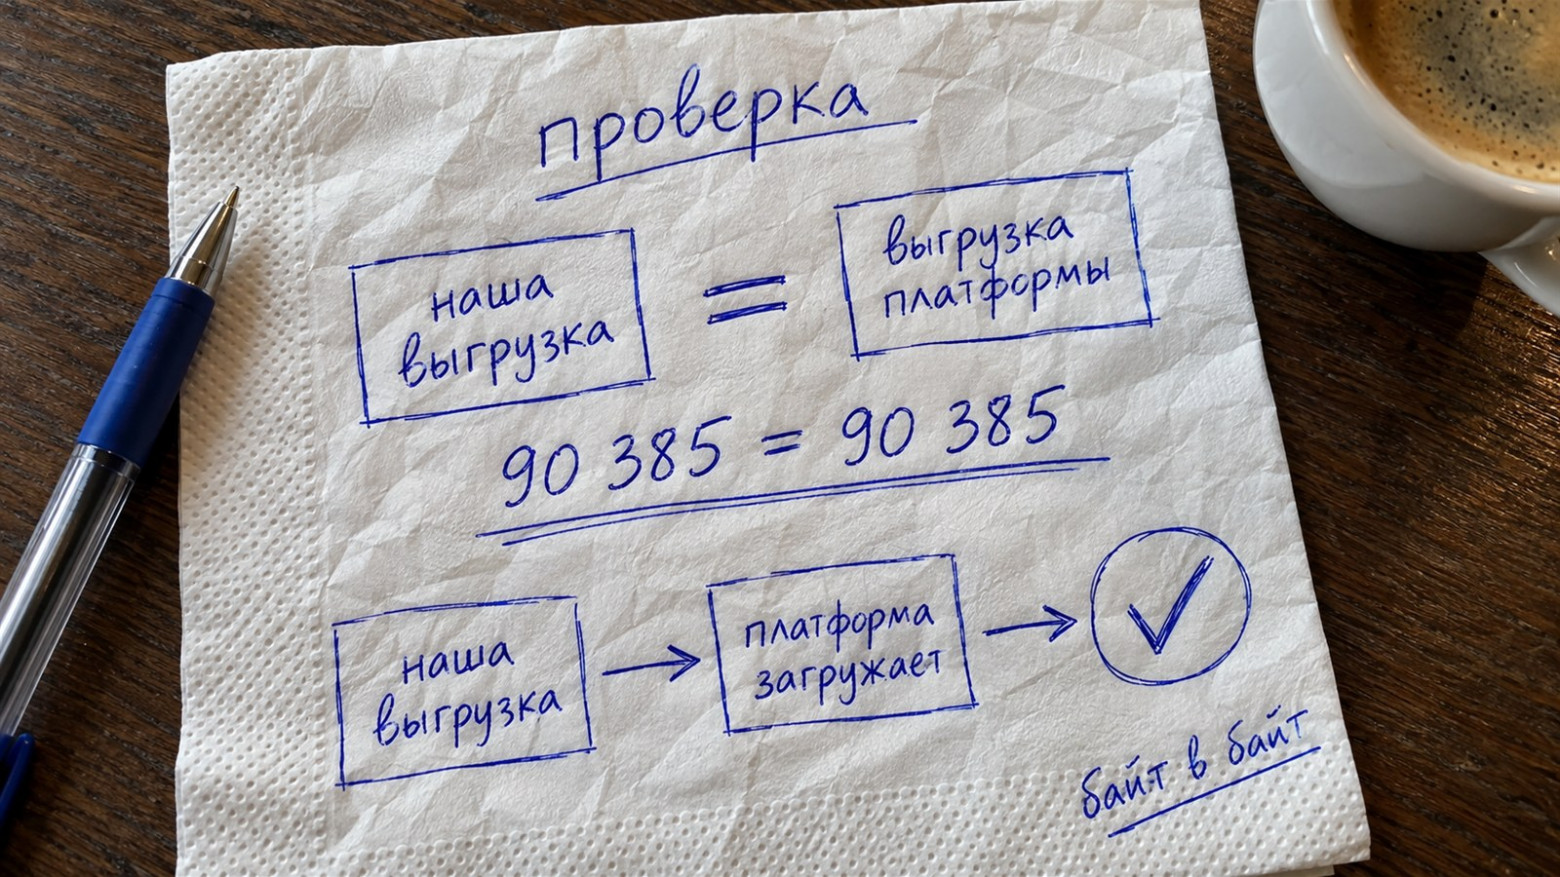
Чтобы убедиться в корректности расшифровки неформатированного хранилища, автор проекта применил строгий метод проверки. Процесс чтения файла транслируется в XML-выгрузку, которая затем сопоставляется с аналогичными данными штатной платформы с точностью до каждого байта, включая переводы строк и табуляцию. Для крупной прикладной конфигурации совпадение достигается на десятках тысяч файлов.
Обратная процедура загрузки XML требует идеального понимания каждого элемента и атрибута. Любая неточность приводит к отказу в загрузке с фиксацией причины, что исключает скрытую потерю данных. Окончательную проверку выполняет сама платформа, принимая сгенерированную выгрузку для сверки записей.
Особенности обхода хэш-таблиц и разбор языка запросов
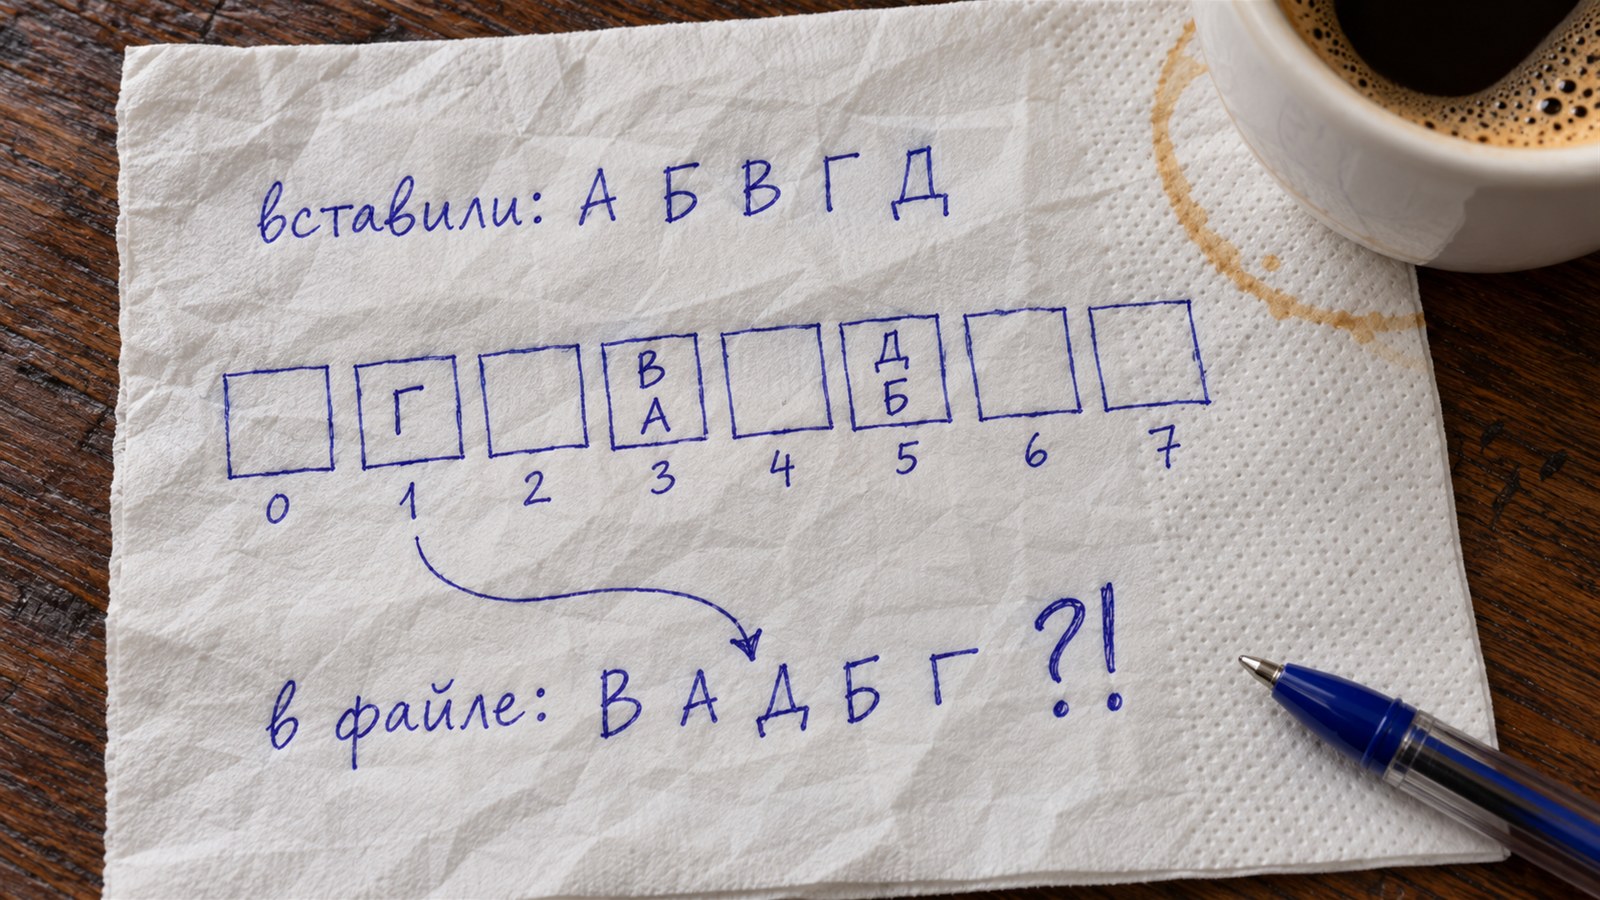
В ходе работы выяснилось, что порядок следования некоторых записей в файле определяется не алфавитом или уникальными идентификаторами, а спецификой обхода стандартной хэш-таблицы из библиотеки MSVC. Порядок элементов зависит от параметров бакетов и хэша строк, поэтому для сохранения совместимости пришлось программно воспроизвести алгоритм чужой хэш-таблицы.
Для корректной работы с динамическими списками в формах потребовалось реализовать собственный синтаксический анализатор запросов. Лексер и грамматика вычисляют имена полей при помощи правил склеивания путей после источника, что заменяет штатный механизм компиляции запросов.
Итоги работы и показатели производительности
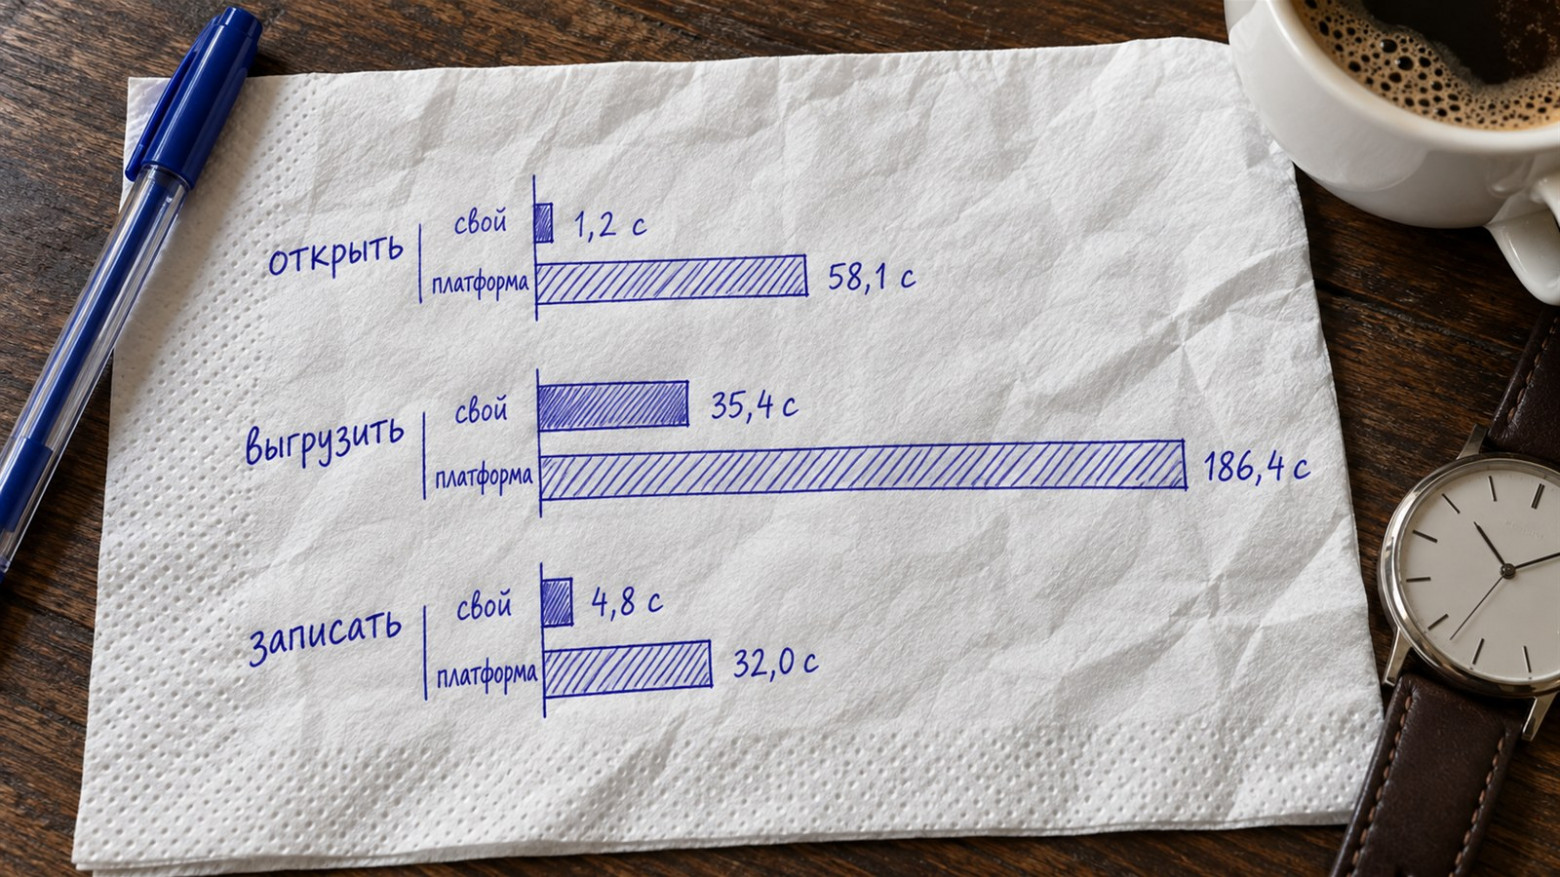
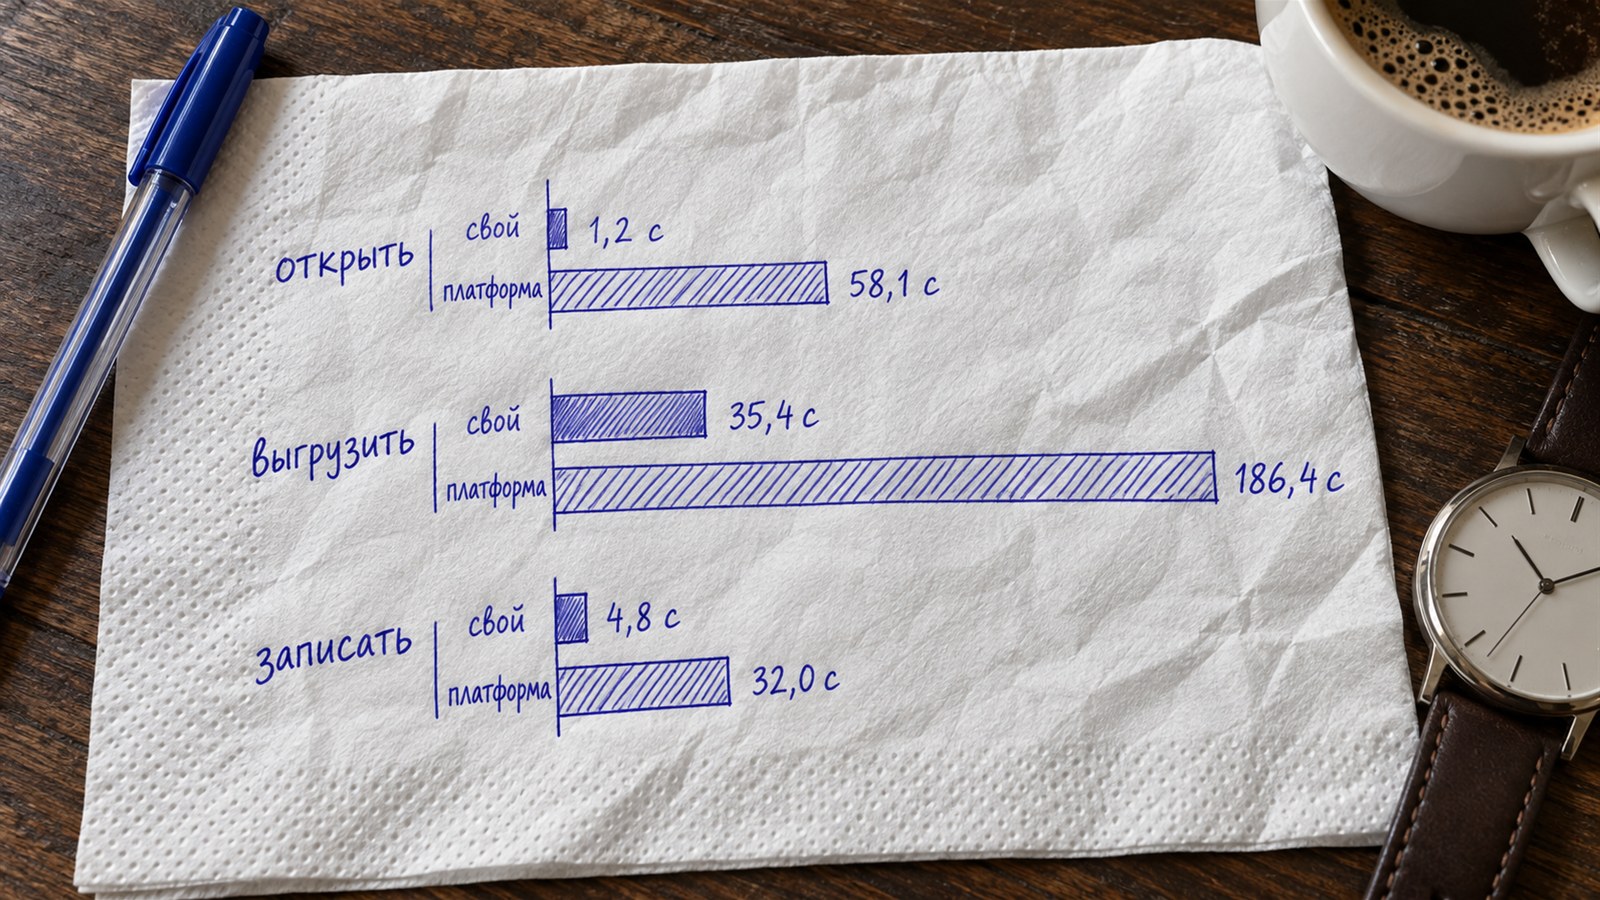
Тестирование самодельного движка на конфигурации объемом около 1 ГБ с десятками тысяч файлов выигрывает по скорости у штатной платформы, которой требуется предварительная загрузка данных в базу данных. Готовый инструмент обеспечивает чтение и запись файлов, работу с деревом свойств и модулей, а также функционирует в режиме командной строки для интеграции с процессами непрерывной интеграции.