
Мой блог
Тестирование альтернатив Claude Code: Codex, Antigravity и OpenCode в деле

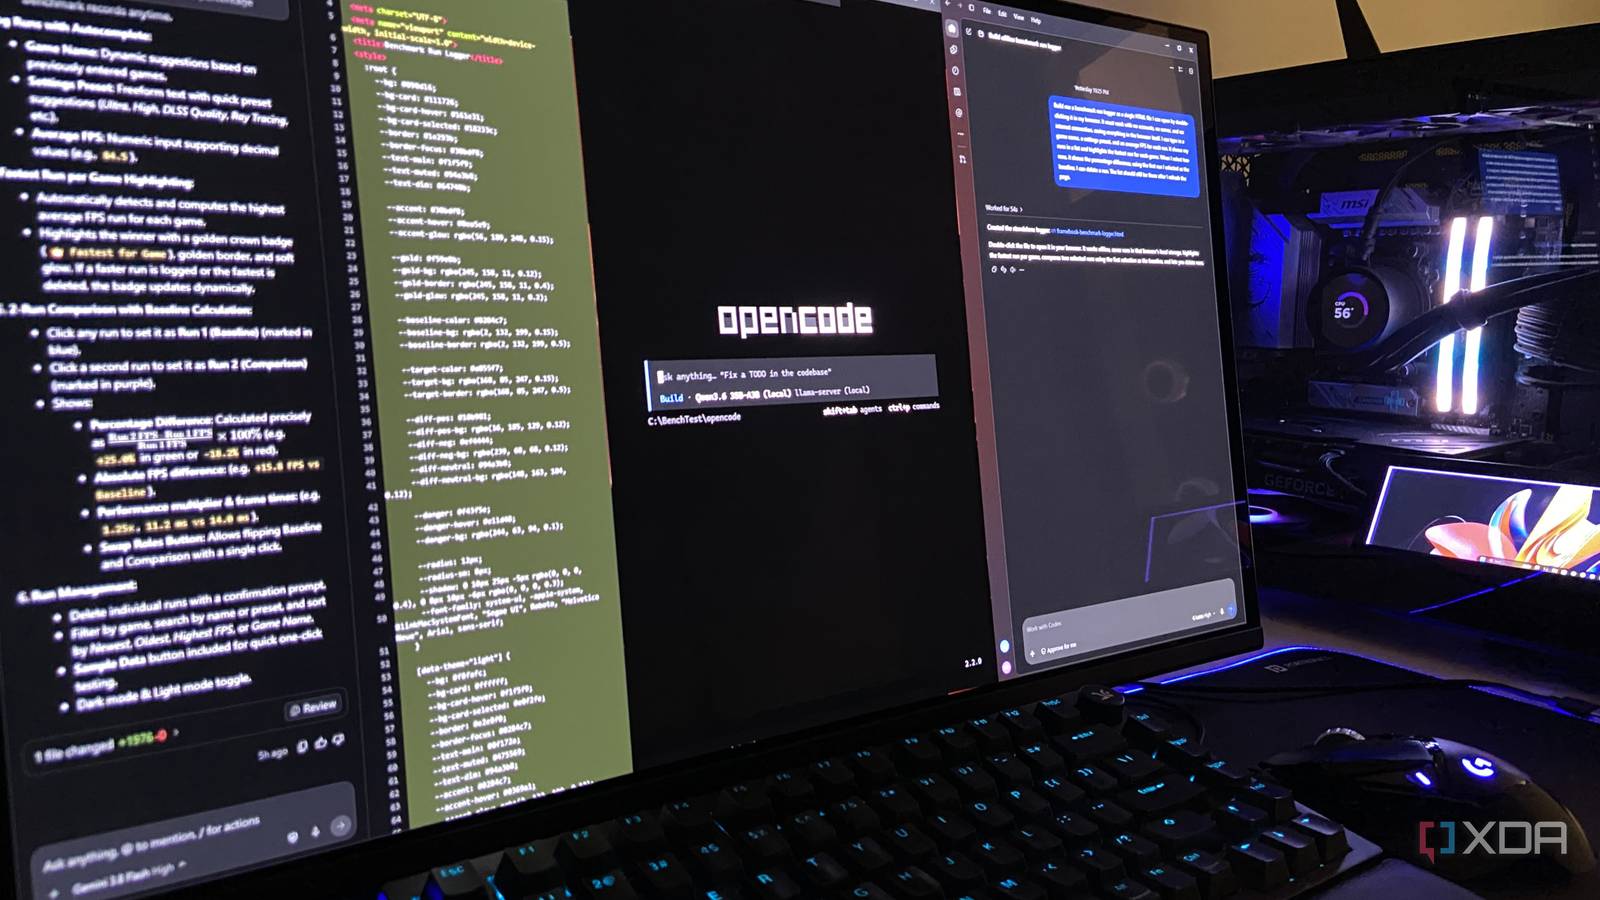
Дискуссии о том, стоит ли переплачивать за подписку на популярные инструменты разработки, ведутся постоянно. Для проверки актуальных альтернатив был проведен практический эксперимент, в рамках которого три известные системы получили реальную задачу по созданию автономной утилиты.
В качестве тестового задания выступала разработка удобного инструмента для ведения и анализа результатов игровых тестов. Полученный опыт позволил оценить производительность бесплатных моделей и локального софта, включая сравнение с базовым стандартом в лице Claude Code.
Постановка задачи и условия тестирования
Поводом для проверки стали многочисленные обсуждения на тематических площадках, где бесплатным агентам приписывают способность полноценно заменять платные решения. Для теста была выбрана типовая задача: создать полностью автономное приложение в виде единого HTML-файла для каталогизации показателей производительности в играх.
К программе предъявлялись четкие требования: работа без серверов, интернета и учетных записей с сохранением информации в браузере. Утилита должна была принимать название проекта, графический пресет и среднюю частоту кадров, формировать список записей, подсвечивать максимальный результат, считать разницу в процентах между двумя выбранными запусками, а также позволять удалять данные с сохранением после обновления страницы.
Ход проверки и критерии оценки
Каждому инструменту отправлялся идентичный промпт в пустой папке без дополнительных правок и наводящих вопросов. Тестирование охватило четыре системы, работающие на разных моделях:
- Codex функционировал на базе GPT-5.6 Terra с высоким уровнем настроек.
- Antigravity задействовал Gemini 3.8 Flash.
- OpenCode работал локально на видеокарте через модель Qwen3.6-35B-A3B.
- Эталонный Claude Code использовал модель Sonnet 5.5.
После завершения генерации полученный код проверялся по шести критериям: возможность фиксации параметров, выделение рекордных прогонов, корректность выбора базы для сравнения, функция удаления записей, сохранение данных в памяти браузера и способность агента самостоятельно тестировать свой код перед передачей.
Результаты работы OpenCode и локального запуска
Локальный запуск модели Qwen через специальный стек на аппаратном обеспечении автора занял минуту и сорок две секунды. Полученный логгер оказался чистым и компактным, успешно справившись с четырьмя критериями из шести.
Тем не менее, в расчетах базового значения обнаружилась ошибка. При выборе первого запуска с показателем 120 кадров в секунду утилита ориентировалась на позицию в списке, а не на порядок кликов, из-за чего в качестве базы ошибочно бралось меньшее значение. Подобные нюансы сложно выявить без детального тестирования под микроскопом.
Особенности Antigravity и визуальное исполнение
Инструмент на базе Gemini 3.8 Flash сформировал наиболее проработанный интерфейс, выделившись среди остальных участников. Процесс генерации занял три минуты, а итоговый файл вырос почти до двух тысяч строк кода.
Утилита предложила автодополнение названий игр и пресетов, добавление поисковой строки, фильтров, сортировки и панели статистики. Кроме того, появилась кнопка смены ролей для быстрого переключения базового значения. Модель самостоятельно провела синтаксический анализ и логические тесты до выдачи результата, хотя и создала избыточный объем кода.
Сравнение Codex с эталонным Claude Code
Модель GPT-5.6 Terra в составе Codex справилась с задачей за две минуты и сорок две секунды, в то время как эталонный вариант от Anthropic потратил на это две минуты и четырнадцать секунд. Обе программы успешно прошли все шесть проверок.
Codex выдал ровно то, что содержалось в исходном запросе, без лишних элементов. HTML-разметка четко обозначила базовую линию, текстовые описания и локальное сохранение информации, а также включила внутреннюю проверку синтаксиса. Главным отличием от эталона стало отсутствие браузерного тестирования со стороны Codex.
Проведенное тестирование показывает, что современные бесплатные модели и альтернативные агенты вплотную приблизились к лидерам рынка в повседневных задачах разработки, существенно сокращая разрыв в возможностях.
