
Мой блог
Как организация заметок в Trilium помогла упорядочить домашний сервер

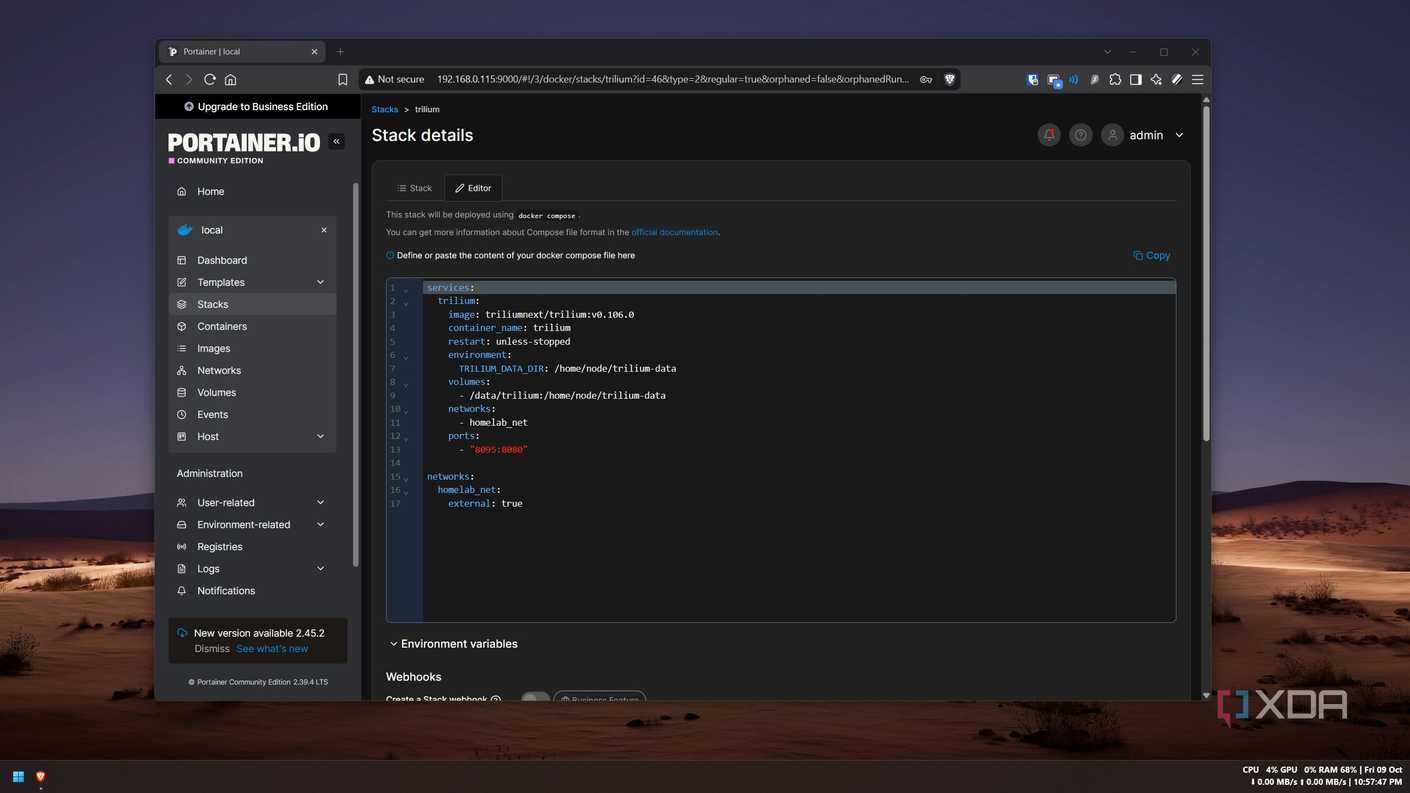
С ростом домашней инфраструктуры объём полезной информации увеличивается настолько, что важные детали конфигурации, порты и адреса сервисов теряются в различных текстовых файлах и диалогах с языковыми моделями. В подобных ситуациях самозаселяемое программное обеспечение для ведения заметок помогает объединить разрозненные данные в единую структурированную базу.
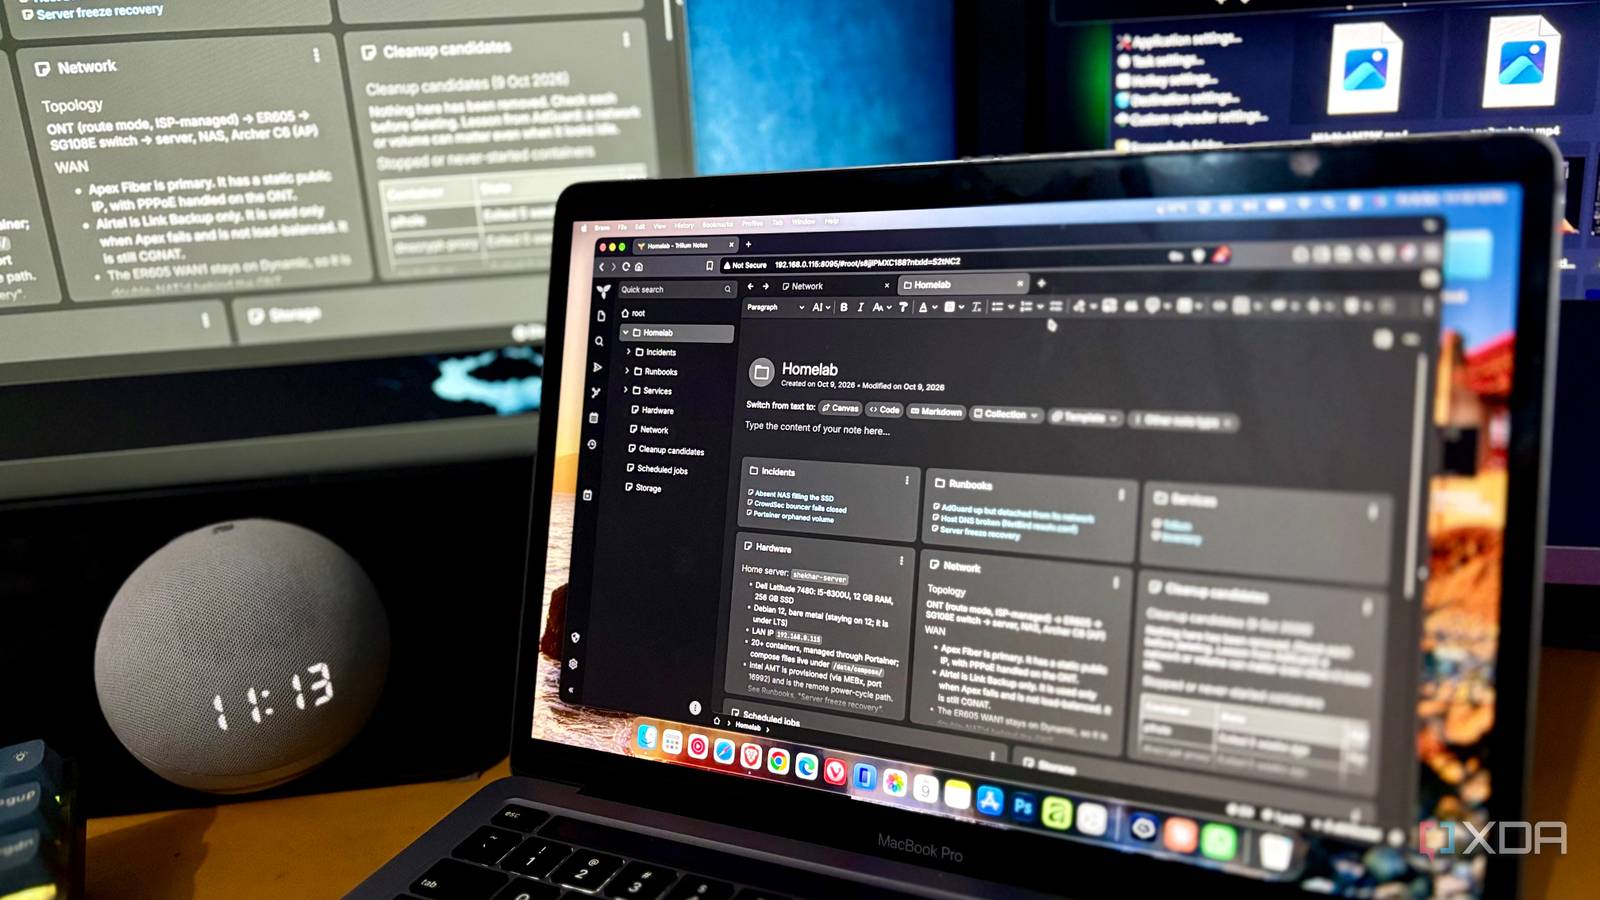
Процесс развёртывания инструментов документирования и переноса разрозненных сведений на базе платформы Trilium позволяет решить проблему поиска актуальной информации при обслуживании сложной инфраструктуры.
Проблема хранения разрозненных записей о домашней инфраструктуре
Со временем парк домашних устройств и виртуальных машин разрастается. Инфраструктура может включать десятки контейнеров Docker, распределенных по нескольким физическим серверам, сетевому оборудованию и удаленным виртуальным серверам. Поддержание такой системы в актуальном состоянии требует регулярного обслуживания, а отдельные сервисы напрямую зависят друг от друга — например, медиасерверы и облачные хранилища завязаны на работу сетевого хранилища NAS.
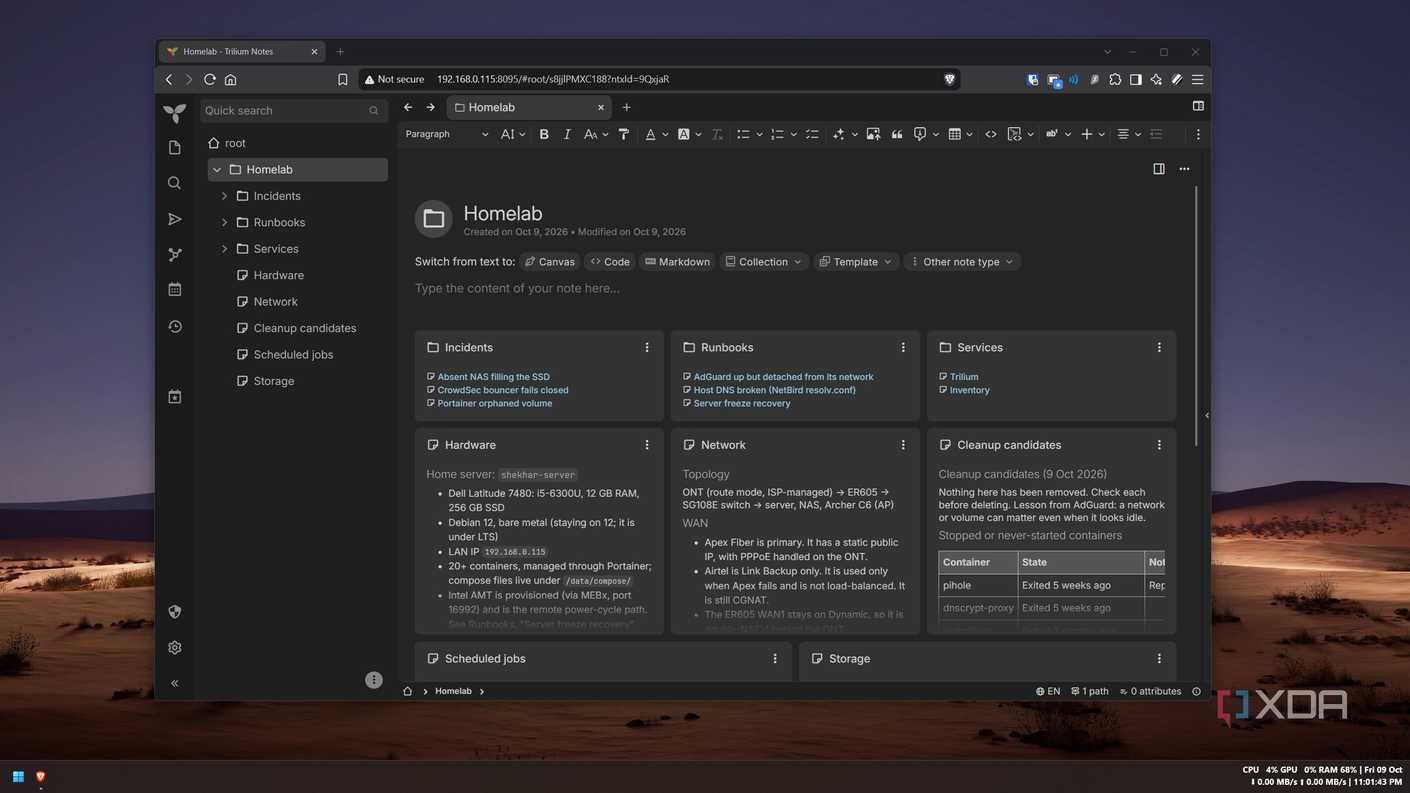
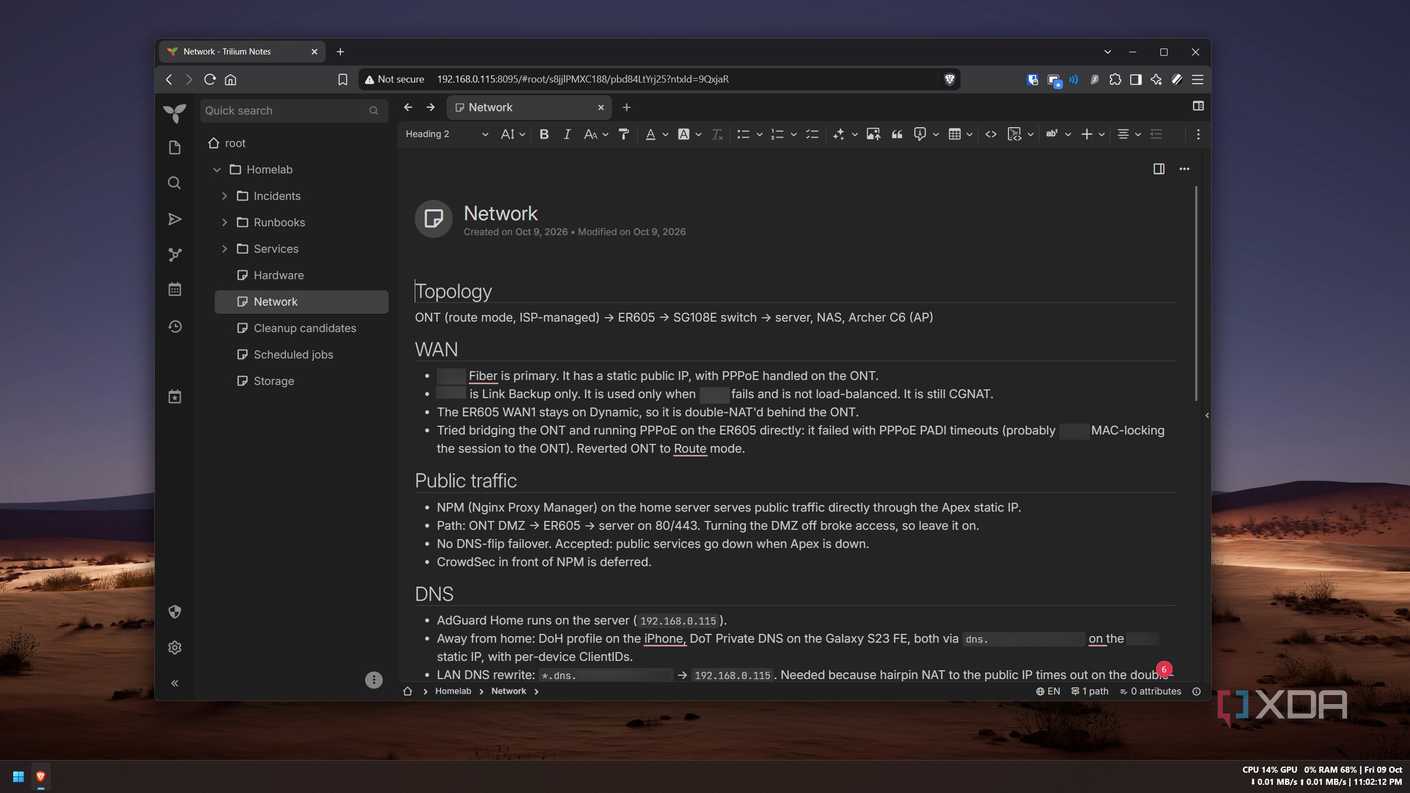
По мере накопления опыта конфигурации, сетевых настроек, ключей доступа и резервных кодов эти данные часто фиксируются случайным образом: в стандартных приложениях для заметок на смартфоне, текстовых файлах или истории чатов с искусственным интеллектом. В результате возникает ситуация, когда вся необходимая информация вроде бы записана, но найти её в момент устранения неполадок оказывается крайне сложно. Использование классических офисных документов или разрозненных локальных файлов не решает проблему централизованного доступа.
Развёртывание платформы Trilium и перенос данных
Поиск подходящего инструмента для централизации данных привёл к выбору платформы Trilium, привлекающей концепцией древовидной структуры записей. Дополнительными преимуществами стали функции синхронизации, поддержка прогрессивных веб-приложений (PWA), история ревизий, защита паролем и встроенный инструмент для веб-клиппинга.
Процесс запуска и наполнения базы состоял из следующих этапов:
- Быстрое развёртывание приложения через Docker и Portainer на домашнем сервере заняло считанные минуты.
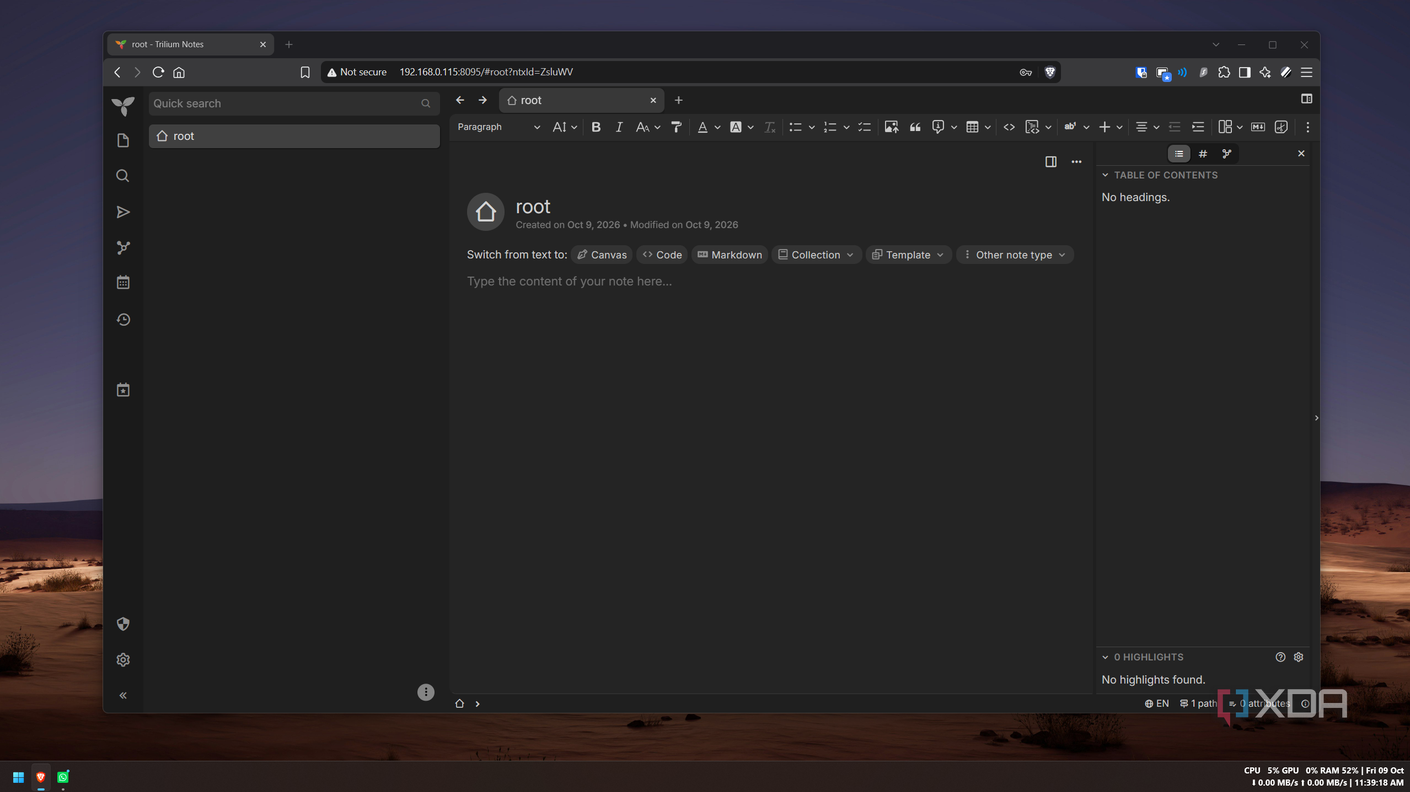
- Первоначально домашняя страница оставалась пустой, так как готовых структурированных документов для импорта не было.
- Для первичной сортировки накопленных нечувствительных данных из текстовых файлов и чатов были задействованы возможности генеративного искусственного интеллекта, что позволило ускорить подготовку материалов к импорту.
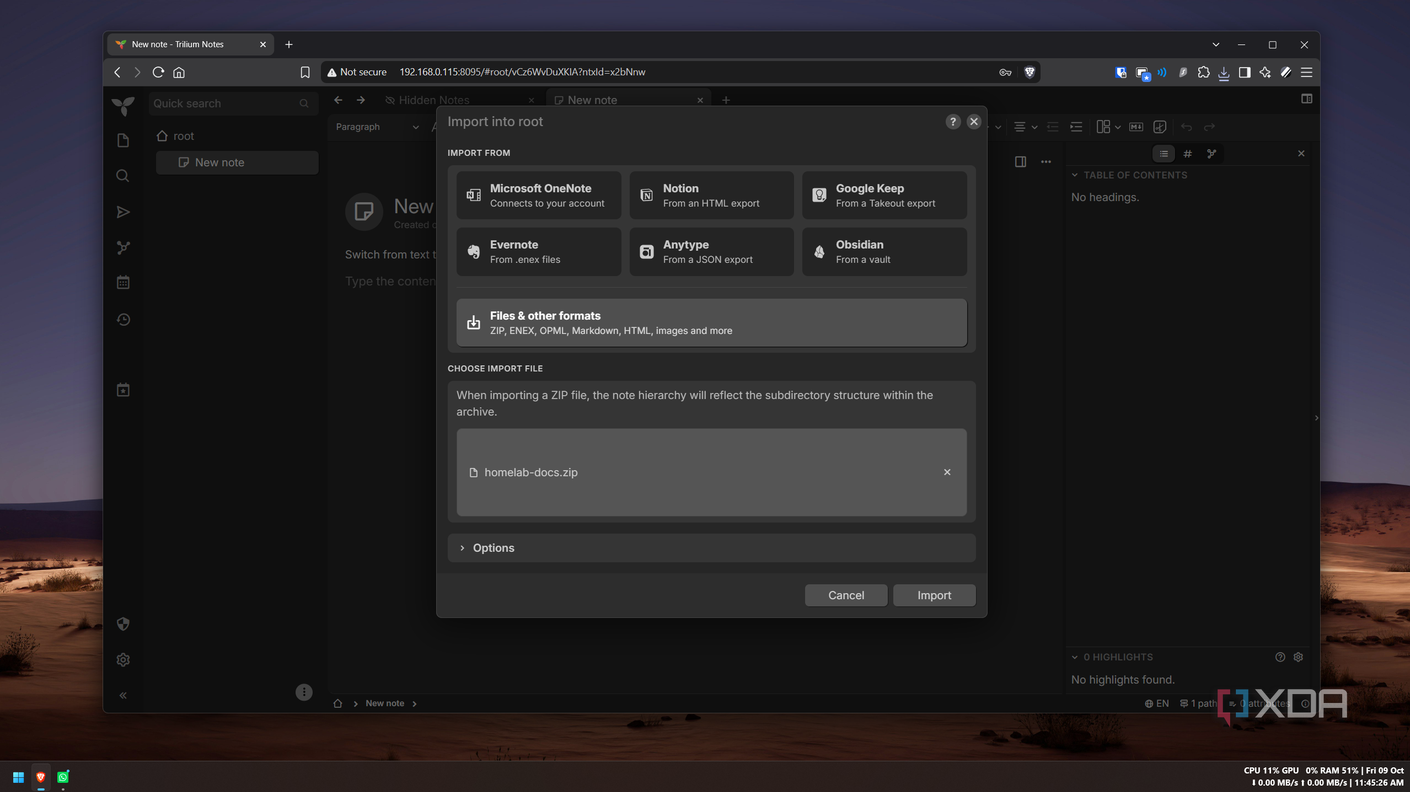
- Полученный массив данных был загружен в структуру заметок Trilium для дальнейшей ручной организации.
Практический опыт использования и выявленные нюансы
Повседневная эксплуатация созданной базы данных показала повышение удобства при обслуживании инфраструктуры. Например, проверка свободных сетевых портов перед развёртыванием нового сервиса стала занимать меньше времени благодаря обращению к инвентарному дереву заметок вместо проверки через командную строку или интерфейс Portainer.
Встроенная поисковая система приложения использует сочетание точного совпадения и нечёткой логики, обеспечивая быстрый поиск по записям. Предпринятая попытка задействовать встроенные функции искусственного интеллекта для поиска ответов по локальным логам с использованием модели через совместимый эндпоинт не дала ожидаемых результатов, так как модель не смогла обнаружить нужную запись по конкретному инциденту.
Главным конструктивным упущением первоначальной настройки оказалось размещение системы документирования непосредственно на том же сервере, работу которого она описывает. В случае полного схода сервера из строя доступ к инструкциям по его восстановлению оказался бы затруднен. Для устранения этого риска требуется вынести резервные копии или саму систему на отдельное хранилище или внешний сервер, учитывая наличие у автора NAS и резервных VPS.
Платформа Trilium представляет собой бесплатное программное обеспечение с открытым исходным кодом для самостоятельного хостинга, ориентированное на создание крупных персональных баз знаний с иерархической структурой.
