
Мой блог
Руководство по TypeSafe AI Jev: структурированные решения и уверенность моделей

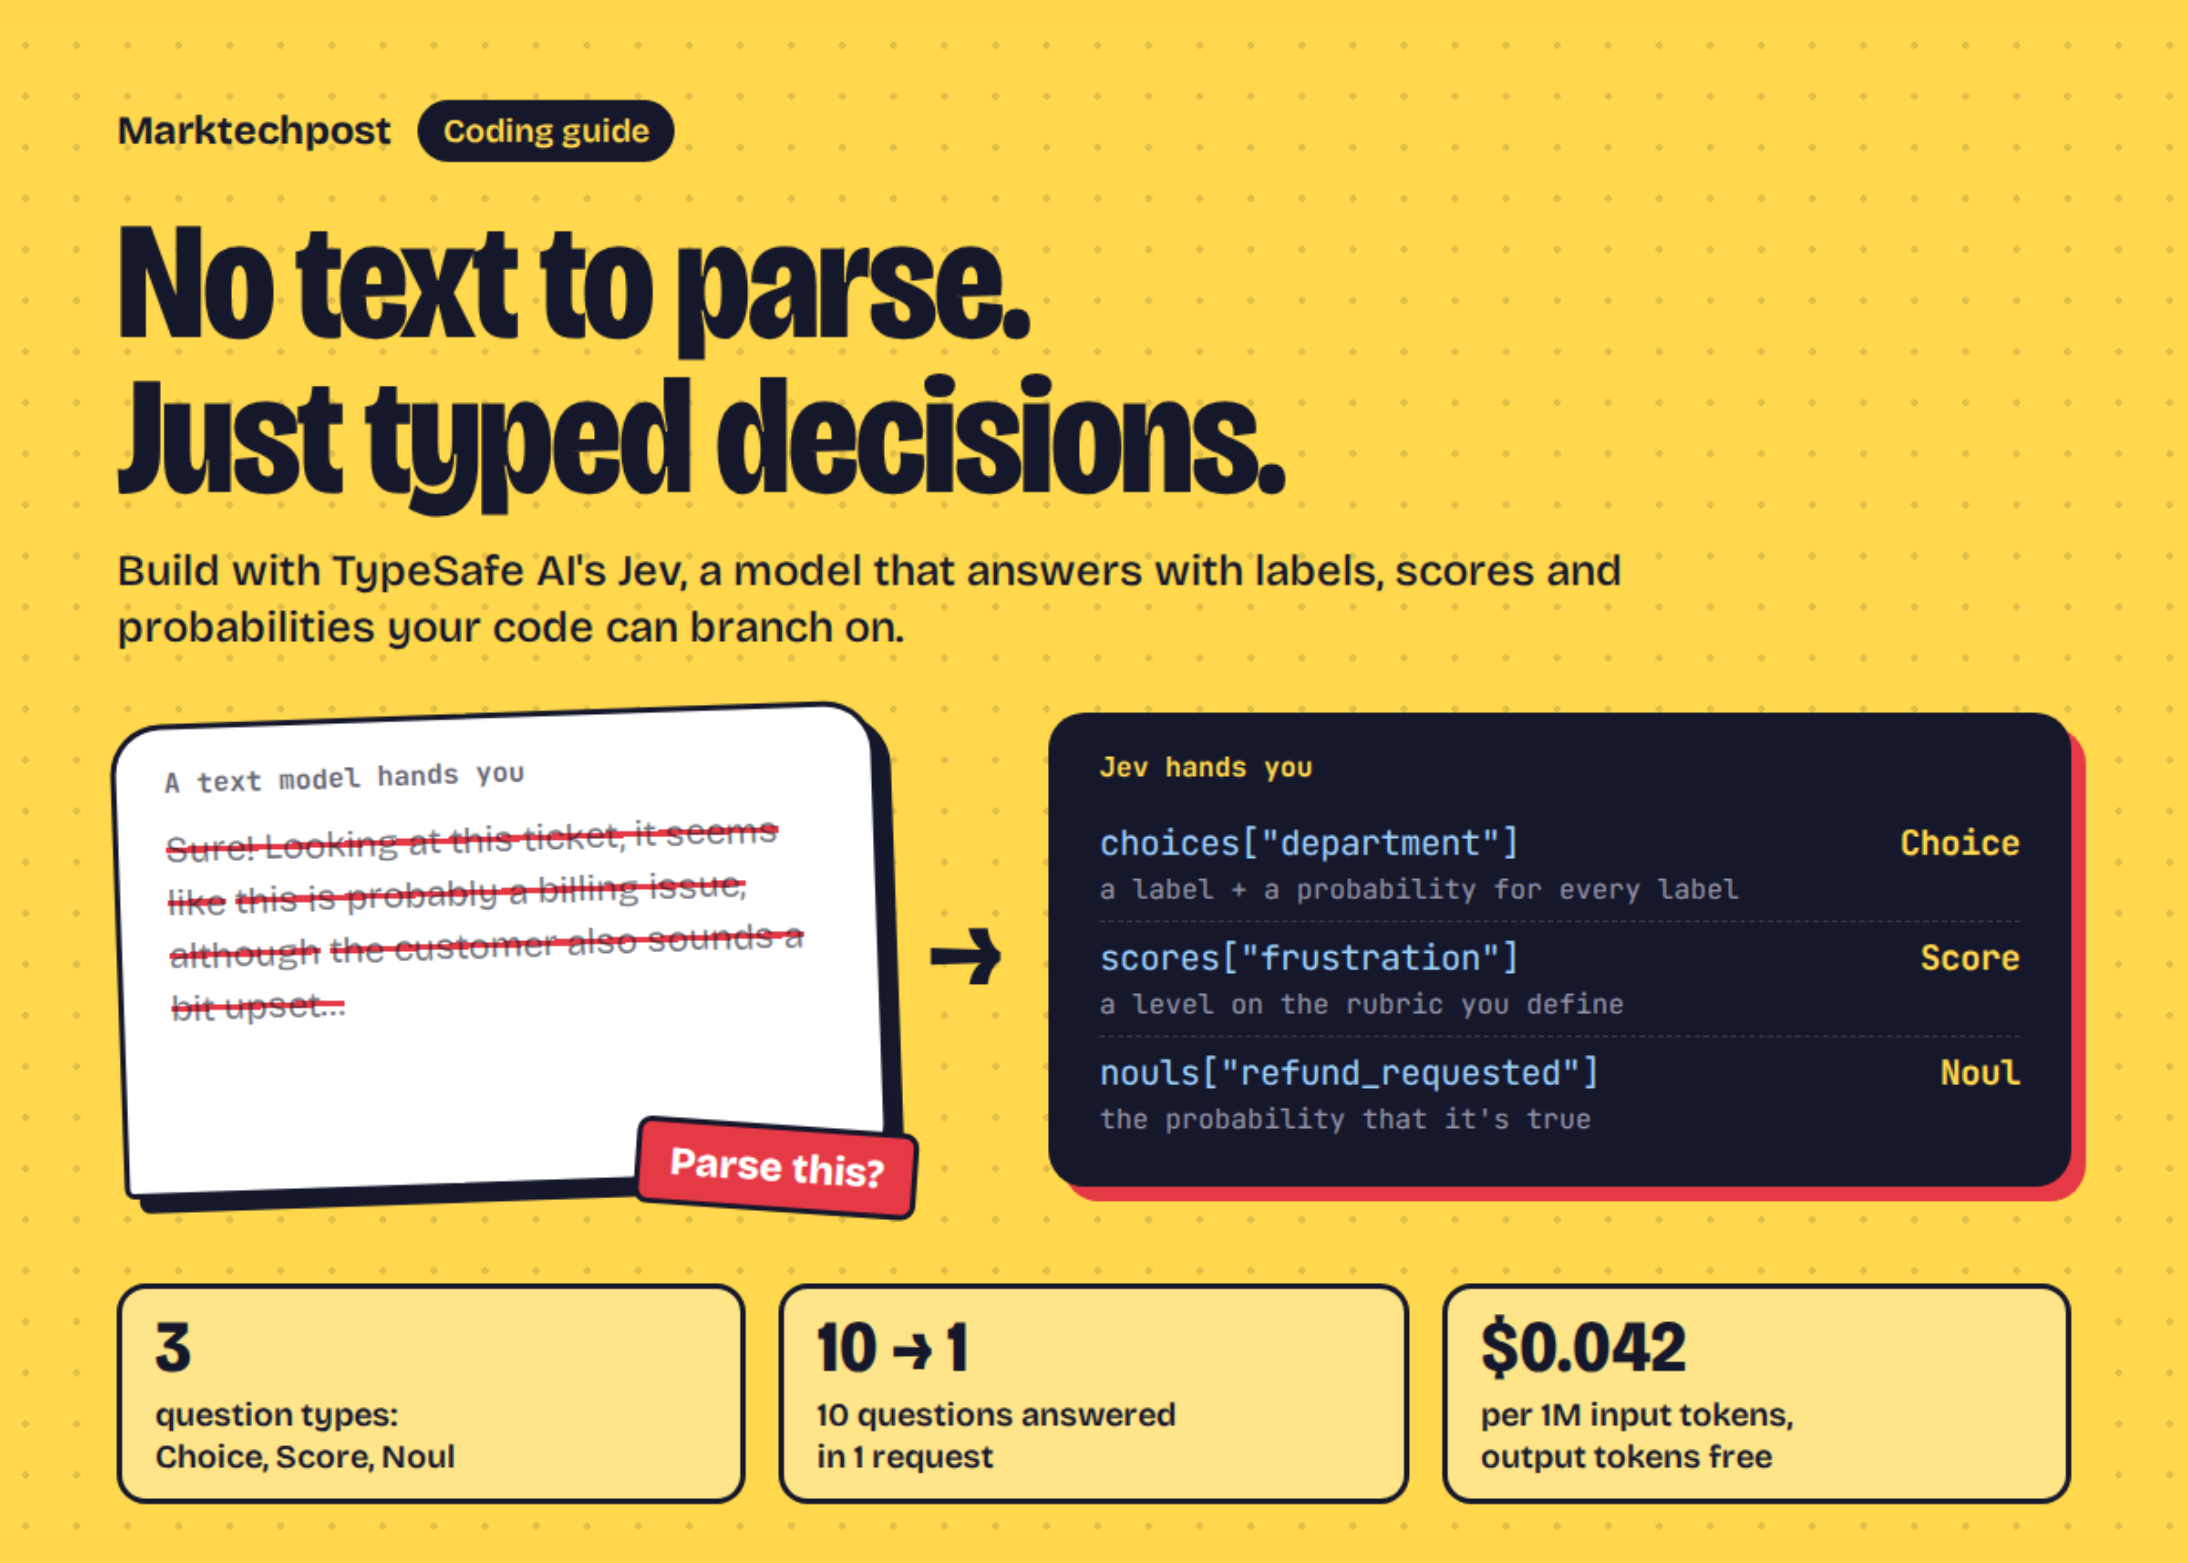
В этом практическом материале я рассматриваю работу с Jev — первой моделью архитектуры System One от TypeSafe AI, которая принципиально не генерирует текстовый контент. Вместо этого мы передаем ей состояние программы и набор типизированных вопросов, получая на выходе точные категории, баллы и вероятности для ветвления кода. С подробностями можно ознакомиться в первоисточнике A Coding Guide, а я покажу ключевые сценарии применения.
Мы инсталлируем официальный пакет Python SDK, настраиваем ключи доступа из переменных окружения или интерфейса Colab и запускаем первый комплексный запрос. Модель возвращает структурированные метрики, которые позволяют строить надежные конвейеры обработки данных без парсинга сырого текста.
Три примитива в одном вызове: Choice, Score и Noul
Архитектура System One обрабатывает два основных элемента: состояние (текст, JSON-объект или массив, описывающий ситуацию) и словарь именованных вопросов. Примитив Choice выбирает одну метку из заданных критериев и возвращает вероятности для каждого варианта. Score оценивает состояние по упорядоченной шкале, возвращая взвешенный уровень, а Noul вычисляет единственную вероятность истинности утверждения.
Имена вопросов задаются разработчиком и не передаются модели напрямую — всю смысловую нагрузку несут инструкции, которые могут ссылаться на вложенные поля через пути с обратными апострофами. Все вопросы обрабатываются параллельно и изолированно друг от друга в рамках одного запроса, а в ответах фиксируется версия модели и объем потребленных токенов.
Влияние структуры состояния на результат
Поскольку модель опирается исключительно переданное состояние, изменение формата входных данных напрямую влияет на информированность. Я протестировал один и тот же вопрос о праве клиента на возврат средств на трех разных типах состояния:
- Простая строка, содержащая только текст жалобы.
- Массив строк с историей переписки.
- Полноценный JSON-объект, включающий данные заказа, историю списаний и текст политики возврата.
Результаты показали, что только структурированный объект предоставляет достаточный контекст для корректной оценки. Использование именованных полей является лучшей практикой, так как инструкции могут явно адресовать конкретные параметры.
Калибровка уверенности и математика распределения
TypeSafe документирует уверенность (confidence) как статистический показатель, вычисляемый на основе распределения вероятностей: количество опций умножается на пиковую вероятность, из полученного значения вычитается единица, после чего результат делится на количество опций минус один. Я пересчитываю этот показатель из вероятностей для Choice и сопоставляю его с расчетным баллом для Score.
Использование неоднозначных формулировок в сообщениях позволяет наглядно увидеть, как меняется энтропия распределения и падает уверенность системы. Примитив Noul не содержит отдельного поля уверенности, поскольку его значение само по себе является вероятностью утвердительного ответа, где цифра 0.5 означает неопределенность.
Спекулятивный веерный опрос: пакетные запросы
Поскольку вопросы внутри одного запроса не зависят друг от друга и не «видят» ответы соседей, мы можем запрашивать всю необходимую информацию единым пакетом, включая те параметры, которые понадобятся только на определенной ветке логики. Я объединил десять вопросов, касающихся постмортема инцидента, в один вызов, а затем выполнил их последовательно для сравнения.
Передача состояния один раз вместо десяти существенно снижает задержку сети и экономит токены. Проверка согласованности подтверждает, что вопросы дают идентичные результаты независимо от того, отправляются они в одиночку или в составе общего пакета.
Маршрутизация с учетом порога уверенности
Типизированные ответы имеют практическую ценность только тогда, когда окружающий код регулирует требования к степени уверенности для выполнения действий. Я классифицирую входящие сообщения банковского ассистента по намерениям и применяю плавающий порог уверенности:
- Проверка баланса требует минимального порога в 0.50.
- Оспаривание транзакции повышает планку до 0.70.
- Одобрение переводов требует уверенности не менее 0.85.
- Закрытие счета активирует самый строгий порог в 0.90.
Сообщения с низкой уверенностью или неясным намерением направляются на оператора поддержки. Пороги задаются в виде обычных переменных Python, что упрощает их версионирование и тестирование.
Композитная оценка: атомарные суждения и веса в коде
Для оценки кандидатов на вакансии я разделил задачу на четыре независимые метрики с помощью Score, нормализовав каждый балл относительно максимального значения. Итоговый рейтинг вычисляется с помощью весовых коэффициентов, разделенных для разных ролей — например, для старшего инженера и тимлида.
Поскольку модель выполняет только атомарную оценку, а логика весов хранится в коде приложения, изменение приоритетов компании позволяет мгновенно пересчитать рейтинг кандидатов без повторного запуска инференса.
Типизированные вызовы функций
Вызовы инструментов реализуются как набор вопросов с закрытым множеством вариантов. Специальный выбор Choice определяет целевое устройство или функцию, включая опцию none для неподдерживаемых команд, а аргументы запрашиваются спекулятивно в том же вызове.
Приложение считывает параметры только для выбранного инструмента, проверяет наименьший показатель уверенности и передает данные в нативную функцию Python. Для задач подсчета, с которыми модель справляется хуже, мы используем массив примитивов Noul на каждый элемент с последующим суммированием в коде.
Продакшен-архитектура: Pydantic, асинхронность и обработка ошибок
Для превращения скрипта в полноценный сервис я использую наследование от SystemOneResponse, что обеспечивает строгую валидацию через Pydantic и доступ к полям через атрибуты вместо словарей. Асинхронный клиент AsyncTypeSafeClient совместно с asyncio.gather позволяет обрабатывать очереди запросов параллельно.
Политика повторных попыток RetryPolicy контролирует тайм-ауты и ограничения бэк-оффа, а типизированные исключения (такие как TypeSafeError или TypeSafeAPIError) перехватывают некорректные конфигурации и ошибки API еще до отправки сетевых пакетов.
