Мой блог
Внешняя память для ИИ-агента: как сохранить опыт нейросети за пределами чата

Современные большие языковые модели обладают внушительными возможностями, но их «оперативная память» ограничена размером контекстного окна. При длительных рабочих сессиях данные неизбежно подвергаются сжатию или удалению, что приводит к потере важных деталей и снижению качества ответов. Использование внешней памяти для ИИ-агента через специализированные протоколы позволяет решить эту проблему, сохраняя структурированный опыт в независимом хранилище.
Проект MemShelf, рассматриваемый в материале, предлагает архитектуру «полки опыта», где вместо разрозненных логов хранятся завершенные эпизоды деятельности. Такой подход позволяет ИИ не просто хранить историю переписки, а фиксировать принятые решения, отвергнутые альтернативы и текущий статус задач в формате, доступном для различных моделей и инструментов.
От управления документами к хранилищу опыта
Концепция MemShelf выросла из идеи DocShelf — системы, которая индексирует локальные PDF-файлы и позволяет нейросети подтягивать только нужные фрагменты текста. Однако MemShelf фокусируется не на внешних документах, а на собственных действиях агента. Единицей хранения здесь выступает «эпизод» — детальный отчет о конкретной рабочей сессии или решении задачи.
В отличие от классических журналов разработки (work logs), которые обычно привязаны к коммитам в коде, эпизод на полке описывает весь контекст работы: какие варианты рассматривались, почему они были отклонены, какие ошибки возникли в процессе и что еще предстоит сделать. Источниками для формирования такой памяти могут выступать:
- Итоги многочасовых смен автономных агентов Claude Code.
- Решения по архитектуре и протоколам, которые должны сохраняться между разными сессиями.
- Отчеты об инцидентах в домашней лаборатории или серверной инфраструктуре.
- Результаты экспериментов с четко зафиксированными ожиданиями и фактическими цифрами.
- Обратная связь от пользователей или студентов, накапливаемая для будущих обновлений.
На практике такая система позволяет нейросети начинать новую сессию не с чистого листа, а с изучения индекса накопленного опыта, что значительно повышает преемственность действий.
Проблемы автоматического сжатия контекста
Основная причина выноса памяти за пределы чата заключается в механизме работы контекстного окна. Когда объем беседы превышает лимит (например, 200–500 тысяч токенов), алгоритмы провайдера запускают автоматическое сжатие. Система сама решает, какие части истории важны, а какие можно отбросить, при этом пользователь никак не может повлиять на этот процесс.
В материале отмечается, что после глубокого сжатия модели часто начинают «тупить», забывая собственные выводы, сделанные часом ранее. Уменьшение окна для экономии лишь ускоряет этот процесс. Кроме того, значительная часть контекста всегда занята системными инструкциями, описаниями инструментов и MCP-серверов — в среднем это около 38 тысяч токенов, которые расходуются еще до первого сообщения пользователя.
MemShelf перехватывает инициативу у алгоритмов сжатия. Вместо того чтобы полагаться на случайное выживание данных в памяти LLM, автор предлагает фиксировать ключевые итоги сессии вручную или полуавтоматически, отправляя их на постоянное хранение. В новом чате агент не гадает, что произошло раньше, а целенаправленно запрашивает нужный эпизод по индексу.
Алгоритм фиксации данных на полке
Рабочий цикл системы MemShelf построен на использовании Markdown-файлов в Git-репозитории. Когда задача завершена, агент формирует эпизод, инструмент проверяет его на соответствие правилам и сохраняет. В последующих сессиях доступ к данным осуществляется через MCP-сервер.
Структура эпизода и индексация
Каждый файл эпизода содержит YAML-заголовок с метаданными (ID, тип, теги, объем исходной сессии) и несколько обязательных секций: дайджест, принятые решения, открытые вопросы и источники. Важнейшим элементом является дайджест — краткое описание сути эпизода объемом не более 120 слов. Если дайджест не содержит ключевых слов (например, «решено» или «отклонено»), система валидации его отклонит.
В контекст нейросети попадает не вся база данных, а только файл INDEX.md, где каждый эпизод представлен одной строкой. Это позволяет агенту видеть всю карту своего опыта, не перегружая память деталями. За полным текстом записи модель обращается только в том случае, если информация из дайджеста кажется ей релевантной текущему запросу.
Роли человека и инструментов
Процесс разделен на автоматизированные и ручные этапы:
- Агент: распознает завершение темы, пишет черновик эпизода и запрашивает чтение индекса.
- Инструментарий (Memshelf): проверяет контракты дайджестов, вычищает конфиденциальные данные (ключи, имена) по заданным паттернам и обновляет статистику.
- Человек: принимает окончательное решение о закрытии темы, проверяет корректность дайджеста перед коммитом и проводит периодическую архивацию старых записей.
- Бот (GitHub Actions): автоматически перерисовывает индекс и файлы учета после внесения новых данных.
Преимущества структурированной внешней памяти
Помимо защиты от потери данных, MemShelf предоставляет ряд функциональных преимуществ, недоступных при обычном использовании облачных чатов.
Контроль качества памяти
Поскольку данные хранятся в Git, в процесс записи можно встроить любые проверки (CI/CD). Это полезно при накоплении базы знаний, например, из отзывов студентов. Перед тем как попасть в постоянную память, информация проходит через фильтр, удаляющий персональные данные или исправляющий ошибки. Таким образом, база знаний остается чистой и структурированной.
Независимость от вендора
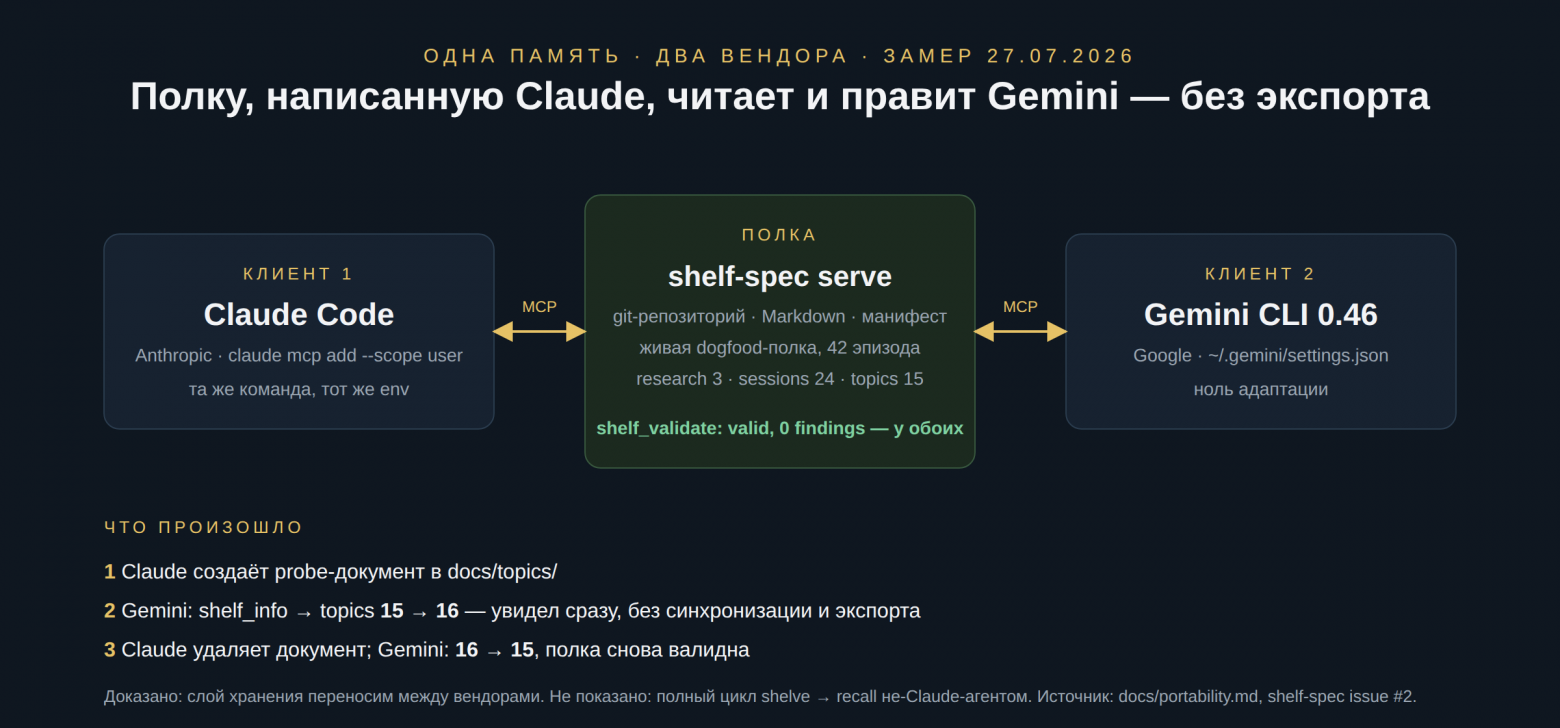
Каноническая копия памяти хранится локально в открытом формате. В материале приводится пример, когда к одной и той же полке опыта одновременно подключались модели от разных компаний — Claude и Gemini. Обе модели одинаково успешно читали индекс, видели изменения, внесенные конкурентом, и могли использовать общий контекст без какой-либо дополнительной адаптации.
Память как доказательная база
Записи на полке, снабженные датами и историей изменений в Git, превращаются в надежный протокол работы. Это позволяет проводить расследования: в какой момент было принято неверное решение, на какие данные опирался агент и какие альтернативы были отброшены по ошибке.
Оптимизация и масштабирование системы
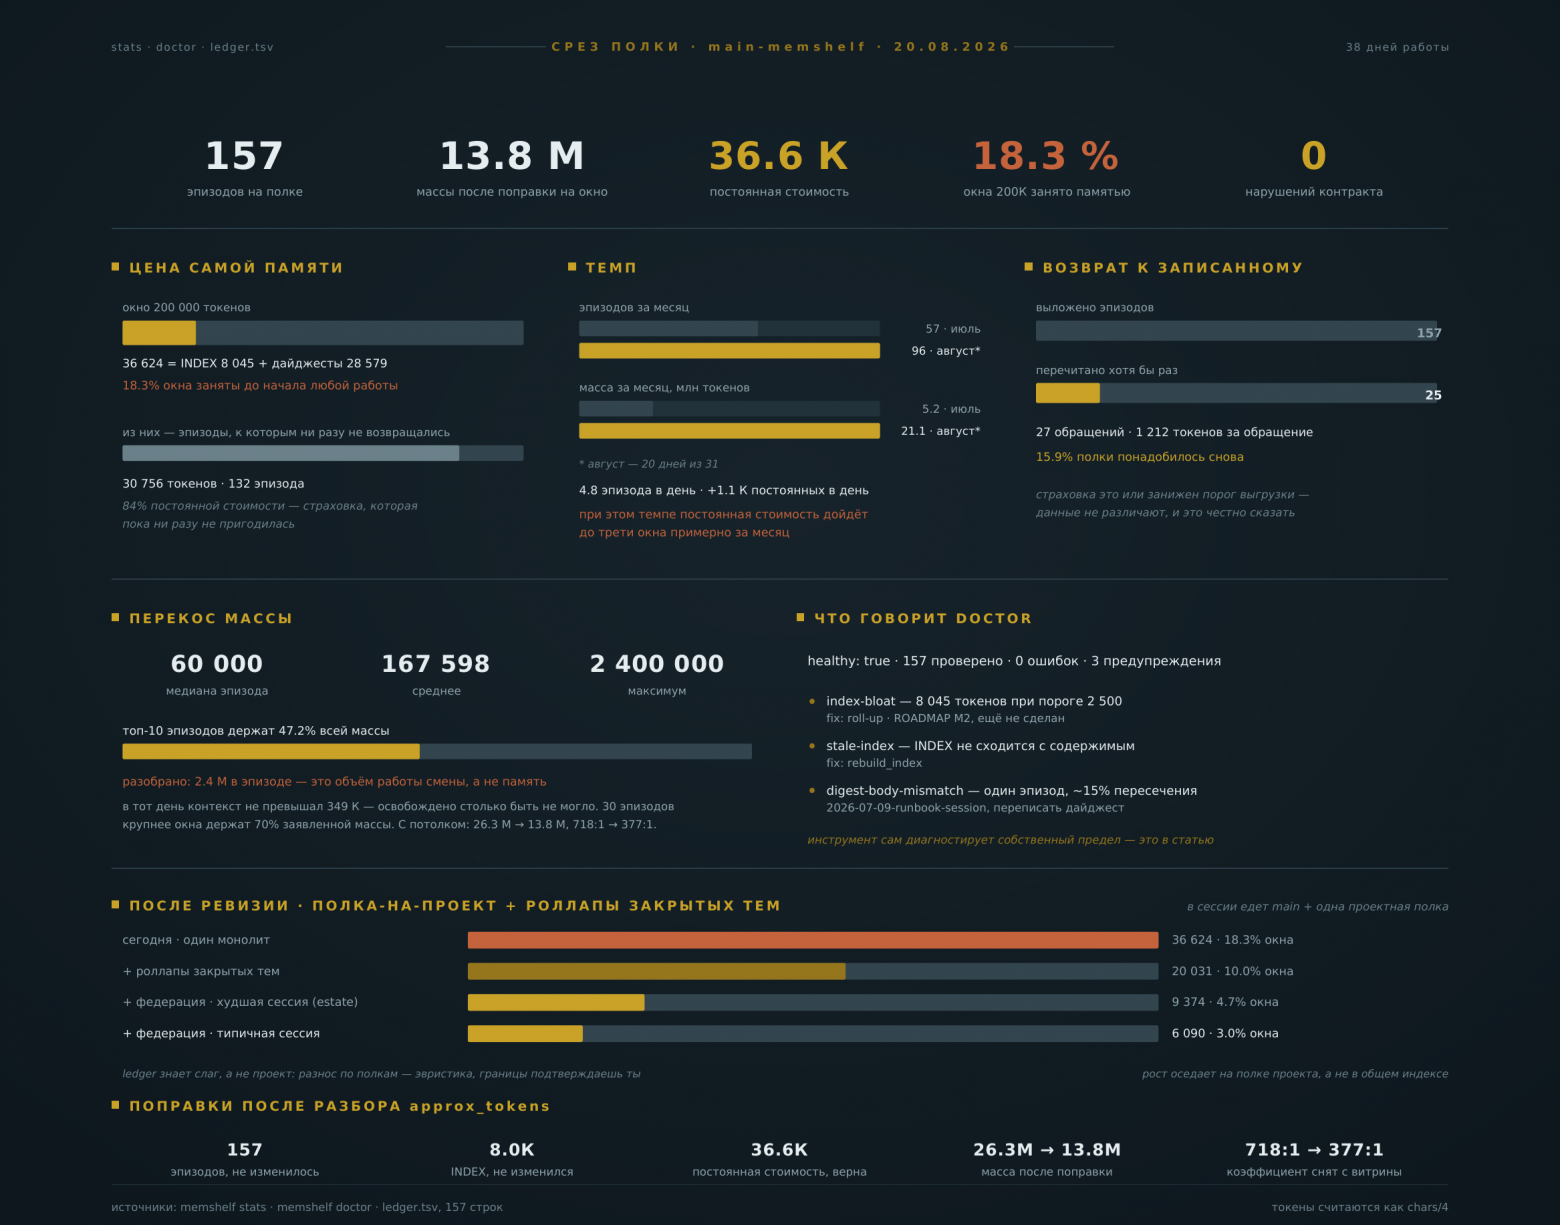
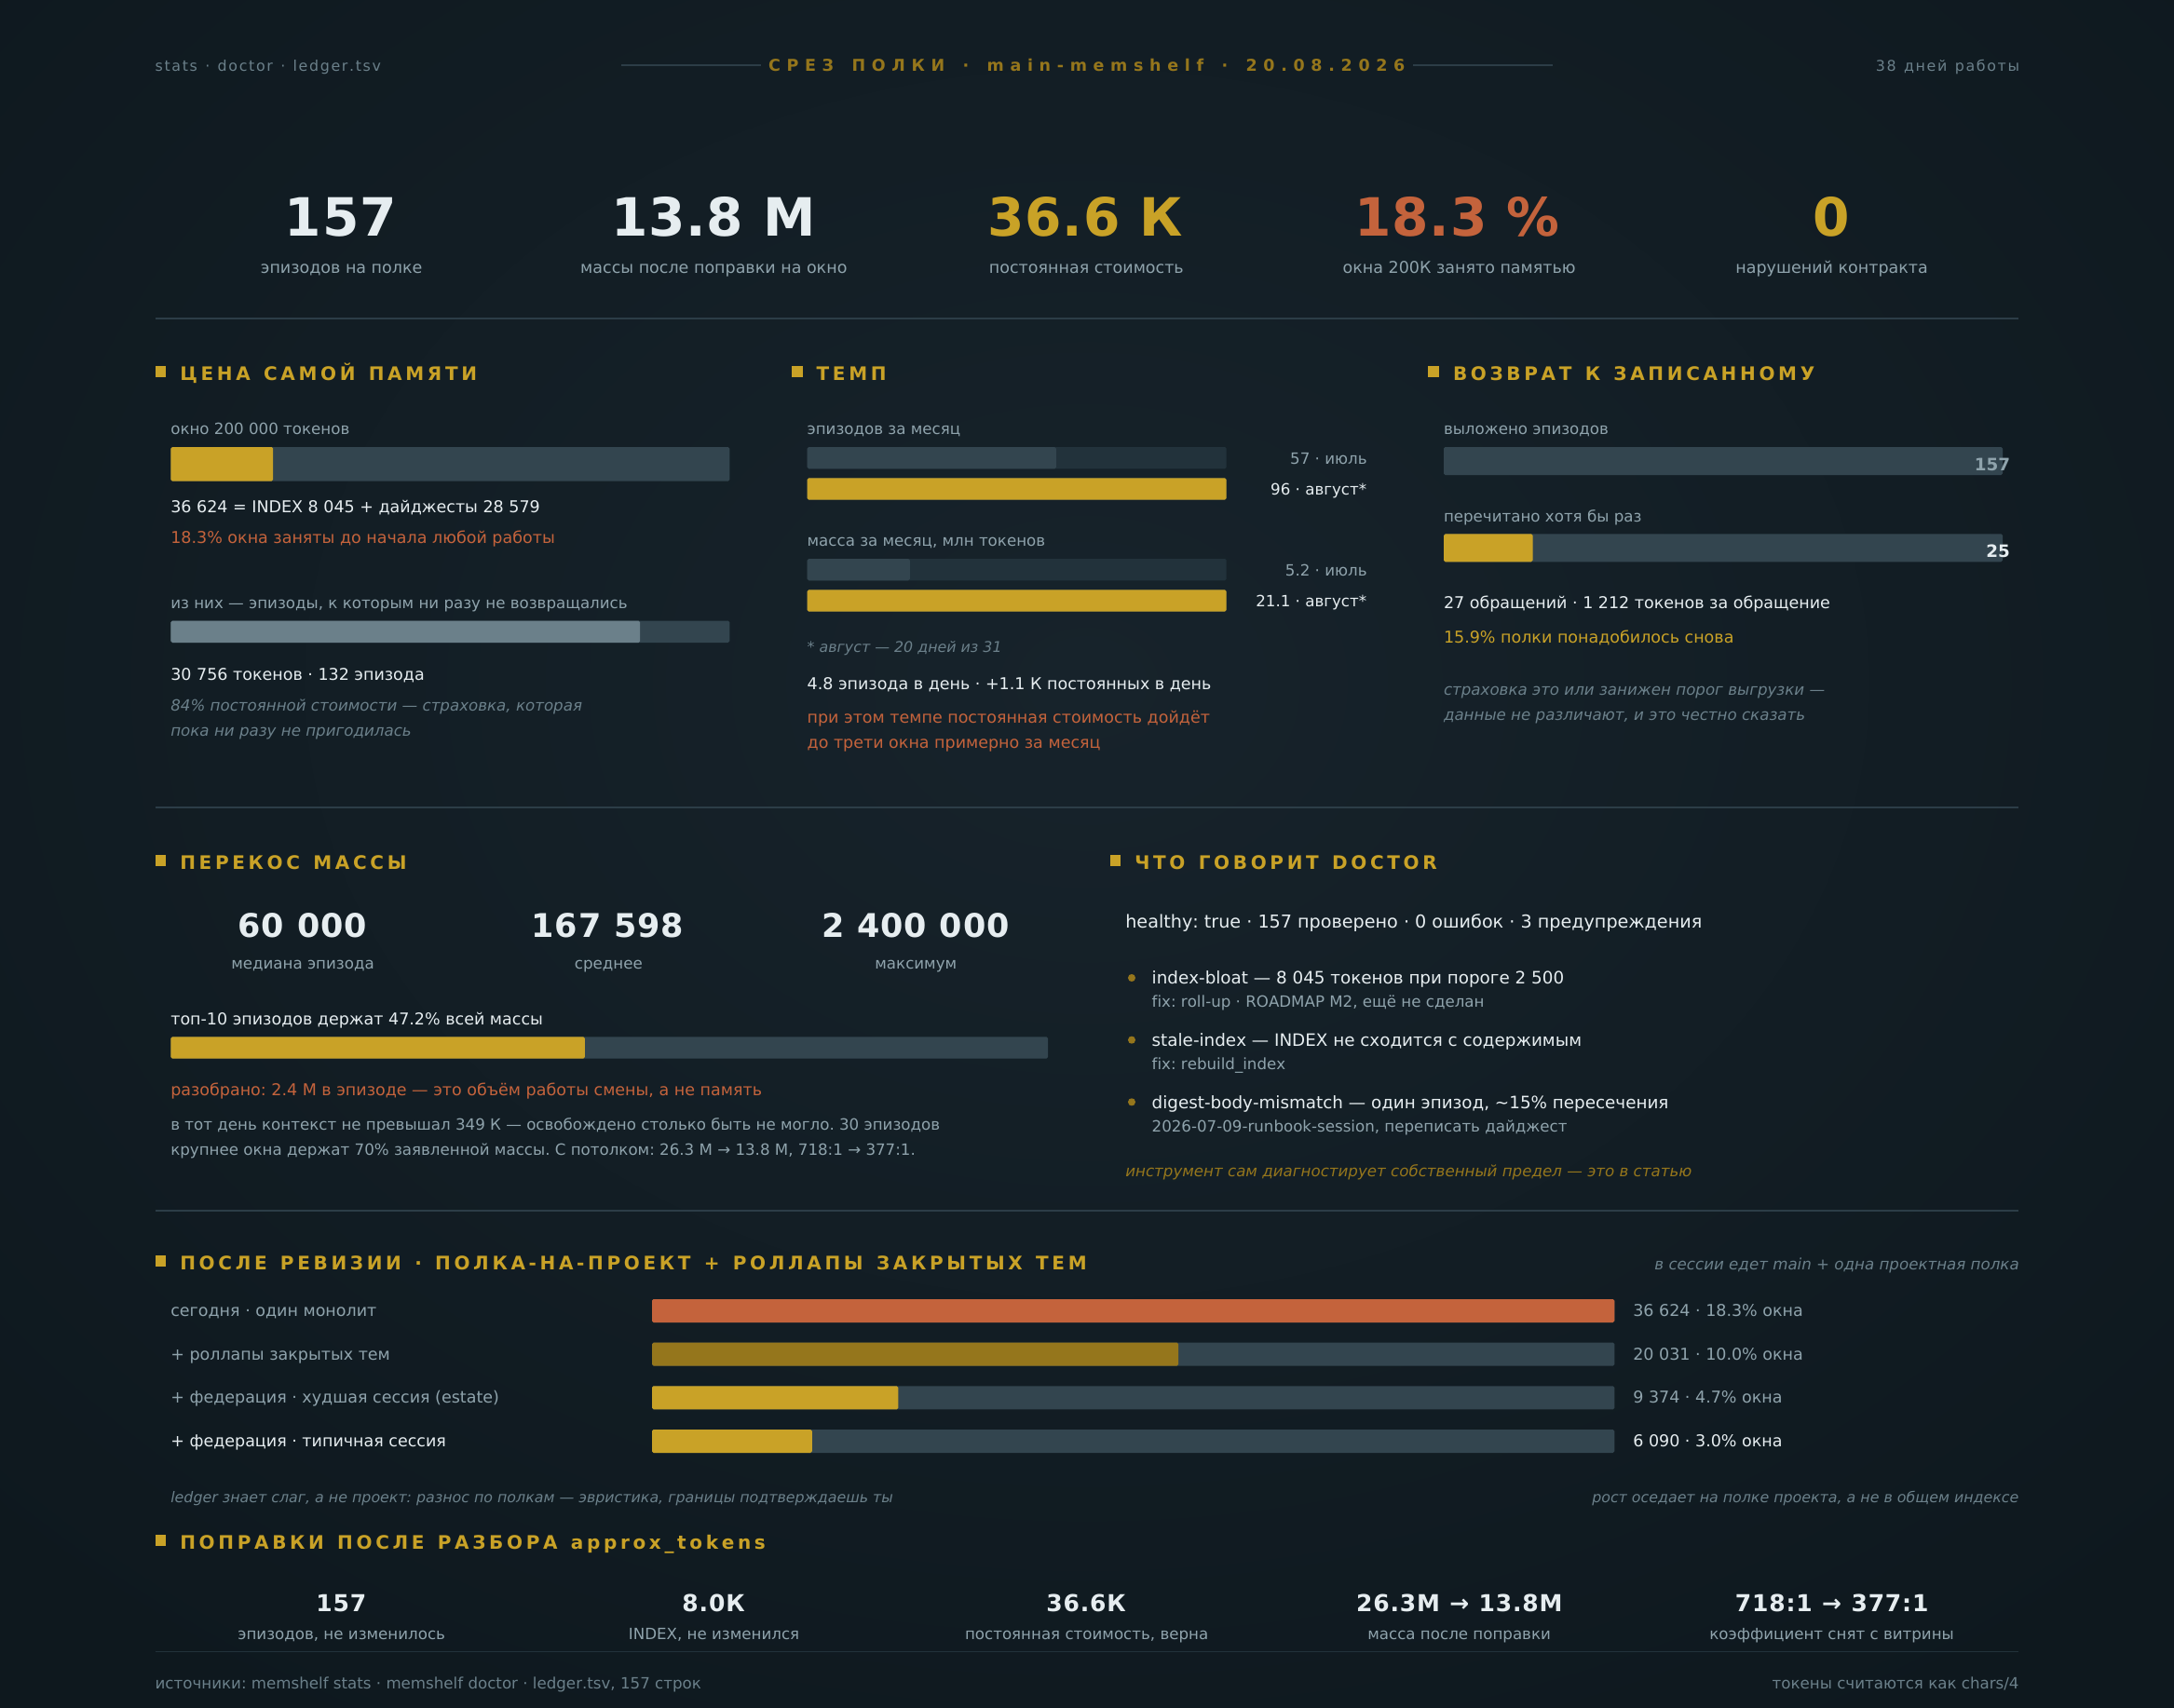
По мере роста количества эпизодов возникают новые вызовы. На 38-й день эксперимента на полке накопилось 157 записей, и только их оглавление начало занимать около 8 тысяч токенов. С учетом дайджестов постоянная стоимость памяти составила почти пятую часть рабочего окна модели.
Для решения проблемы масштабирования были внедрены следующие меры:
- Разделение полок: выделение общей полки для глобальных решений и приватных полок для конкретных проектов. В сессию загружается только нужный проектный индекс, что сокращает расход токенов в несколько раз.
- Механизм Rollup: объединение нескольких старых эпизодов в один сводный отчет с переносом оригиналов в архив.
- Автоматический аудит (memshelf_doctor): специальный инструмент следит за целостностью базы, проверяет длину дайджестов, ищет случайно попавшие секретные ключи и следит за бюджетом токенов для каждой строки индекса.
Экономическая эффективность и расход токенов
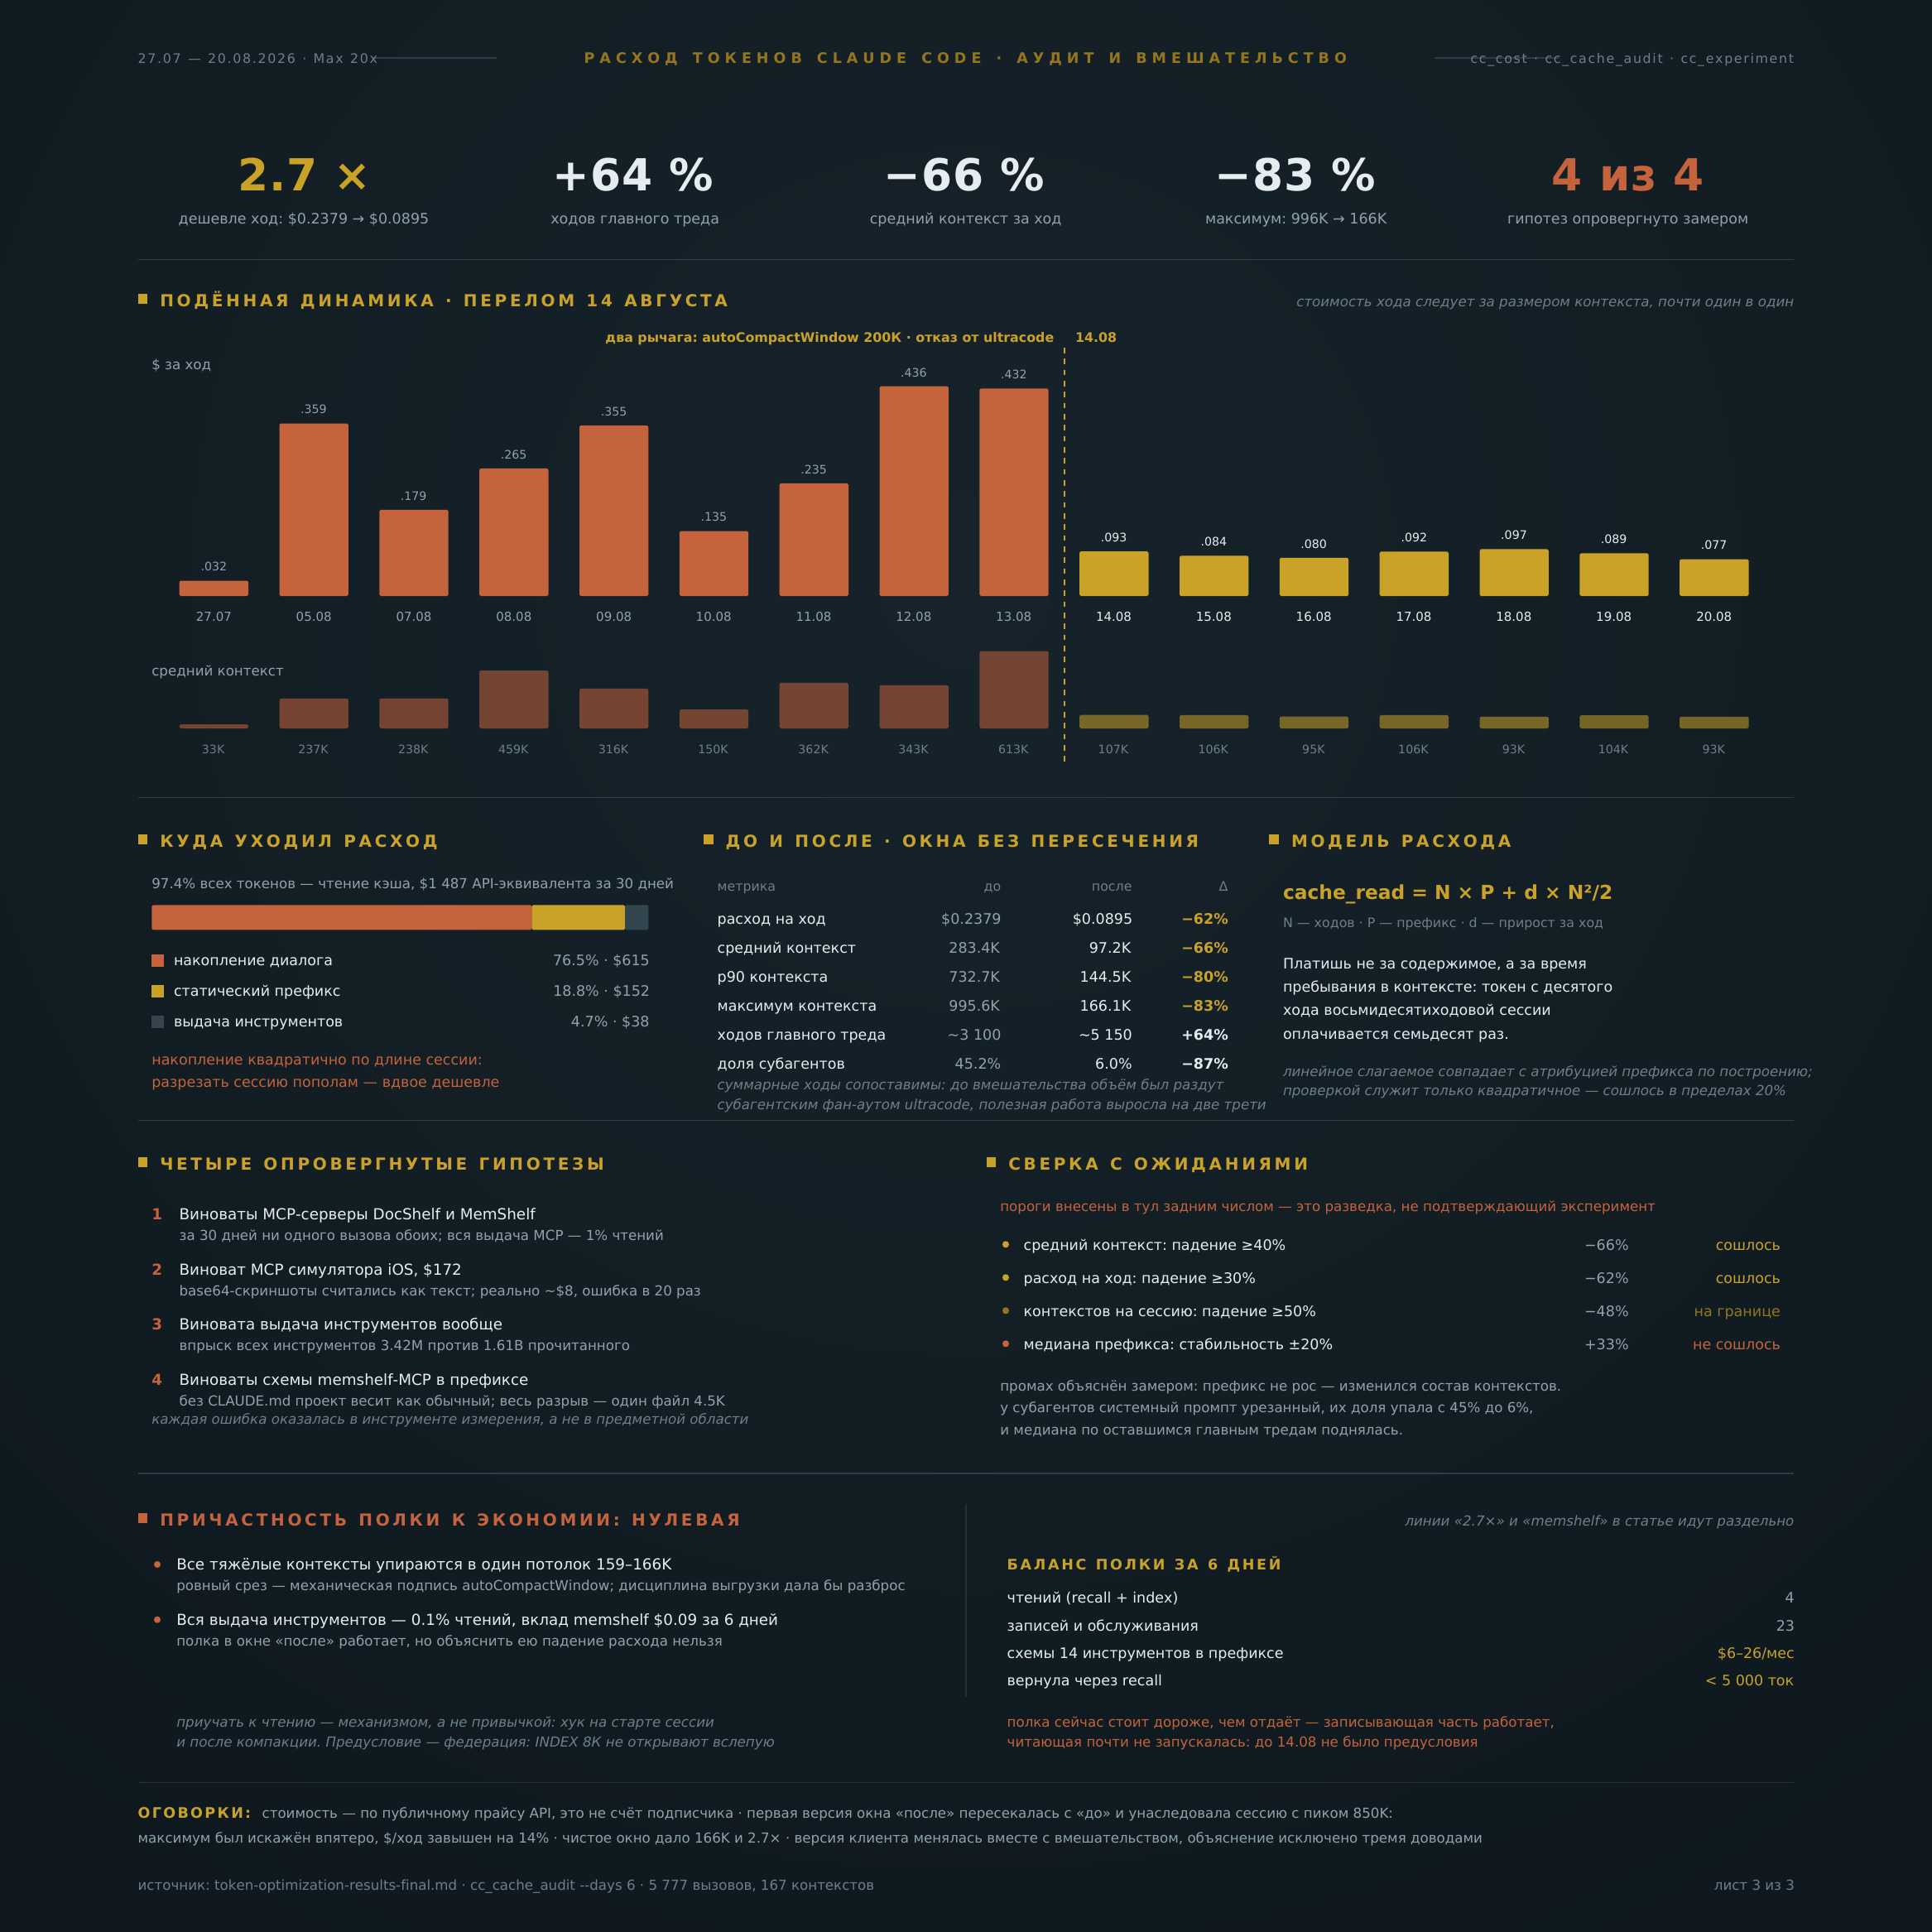
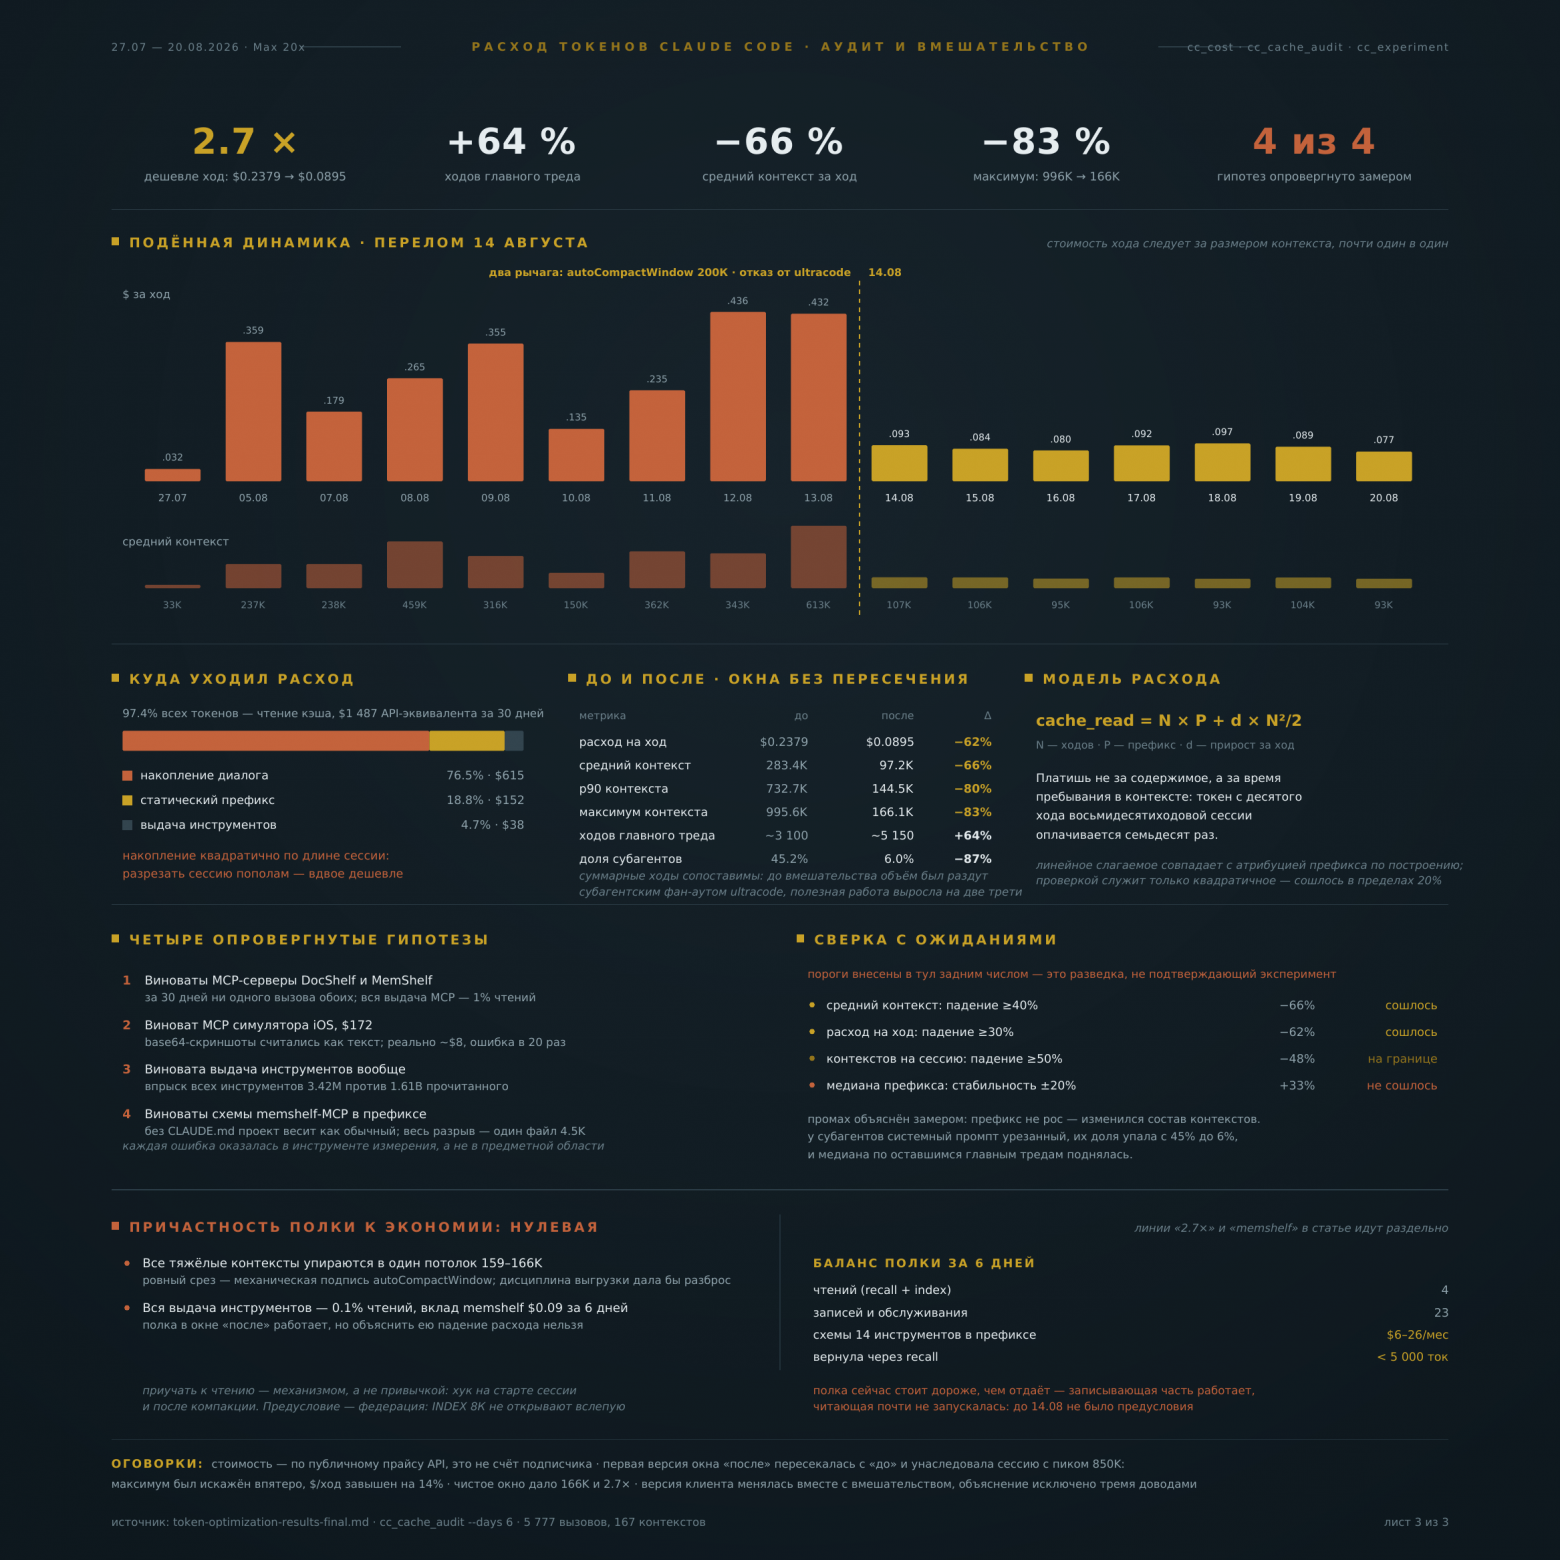
Анализ затрат показал, что основная стоимость работы с ИИ-агентами складывается не из объема передаваемых данных, а из времени их нахождения в контексте. Каждый новый ход в чате заставляет модель перечитывать всю историю заново. Таким образом, затраты растут квадратично.
Использование MemShelf позволяет экономить, заменяя «тяжелую» историю переписки легкими ссылками. Вместо того чтобы держать в памяти 60 000 токенов прошедшей сессии, система хранит дайджест на 184 токена. Если данные понадобятся, агент подтянет нужную секцию объемом около 1 000 токенов. В масштабах месяца активной работы это позволяет значительно снизить эффективную стоимость одного хода при сохранении высокого качества ответов.
Автор отмечает, что использование кэширования токенов у провайдеров (например, Anthropic) делает работу дешевле, но не решает проблему объема. Кэш живет минуты и ограничен одной сессией, в то время как полка опыта доступна всегда и везде.
Барьеры между записью и воспроизведением
Опыт эксплуатации показал, что наличие хранилища не гарантирует его использование. Если запись эпизода — это естественное завершение задачи, то чтение памяти требует осознанного действия. В ряде случаев ассистент может игнорировать доступную память, пытаясь заново изобрести решение, которое уже зафиксировано на полке.
Чтобы приучить агента пользоваться накопленным опытом, были внедрены технические хуки: обязательное чтение индекса при старте сессии и проверка памяти после каждого автоматического сжатия контекста. Это переводит использование памяти из разряда «рекомендаций» в категорию обязательных алгоритмических шагов ИИ-агента.
Инструментарий и начало работы
Система MemShelf реализована как открытый пакет на Python и доступна через PyPI. Она поддерживает работу как через протокол MCP (Model Context Protocol) в клиентах вроде Claude Desktop или Claude Code, так и через обычный терминал.
Набор инструментов включает команды для инициализации полки, архивации диалогов, поиска по базе (в том числе семантического), а также средства для разрешения конфликтов при параллельной записи данных из разных сессий. Для тех, кто хочет внедрить подобную систему, предоставлена спецификация формата, позволяющая создавать совместимые решения на любых языках программирования.