
Мой блог
Adaption Labs представила Invent a Dataset: генерация обучающих выборок по описанию задачи

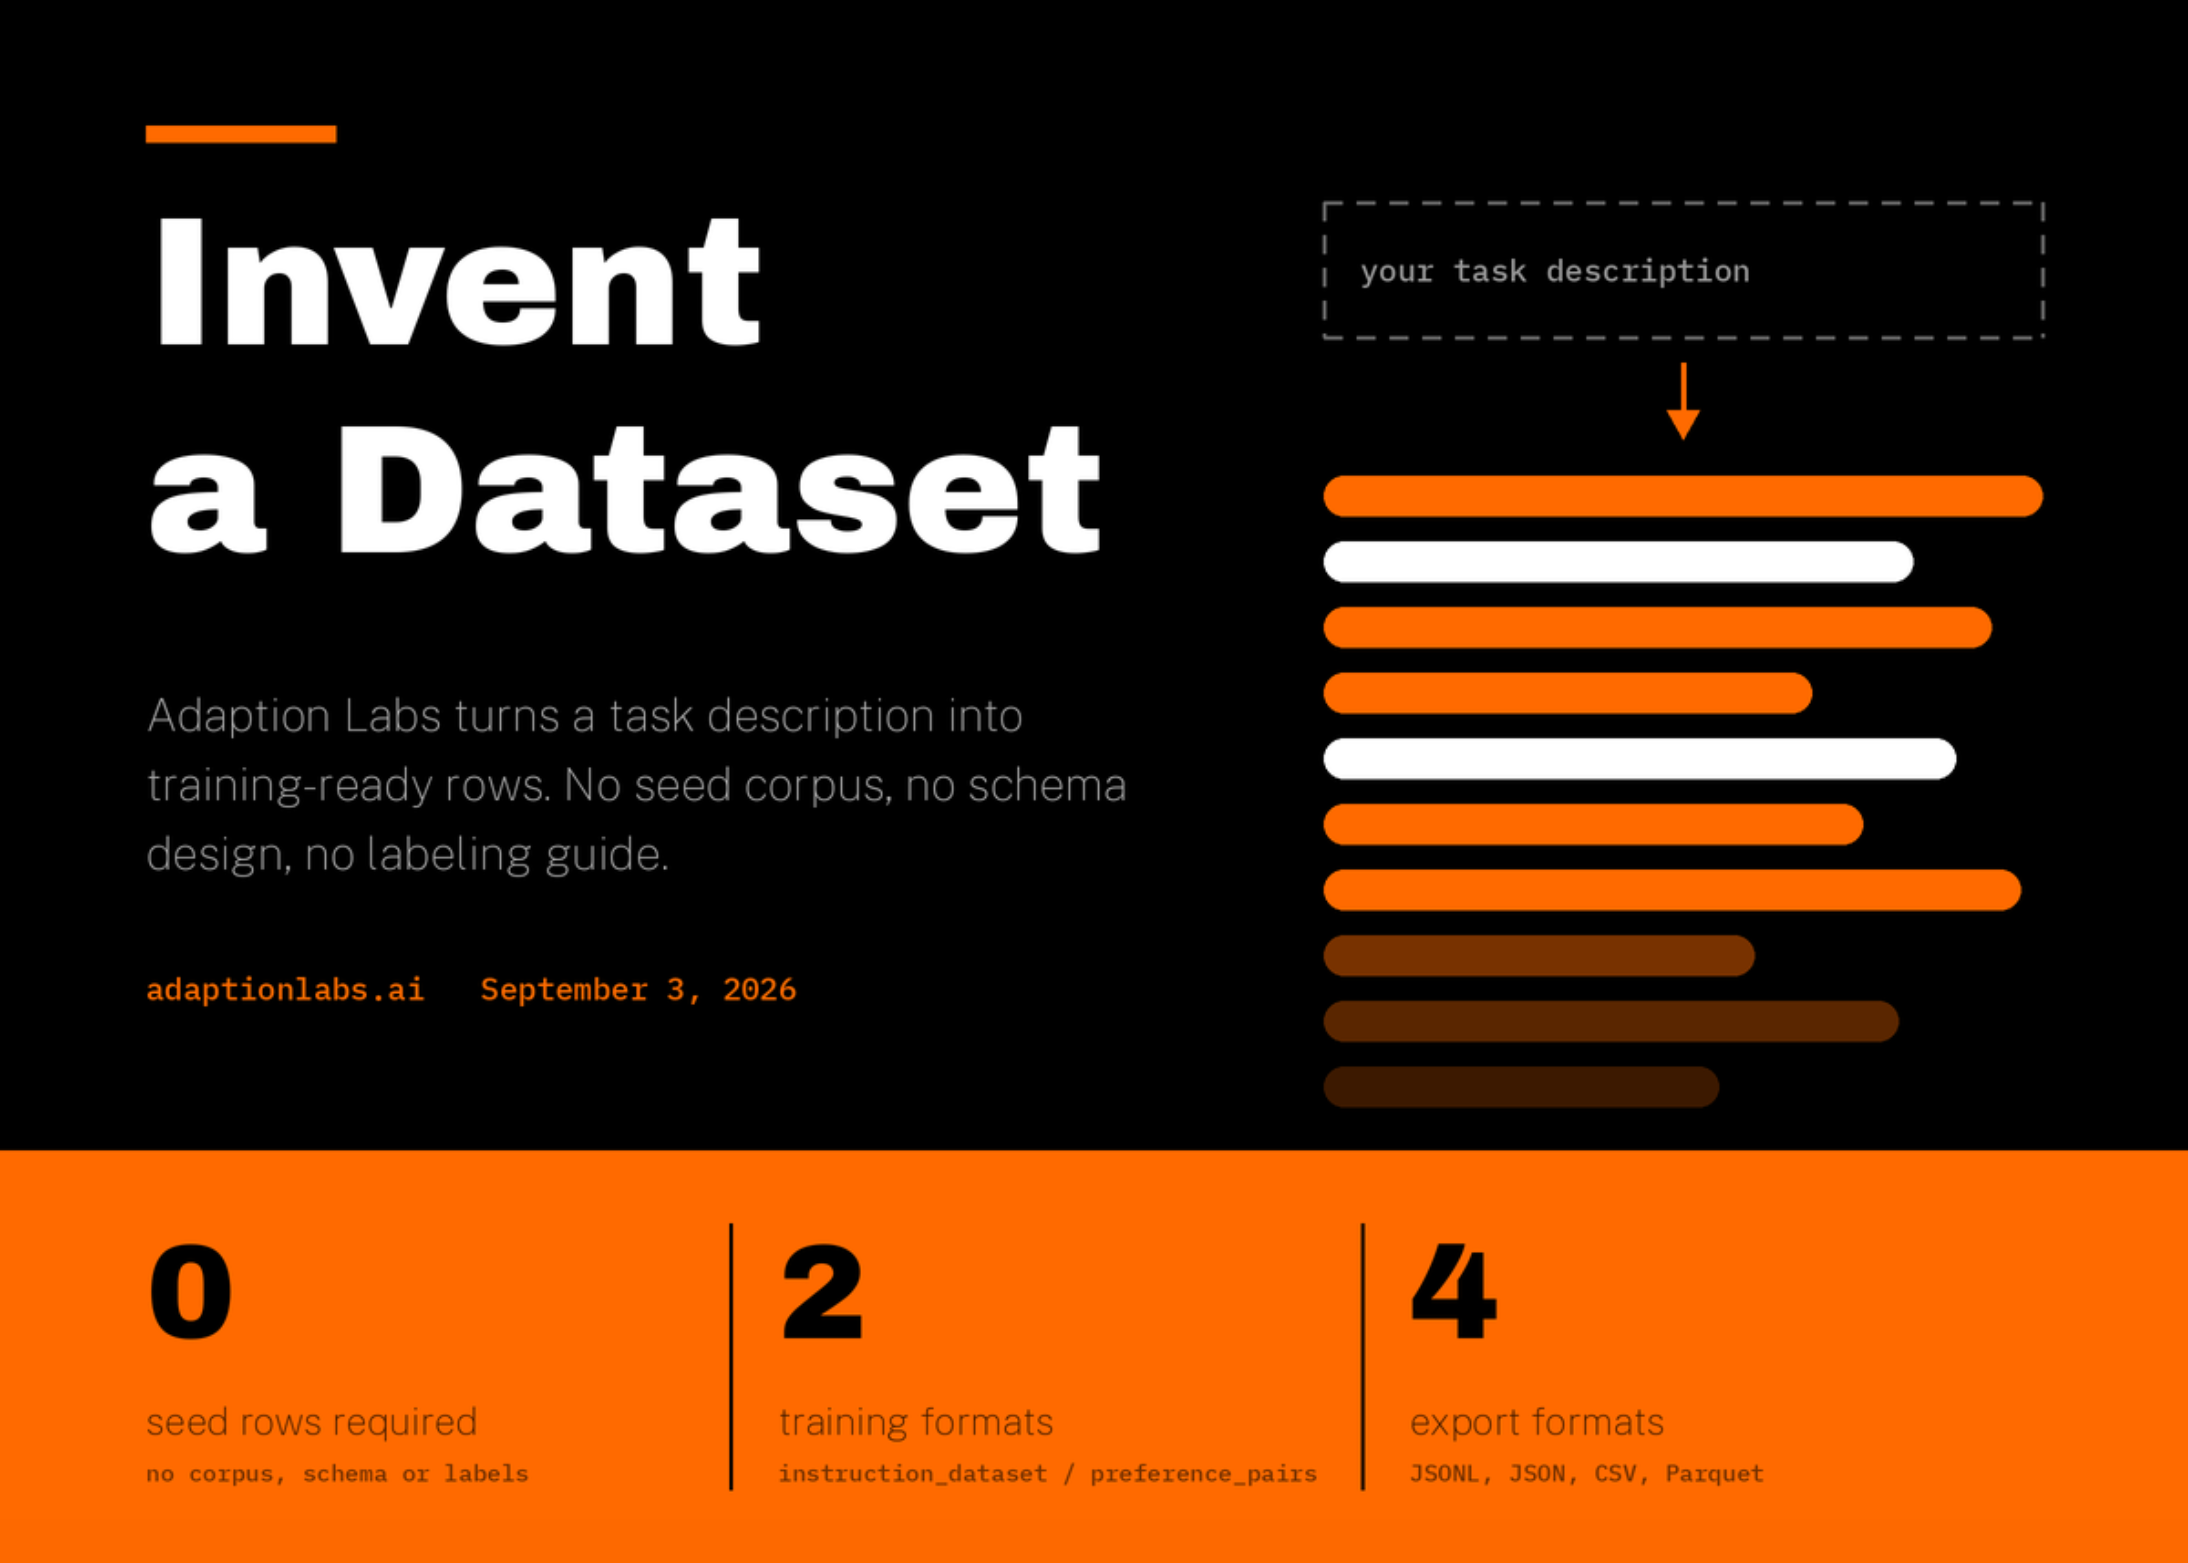
Компания Adaption Labs анонсировала инструмент под названием Invent a Dataset. Главная особенность этого решения заключается в том, что оно позволяет создавать полноценные, готовые к дообучению моделей выборки данных на основе обычного текстового описания желаемого поведения нейросети. Пользователю больше не нужно собирать исходный корпус текстов (seed corpus), выстраивать сложную схему данных или составлять инструкции для аннотаторов.
С технической точки зрения инструмент уже готов к полноценному использованию. Доступ к Invent a Dataset открыт через веб-приложение Adaption, а также посредством Python SDK и REST API. Сгенерированные строки выгружаются в привычных форматах — JSONL, JSON, CSV или Parquet. Это делает получившийся датасет полностью автономным файлом, который принадлежит пользователю и может применяться на любой обучающей инфраструктуре. Сам процесс генерации происходит на мощностях сервиса Adaption и оплачивается списываемыми кредитами. Варианта для локального или изолированного развертывания генератора на собственной инфраструктуре разработчики не предусмотрели.
Главные проблемы традиционной подготовки данных
Классический пайплайн подготовки обучающих выборок почти всегда стартует с уже имеющихся у команды сырых сведений. Разработчикам приходится неделями размечать, фильтровать, очищать и приводить эти массивы к нужному виду, чтобы хоть как-то приблизить их к целевой задаче. В Adaption Labs указывают на то, что подобный подход изначально зажимает качество итоговой модели в рамки того, насколько имеющиеся данные соответствуют реальному целевому сценарию. В специфических и узкоспециализированных областях полезный сигнал обычно скрыт в корпоративных системах, неструктурированном тексте или логах процессов, откуда его крайне сложно извлечь в форме чистого обучающего датасета.
Исследовательская команда Adaption Labs подчеркивает разницу между их подходом и имеющимися инструментами генерации синтетических данных. Существующие решения автоматизируют генерацию только после того, как человек вручную задал структуру (schema), распределение задач и конкретную стратегию создания примера. Invent a Dataset работает на уровень выше: точка входа здесь — это непосредственное описание логики поведения, которое требуется получить от модели.
Механика и особенности работы API
Архитектура API описана максимально конкретно и четко. Запуск процесса осуществляется посредством одного вызова функции datasets.invent. Этот запрос моментально возвращает ответ со статусом running и запускает фоновую генерацию. После этого клиентское приложение опрашивает метод datasets.get до тех пор, пока статус не сменится на succeeded или failed, после чего можно скачивать готовые строки.
Управление доменами выступает главным рычагом контроля над контентом. Вместо использования жестко прописанных значений разработчики рекомендуют запрашивать актуальный список с помощью метода datasets.invent_domains. В вызов передаются общие категории, например medical, или уточненные поддомены вроде medical.symptoms_diagnosis. Для успешного запуска требуется указать хотя бы один домен или поддомен. При этом можно сочетать сразу несколько тематик в одном запуске. Если указать категорию верхнего уровня без уточнения поддоменов, система задействует весь спектр данной тематики.
На данный момент сервис поддерживает два ключевых формата выдачи:
instruction_dataset— вариант по умолчанию, формирующий пары «инструкция — ответ» (prompt-completion), предназначенные для классического Supervised Fine-Tuning (SFT);preference_pairs— формат с двумя вариантами ответа («выбранный» и «отклоненный»), который применяется при обучении с подкреплением и выравнивании моделей, например по методу DPO (Direct Preference Optimization).
При использовании API в реальных рабочих процессах стоит учитывать три важных параметра:
- Параметр
estimate=Trueпозволяет рассчитать точную стоимость запроса в кредитах и сравнить её с текущим балансом пользователя без фактического запуска генерации и списания средств. - Параметр
promptпринимает текстовое описание объемом до 10 000 символов, с помощью которого задаются детали поведения, стилистика и тончайшие нюансы формируемых записей. - Параметр
idempotency_keyпринимает строку длиною до 255 символов. Он гарантирует защиту от сбоев в сети: при повторном отправке запроса с тем же ключом система вернет результат первого запуска, а не станет списывать кредиты за дублирующий процесс.
Лимит на общее количество генерируемых строк за один запуск зависит от выбранного тарифного плана пользователя.
Локализация и языковые возможности
Функция расширения языкового охвата language_expansion может функционировать в двух независимых режимах:
translate— создает прямое переводное ответвление строки на выбранный целевой язык;localize— генерирует варианты, адаптированные под конкретную страну и языковую пару, используя локальные формулировки, терминологические нормы и культурный контекст вместо буквального перевода.
За объем языковой адаптации отвечает параметр sample_rate, принимающий значение от 0,01 до 1,0. Он задает долю строк из созданного датасета, подлежащих расширению. Важно учитывать, что финансовое списание кредитов происходит исходя из итогового количества сформированных расширенных строк, а не по исходному объему генерации. В случае передачи некорректного или неподдерживаемого кода языка API возвращает ошибку с кодом 400 и примерами правильных значений.
Замкнутый цикл обучения: интеграция с AutoScientist
Инструмент Invent a Dataset задуман не как изолированный генератор файлов, а как первая половина полного цикла безданных (zero-data) обучающих пайплайнов. Идентификатор созданного датасета (dataset ID) передается напрямую в метод autoscientist.create. Эта система берет на себя одновременную оптимизацию структуры данных и рецепта обучения модели под конкретную целевую метрику.
Платформа AutoScientist была запущена в мае 2026 года и стала технологическим парным элементом в инфраструктуре обработки данных Adaption. По внутренним оценкам компании, алгоритмы AutoScientist превосходят конфигурации обучения, составленные вручную их собственными исследователями, в среднем на 35%. Доля успешных моделей (win rate) увеличилась с 48% до 64%. Эти показатели были зафиксированы в рамках внутренних тестов по восьми профильным вертикалям при объемах датасетов от 5 000 до 100 000 строк. Обучение проводилось на архитектурах, доступных для точечного дообучения на мощностях Together AI.
Итоги и выводы
Запуск Invent a Dataset обозначает переход от привычной сборки обучающих данных к их прямой декларативной генерации из функциональных требований. Пользователю достаточно сформулировать задачу, указать домены и формат output-файла, чтобы получить структурированную выборку без единой строчки ручной разметки. Я регулярно отслеживаю развитие систем генерации синтетических данных, и связка Invent a Dataset с AutoScientist выглядит как шаг к полностью автоматизированному пайплайну дообучения узкоспециализированных ИИ-моделей.
Источник: www.marktechpost.com
