
Мой блог
Игнорирование цвета и выделений в документах приводит к ошибкам ИИ-агентов

Большинство корпоративных ИИ-систем сталкиваются со скрытой проблемой при парсинге файлов: современные конвертеры корректно считывают текст и таблицы, но полностью игнорируют визуальные акценты. По данным исследователей из компании Amazon, обработка документов корпоративными ИИ-агентами без учета цветового выделения маркером и применения красного шрифта приводит к тому, что языковые модели уверенно выдают ошибочные выводы.
Даже при высокой точности оцифровки структуры документа потеря графического слоя выделения лишает модель ключевого контекста. В результате ИИ пропускает критически важные инструкции, правила и приоритеты, которые авторы специально выделили графически.
Проблема игнорирования графических выделений в оцифровке
Масштаб проблемы оцифровки бумажных и цифровых документов остаётся огромным. По имеющимся оценкам, из четырёх миллиардов бумажных документов, ежегодно циркулирующих в мировой торговле, цифровой вид получает лишь около 1%. В государственном секторе ситуация аналогичная: Национальное управление архивов и документации США сообщает, что оцифровано лишь 4,04% хранящихся аналоговых материалов, а почти 12 миллиардов документов всё ещё ждут своей очереди.
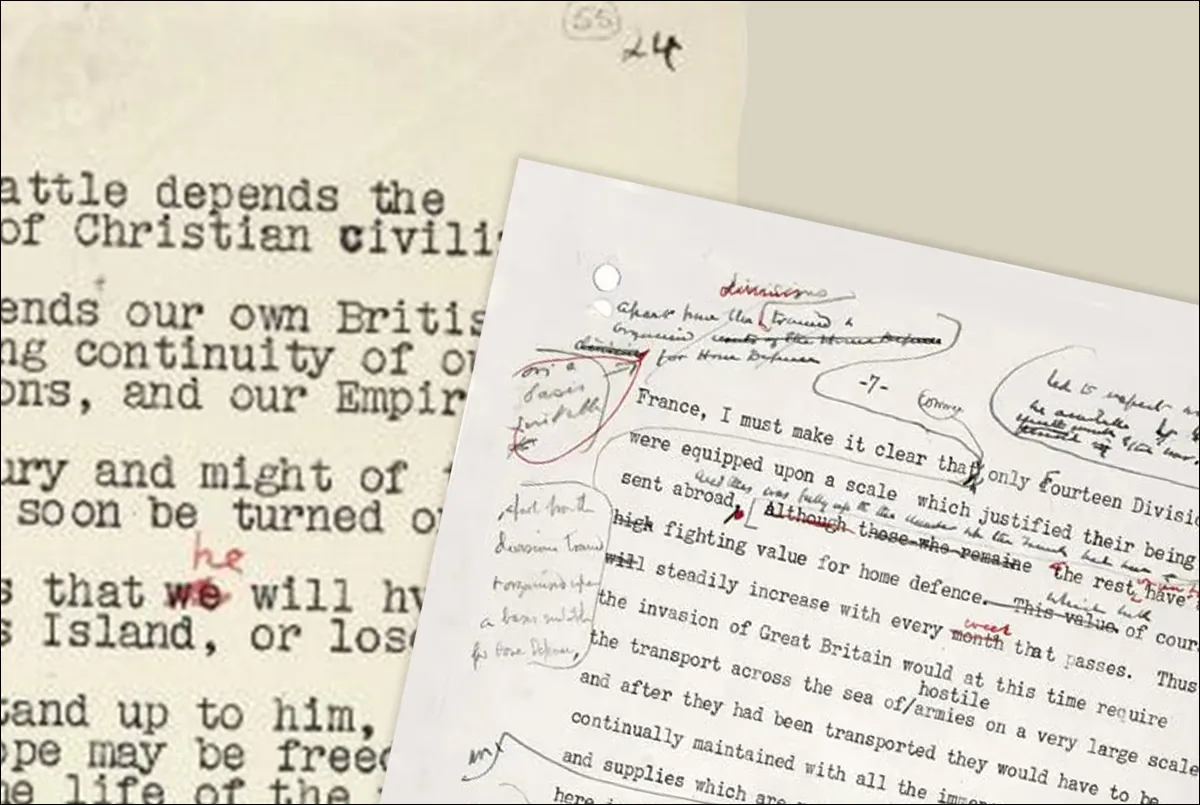
При работе с важными текстами авторы традиционно используют визуальные акценты. Нанесение пометок маркером, смена цвета шрифта или рукописные исправления помогают быстро выхватить главное из массива данных. Историческим примером служит Уинстон Черчилль, который при подготовке речей использовал чернила разных цветов, в частности применяя красный цвет как сигнал для внесения правок.
Однако современные инструменты конвертации и сегментации документов, такие как библиотека Docling или стандартные системы OCR и VLM (Vision Language Models), полностью удаляют эти графические слои при преобразовании текста. В результате сотни миллионов документов теряют слой авторского подчеркивания смыслов, что неизбежно ведет к искажению намерений составителя при последующем анализе алгоритмами.
Результаты исследования и сбои в восприятии смыслов ИИ
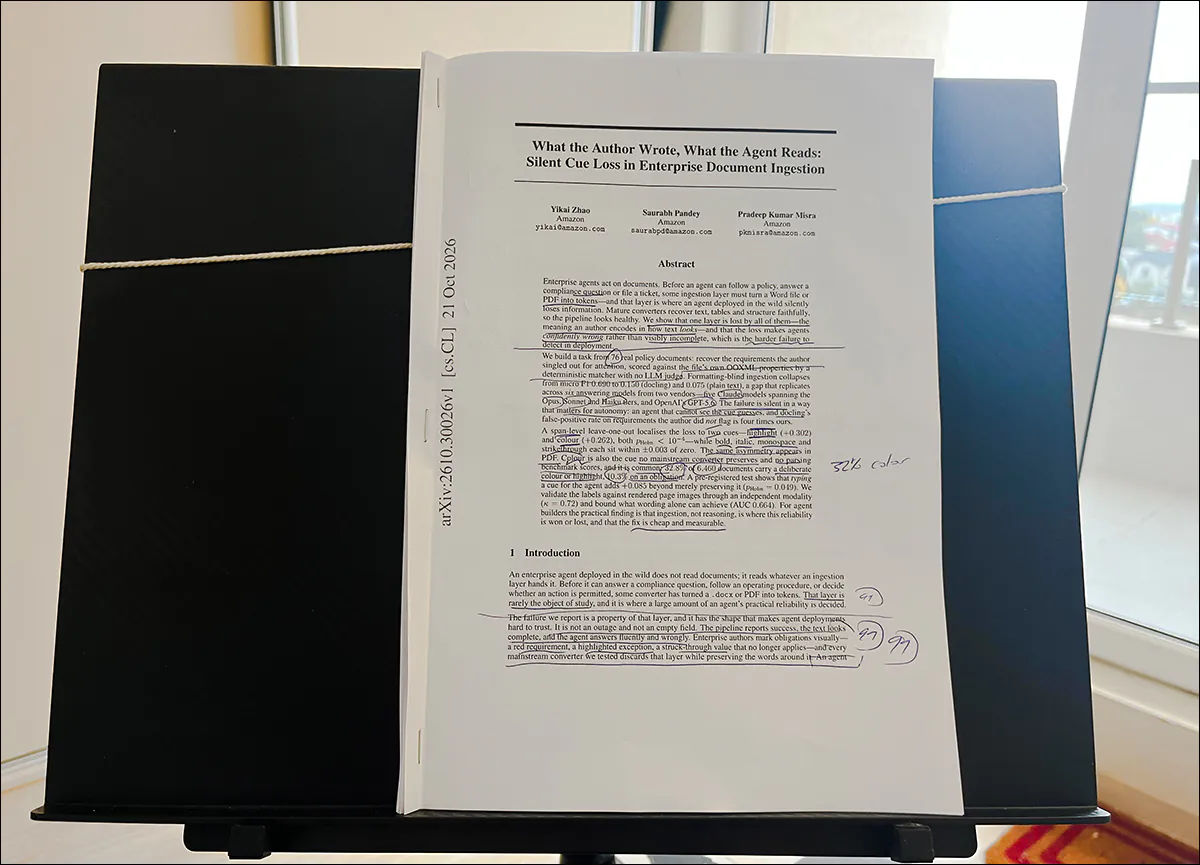
В научной работе «What the Author Wrote, What the Agent Reads: Silent Cue Loss in Enterprise Document Ingestion» авторы детально исследовали проблему утраты визуальных маркеров. В ходе эксперимента было проанализировано 6 462 нормативных документа в формате .docx. Почти треть из них содержала текст красного цвета или выделение цветным маркером, а примерно в каждом десятом документе эти графические приёмы применялись для обозначения обязательных к исполнению требований.
Разработчики отмечают, что популярные конвертеры справляются с извлечением текста, таблиц и структуры, поэтому внешне конвейер обработки данных выглядит исправным. На практике же потеря внешнего оформления делает ИИ-агентов уверенно ошибающимися — модель выдаёт ошибочный ответ с высокой уверенностью вместо того, чтобы указать на неполноту данных. Это наиболее опасный тип сбоя при развёртывании систем в реальной эксплуатации.
Эксперименты показали, что при сохранении оригинальных цветов шрифта и фоновых выделений языковые модели справляются с поиском важных требований существенно лучше. Этот эффект подтвердился на шести популярных нейросетевых моделях, включая GPT-5.6 Terra, Claude Opus 5 и Claude Sonnet 5.
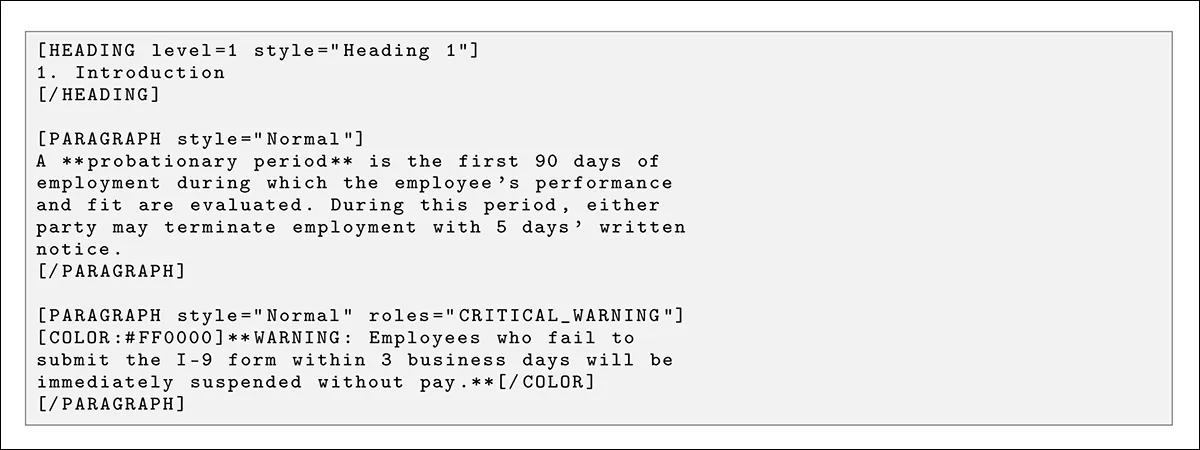
Для учета визуального слоя исследователи предложили алгоритм, который фиксирует факт наличия выделения и его конкретный цвет. К примеру, красный цвет системно кодируется как показатель высокого приоритета или негативного контекста. Интеграция таких меток в текст происходит на этапе детерминированного парсинга без привлечения дополнительного LLM-процессинга. Это приводит примерно к двукратному увеличению расхода токенов на один документ, однако обеспечивает качественный прирост достоверности ответов.
Почему стандартное форматирование не работает так же эффективно
В ходе работы исследователи проверили влияние других способов оформления текста: полужирного написания, курсива, моноширинного шрифта и зачёркивания. Результаты показали, что стандартные типографические приёмы практически не помогают ИИ-моделям выявлять ключевые требования.
Причина заключается в чрезмерно частом использовании стандартного форматирования. В одном корпоративном документе может встречаться более тысячи элементов с полужирным шрифтом — им выделяют каждый подзаголовок, термин или определение. Из-за такой плотности полужирный шрифт перестаёт служить сигналом особых указаний.
Напротив, выделение фрагмента цветным маркерным фоном или изменение цвета текста на красный является точечным и редким действием автора. Именно редкость применения делает цвет идеальным маркером истинного намерения составителя.
Методология тестирования и попытки анализа без контекста
Чтобы протестировать работу ИИ-агентов в контролируемых условиях, авторы отобрали 84 документа, содержащих 332 отмеченных цветным выделением требования и 4 192 неотмеченных требования. В каждом файле присутствовало минимум одно отмеченное и не менее трёх обычных условий, чтобы исключить возможность простого копирования всего текста.
Перед языковыми моделями ставилась задача сформировать список всех требований, которые автор выделил для особого внимания или повысил в приоритете. Проверка ответов производилась программно без участия оценки со стороны сторонней LLM. Ответ засчитывался как точное совпадение, если он содержал минимум четыре последовательных ключевых слова из исходного требования.
Дополнительно был проведён абляционный тест, задача которого заключалась в проверке возможности определить важность требования исключительно по тексту, без учёта цвета. Текстовый классификатор достиг значения метрики ROC AUC лишь 0,664 (где 0,5 соответствует случайному угадыванию). Попытки искать ключевые слова срочности дали результат 0,508, а оценка по длине предложений — 0,492.
Эти цифры доказали, что сформулировать важность фрагмента только по словесной конструкции невозможно. Если бы сама формулировка содержала исчерпывающе жесткие выражения, автору не потребовалось бы наносить дополнительное визуальное выделение поверх готового текста.
Сравнение конвертеров и тесты на сторонних бенчмарках
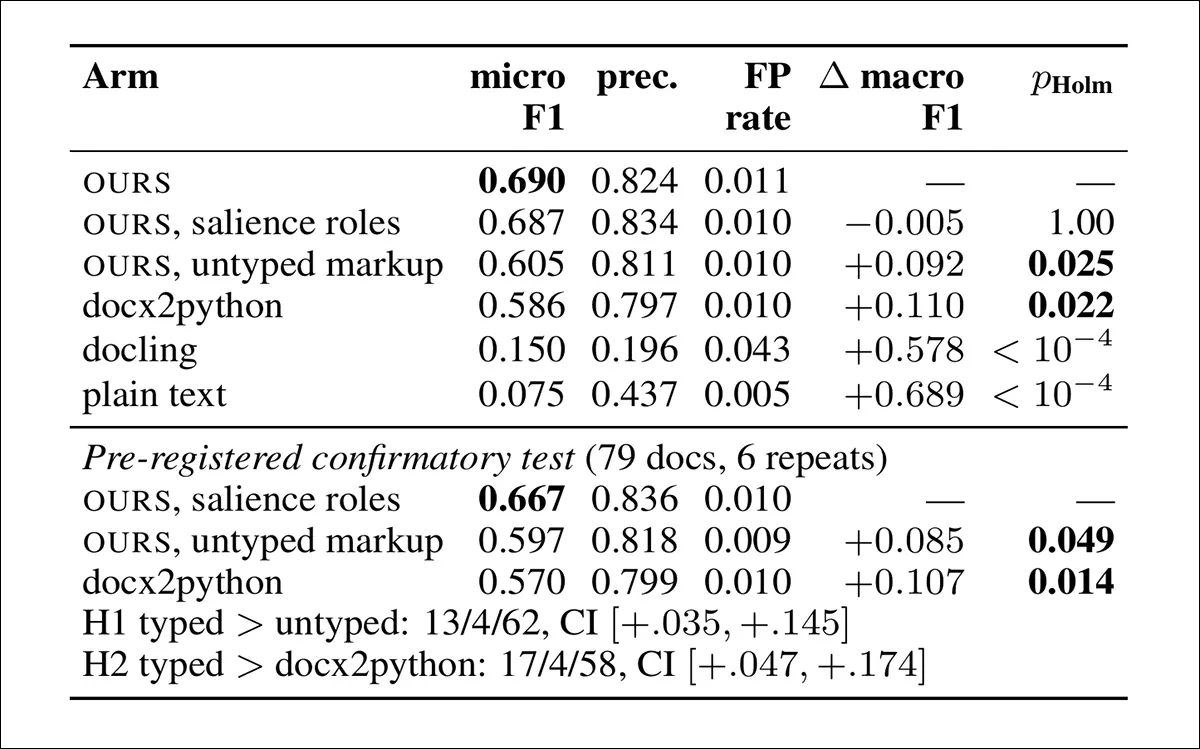
В исследовании сопоставлялись шесть методов подготовки документов: авторский парсер (OURS), варианты OURS с ролевой разметкой и нетипизированной разметкой, библиотеки docx2python, Docling, а также чистое извлечение плоского текста. Сравнение производилось на 76 документах с трёхкратным повторением каждого теста.
Метод авторов показал итоговую метрику F1 на уровне 0,690. Популярная библиотека docx2python показала результат 0,586, инструмент Docling — 0,150, а метод извлечения плоского текста — 0,075. Показатель ложноположительных срабатываний у Docling оказался почти в четыре раза выше по сравнению с разработанной системой (4,3% против 1,1%).
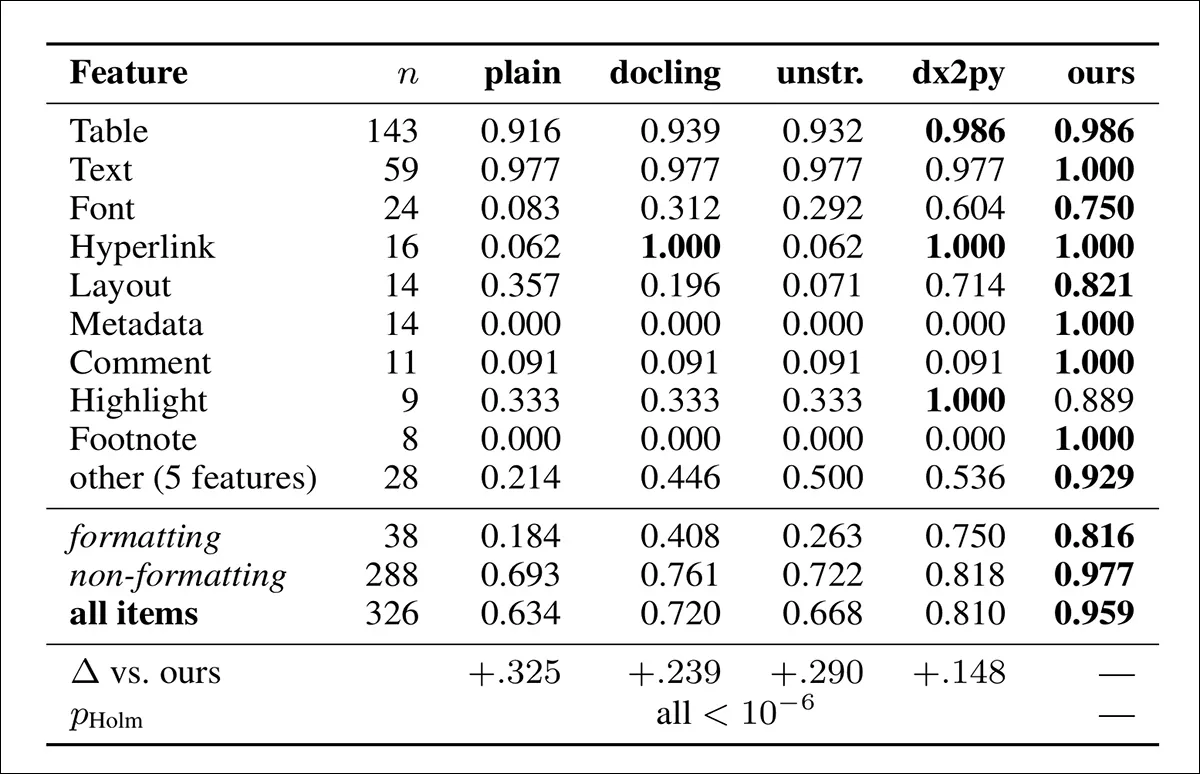
Дополнительное тестирование проводилось на бенчмарке Microsoft Office Comprehension Benchmark (OCB), включающем 326 вопросов к 59 документам Word. Бенчмарк оценивает извлечение метаданных, таблиц, гиперссылок, комментариев и сносок:
- Авторский парсер OURS набрал итоговый балл 0,959.
- Библиотека docx2python показала результат 0,810.
- Инструмент Docling получил 0,720.
- Преобразование в плоский текст набрало 0,634.
Разработанный парсер показал идеальный результат 1,000 в категориях метаданных, комментариев и сносок, тогда как остальные инструменты получили в этих разделах нулевые оценки.
Практические выводы для корпоративной обработки документов
Выявление проблемы потери цветовых акцентов при парсинге открывает важный вектор развития корпоративных ИИ-систем. Сохранение исходного цветового оформления требует большего бюджета токенов на хранение контекста, однако этот шаг напрямую определяет точность работы ИИ-агентов с нормативной документацией.
Для практического применения исследователи советуют переходить на детерминированные конвертеры, способные фиксировать цвета текста и подложки на этапе парсинга файла и передавать их в контекст нейросети в виде явных текстовых тегов.
