Тэг
OCR
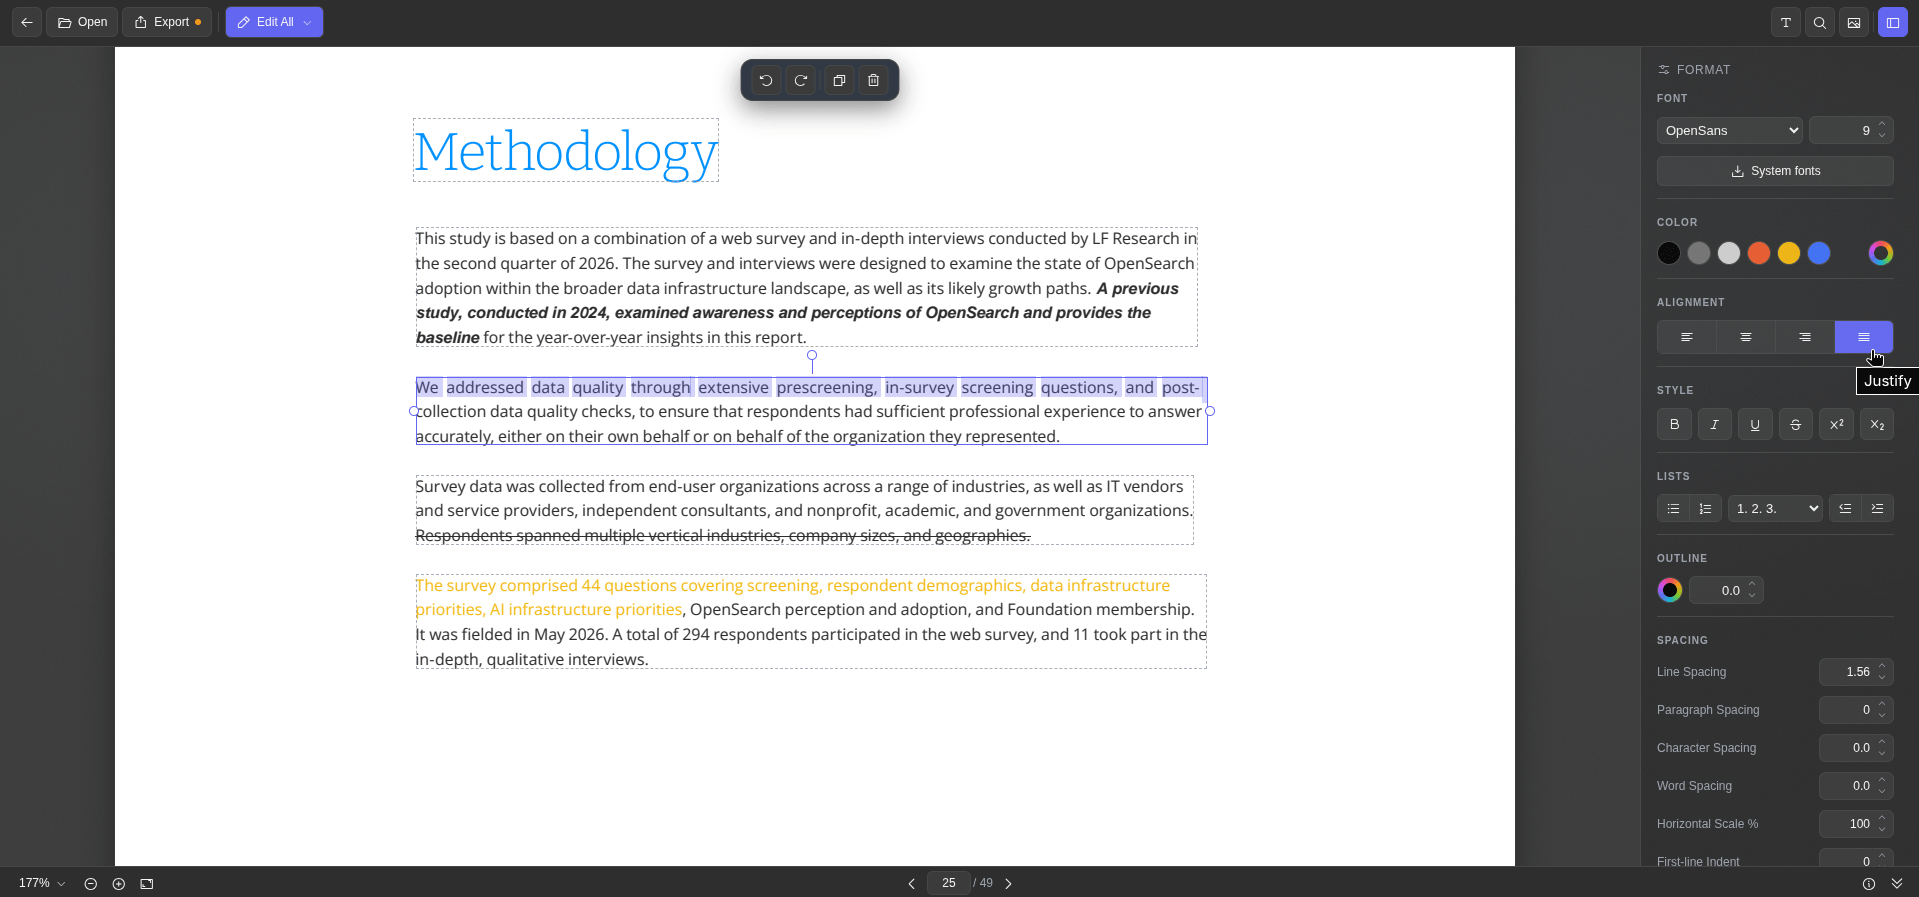
BentoPDF: локальный инструмент для работы с PDF прямо в браузере
Рассматриваем возможности браузерного редактора BentoPDF, который выполняет локальное редактирование, сжатие и распознавание PDF без отправки данных на серверы.
Читать далееКак я перестал верить нейросетям и создал систему Zero-Trust для юридических документов
Практический опыт разработки конвейера для автоматизированного чтения и строгой детерминированной верификации юридических документов без слепого доверия нейросетям.
Читать далее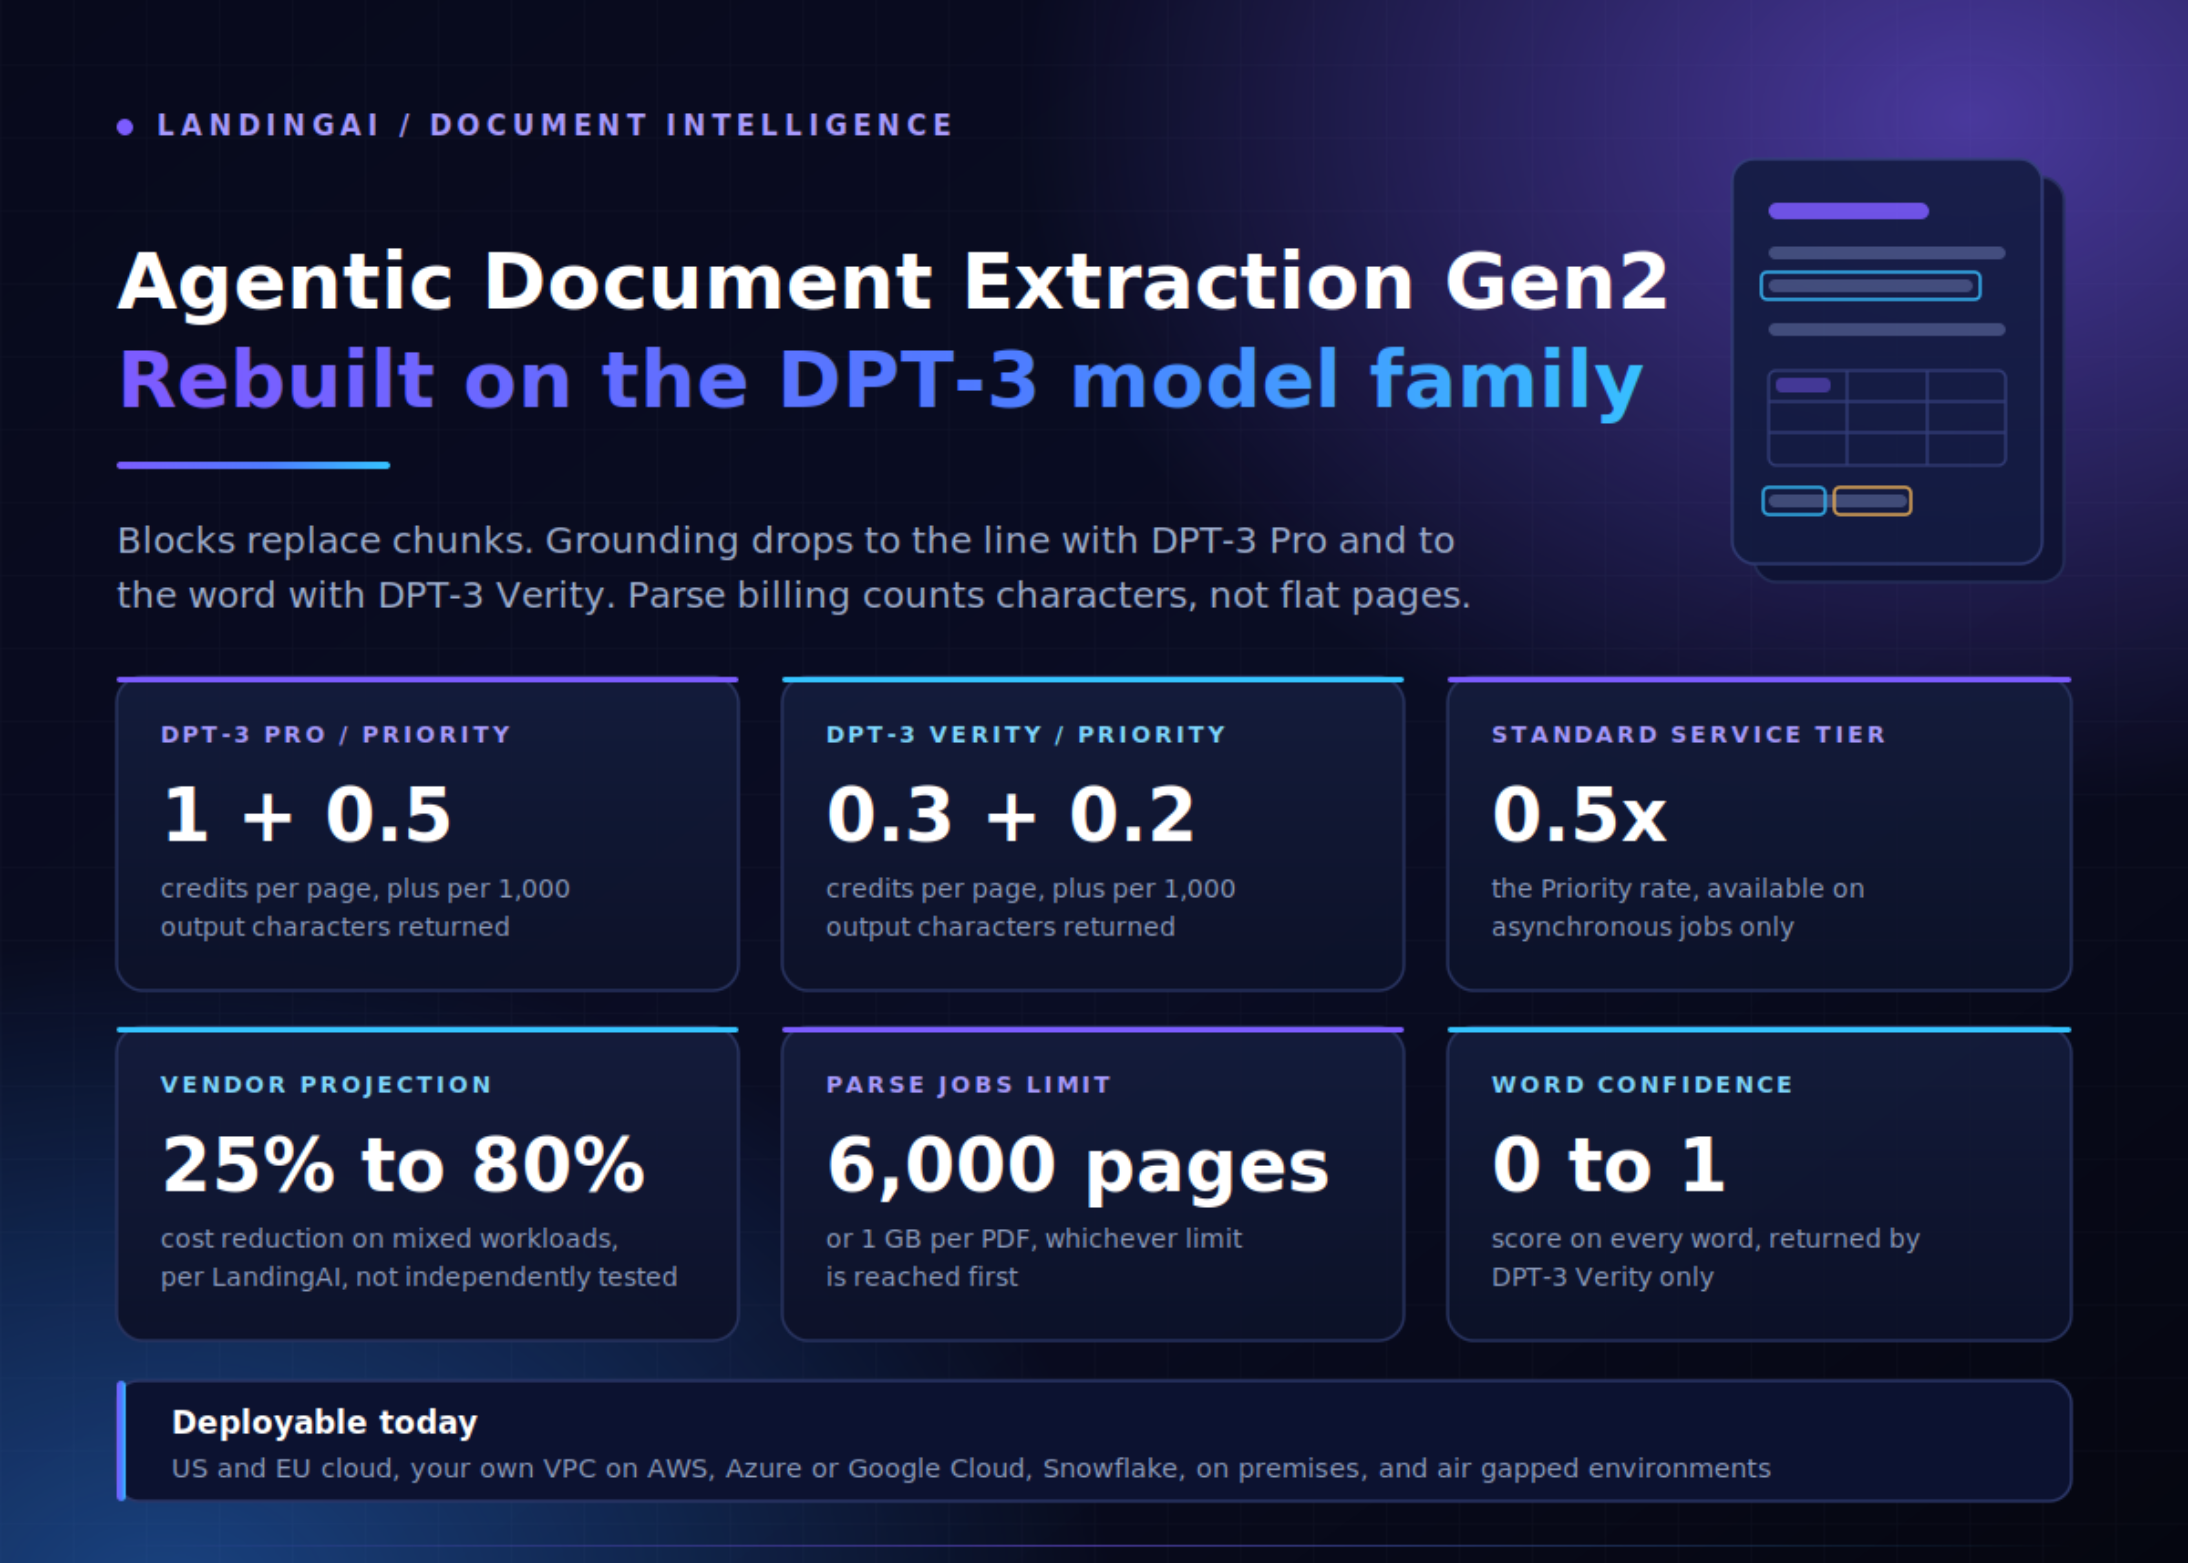
LandingAI представила Agentic Document Extraction Gen2: разбор моделей DPT-3 Pro и Verity, древовидной структуры и новой системы оплаты
LandingAI представила систему Agentic Document Extraction Gen2 на базе нейросетей DPT-3 Pro и Verity. Разбор древовидной структуры, гибридной системы оплаты и атомарной привязки координат.
Читать далее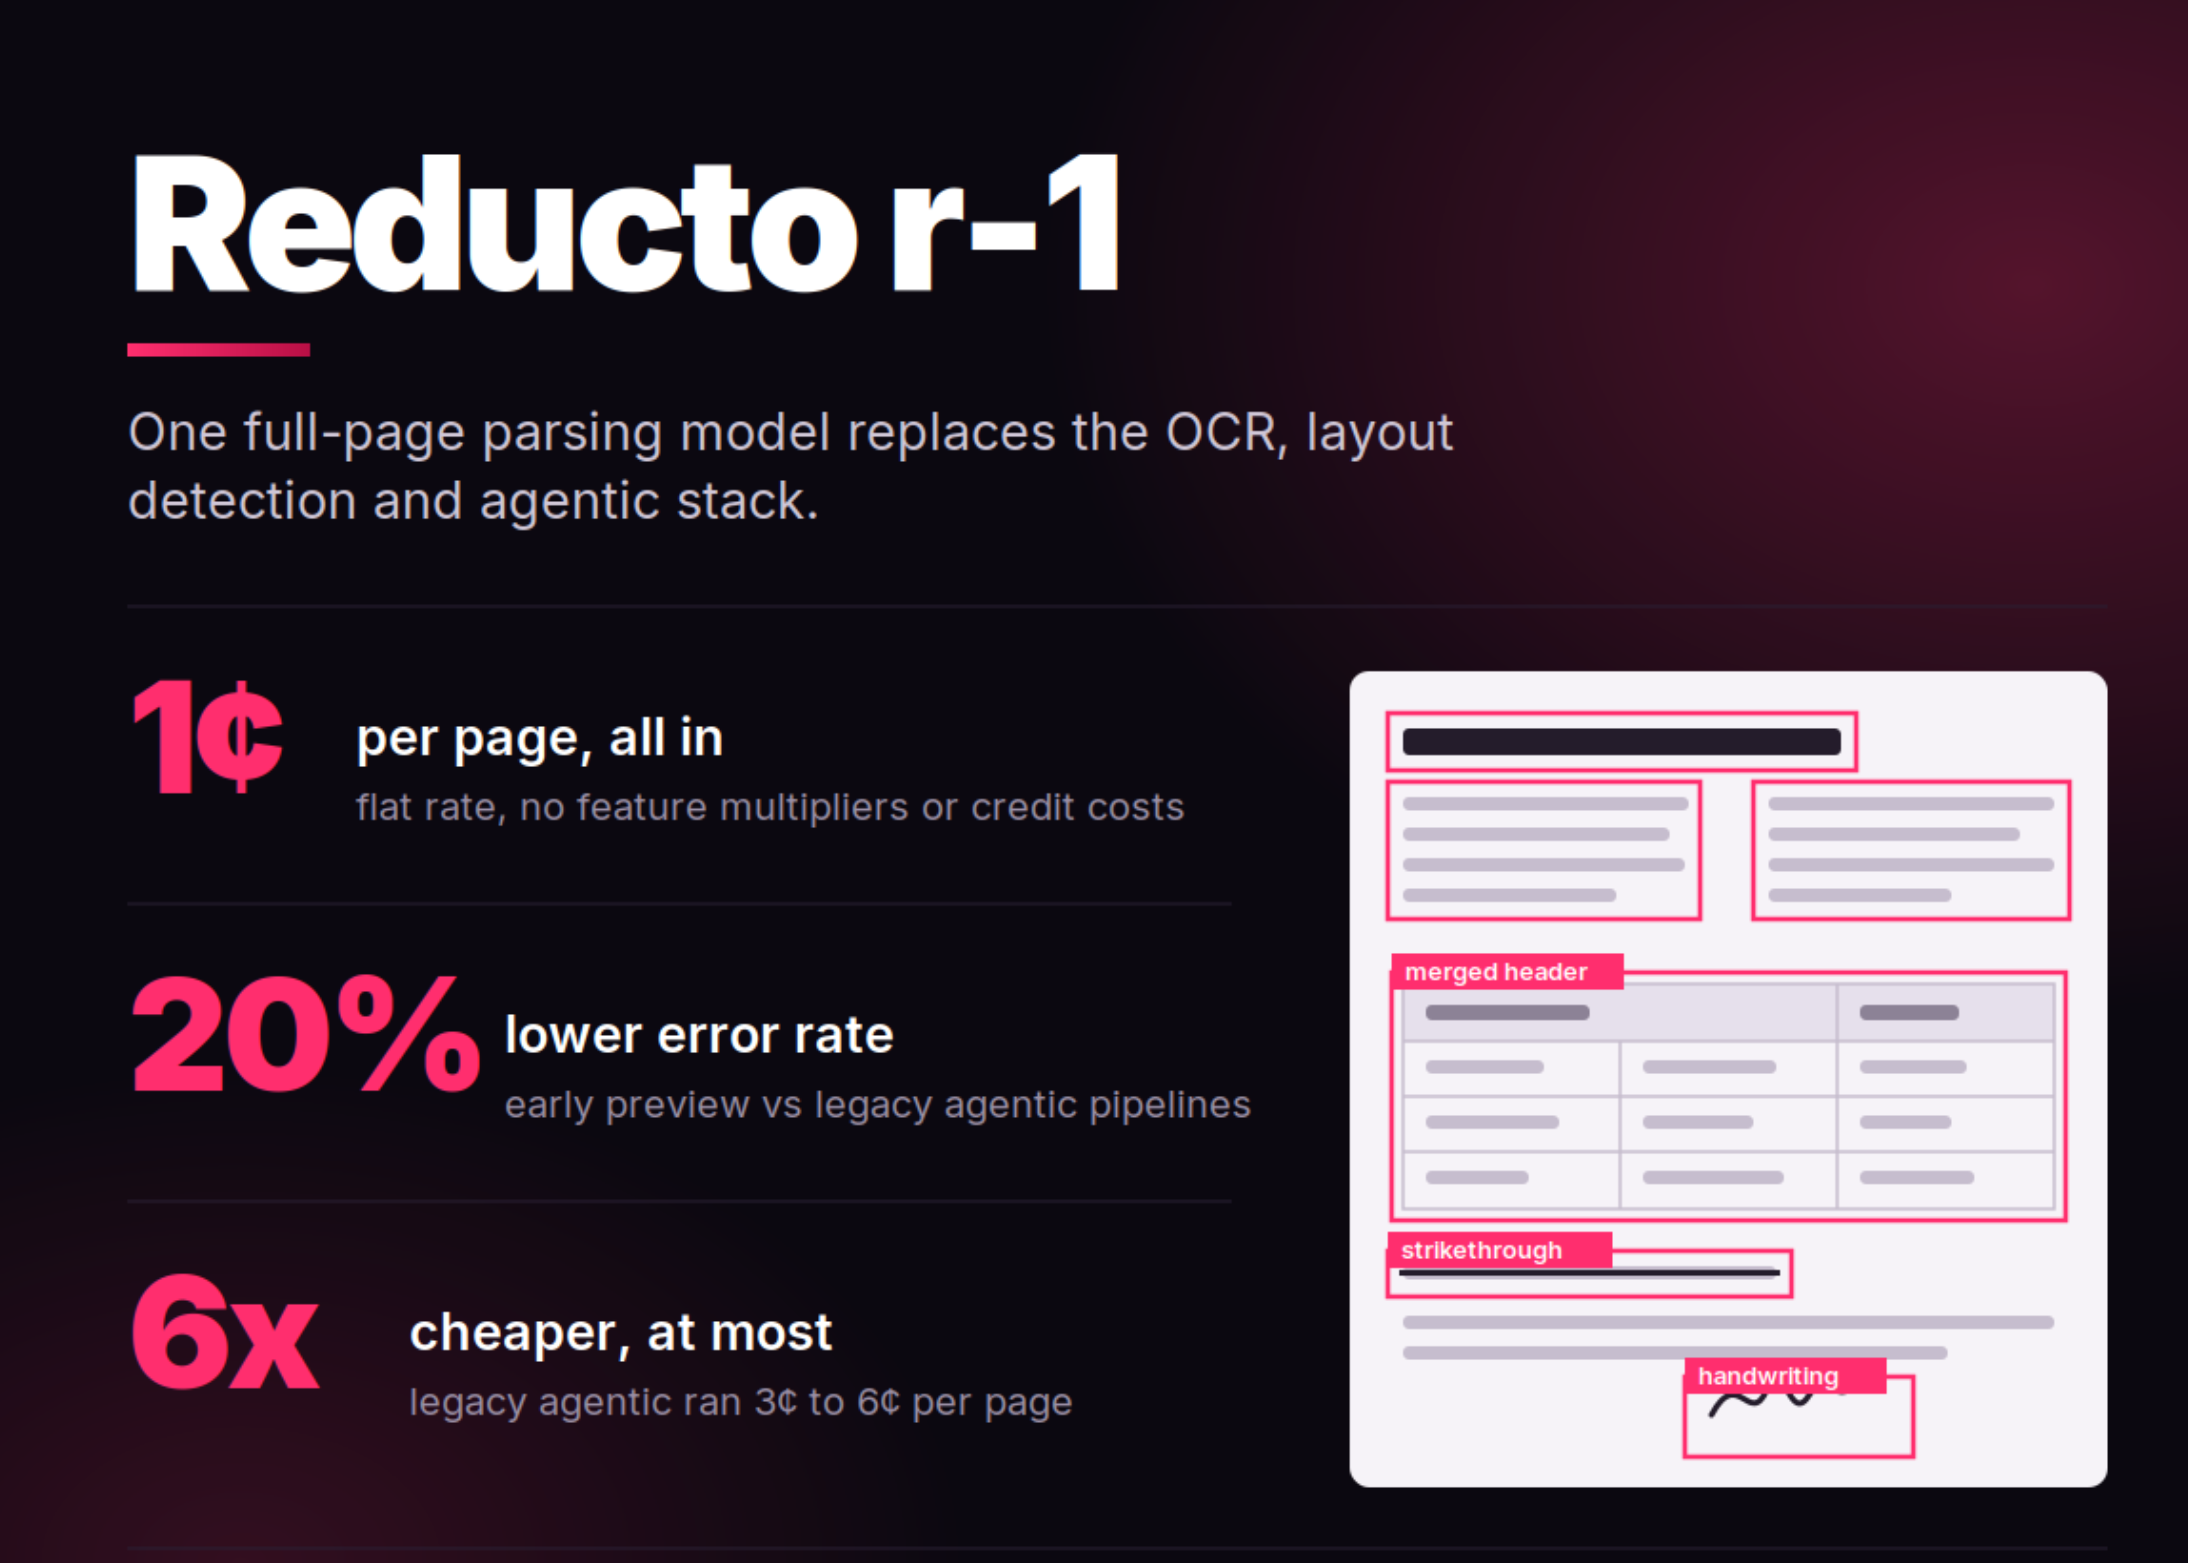
Reducto выпустила r-1: модель парсинга документов за один проход
Компания Reducto представила новую модель r-1 для интеллектуального парсинга документов, объединяющую OCR, анализ структуры и разметку в один проход.
Читать далее
Reducto выпустила модель r-1: распознавание документов в один проход за 1 цент за страницу
Reducto представила модель r-1 для однопроходного анализа документов. Она снижает количество ошибок на 20% и уменьшает стоимость парсинга до 1 цента за страницу.
Читать далее
Как специализированные языковые модели превосходят универсальные системы в OCR
Специализация языковых моделей под конкретные домены позволяет достигать более высокого качества распознавания текста, чем универсальные архитектуры.
Читать далее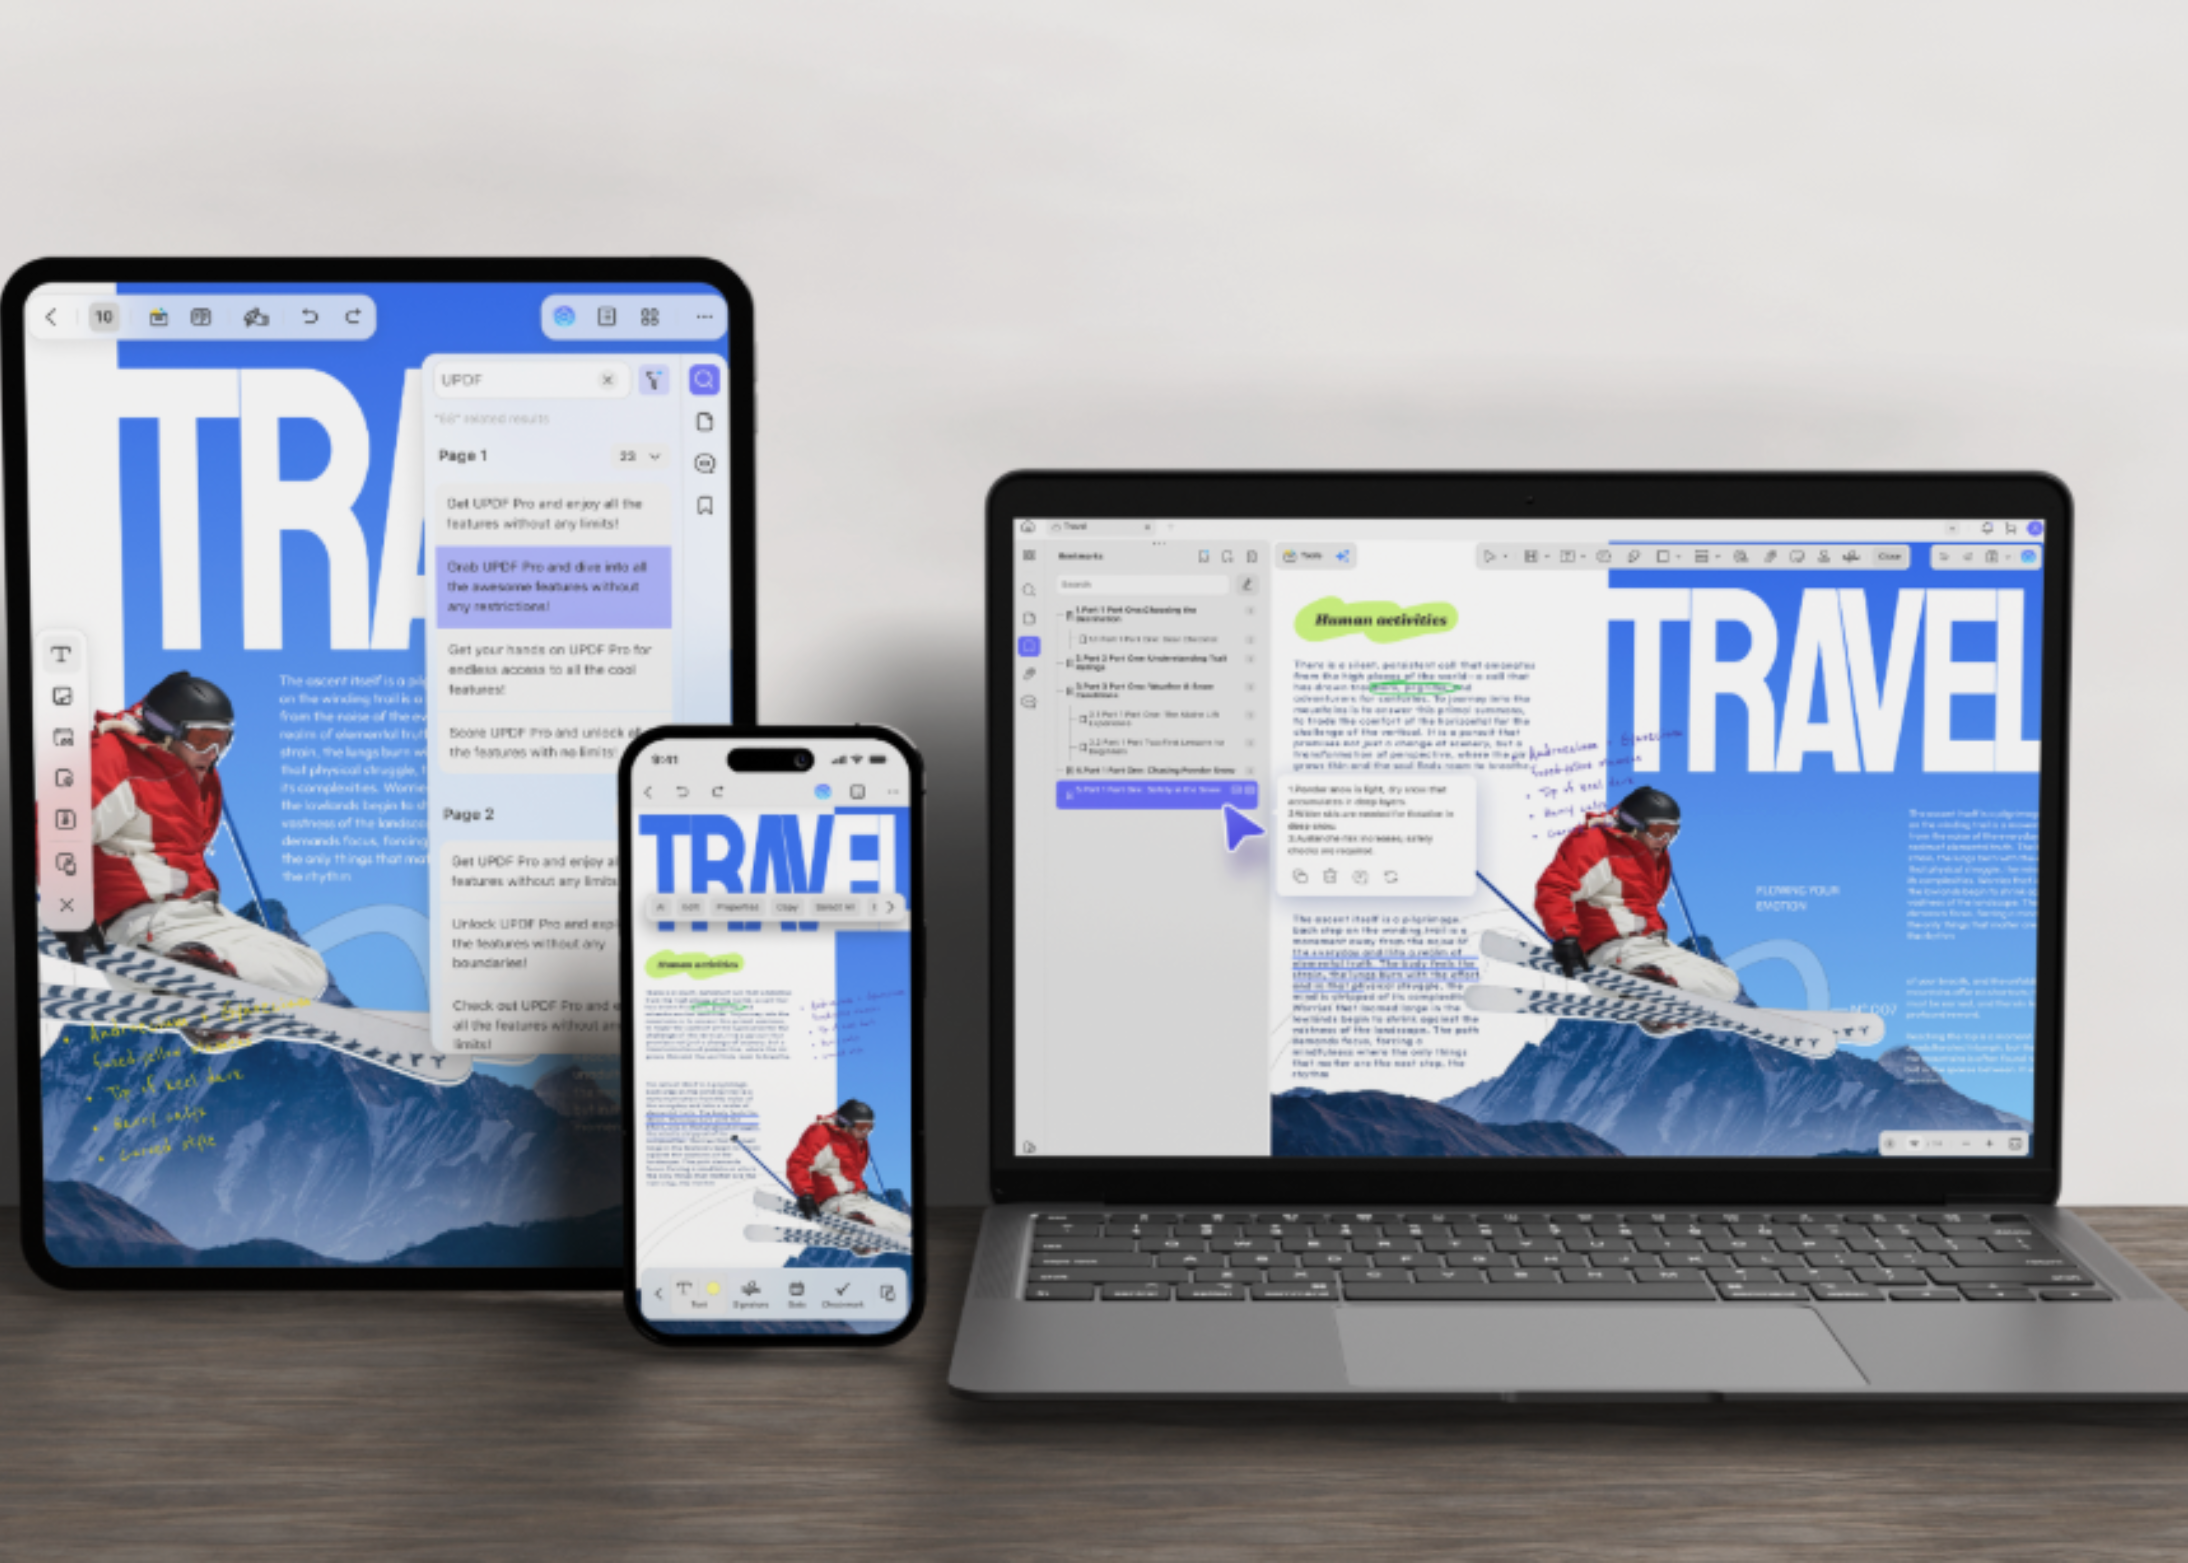
UPDF: легкая альтернатива Adobe с искусственным интеллектом для работы с документами
Обзор универсального PDF-редактора UPDF, объединяющего инструменты редактирования, конвертации, OCR и встроенного AI-ассистента.
Читать далее