
Мой блог
Reducto выпустила модель r-1: распознавание документов в один проход за 1 цент за страницу

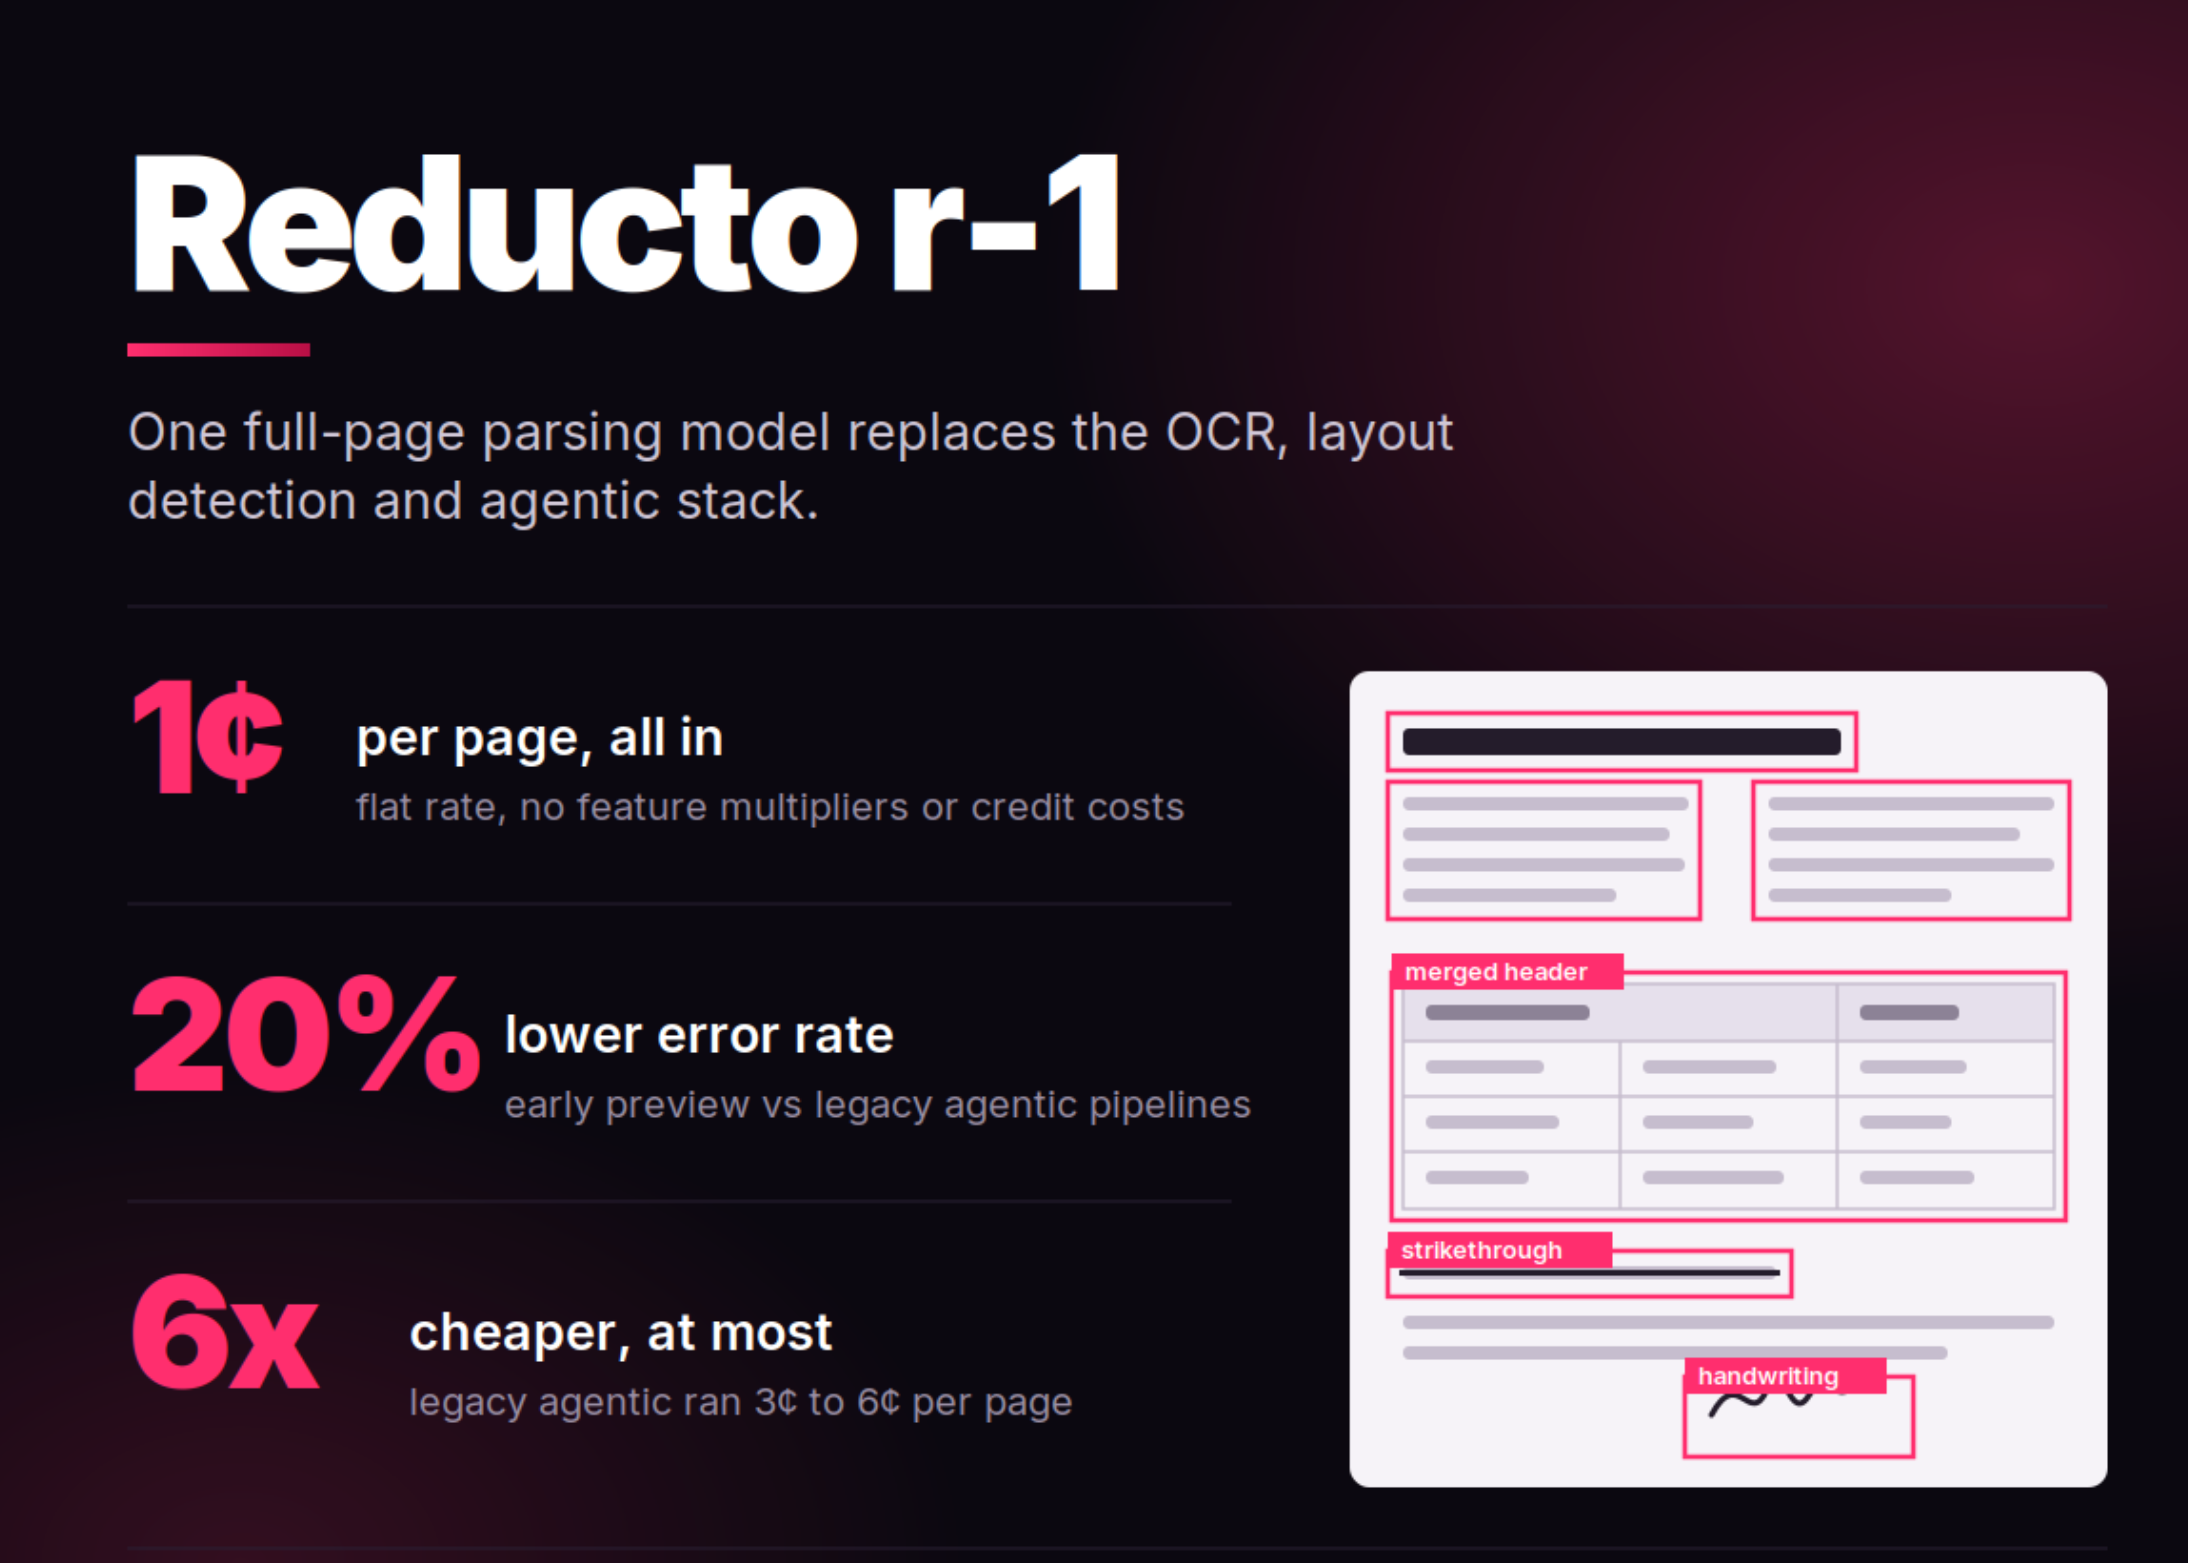
Модель Reducto r-1: распознавание документов в один проход за 1 цент за страницу
Разработчики из компании Reducto представили модель r-1 — новое решение для анализа и парсинга документов, построенное на полностью обновленной архитектуре. Главное технологическое изменение заключается в отказе от многоэтапного агентского конвейера OCR в пользу единственного полного прогона по странице. По заявлениям разработчиков, модель r-1 не только превосходит прежние флагманские алгоритмы компании по точности, но и работает значительно быстрее, снижая затраты на обработку до шести раз.
На сегодняшний день инструмент уже доступен для пользователей в рамках публичного превью. Модель r-1 интегрирована в облачный Parse API версии V3 и активируется через специальный флаг в конфигурации запроса. Модель распространяется с закрытым исходным кодом, поэтому локальные весы для самостоятельного развертывания недоступны. При этом платформа Reducto поддерживает варианты развертывания в мультиарендном облаке, изолированном клиентском VPC, локальных серверах (on-premises) и полностью изолированных системах (air-gapped), соответствуя стандартам безопасности SOC 2 Type II и HIPAA на корпоративных тарифах.
Один проход вместо сложного конвейера
Прежняя архитектура системы Parse выполняла обработку документа в несколько последовательных шагов: отдельно запускались оптическое распознавание символов (OCR), определение макета страницы и последующая пост-обработка текста. При необходимости поверх этой цепочки накладывались дополнительные агентские визуально-языковые модели. Каждый такой обратный вызов к отдельным нейросетям неизбежно увеличивал общую задержку (latency) при обработке файла.
В отличие от устаревшего подхода, r-1 объединяет все ключевые этапы в единый сквозной проход по всей странице. В рамках одного цикла модель одновременно извлекает печатный текст, структуры таблиц, графические элементы, определяет визуальный макет, правильный порядок чтения, элементы форматирования и привязку данных к координатам (grounding). Каждый распознанный блок возвращается с относительными координатами ограничивающих рамок (bounding boxes), что позволяет точно сопоставить извлеченный фрагмент с его фактическим положением на исходной странице.
Такая консолидация функций представляет собой главное практическое преимущество системы. На практике инженеры, работающие с финансовой отчетностью, страховыми исками или договорами, вынуждены использовать сервисы разных провайдеров и достраивать сложную пост-обработку для достижения приемлемого качества. Модель r-1 устраняет затраты на оркестрацию множества сервисов, предлагая решение «все в одном» вместо сложной инфраструктуры.
Показатели точности и финансовая выгода
Согласно данным внутренних тестов Reducto, раннее превью r-1 продемонстрировало снижение количества ошибок на 20% по сравнению с собственными агентскими конвейерами предыдущего поколения. Кроме того, компания заявляет, что на сложных документах новая модель обошла популярные гиперскейлерные решения и крупные языковые модели. В качестве основных конкурентов для сравнения в релизе упоминаются такие сервисы, как Amazon Textract и Azure Document Intelligence.
С точки зрения ценообразования разница оказалась крайне существенной. Прежние агентские алгоритмы требовали от 3 до 6 центов за обработку одной страницы в зависимости от сложности задачи. Стоимость использования r-1 составляет фиксированный 1 цент за страницу («все включено»). Компания подчеркивает, что здесь отсутствуют скрытые множители функций или дополнительная плата за включение высоких настроек точности — фиксированный тариф покрывает полный цикл обработки.
Важно учитывать несколько оговорок касательно опубликованных метрик. Заявленное 20-процентное сокращение ошибок измерялось относительно собственной предыдущей архитектуры Reducto, а не сторонних систем. Кроме того, сравнение с продуктами гиперскейлеров и сторонними LLM проводилось самой компанией в изолированных тестах, без публикации открытого набора данных (benchmark) или публичного стенда для проверки.
Какие задачи на странице решает r-1
Исходя из официальной документации, в рамках одного прохода модель r-1 нативно обрабатывает широкий спектр элементов и особенностей оформления:
- Цифровой печатный текст, сканированные копии документов и рукописный ввод;
- Разбор структуры таблиц с учетом контекста всей страницы, включая корректное определение объединенных ячеек и вложенных заголовков;
- Многоколоночная верстка, верхние и нижние колонтитулы, боковые панели и правильная последовательность чтения текста;
- Обнаружение иллюстраций и графиков с автоматической генерацией их краткого текстового описания;
- Сохранение смыслового форматирования: заголовки, списки, полужирный шрифт, подчеркивания и зачеркнутый текст;
- Точная привязка контента через координаты ограничивающих рамок относительно размеров страницы.
Особое внимание разработчики уделяют сложным краевым случаям (long tail cases): плотным таблицам, нестандартным макетам, сканам низкого качества, текстам с водяными знаками и документам без четкого шаблона. В жестко регулируемых отраслях подобные нюансы имеют решающее значение. Например, нераспознанный зачеркнутый текст может полностью изменить смысл юридического договора, а ошибка при чтении таблицы приведет к передаче некорректных финансовых показателей дальнейшим автоматизированным агентам.
Порядок миграции и поддержка старого стека
Для перехода на r-1 требуется использование Parse API версии V3. Если в теле запроса параметр settings.model останется незаполненным, система автоматически задействует предыдущую версию Parse. Такой подход гарантирует, что существующие интеграции не сломаются при обновлении API. При этом новые пайплайны, создаваемые в интерфейсе Studio, по умолчанию получают конфигурацию с r-1.
Пример вызова новой модели в коде выглядит следующим образом:
result = client.parse.run(
    input=upload.file_id,
    settings={"model": "r-1"}
)
Агентская обработка не упраздняется полностью. В сценариях, требующих применения пользовательских промптов или специфического извлечения сложных диаграмм, такие страницы продолжают направляться в агентский конвейер. Результаты работы агентских моделей накладываются поверх данных, полученных от r-1, что добавляет дополнительное время ожидания. Командам, планирующим миграцию, рекомендуется свериться со страницей совместимости настроек, так как часть старых параметров в r-1 игнорируется.
Разработчики Reducto также анонсировали следующий этап развития линейки: компактную модель r-1 mini для задач, критичных к скорости и бюджету, а также функцию автоматической маршрутизации страниц, которая будет сама подбирать оптимальную модель для каждого листа в документе. Для компаний, переходящих с других сервисов парсинга, Reducto предлагает до $5 000 в виде кредитов для проведения параллельного сравнительного тестирования.
Главные выводы
Запуск r-1 демонстрирует переход от громоздких многоэтапных конвейеров к монолитным специализированным нейросетям для парсинга документов. Объединение OCR, анализа верстки, распознавания таблиц и форматирования в один проход снижает ошибки на 20% и уменьшает стоимость обработки до фиксированного 1 цента за страницу. Инструмент доступен в превью через Parse API V3 и уже готов к тестированию в продуктивных системах.
Источник: www.marktechpost.com
