
Мой блог
Reducto выпустила r-1: модель парсинга документов за один проход

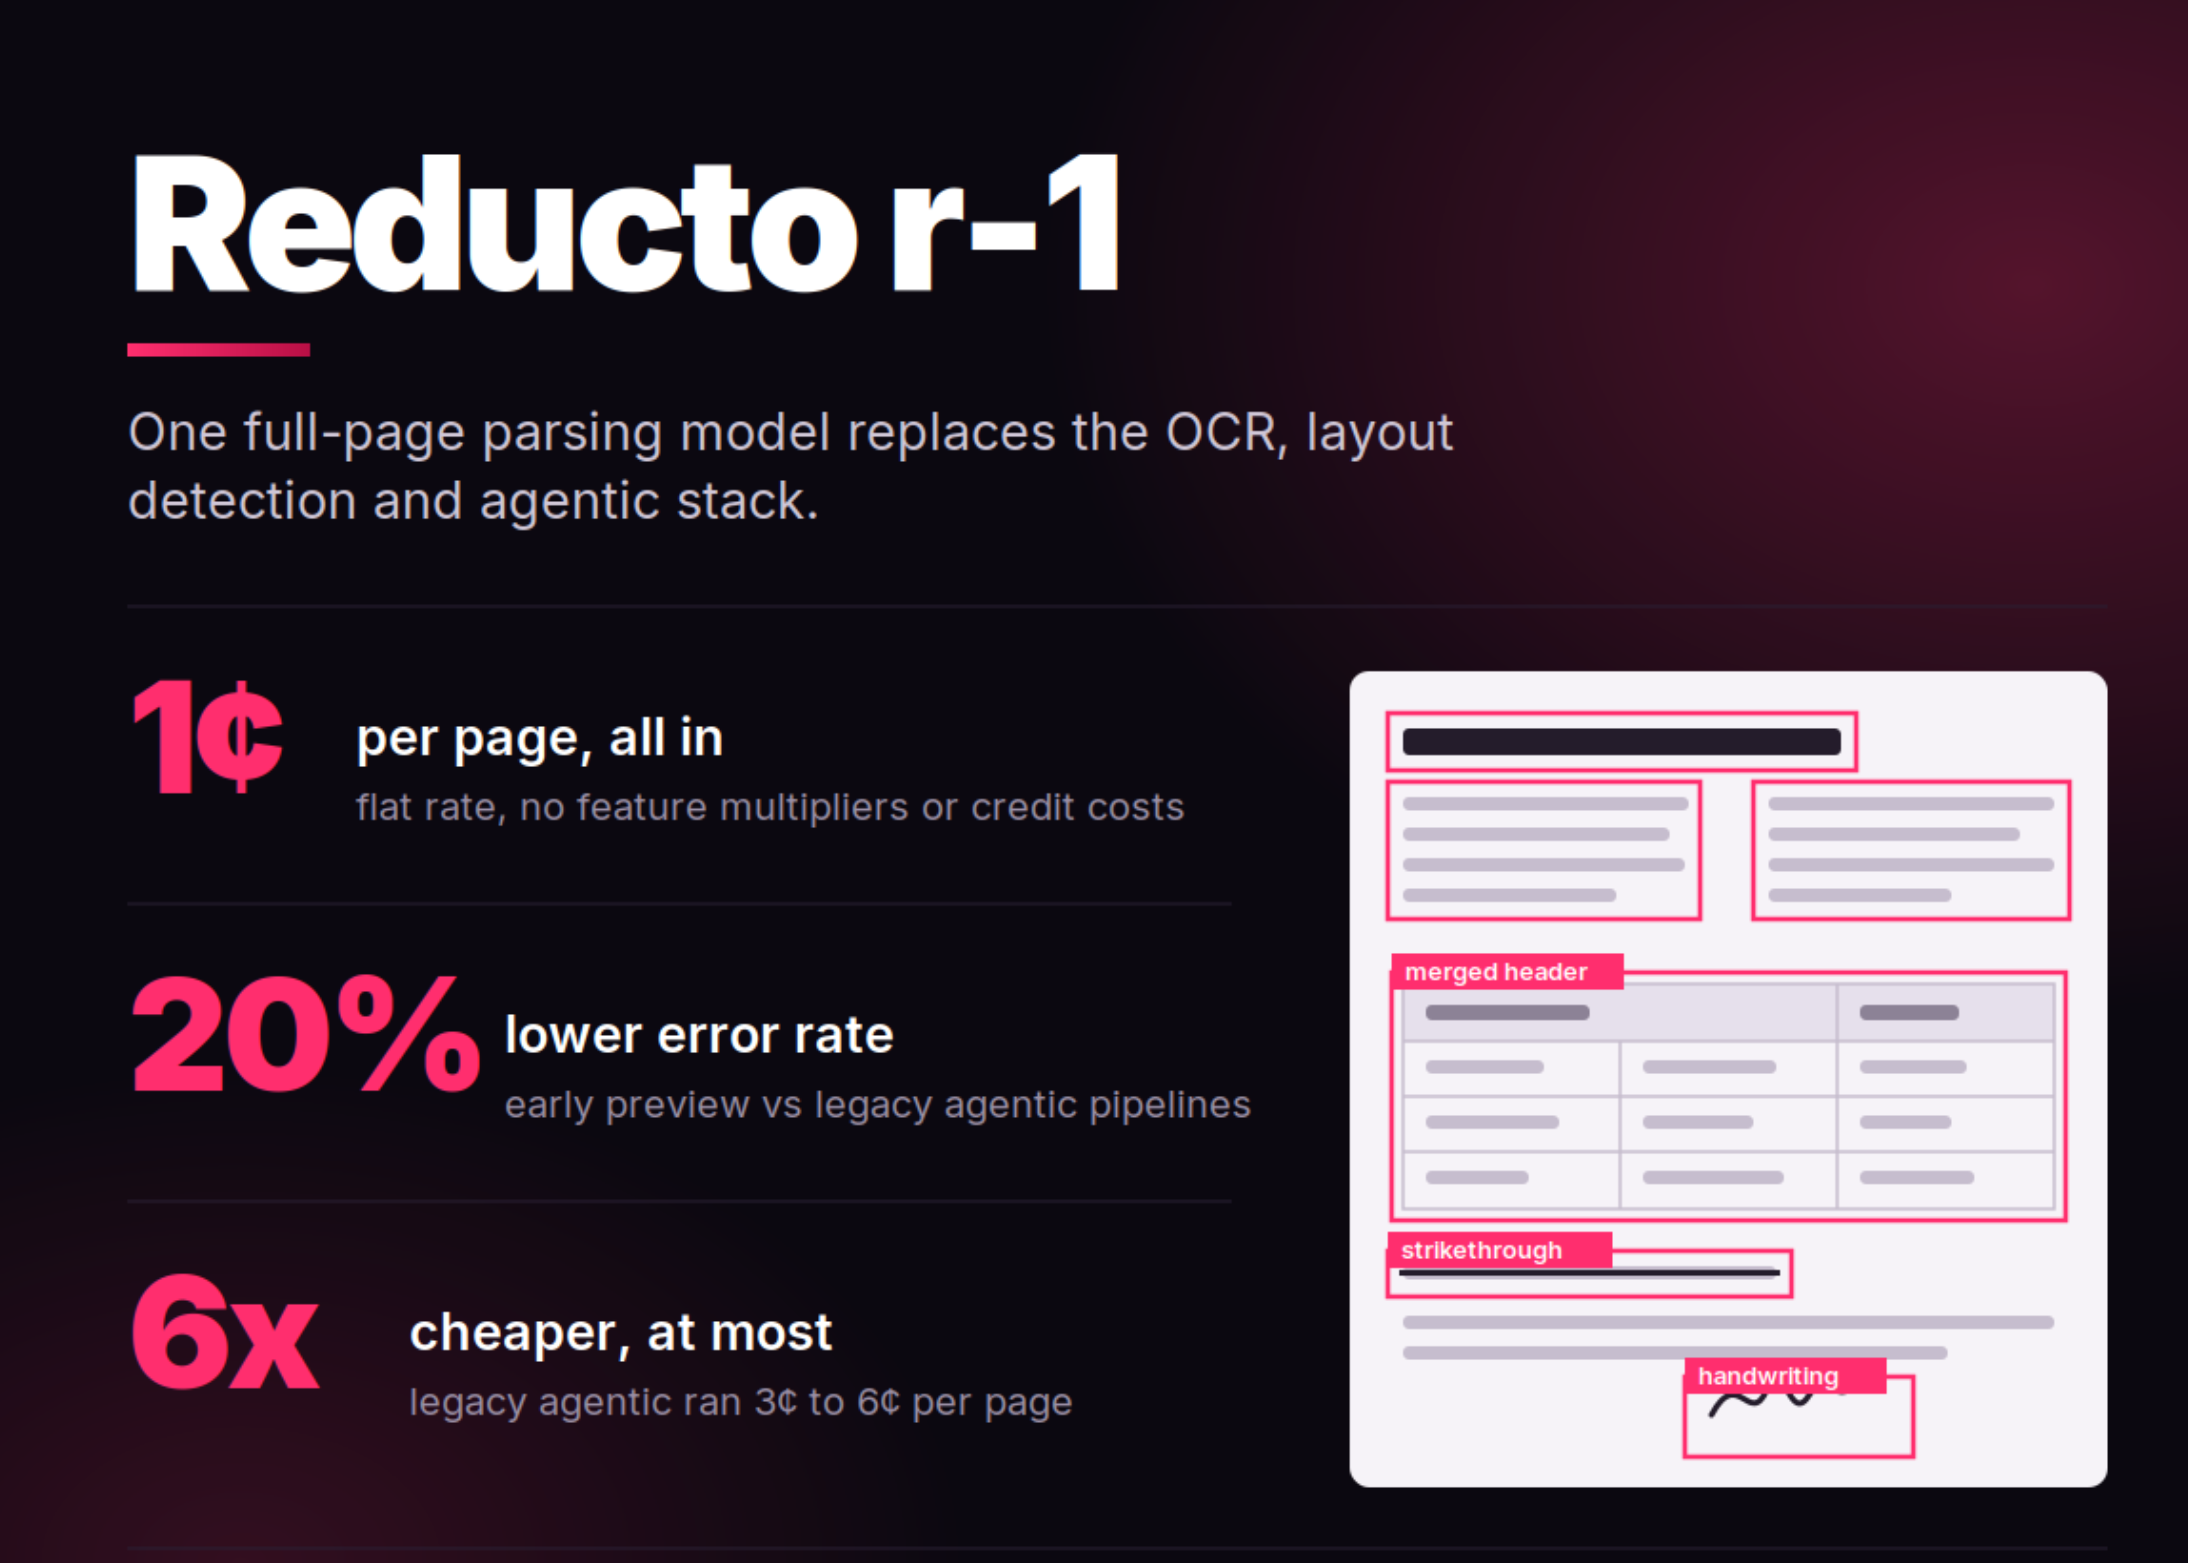
Компания Reducto анонсировала выпуск r-1 — первой модели в новом семействе инструментов для парсинга документов, созданной на базе полностью переписанной архитектуры. Новая разработка заменяет многоступенчатый агентский OCR-пайплайн компании на один проход по всей странице целиком. По заявлению создателей, r-1 превосходит по точности самые мощные предыдущие агентские модели, работает быстрее и обходится значительно дешевле. Инструмент уже доступен для развертывания в режиме превью. Модель r-1 функционирует через облачный интерфейс Parse API третьей версии от Reducto и активируется с помощью специального флага конфигурации. Открытых весов или локальных чекпоинтов для самостоятельного хостинга не предусмотрено. При этом платформа компании поддерживает многопользовательские облачные развертывания, изолированные клиентские VPC, локальные инсталляции и изолированные среды без доступа к интернету (air-gapped), обладая аттестацией SOC 2 Type II и поддерживая обработку данных по стандартам HIPAA на старших тарифных планах в соответствии с политиками безопасности.
Один проход вместо сложного конвейера
Традиционный синтаксический анализ выполняет распознавание текста, определение макета и постобработку в виде отдельных этапов, поверх которых часто накладываются дополнительные проходы визуально-языковых моделей. Каждое лишнее обращение к модели увеличивает общую задержку. В модели r-1 текст, таблицы, иллюстрации, разметка, порядок чтения, форматирование и привязка к координатам объединены в один проход по странице. Каждый блок возвращается с относительными рамками (bounding boxes), которые связывают контент с его точным расположением на бумажном или цифровом листе. Именно такое объединение шагов является ключевым технологическим преимуществом. Команды, работающие со сложной финансовой отчетностью, страховыми требованиями или договорами, обычно вынуждены направлять файлы через нескольких разных провайдеров и подключать дополнительную постобработку ради достижения приемлемой точности. Новая модель нацелена на снижение этих издержек на оркестрацию, а не только на повышение базового качества распознавания символов.
Метрики эффективности и сравнение
Разработчики сообщают о снижении уровня ошибок на 20% в ходе раннего превью r-1 по сравнению с собственными устаревшими агентскими конвейерами. Кроме того, внутренние тесты показали, что новинка превзошла широко используемые продукты крупных облачных провайдеров и крупные языковые модели на сложных документах. В качестве основных базовых аналогов в пресс-релизе упоминаются Amazon Textract и Azure Document Intelligence. Что касается стоимости, то старые агентские решения обходились в сумму от 3 до 6 центов за страницу в зависимости от рабочей нагрузки. Новая модель оценивается в 1 цент за страницу по принципу «все включено», без скрытых коэффициентов или дополнительных кредитных затрат для достижения высокой точности. В компании рассматривают это нововведение как часть более широкого перехода к единым фиксированным тарифным сеткам. Стоит отметить, что 20-процентное сокращение ошибок измеряется относительно собственного предшествующего пайплайна Reducto, а не независимого стороннего эталона. Прямое сравнение с облачными гигантами и языковыми моделями проводилось силами самой компании, причем публичный тестовый набор данных или открытый инструмент оценки вместе с анонсом опубликованы не были.
Какие задачи решает r-1 на странице
Согласно технической документации, модель нативно справляется со следующими задачами в рамках единого прохода по странице:
- цифровой текст, сканы документов и рукописный ввод;
- структура таблиц с учетом окружающего контекста страницы, включая объединенные ячейки и вложенные заголовки;
- колонки, заголовки, нижние колонтитулы, боковые панели и корректный порядок чтения;
- обнаружение графических элементов с генерацией краткого описания;
- значимое форматирование, включая заголовки, списки, полужирное начертание, подчеркивания и зачеркивания;
- привязка элементов к координатам страницы с помощью относительных ограничивающих рамок.
Среди сложных сценариев, на которых отдельно акцентируют внимание разработчики, выделяются плотные таблицы, нестандартные макеты, низкокачественные сканы, документы с водяными знаками и материалы, не имеющие предсказуемых шаблонов. Пропущенное зачеркивание может полностью исказить смысл пункта контракта, а некорректно прочитанная таблица — передать программному агенту неверное число, поэтому подобные граничные случаи имеют критическое значение в регулируемых рабочих процессах.
Путь миграции и особенности старого стека
Для работы r-1 требуется применение API третьей версии. Запросы на парсинг, в которых явно не указан параметр настроек модели, продолжают выполняться через устаревший механизм, поэтому существующие процессы не прекратят работу неожиданно. Новые пайплайны, создаваемые в инструментальной среде Studio, используют r-1 по умолчанию. Пример вызова выглядит следующим образом: result = client.parse.run(input=upload.file_id, settings={“model”: “r-1”}). При этом агентская обработка не исчезает полностью. Рабочие процессы, требующие использования пользовательских промптов или расширенного извлечения диаграмм, по-прежнему маршрутизируют такие страницы через агентский конвейер, результаты которого Reducto объединяет с выводом r-1, что, однако, увеличивает общую задержку выполнения.
Командам, которые планируют перенос уже существующих конфигураций, перед началом работ рекомендуется изучить страницу совместимости настроек r-1. Часть устаревших параметров здесь не поддерживается или просто игнорируется системой. Разработчики уже анонсировали следующие две версии модели: облегченную r-1 mini, оптимизированную для максимально быстрых и бюджетных задач, а также интеллектуальную маршрутизацию. Последняя будет автоматически подбирать подходящую версию модели отдельно для каждой страницы в зависимости от ее сложности.
Организациям, которые планируют полностью отказаться от сторонних инструментов парсинга документов и протестировать новинку в деле, предлагают специальные условия. Можно запросить до 5000 долларов в виде кредитов на баланс для проведения детального сравнительного тестирования в реальных условиях.
Главные итоги запуска модели r-1
- Модель объединяет распознавание текста (OCR), анализ макета, извлечение таблиц, сохранение форматирования и привязку данных в один общий проход по странице.
- По собственным замерам разработчиков, уровень ошибок сократился на 20% по сравнению с предыдущими многоэтапными агентскими конвейерами.
- Стоимость обработки снизилась с 3–6 центов до фиксированного 1 цента за страницу.
- Инструмент уже доступен в режиме предварительного просмотра через V3 Parse API с помощью параметра
settings.model: "r-1"(открытые веса не публикуются).
Источник: marktechpost.com
