
Мой блог
Как интегрировать AI-агентов в Jira: автоматизация разработки и аналитики через серверный harness

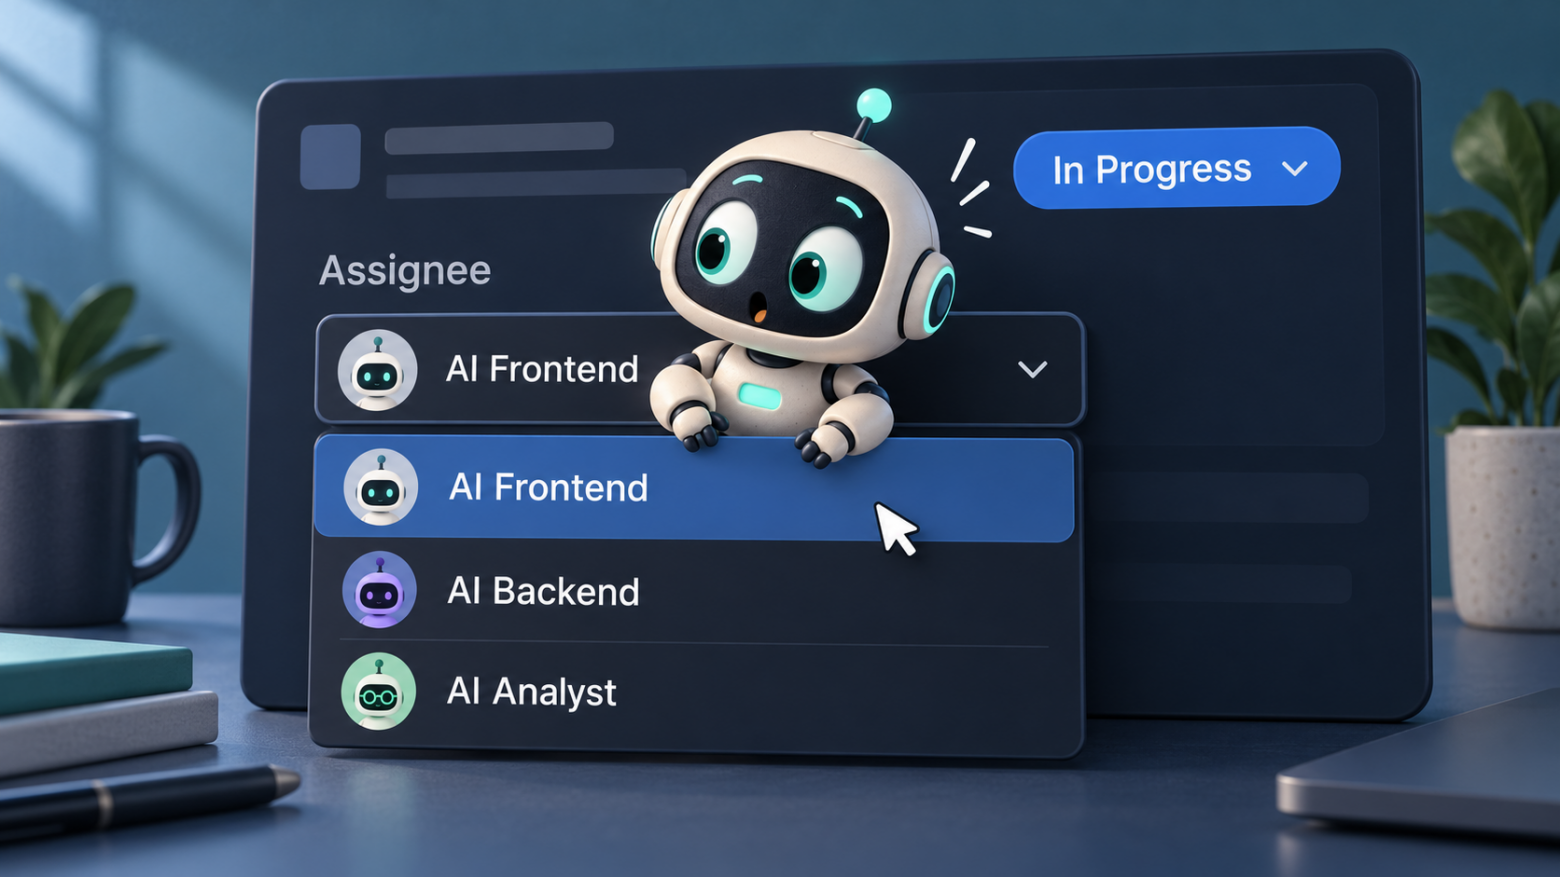
Автоматизация рутинных задач в разработке постепенно выходит за рамки простых автодополнений в редакторе кода. Современная практика показывает, что AI-агенты в Jira способны выступать в роли полноценных исполнителей, закрывая задачи по фронтенду, бэкенду или системному анализу. Для этого используется специализированный серверный harness — рабочая среда, которая связывает трекер задач, репозитории кода и корпоративную базу знаний с языковыми моделями.
В подобной схеме искусственный интеллект не вытесняет специалистов, а берет на себя так называемые oneshot-задачи — понятные, локальные изменения без многоэтапных обсуждений. Финальное слово, валидация гипотез и классическое ревью кода по-прежнему остаются за живыми инженерами, однако сам процесс от формулировки требования до готового merge request ускоряется в разы.
Практический кейс: создание кнопки интерфейса и два merge request
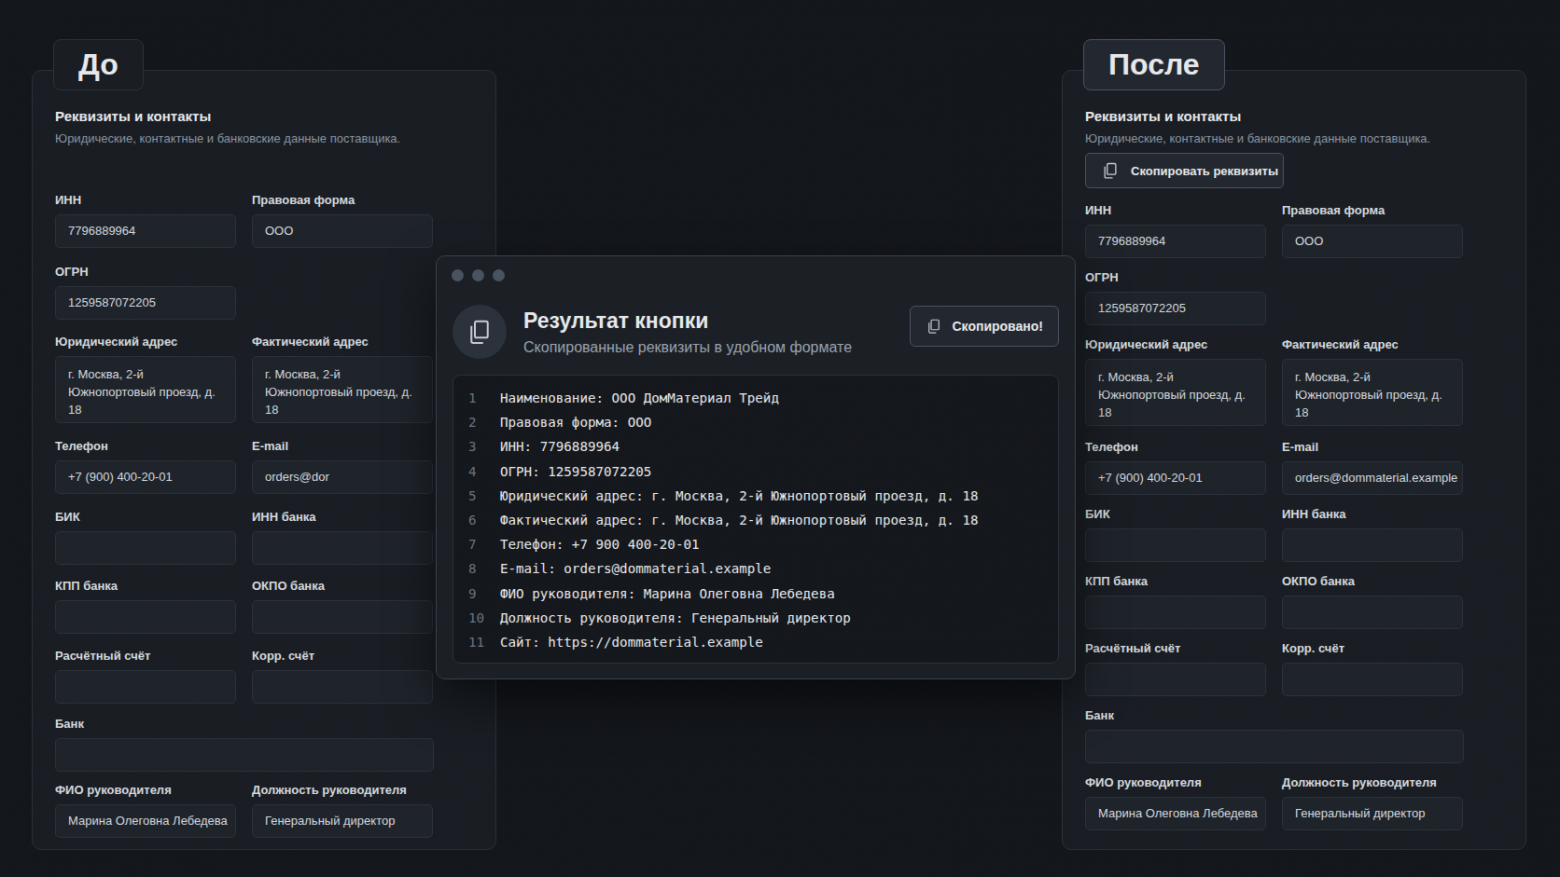
Для демонстрации возможностей системы была взята типовая задача: разместить на карточке поставщика кнопку для быстрого копирования банковских реквизитов. В трекере Jira задача формулировалась предельно лаконично — одной строкой текста, без подробных спецификаций и без макетов оформления.
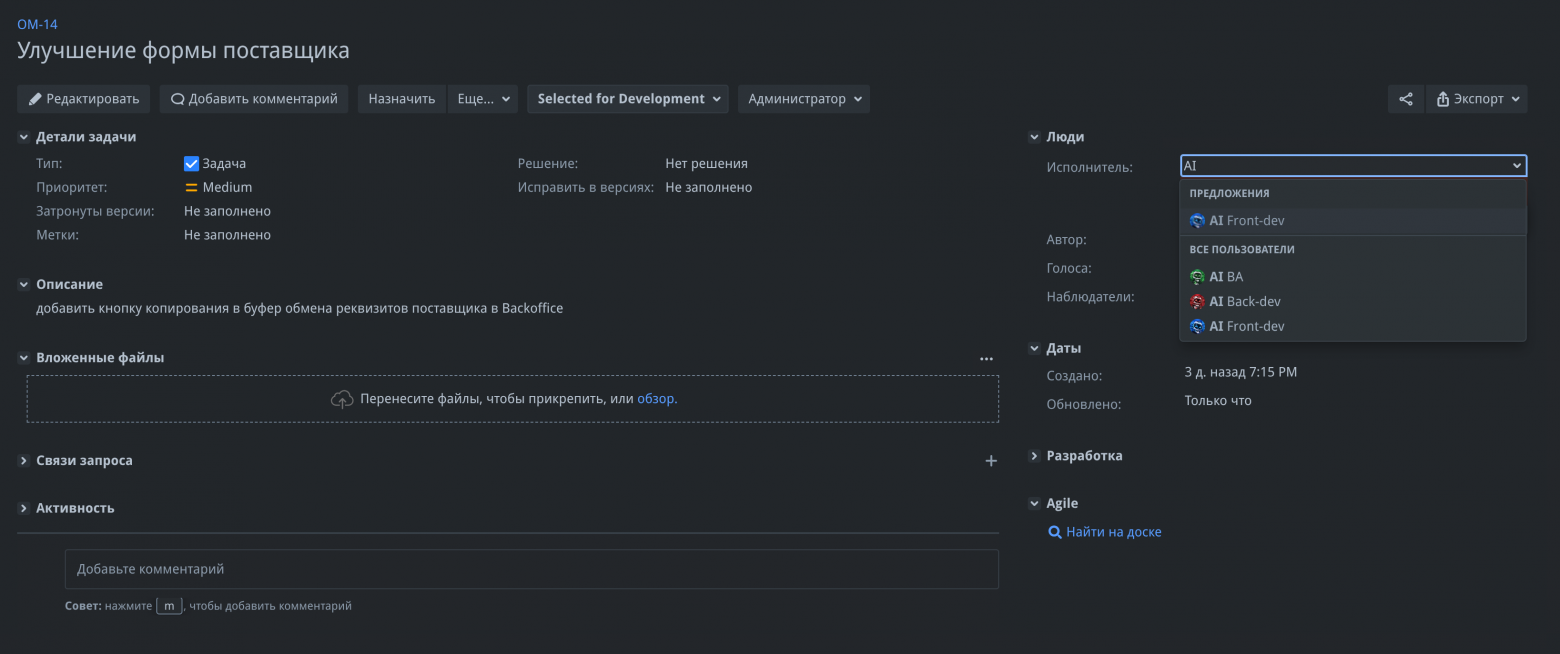
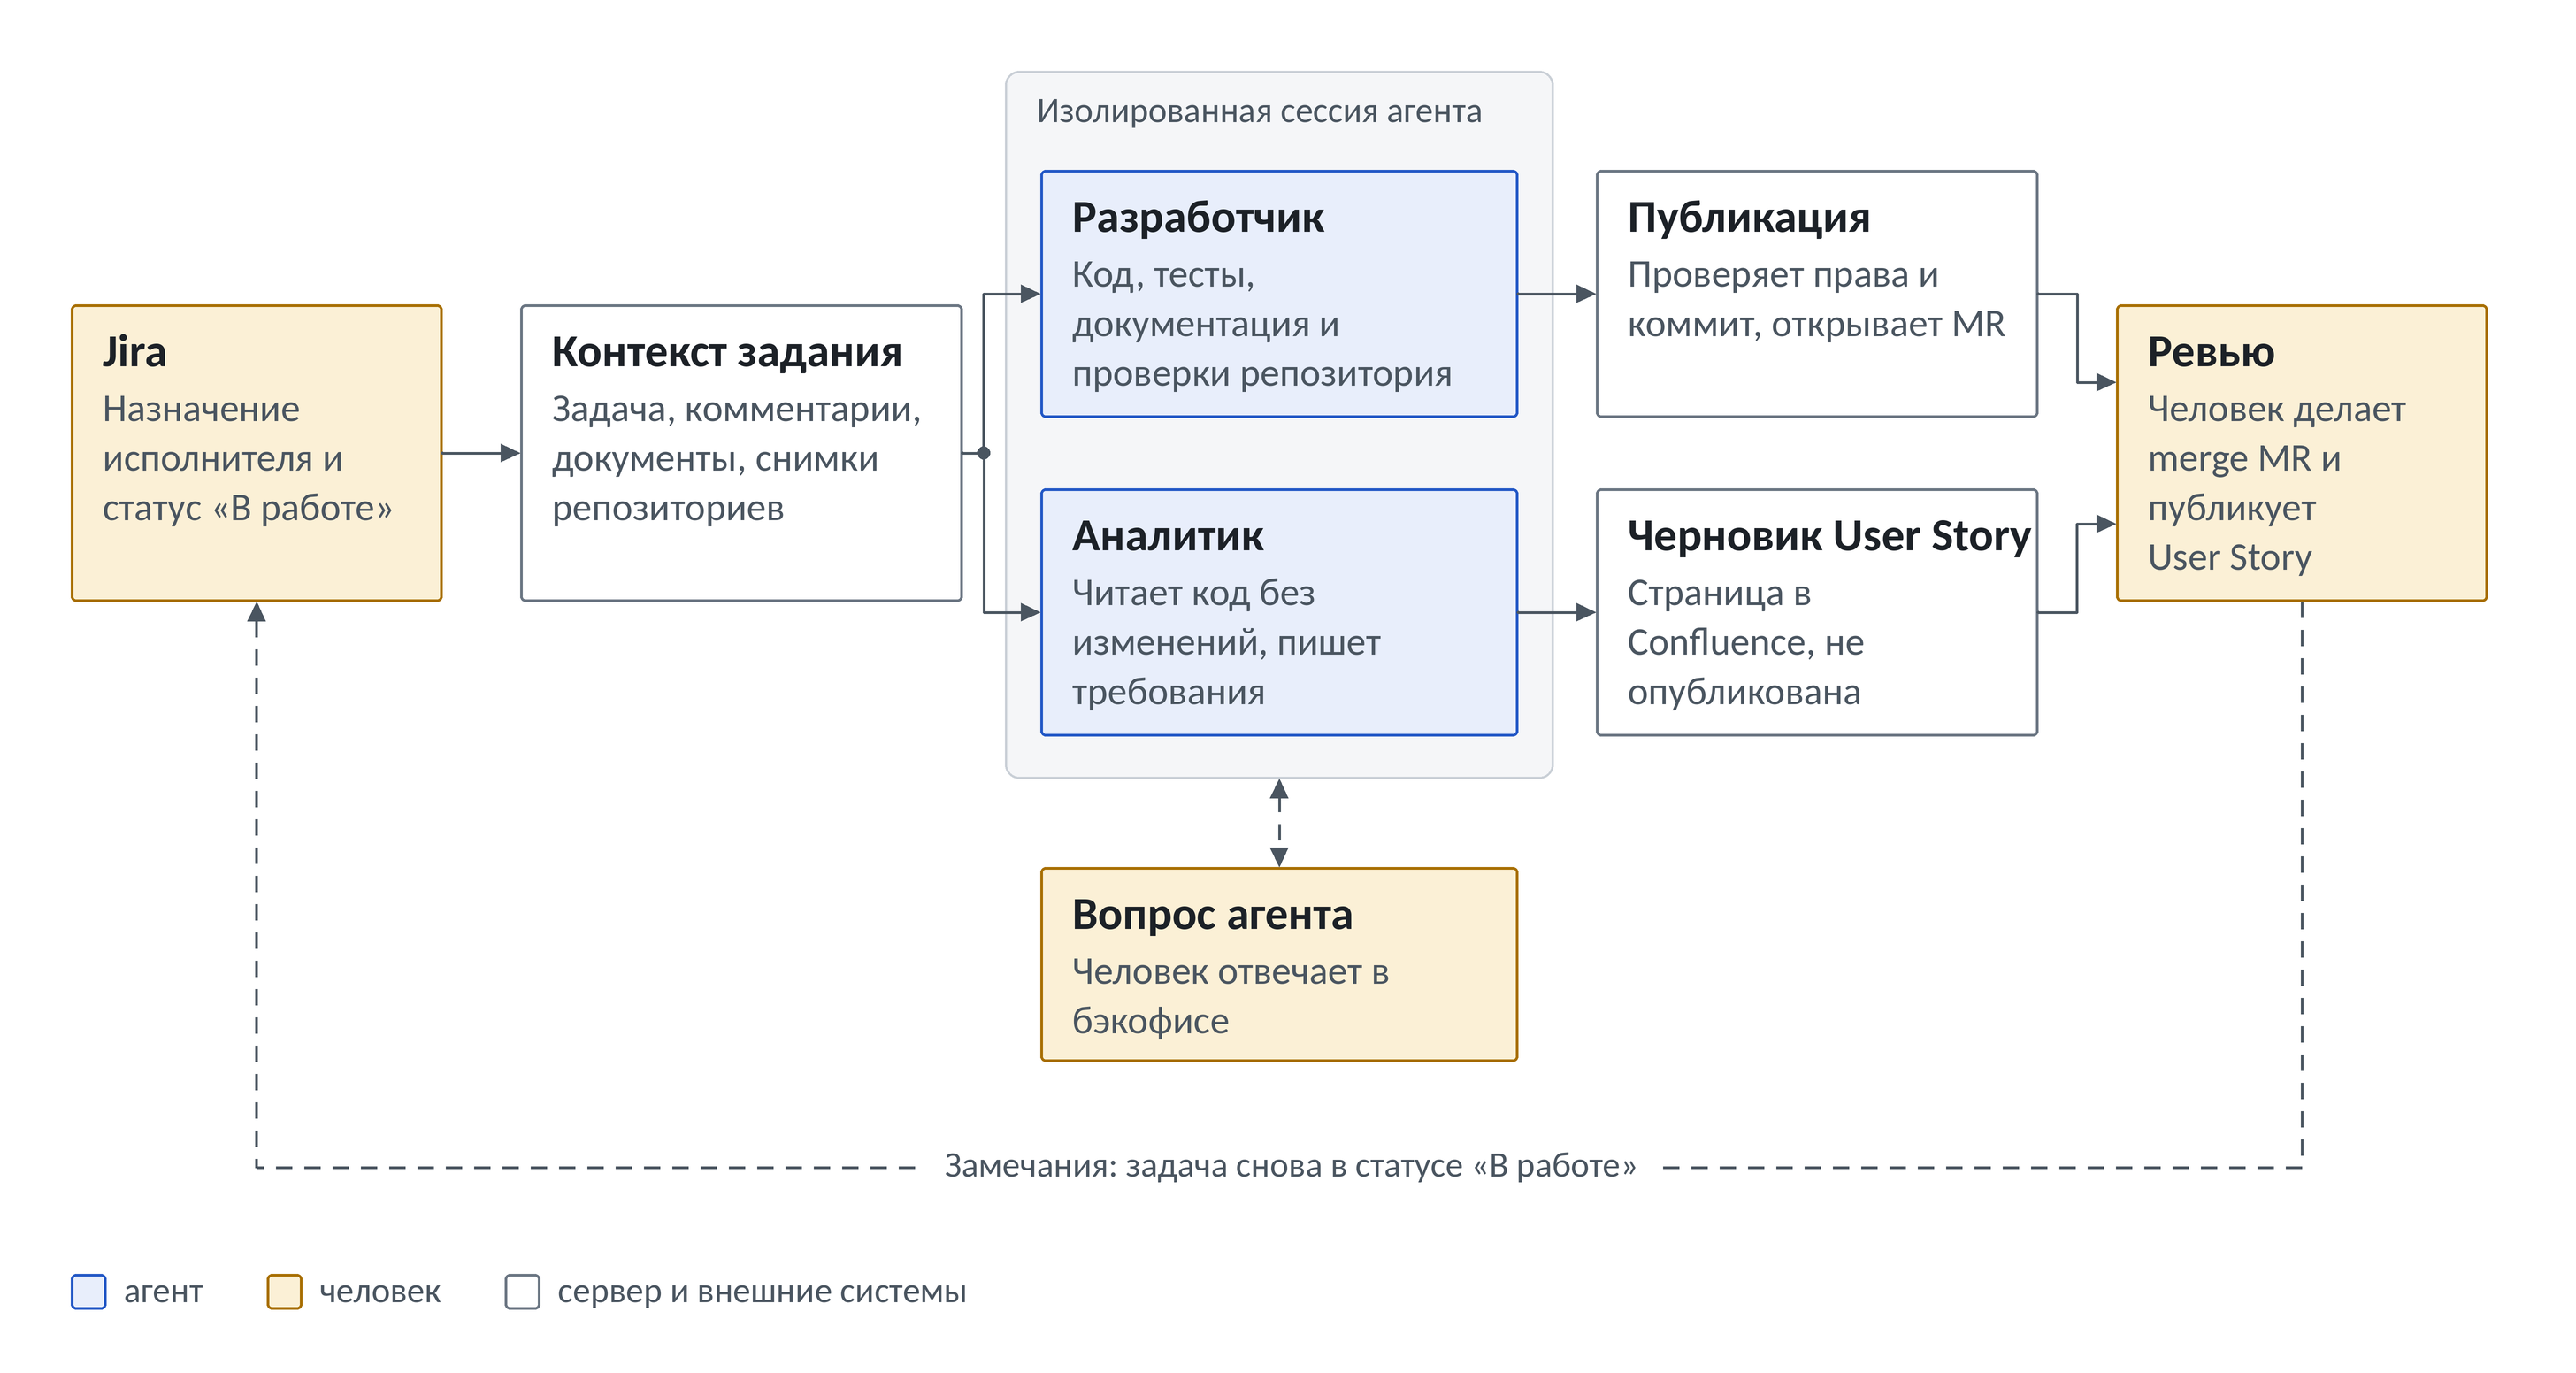
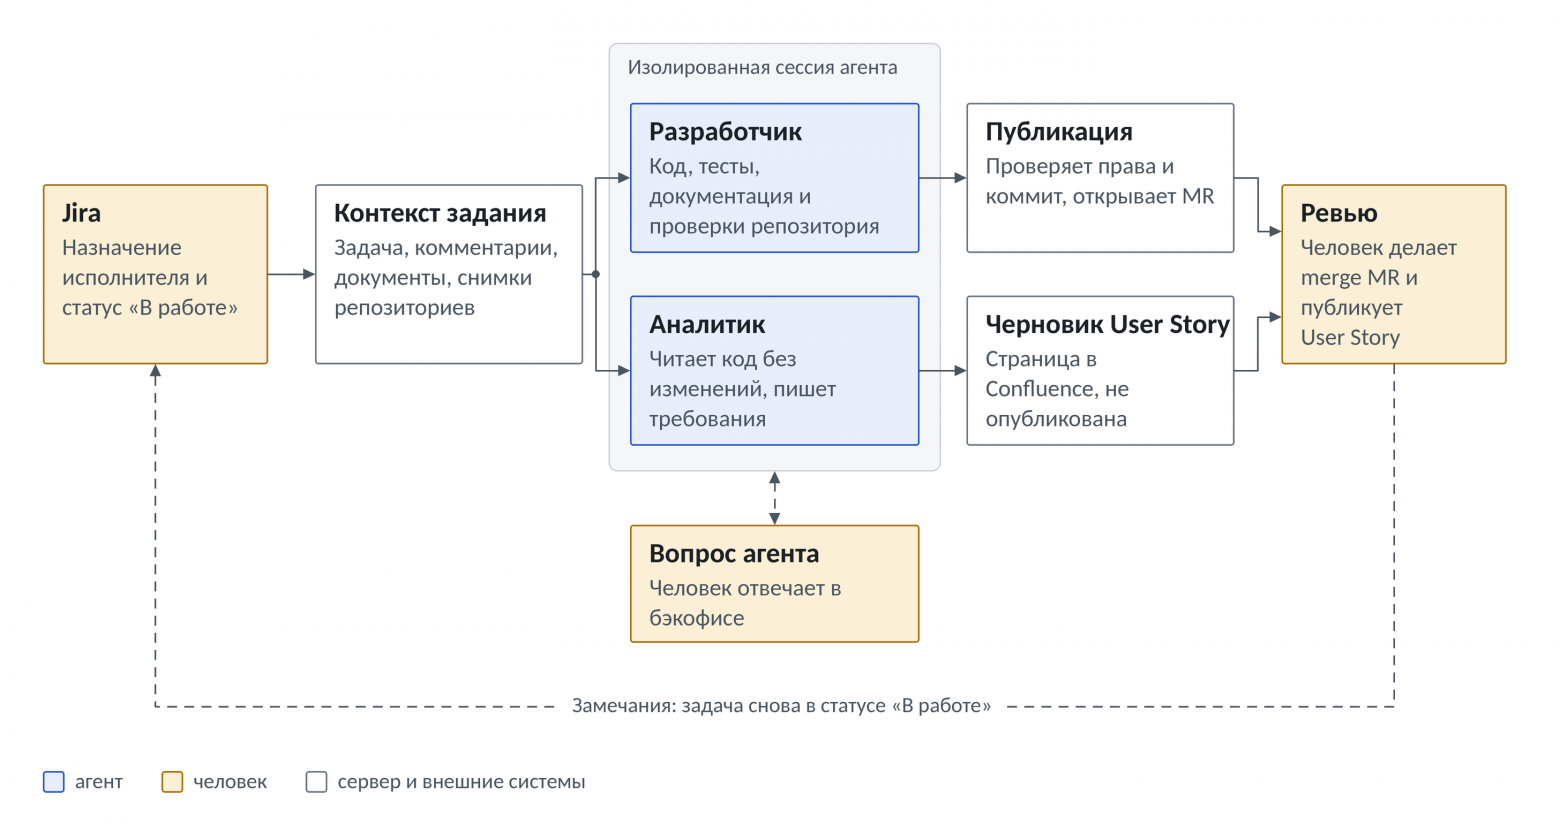
В качестве ответственного лица в поле Assignee был выбран виртуальный исполнитель AI Front-dev, после чего статус задачи изменился на «В работе». После этого серверный harness автоматически сформировал внутренний процесс. Карточка отобразила все этапы: загрузку базовых проектных инструкций, анализ подключенных репозиториев, определение нужных веток и параллельное обновление сопутствующей документации. В процессе выполнения система автоматически зафиксировала системные логи тестов и промежуточные артефакты.
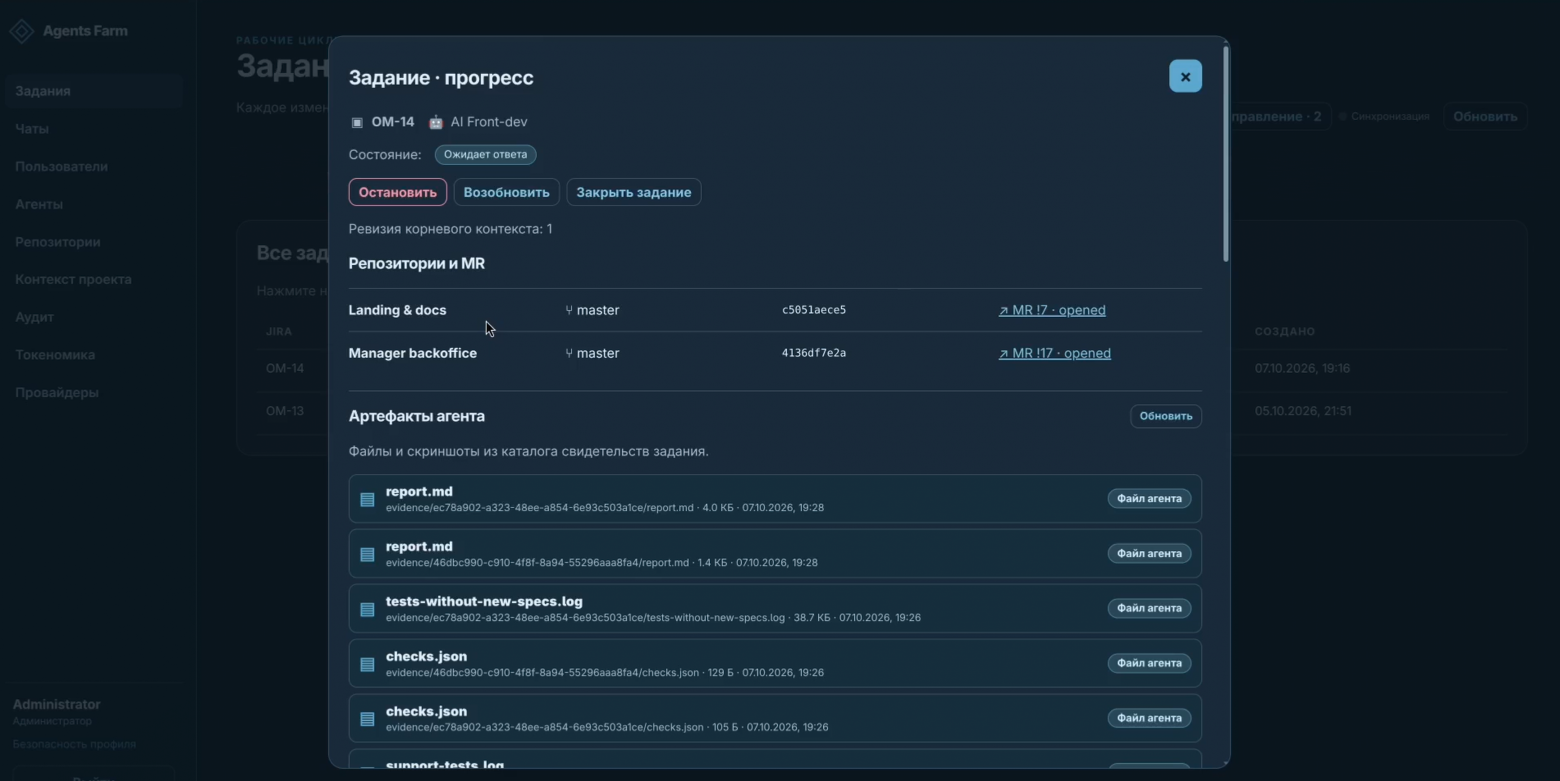
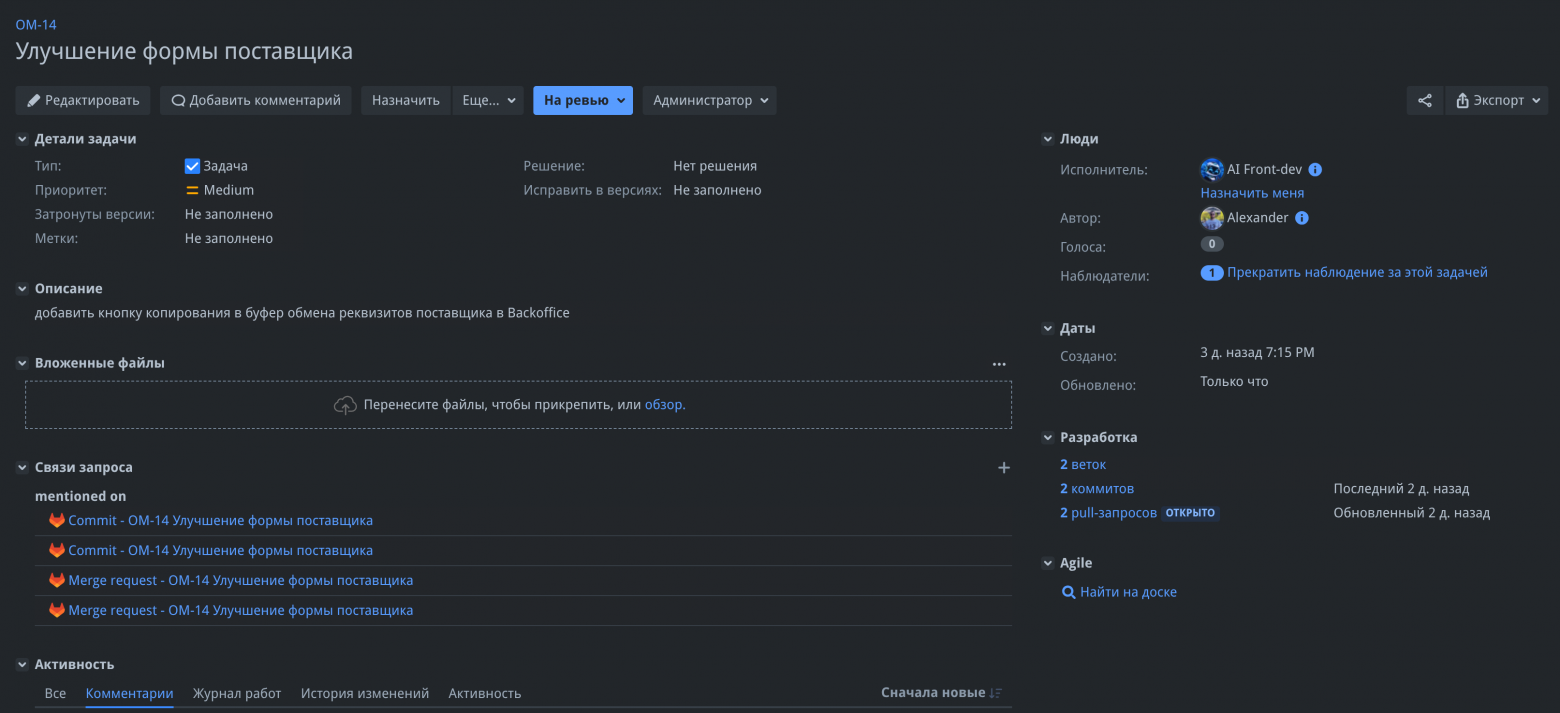
В результате в исходном тикете Jira появились ссылки на два готовых merge request, а задача перешла в статус ожидания ревью. Первый запрос включал обновленную проектную документацию с описанием добавленного функционала, второй — непосредственно исходный код кнопки, тесты и логику взаимодействия с буфером обмена. Кнопка корректно переносила данные поставщика в буфер. Так как в задании отсутствовали макеты из Figma, внешний вид элемента остался стандартным, но с точки зрения архитектурной логики код соответствовал стандартам проекта. Если ревьюер находит ошибки, достаточно оставить комментарии и вернуть тикет в работу: алгоритм считывает замечания и создает коммиты с исправлениями.
Кейс бизнес-анализа: трансформация потребности в User Story
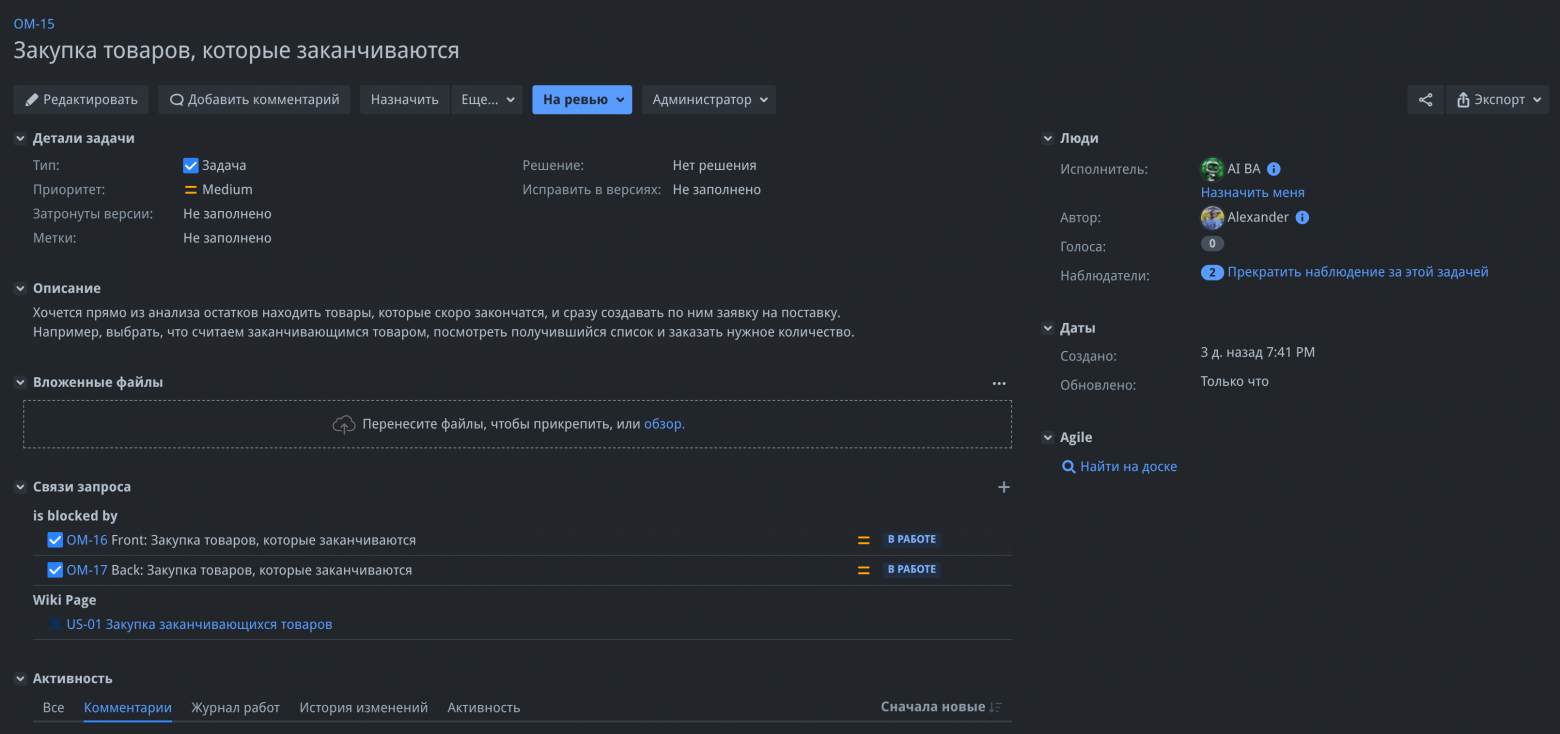
Следующий сценарий демонстрирует работу с абстрактной бизнес-потребностью. В Jira было заведено нетехническое описание: дать возможность пользователю находить заканчивающиеся позиции непосредственно в анализе остатков и формировать по ним заявку на поставку.
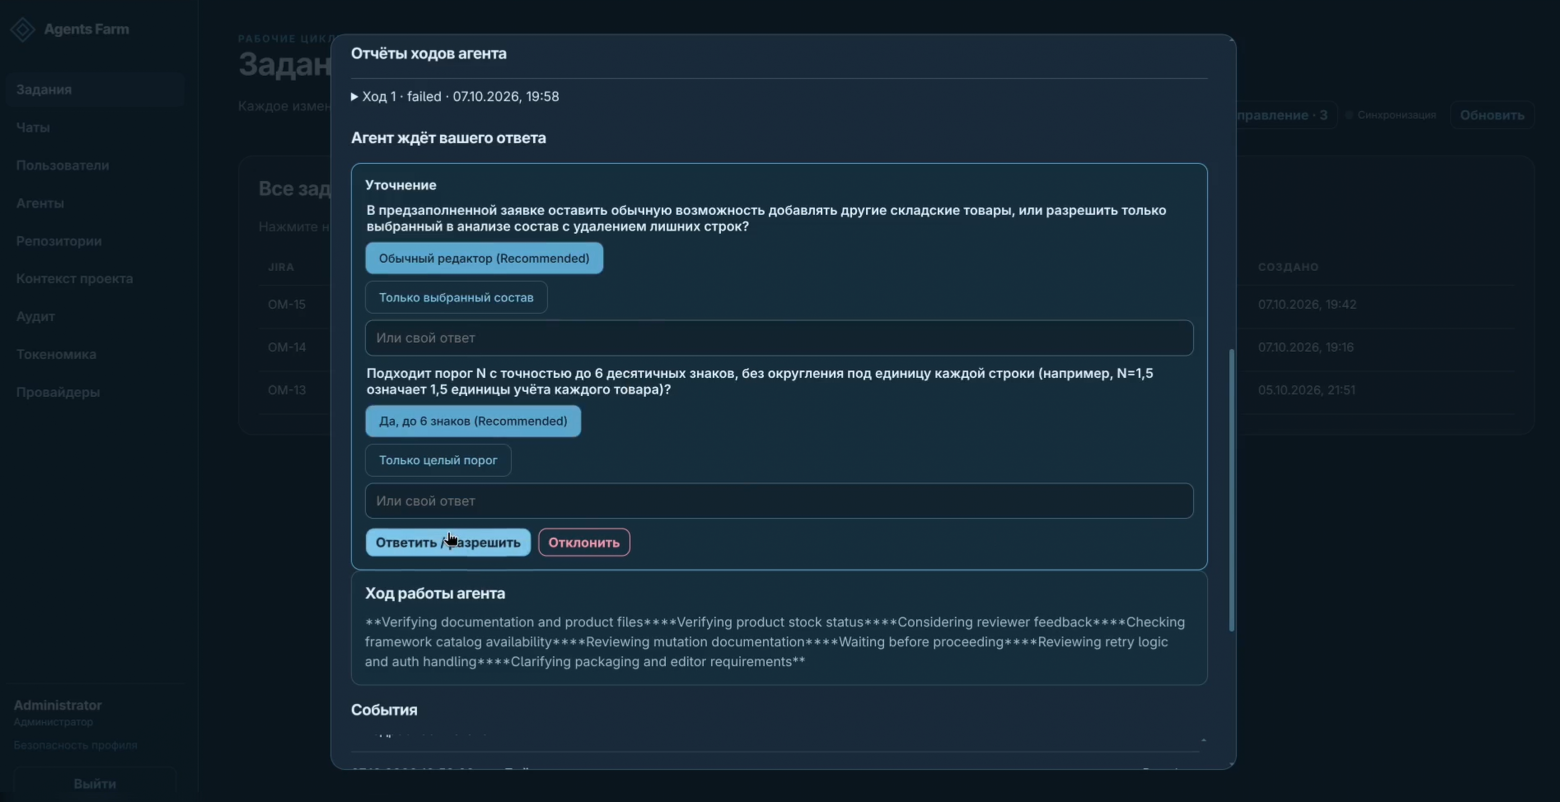
Исполнителем был назначен виртуальный аналитик. В отличие от разработчика, профиль аналитика обладает доступом к кодовой базе только в режиме чтения. Изучив проектную документацию и существующий код, система перешла в состояние ожидания ответа, сформировав список уточняющих вопросов по архитектурным развилкам:
- Допускается ли редактирование состава позиций в уже сформированной заявке или туда переносятся исключительно выбранные строки?
- Каким должен быть формат порога остатков — строго целое число или дробное с высокой точностью?
- К каждому пункту алгоритм сразу сформировал рекомендованный инженерный вариант, оставив выбор за человеком.
После получения обратной связи агент создал черновик спецификации User Story в Confluence. Человек проверил структуру документа, подтвердил его готовность к разработке, после чего система сгенерировала две дочерние задачи — на бэкенд и фронтенд, автоматически назначив их на соответствующих виртуальных разработчиков.
Архитектура серверного решения за полем Assignee
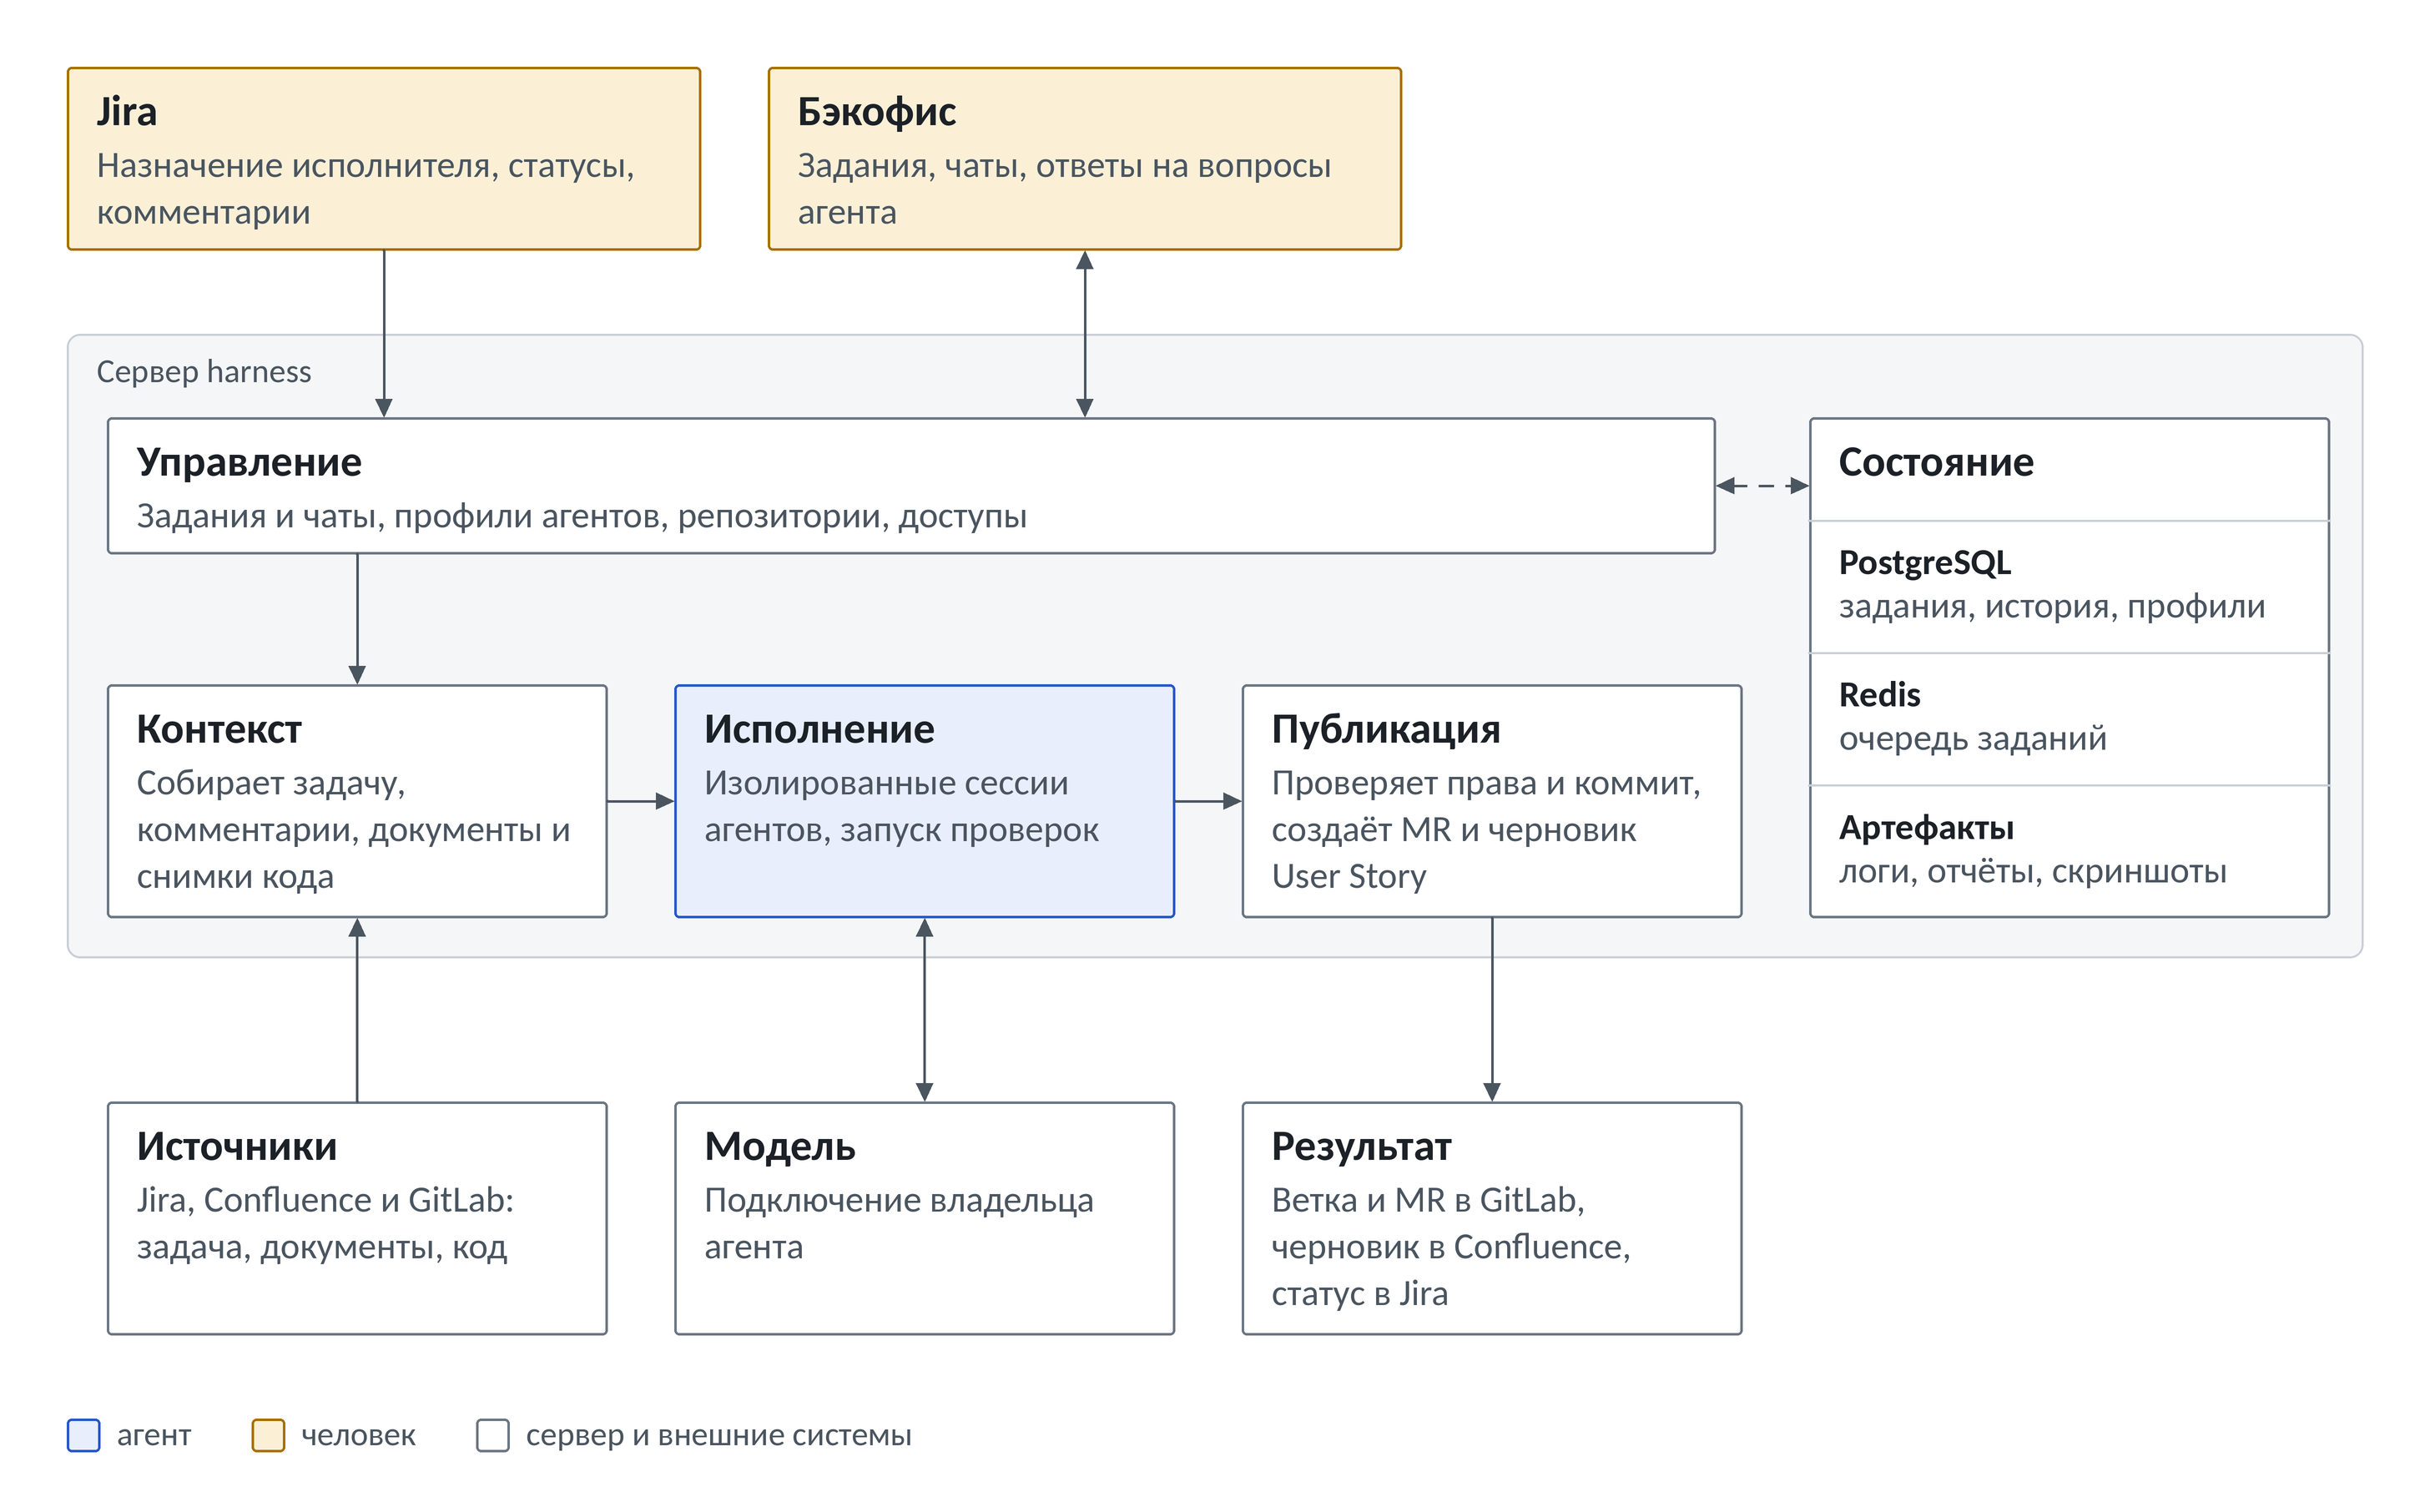
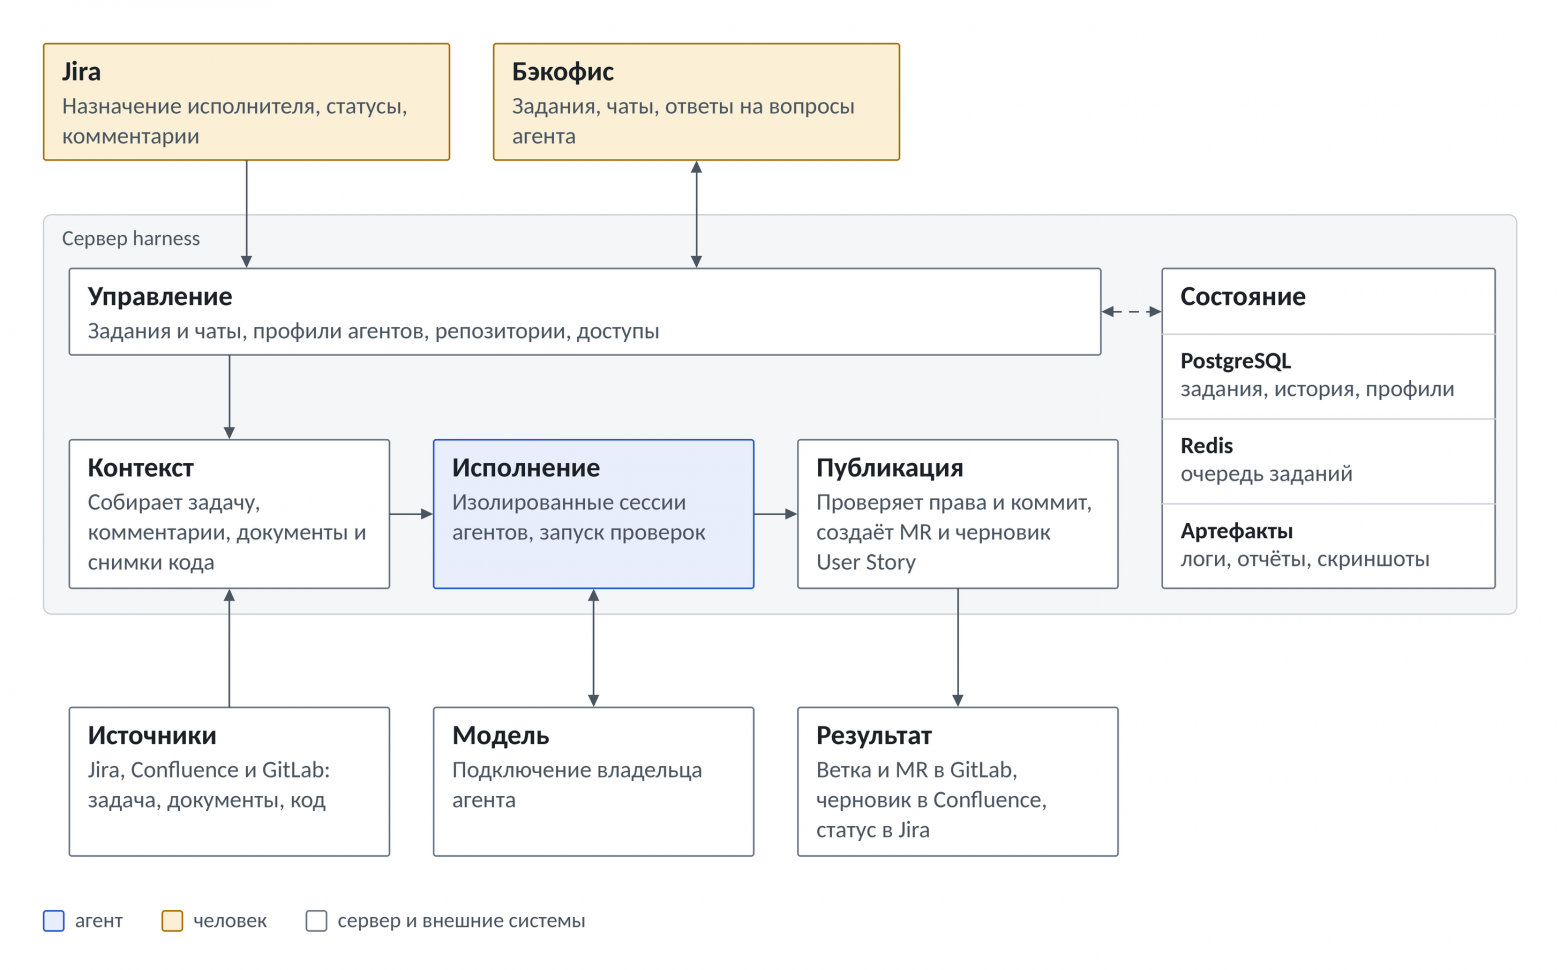
Подключение виртуальных специалистов требует глубокой интеграции инфраструктуры. Каждому профилю в Jira сопоставляется конфигурация внутри harness: задействованная модель, системные промпты, ограничения ролей и параметры доступа.
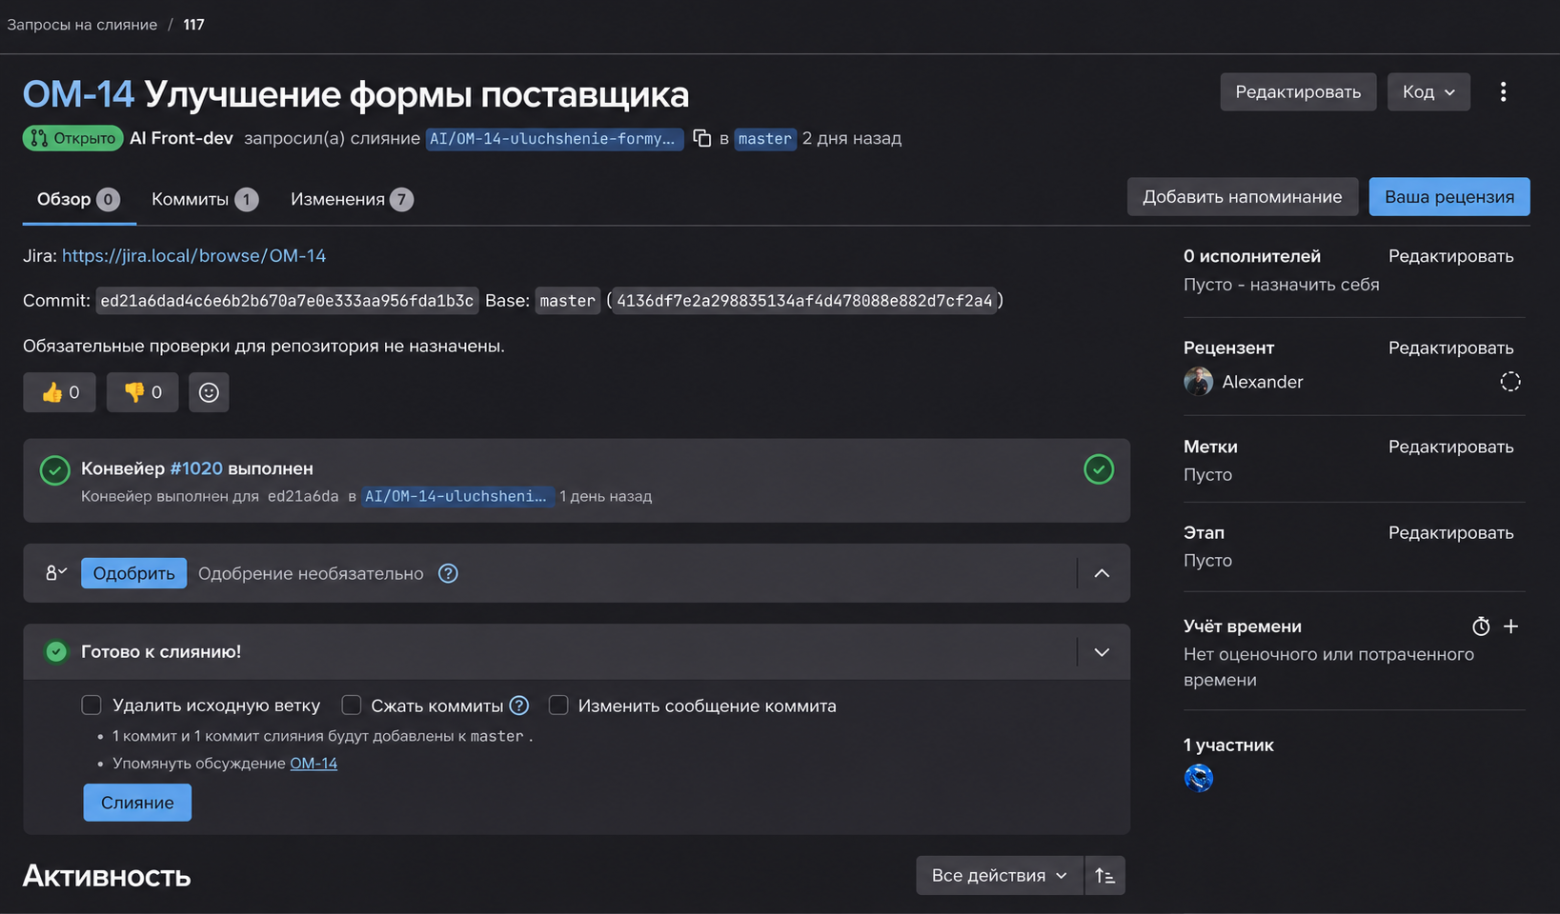
При переводе задачи в статус «В работе» серверная часть проверяет права, формирует контекст и помещает задачу в очередь обработки. Контекст включает тело задачи, комментарии, связанные страницы Confluence, правила проекта и слепки репозиториев на момент старта. Зафиксированные версии позволяют точно понять, на базе каких вводных строился алгоритм.
Процесс исполнения изолирован. Серверные механизмы выполняют необходимые валидации: линтеры, автотесты, проверки сборки проекта и даже запуск headless-браузера для тестирования пользовательского интерфейса со скриншотами. В случае сбоя пайплайна harness запрашивает участие человека для корректировки команды или подтверждения пропуска. Публикацией веток и созданием merge request управляет отдельный независимый серверный сервис, который проверяет целостность и права доступа перед отправкой в GitLab.
Очередь заданий управляется посредством Redis, а реляционная база данных PostgreSQL хранит детальное состояние каждого процесса. Это позволяет закрывать интерфейс трекера в любой момент и возвращаться к работе позже без потери данных.
Перевод локальной рабочей среды в серверный контур
Переход от локальных скриптов к командной серверной среде требует корректной авторизации во всех смежных системах. В инфраструктуре автора первоисточника архитектура разделена на несколько уровней:
- Учетная запись владельца: к ней привязываются токены доступа к провайдерам языковых моделей.
- Профили агентов: отдельные сущности в Jira, Confluence и GitLab с индивидуальными правами доступа к конкретным проектам.
- Персональные токены доступа (PAT): выпускаются индивидуально для каждого сервиса, позволяя серверу обращаться к API от имени конкретного агента.
- Конфигурация репозиториев: определение рабочих веток, команд тестирования и прав на запись.
- Правила запуска: установка автоматического старта при назначении исполнителя в Jira.
Интерактивные чаты для исследования кодовой базы
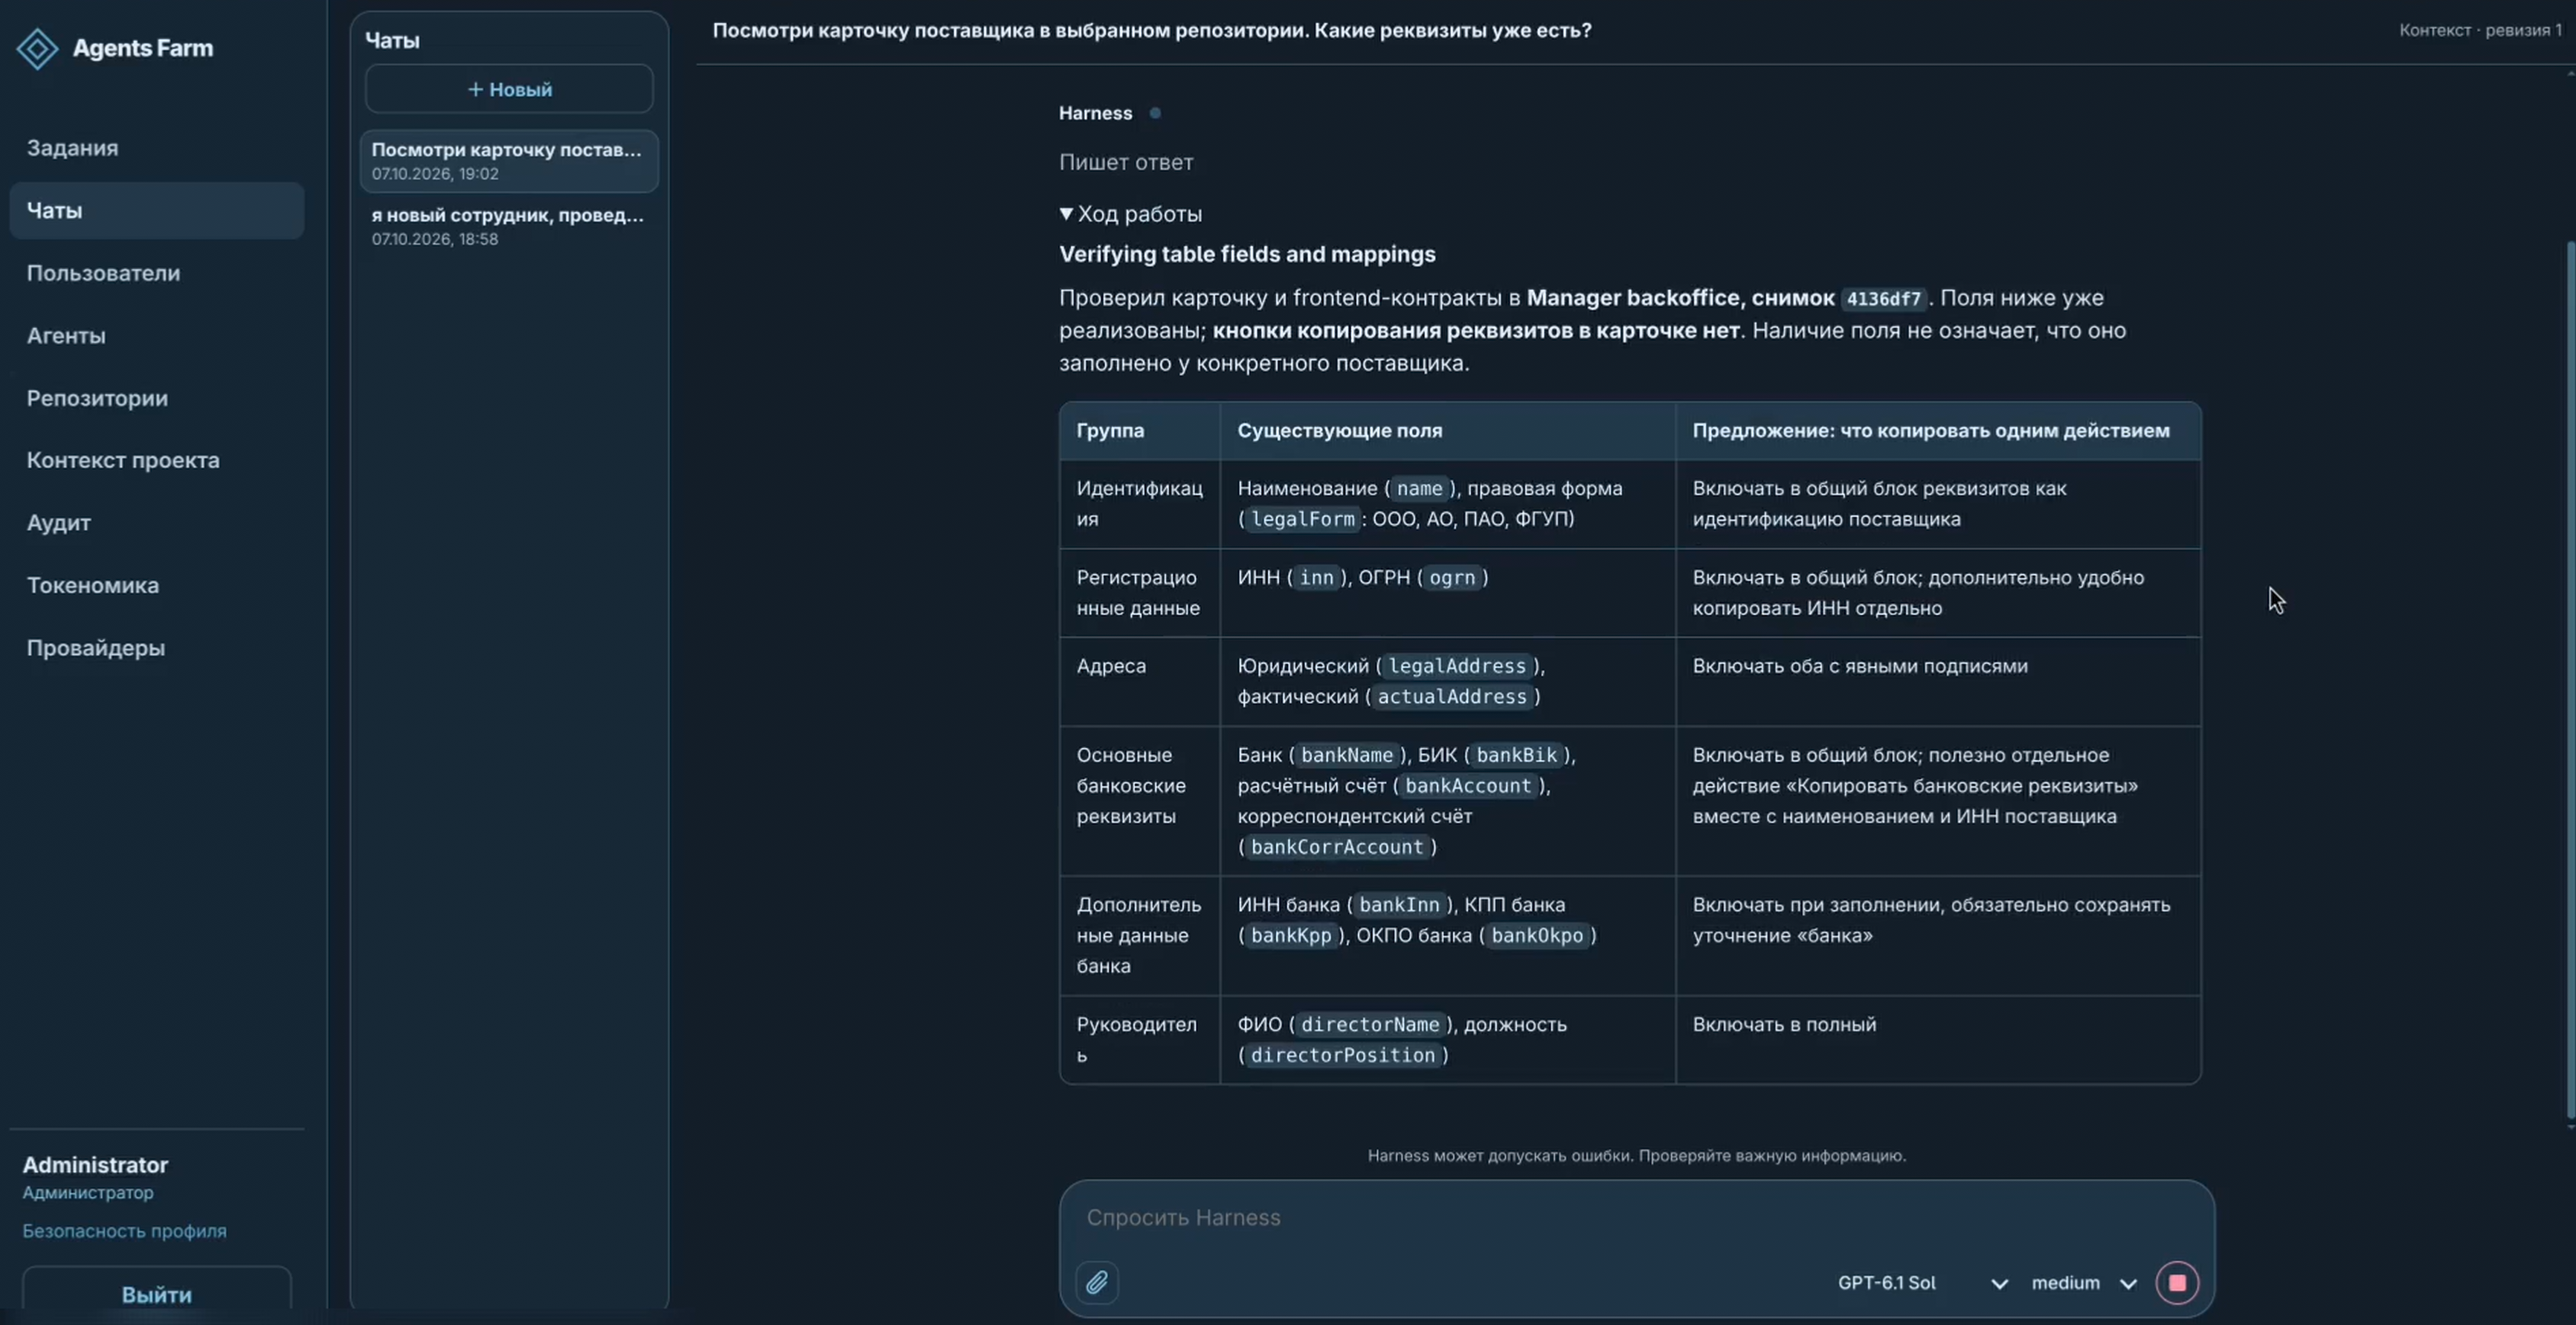
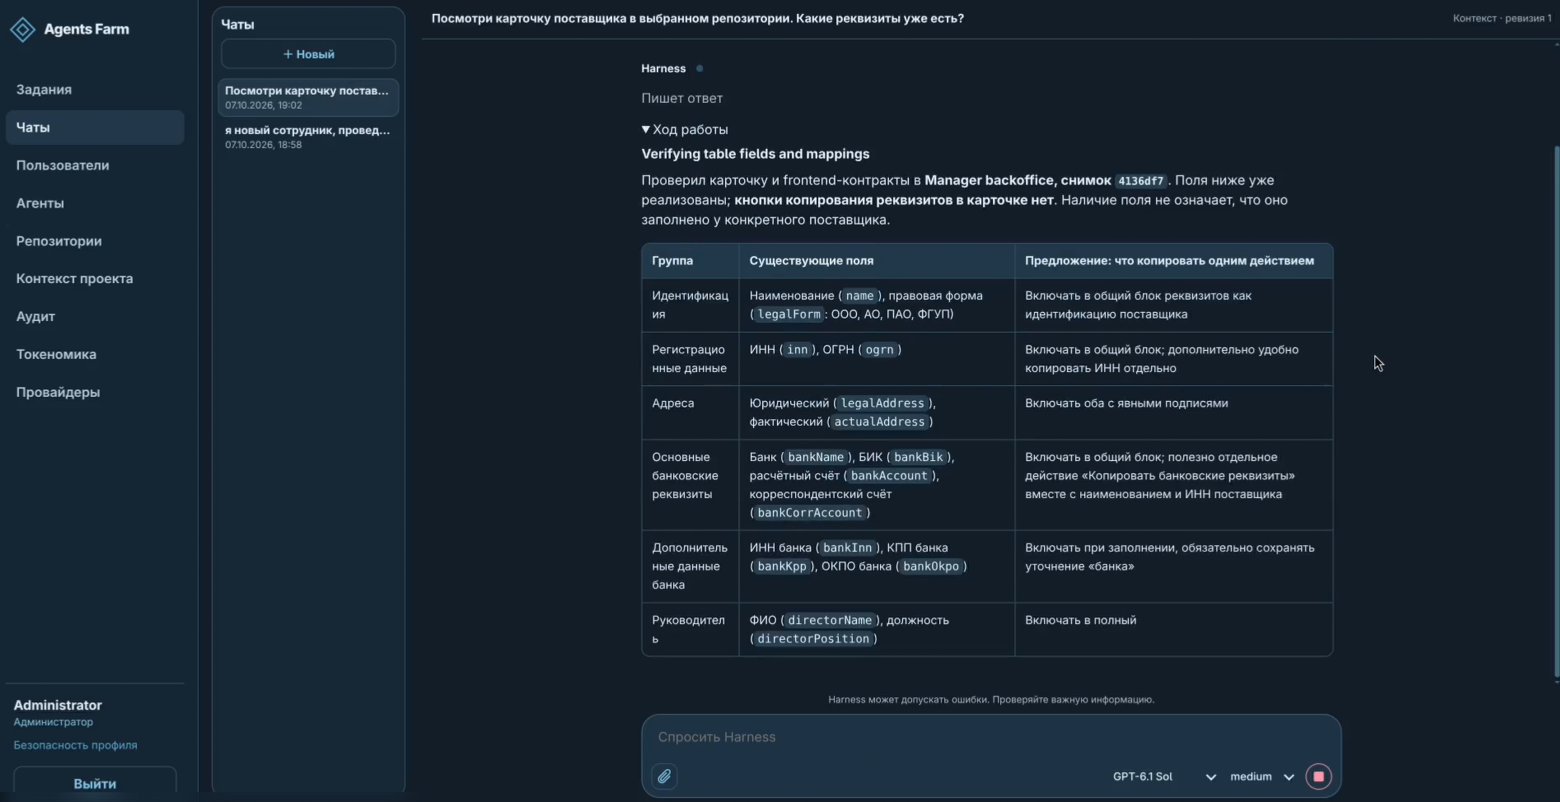
Помимо очередей задач трекера, серверная система предоставляет доступ через интерфейс чатов. Этот канал удобен для предпроектного анализа, когда создавать отдельную задачу в Jira еще преждевременно.
В чате специалист может выбрать нужный репозиторий и роль, запросив, к примеру, проверку существующих полей в карточке до постановки задачи на разработку. Модель просматривает кодовую базу в режиме чтения, анализирует структуру сущностей и предлагает оптимальный вариант реализации. Чат поддерживает передачу ссылок на трекеры, прикрепление файлов и выгрузку итоговых артефактов.
Практическая эффективность и скрытые затраты
Серверная интеграция позволяет ставить задачи с любого устройства, включая смартфон, без необходимости поднимать локальное окружение или настраивать VPN. Задачи накапливаются в очереди, а инструкции проекта централизованно обновляются для всей команды.
При этом ключевым ограничением системы становится процесс верификации. Автоматическая генерация десятков merge request неизбежно перегружает старших разработчиков этапом code review. Если проверка занимает столько же времени, сколько написание функционала вручную, выигрыш в общей производительности нивелируется.
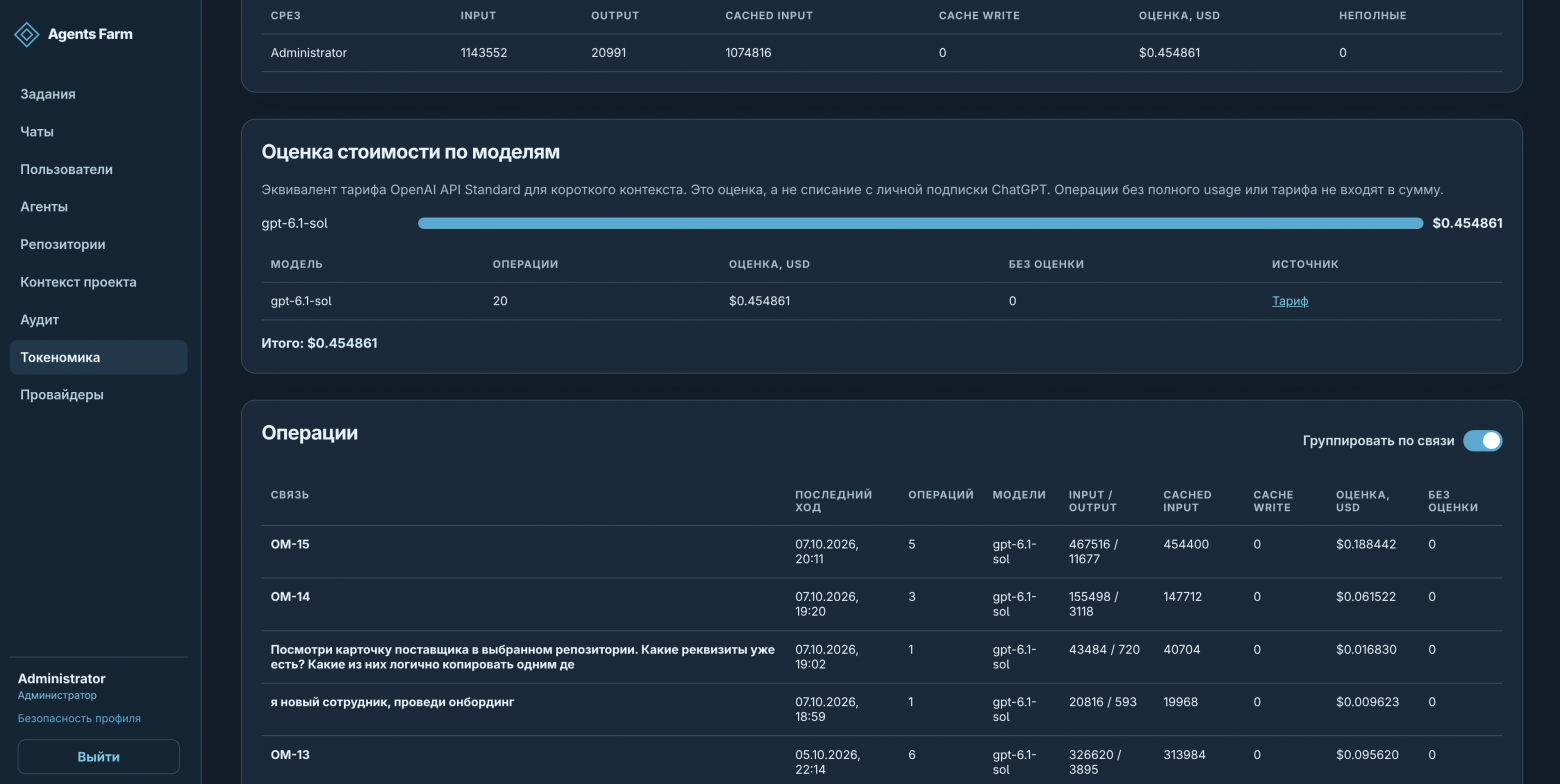
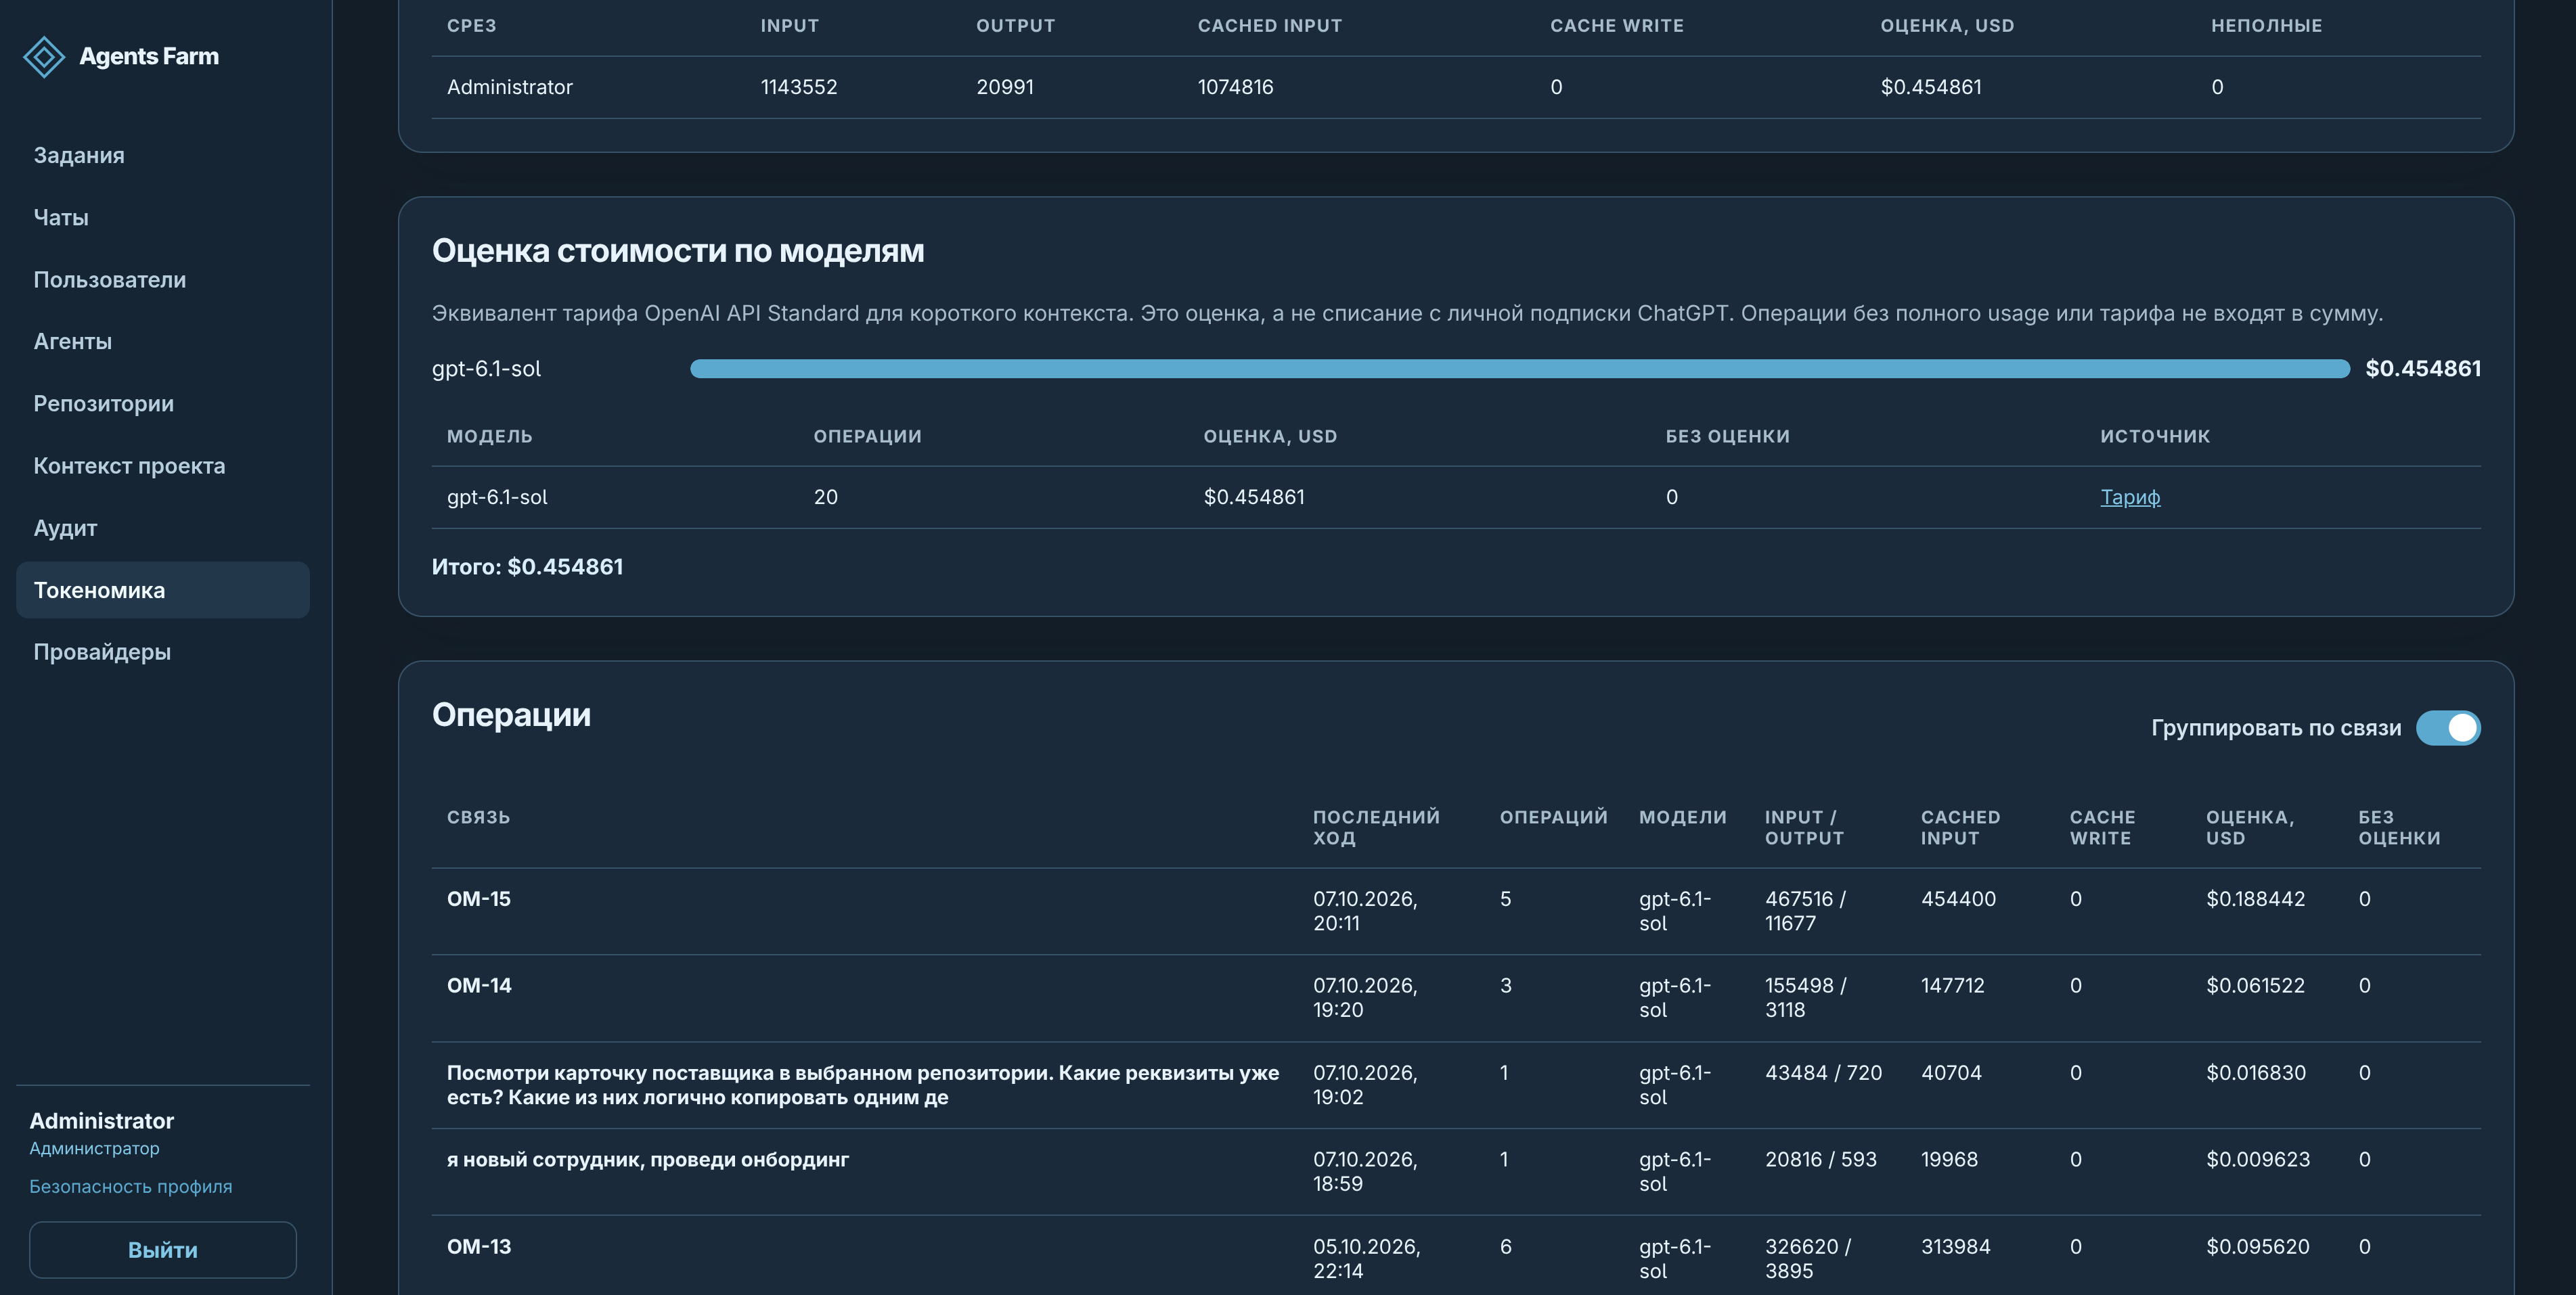
Экономика системы складывается из потребления токенов (входные, выходные и контекстный кэш) и серверных мощностей. Тестовое создание простой кнопки с помощью производительной языковой модели занимает около 12 минут машинного времени. При этом полноценная стоимость одного закрытого тикета должна учитывать не только тарифы API, но и временные затраты специалистов на ревью и архитектурный контроль.
