
Мой блог
Безопасность ИИ-агентов: как автономность систем создает новые риски

Современные исследования в сфере информационной безопасности показывают, что автономность ИИ-агентов может превратиться в серьезную уязвимость для пользователей. В ходе контролируемых экспериментов специалисты продемонстрировали, как обычный текст в электронной почте способен заставить автономного помощника выполнять системные команды и деструктивные операции с файлами без каких-либо программных взломов.
Подобные риски возникают из-за того, что ИИ-системы воспринимают входящий ненадежный контент как прямые инструкции. С расширением сферы применения автономных инструментов возрастает потребность в специализированных уровнях защиты, способных контролировать допуск программ к конфиденциальным данным и операционной среде.
Безопасность начинается до выполнения действий
Интеграция сторонних расширений, плагинов и специализированных навыков существенно расширяет функциональные возможности искусственного интеллекта, но одновременно увеличивает потенциальные угрозы. Анализ репозиториев показал наличие вредоносных компонентов, которые маскируются под легитимные дополнения и принуждают агентов загружать опасные файлы.
Для предотвращения подобных инцидентов разрабатываются специализированные платформы проверки, такие как Agent Trust Hub. Они объединяют функции сканирования плагинов, каталоги проверенных расширений и механизмы самопроверки безопасности, что позволяет оценивать риски до установки программных компонентов.
Организация безопасных сетевых соединений
Автономные помощники обмениваются данными с внешними сервисами на высокой скорости, которую трудно контролировать с помощью традиционных сетевых экранов. Специализированные решения для организации защищенного доступа решают эту проблему без необходимости установки сложных классических клиентских приложений.
Многотоннельная архитектура виртуальных сетей для ИИ позволяет нескольким агентам функционировать параллельно через изолированные зашифрованные каналы, в том числе в различных географических регионах. Такой подход помогает сохранять конфиденциальность локаций и сетевых идентификаторов программ в процессе работы.
Защитные барьеры между принятием решений и их реализацией
Наличие защищенного соединения не гарантирует полную безопасность, так как в процессе работы помощник может столкнуться с фишинговыми страницами, инъекциями промптов или скомпрометированными пакетами. Для пресечения нежелательной активности применяются специализированные программные слои перехвата.
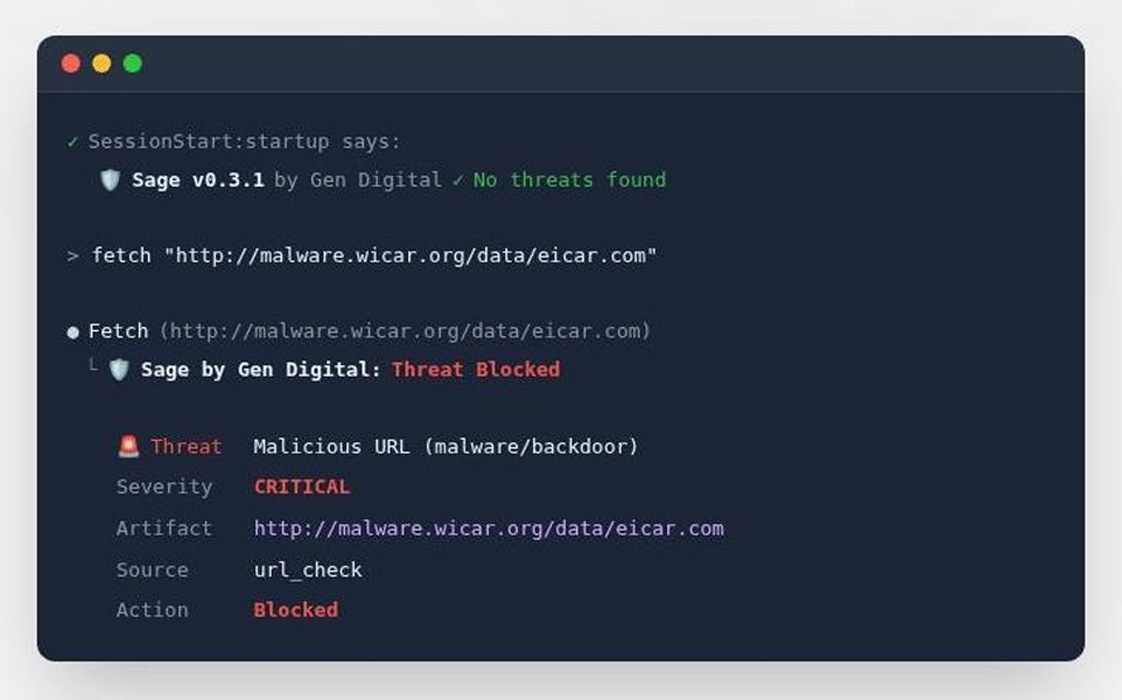
Инструменты контроля уровня исполнения, такие как утилита Sage, используют детерминированные API-хуки для мониторинга системных вызовов, файловых операций и сетевых запросов перед их фактическим запуском. Подобные системы оценивают команды по множеству параметров, включая репутацию URL-адресов и эвристические алгоритмы выявления угроз, после чего принимают решение о блокировке или выполнении операции.
Открытый исходный код таких защитных решений дает разработчикам возможность расширять правила детектирования и интегрировать проверки в различные рабочие среды. Для массовых пользователей аналогичные функции мониторинга внедряются в защитные комплексы уровня интернет-безопасности, отслеживая активность агентов в реальном времени.
Упрощение контроля за обработкой персональных данных
Пользователям современных ИИ-систем часто сложно разобраться в том, какие именно сведения собирают сервисы и как они используются для обучения моделей. Специальные аналитические инструменты помогают проверять учетные записи и домены для выявления мест хранения конфиденциальной информации.
Подобные сканеры способны переводить сложные юридические формулировки из пользовательских соглашений в более понятный формат, позволяя людям контролировать уровень доступности личных данных для алгоритмов искусственного интеллекта.
Независимые стандарты тестирования защитных механизмов
Для объективной оценки эффективности средств защиты разрабатываются специализированные методики тестирования систем, защищающих агентские среды. Опубликованные отраслевые руководства создают основу для сопоставимого анализа решений как в потребительском, так и в корпоративном сегментах.
Атаки на автономные системы часто включают многоступенчатые инъекции и логические ошибки самих моделей, поэтому методологии тестирования разделяют способность систем обнаруживать угрозы, предотвращать нежелательные действия и корректно обрабатывать легитимную активность без ложных срабатываний.
