
Мой блог
Что происходит внутри Spark во время выполнения задач: архитектура и пайплайны

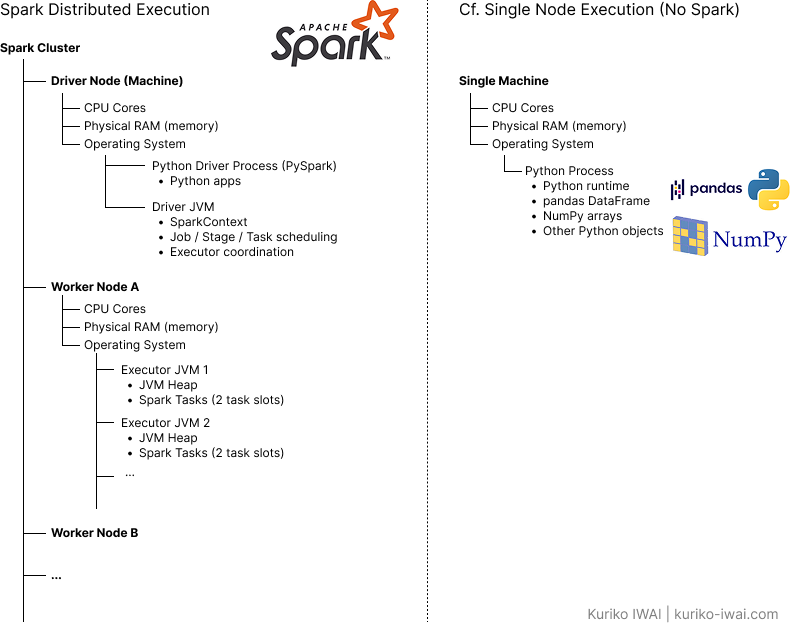
Современные дата-пайплайны сталкиваются с ограничениями производительности одиночных серверов при росте объемов информации. Инструменты распределенной обработки, такие как Apache Spark, позволяют масштабировать вычисления, разделяя рабочие нагрузки на логические части.
Понимание того, как устроен Spark, помогает проектировать эффективные распределенные вычисления и избегать распространенных архитектурных ошибок.
Введение в параллельную обработку данных
Обработка больших данных требует эффективного распределения ресурсов. Apache Spark представляет собой движок распределенных вычислений, который делит рабочие процессы на отдельные задачи и выполняет их параллельно на доступных ядрах процессора и вычислительных узлах.
Однако распределенный режим не обязательно предполагает наличие кластера из множества физических машин. Система способна функционировать в локальном режиме на одном устройстве, разделяя данные на логические сегменты и обрабатывая их параллельно.
Архитектурные компоненты распределенной системы
Платформа строится на взаимодействии нескольких ключевых элементов, каждый из которых выполняет определенную роль в управлении ресурсами и исполнении кода.
Основные роли и узлы кластера
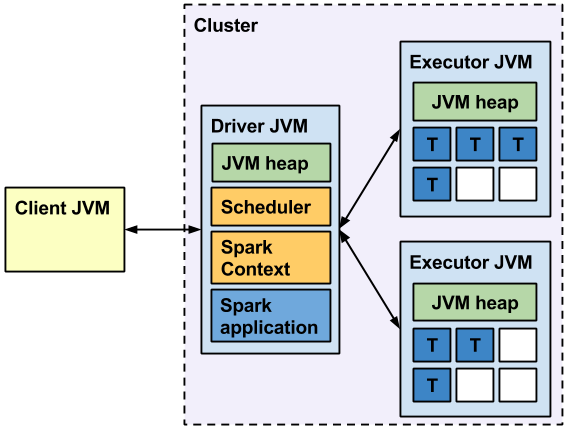
Драйвер выполняет координирующие функции для приложения, преобразуя логику в ориентированный ациклический граф физических задач и распределяя их между исполнителями. Менеджер кластера отвечает за выделение аппаратных ресурсов в соответствии с системными настройками.
Рабочие узлы предоставляют вычислительные мощности, а запускаемые на них процессы-исполнители непосредственно выполняют задачи и удерживают данные в процессе вычислений. В зависимости от конфигурации окружения на одном физическом или виртуальном узле может работать как один, так и несколько исполнителей.
Практический пример обработки данных электронной коммерции
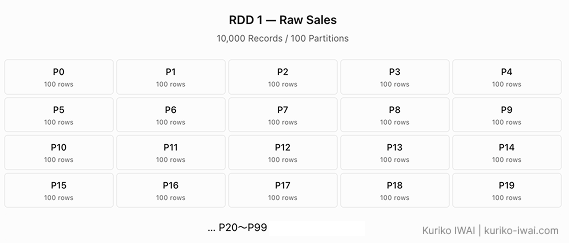
Для демонстрации архитектуры рассматривается гипотетическая торговая площадка с массивом из 10 000 записей о продажах. Каждая запись содержит артикул товара и проданное количество, причем в системе фигурируют три различных SKU: A, B и C.
Цель обработки заключается в фильтрации некорректных значений и расчете общего объема продаж по каждому артикулу. После отсеивания строк с нулевым и отрицательным количеством в наборе остается 9 800 валидных записей для финальной агрегации.
Конфигурация кластера и распределение памяти
В тестовой схеме задействовано три рабочих узла, каждый из которых оснащен восьмиядерным процессором и 32 гигабайтами оперативной памяти. Суммарный потенциал системы составляет 24 виртуальных ядра.
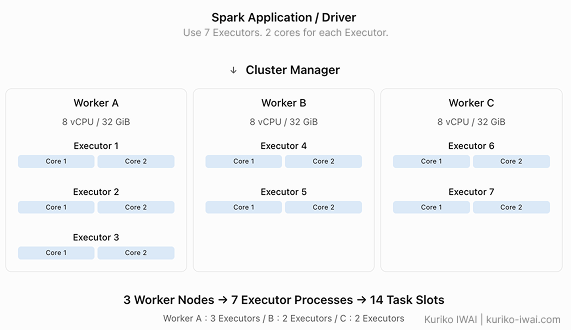
При запросе ресурсов менеджер распределяет нагрузку между семью исполнителями, выделяя каждому по два процессорных ядра и по три гигабайта памяти под кучу Java. Оставшийся объем задействуется под системные нужды виртуальной машины и служебные процессы.
Роль виртуальной машины Java
Программная платформа базируется на среде выполнения Java. Поскольку ядро написано на Scala и Java, выполнение байт-кода требует соответствующего окружения для управления потоками, выделения памяти и сборки мусора.
В сценариях с использованием PySpark клиентский процесс на Python взаимодействует с драйвером через специальный мост, в то время как исполнители на рабочих узлах запускаются внутри виртуальной машины и управляют вспомогательными рабочими процессами для выполнения пользовательских функций.
Отказоустойчивые распределенные наборы данных
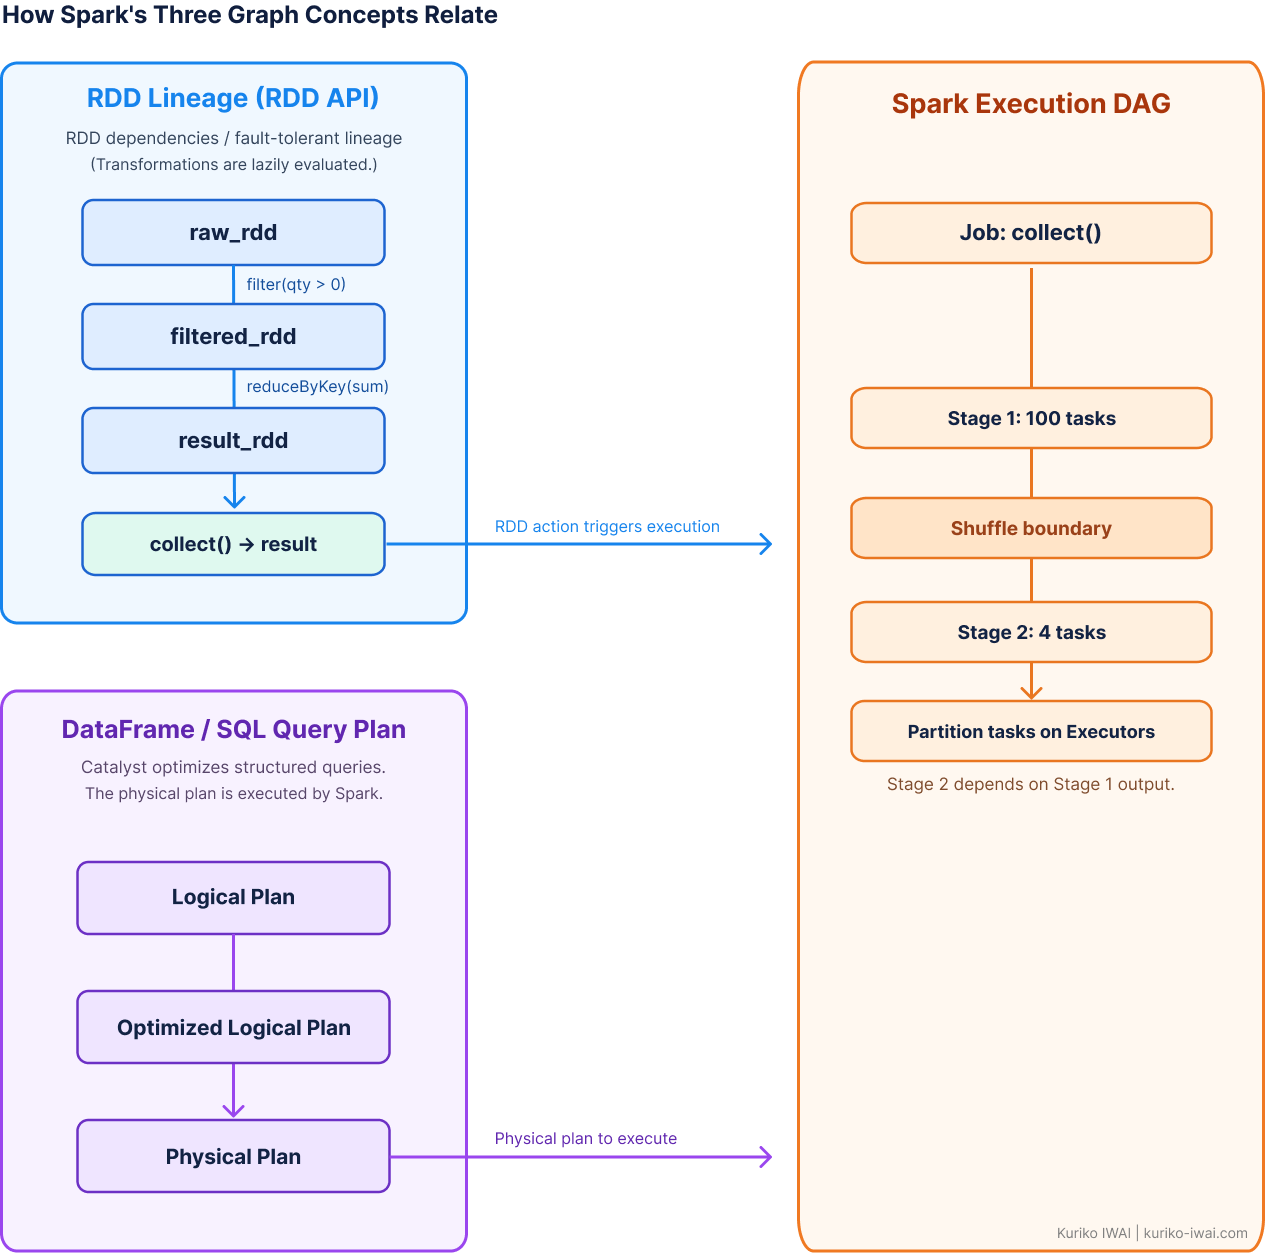
Основной абстракцией данных выступает неизменяемая коллекция элементов с поддержкой параллельной обработки, известная как RDD. Структура отслеживает зависимости между преобразованиями, что позволяет восстанавливать утраченные фрагменты без необходимости дублирования всех промежуточных результатов.
Разделение на партиции представляет собой логические фрагменты данных, каждый из которых обрабатывается отдельной задачей в рамках этапа выполнения. Создание заданного числа начальных разделов позволяет равномерно распределить исходные элементы по исполнителям.
Сравнение интерфейсов RDD и DataFrame с оптимизацией Catalyst
Хотя низкоуровневая работа с наборами помогает понять механику перетасовки и построения линий зависимостей, в стандартных задачах ETL предпочтительнее использовать интерфейс DataFrame.
Такой подход предоставляет структурированные схемы, столбцы и выражения, видимые оптимизатору запросов, который автоматически строит эффективные физические планы выполнения.
Планы запросов и этапы оптимизации
Подобно цепочкам зависимостей в RDD, запросы в DataFrame проходят через несколько стадий трансформации. Движок формирует логическое описание, после чего применяет правила оптимизации, включая фильтрацию и сокращение колонок.
На этапе генерации физического плана выбираются конкретные операторы выполнения, такие как частичные агрегации, операции обмена и соединения, которые затем транслируются в исполняемые задачи на узлах кластера.
Сравнение подходов к агрегации
Низкоуровневые операции требуют явного написания логики фильтрации и свертки с использованием кортежей, тогда как декларативный интерфейс оперирует пространствами имен и именованными столбцами.
Оба метода решают идентичную бизнес-задачу по очистке и суммированию показателей, однако первый возвращает стандартные элементы среды программирования, а второй формирует структурированные строки с понятной схемой данных.
Заключение
Целью настройки производительности распределенных систем является снижение общих затрат на вычисления и уменьшение задержек без потери стабильности кластера.
Понимание того, как распределяются вычислительные ресурсы, формируются задачи и обрабатываются партиции на исполнителях, создает прочную основу для проектирования надежных конвейеров обработки данных.
