
Мой блог
Как мои худшие привычки в Claude Code вредили работе: сравниваю свой сетап с новичком

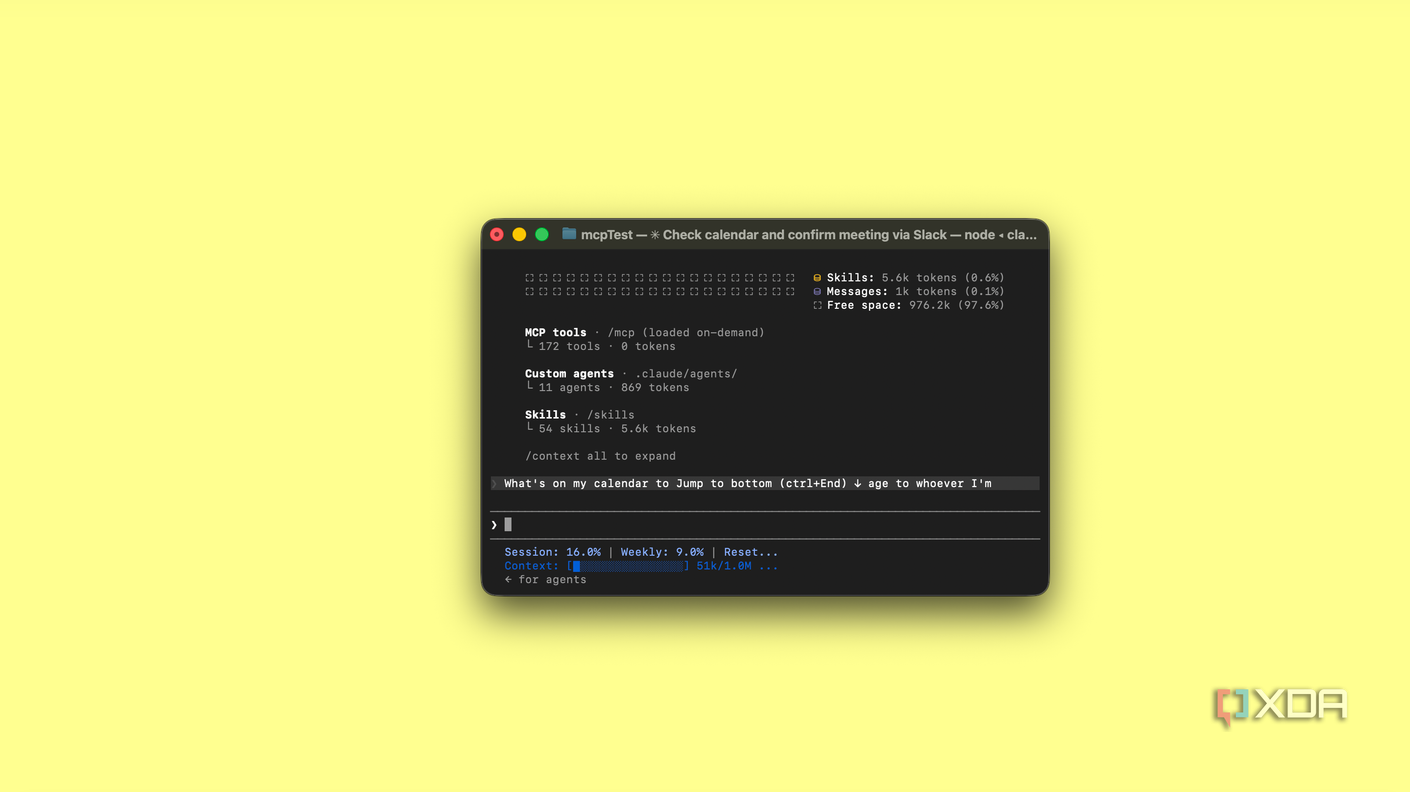
В последнее время интернет пестрит советами о том, как правильно настраивать нейросети и какие плагины делать обязательными для внедрения. Я протестировал множество рекомендаций для Claude Code, совмещая роли обычного пользователя и профильного журналиста. Со временем мой сетап оброс таким количеством улучшений, что перестал приносить пользу. Решив провести ревизию, я сравнил свою перегруженную среду с минималистичным подходом новичка и понял, что многие уловки только мешали.
Когда постоянно тестируешь технологии, легко попасться в ловушку избыточных настроек. Накопив за месяцы работы горы интеграций, инструкций и режимов, я решил вернуться к истокам, чтобы оценить реальную пользу каждого элемента. Как выяснилось, стремление оптимизировать всё подряд часто дает противоположный результат.
Избыток MCP-серверов создает хаос
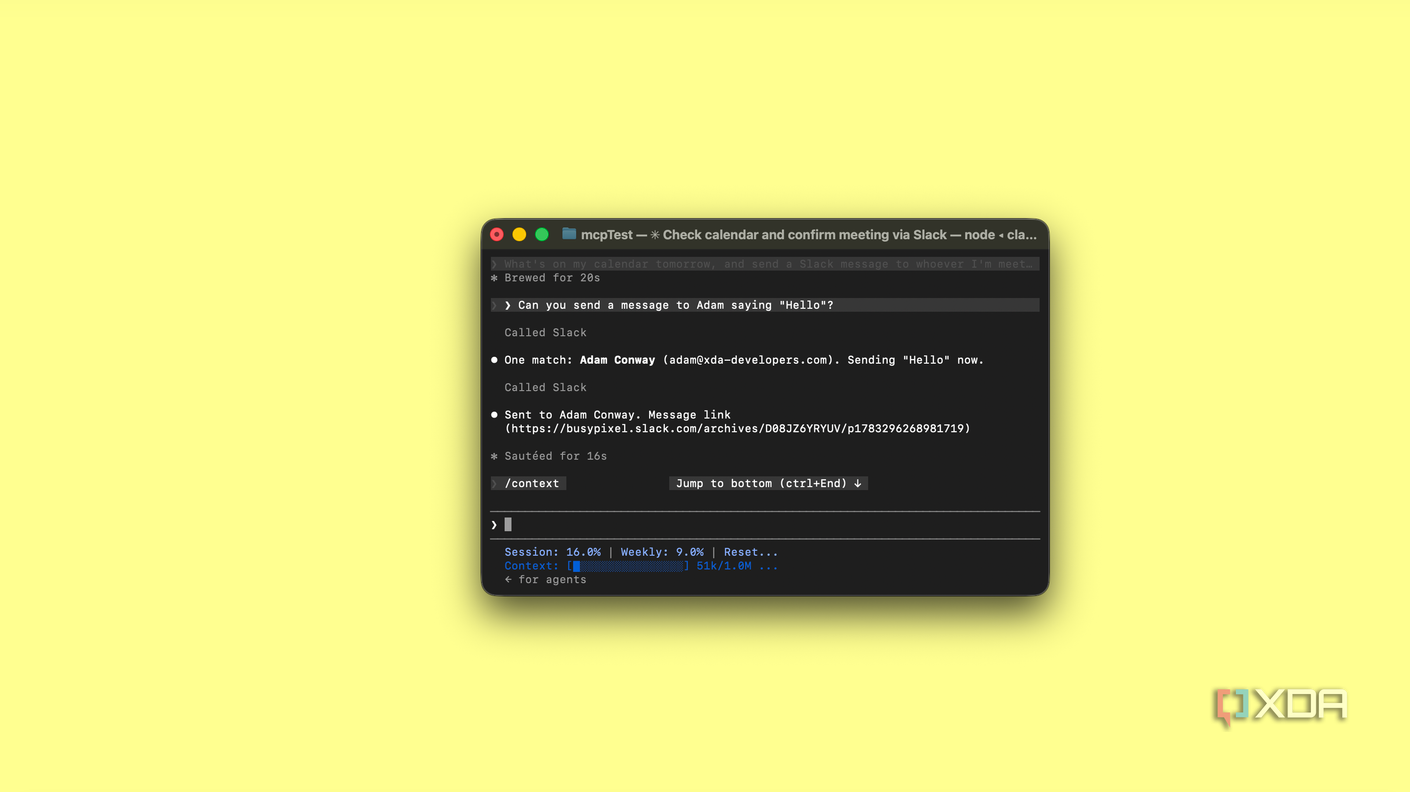
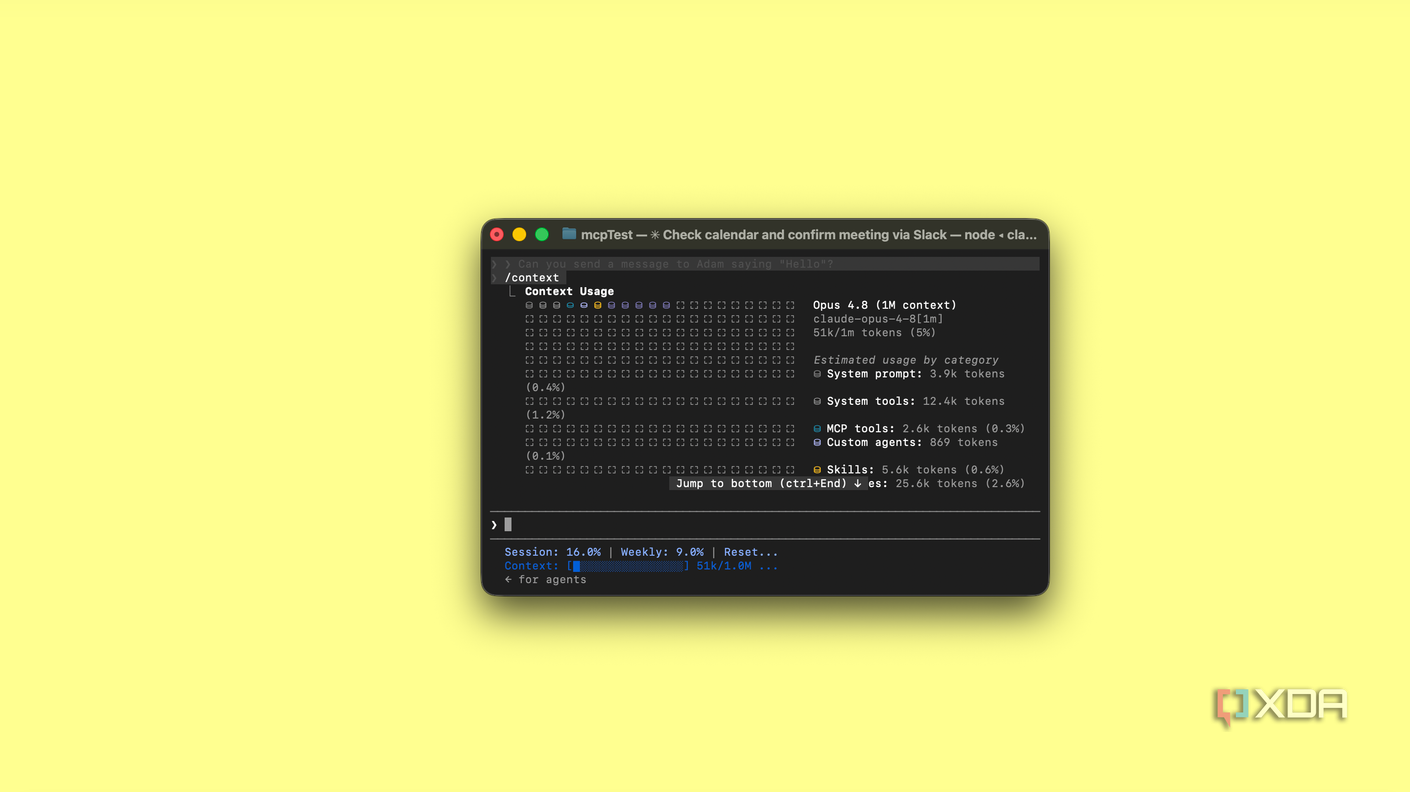
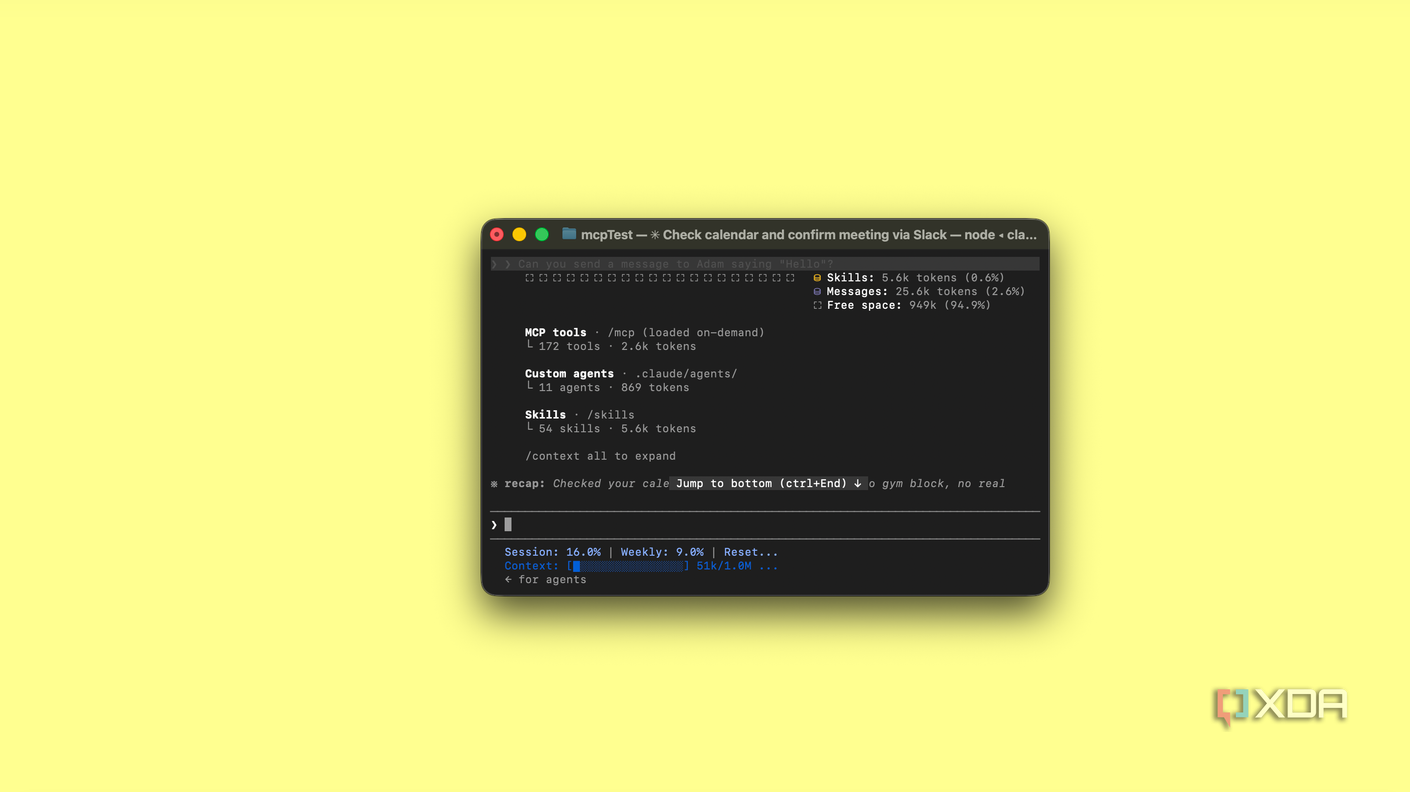
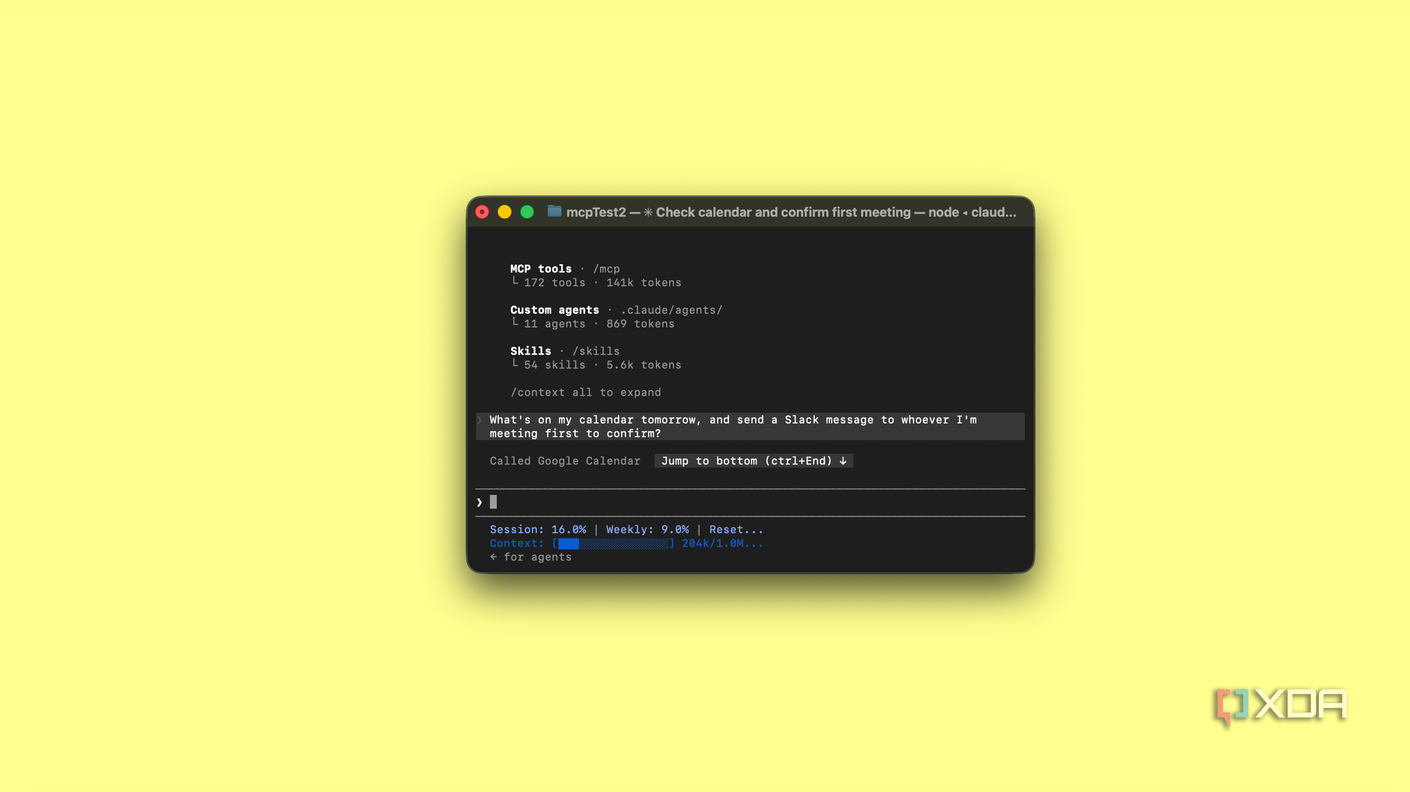
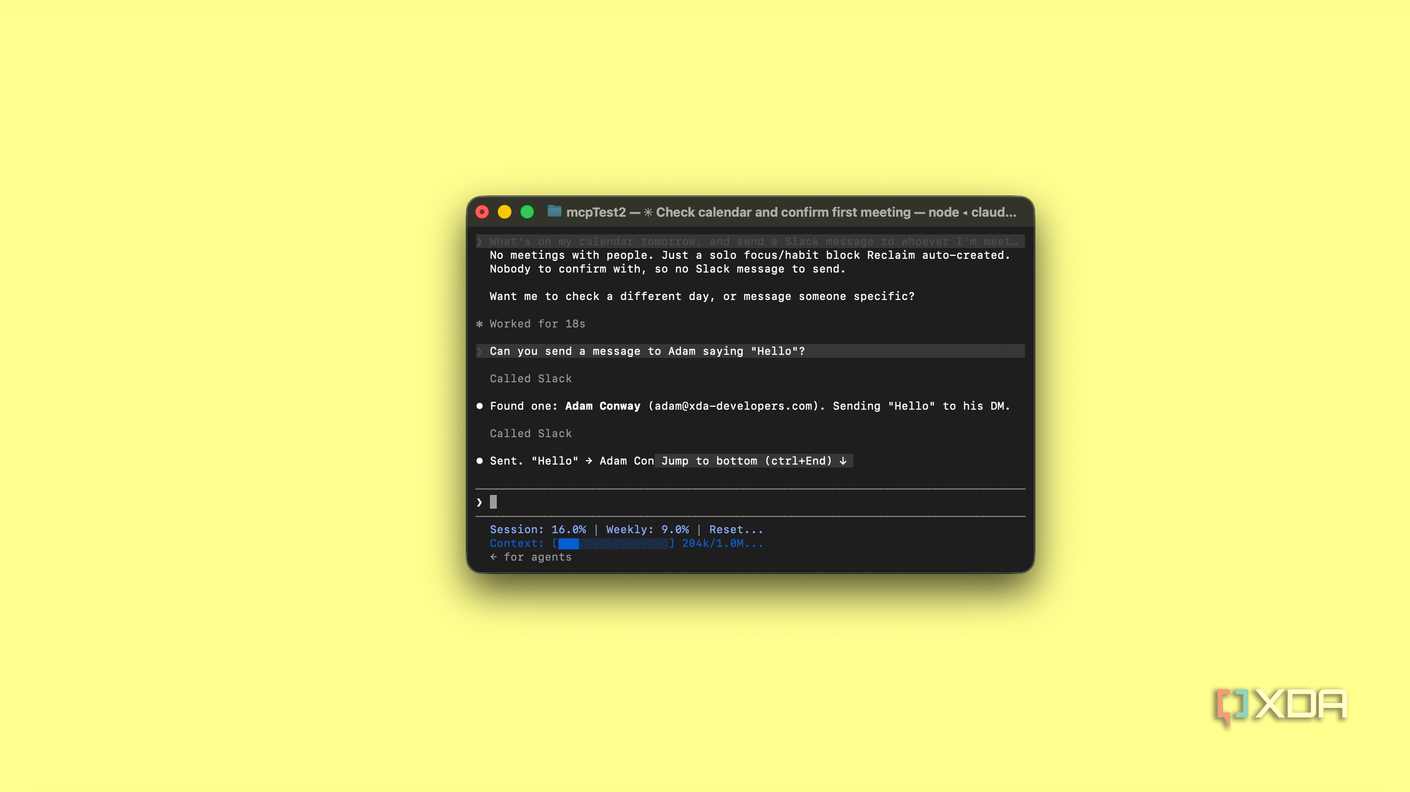
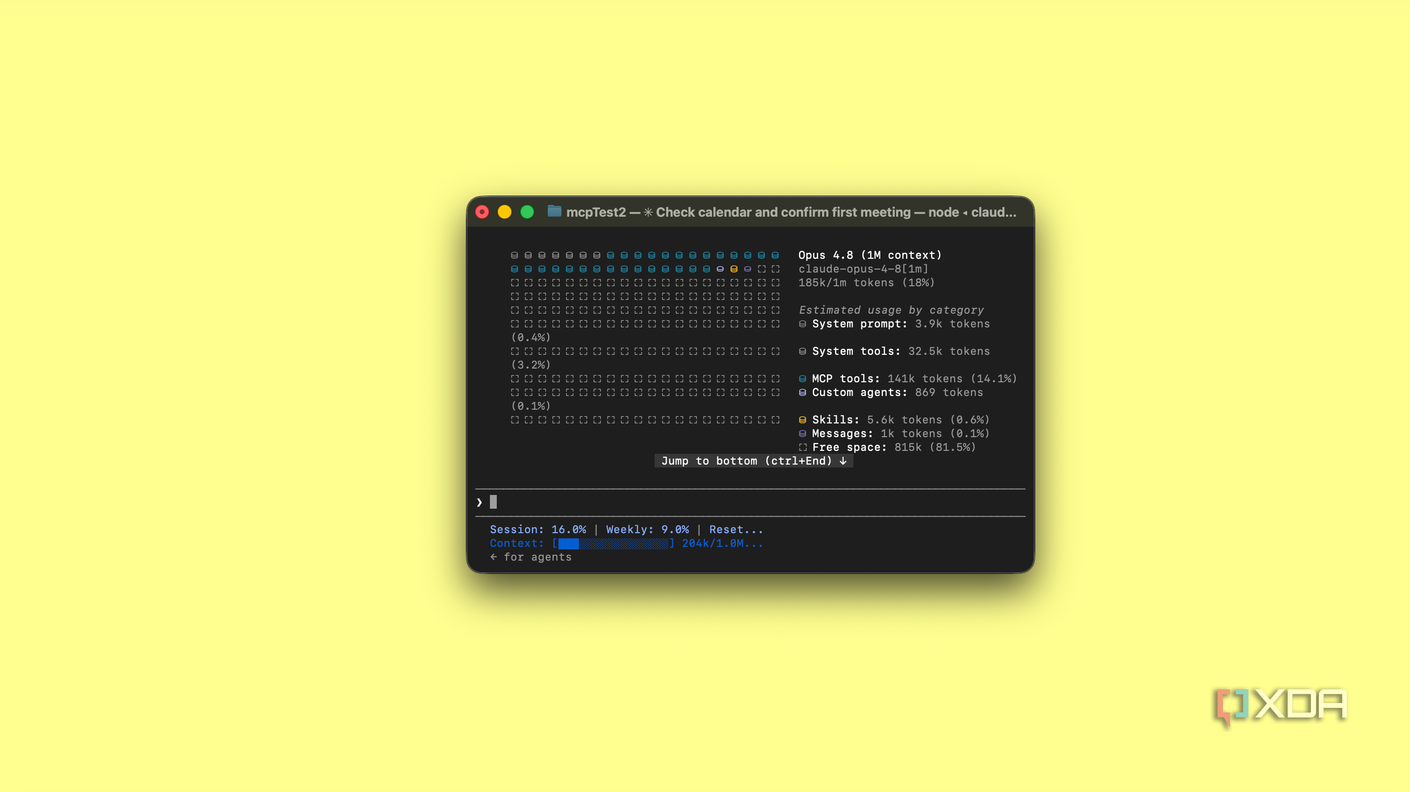
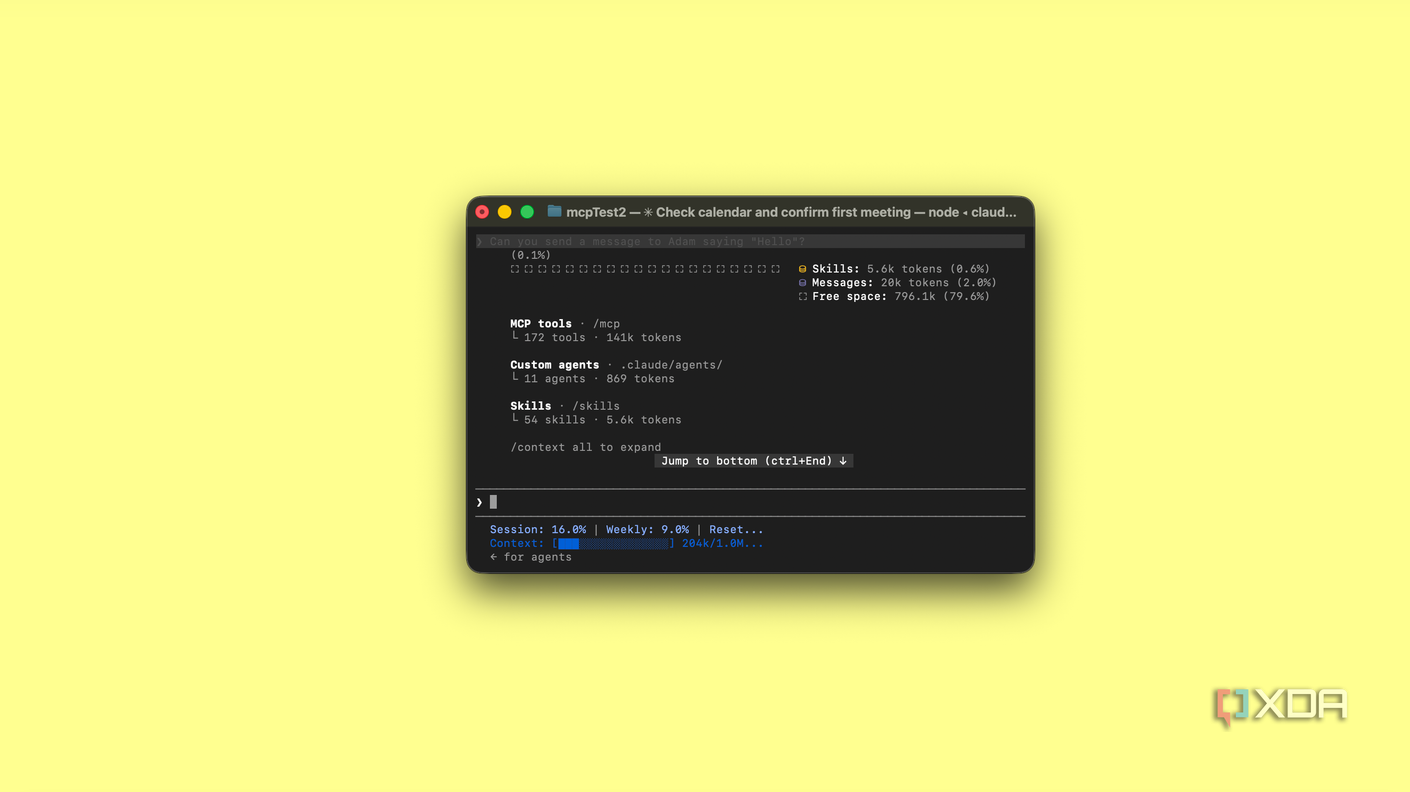
Интеграция искусственного интеллекта в повседневные задачи через подключение внешних сервисов — отличная идея. Для этого в современных инструментах предусмотрены встроенные возможности или протокол Model Context Protocol (MCP). Проблема в том, что я подключил слишком много MCP-серверов. Каждая новая служба воспринималась как полезный апгрейд, в итоге у меня были задействованы серверы для заметок, облачных платформ, мессенджеров, баз данных, сред разработки и инструментов для встреч вроде Read AI.
Главная сложность заключается в том, что большое количество соединений не делает систему умнее. Каждый подключенный сервер добавляет инструменты, из которых модель должна выбирать подходящие. При пересечении функционала это сильно запутывает процесс. До появления механизма Tool Search, откладывавшего определение инструментов до момента их вызова, подобные излишки съедали огромную часть контекста еще до отправки самого промпта.
Лишние слои памяти, которые агенту не нужны
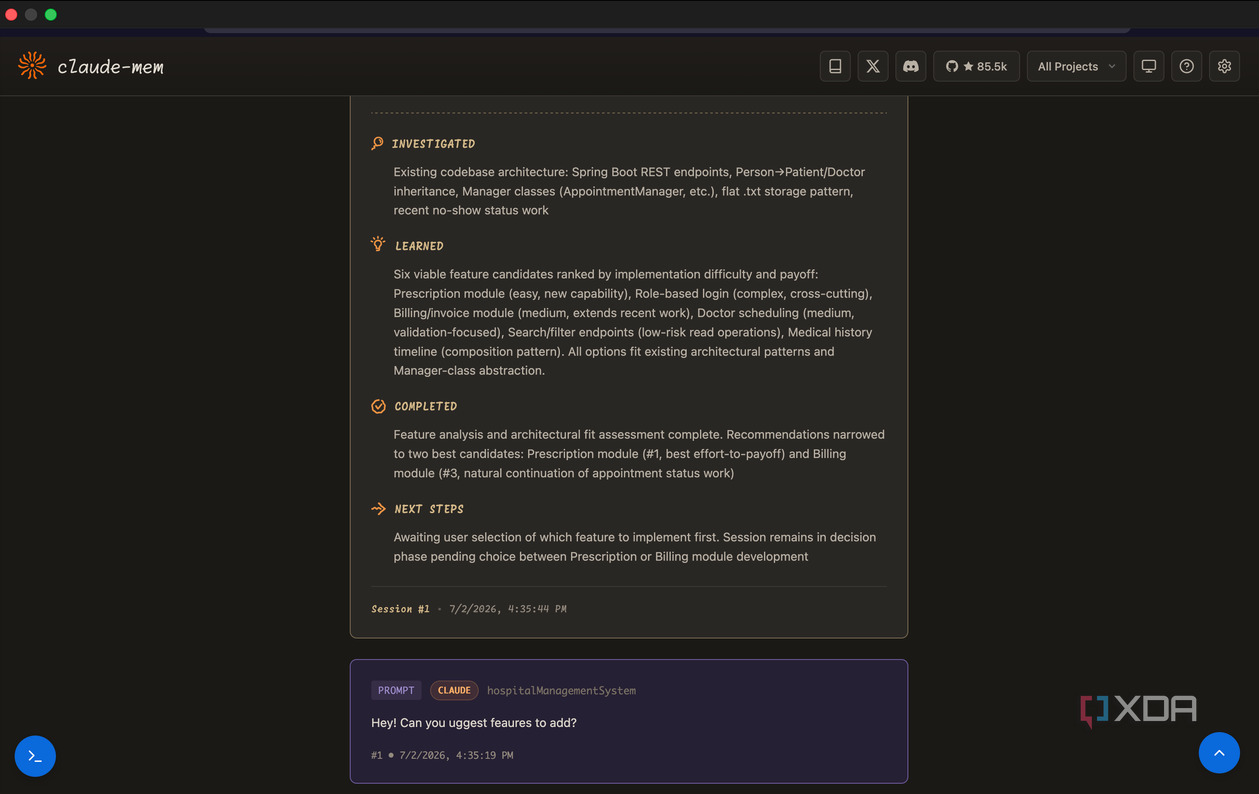
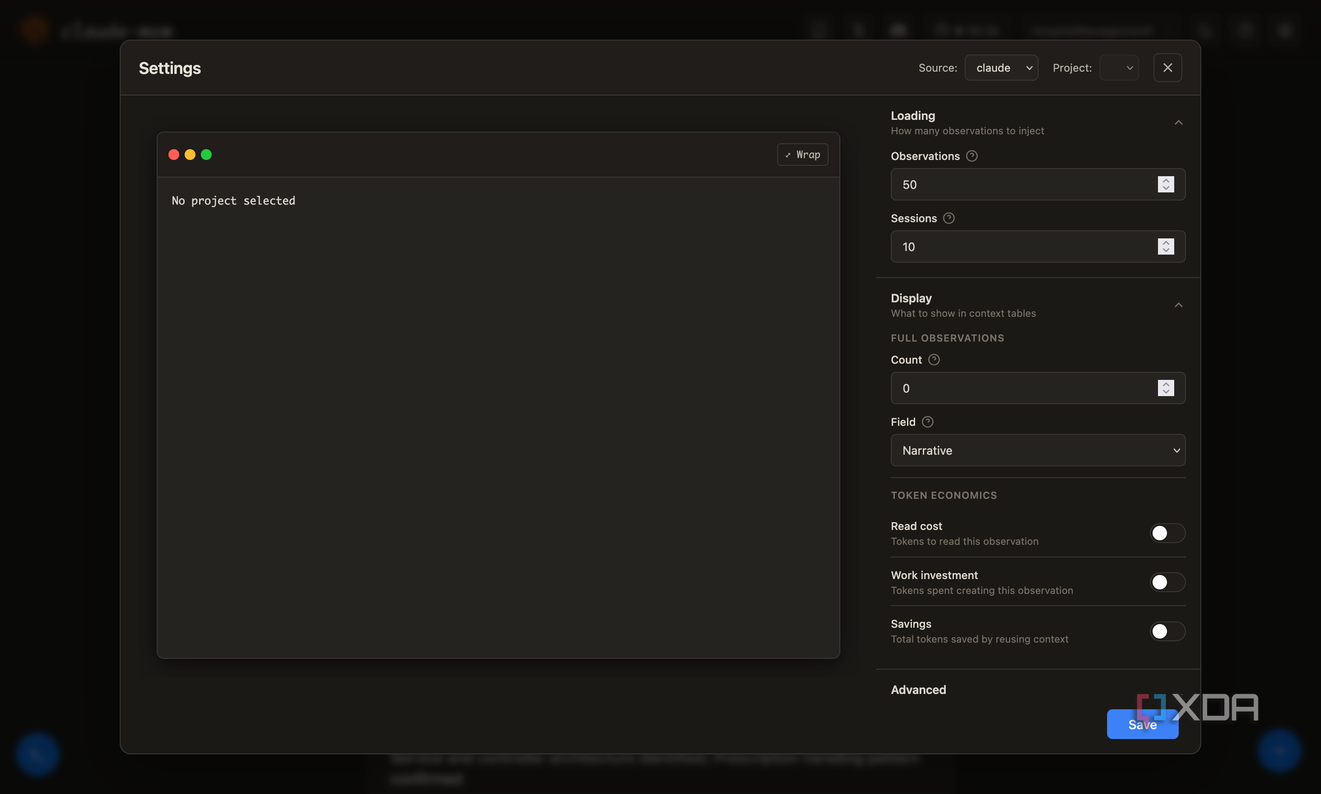
С памятью я совершил ту же ошибку, полагая, что чем больше нейросеть помнит о моих проектах и прошлых сессиях, тем эффективнее она будет действовать. В результате я установил плагины вроде claude-mem поверх встроенных возможностей Claude Code. Проблема оказалась не только в том, что эти дополнения создавали лишние инструкции и агентов до начала работы, но и в качестве самой памяти.
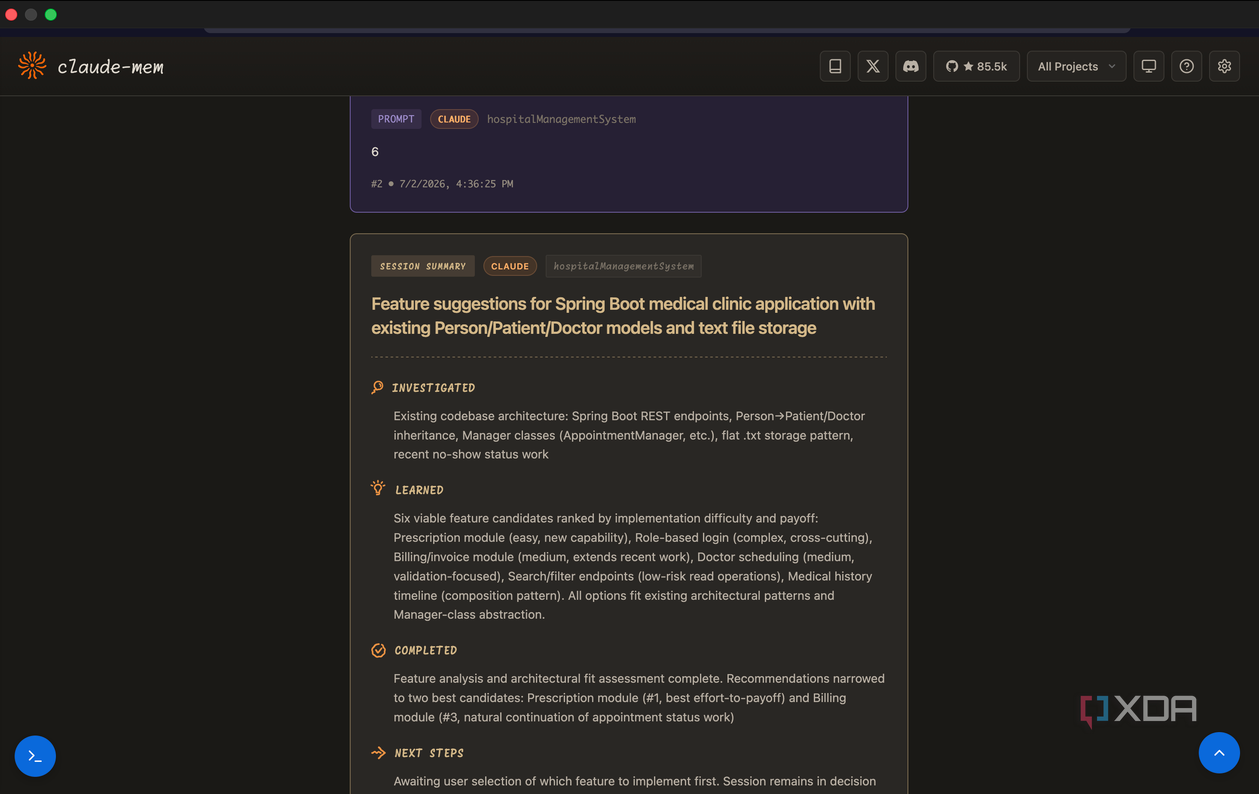
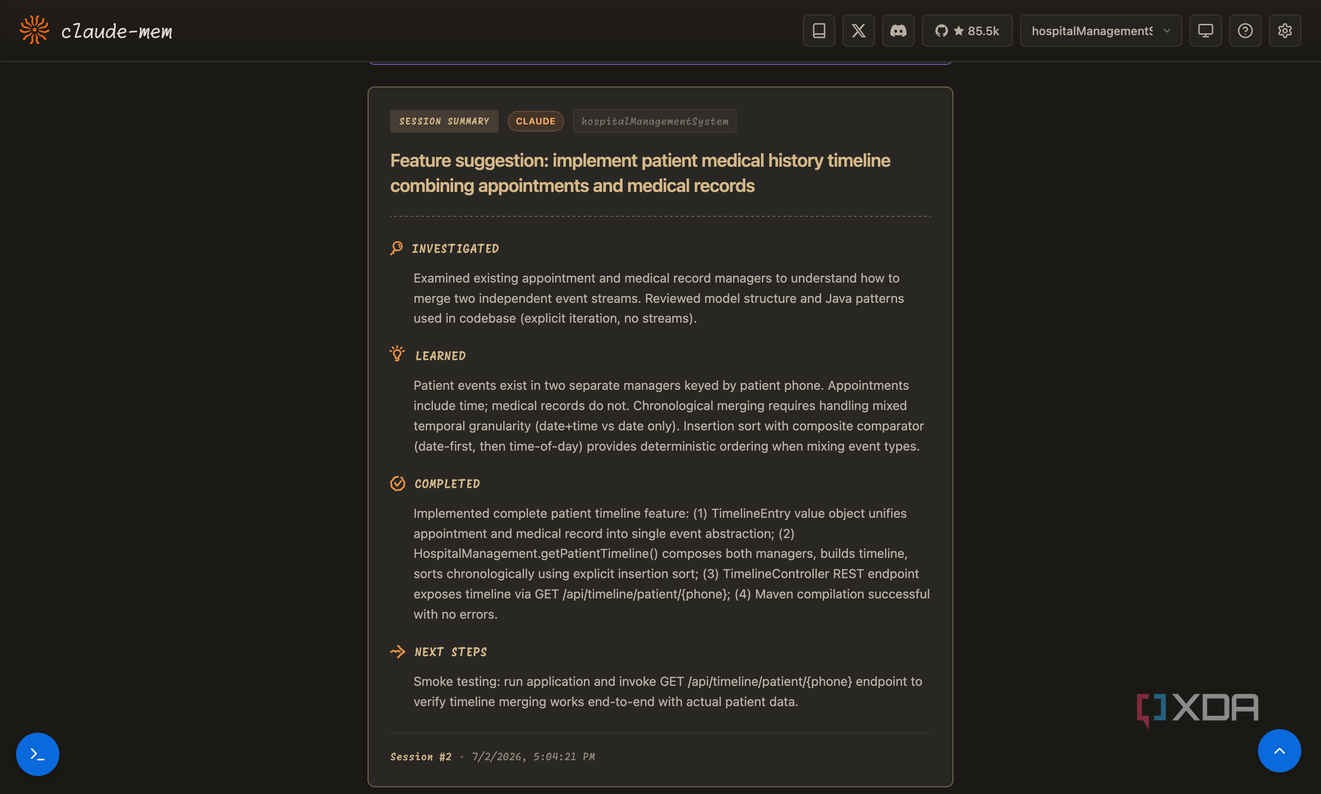
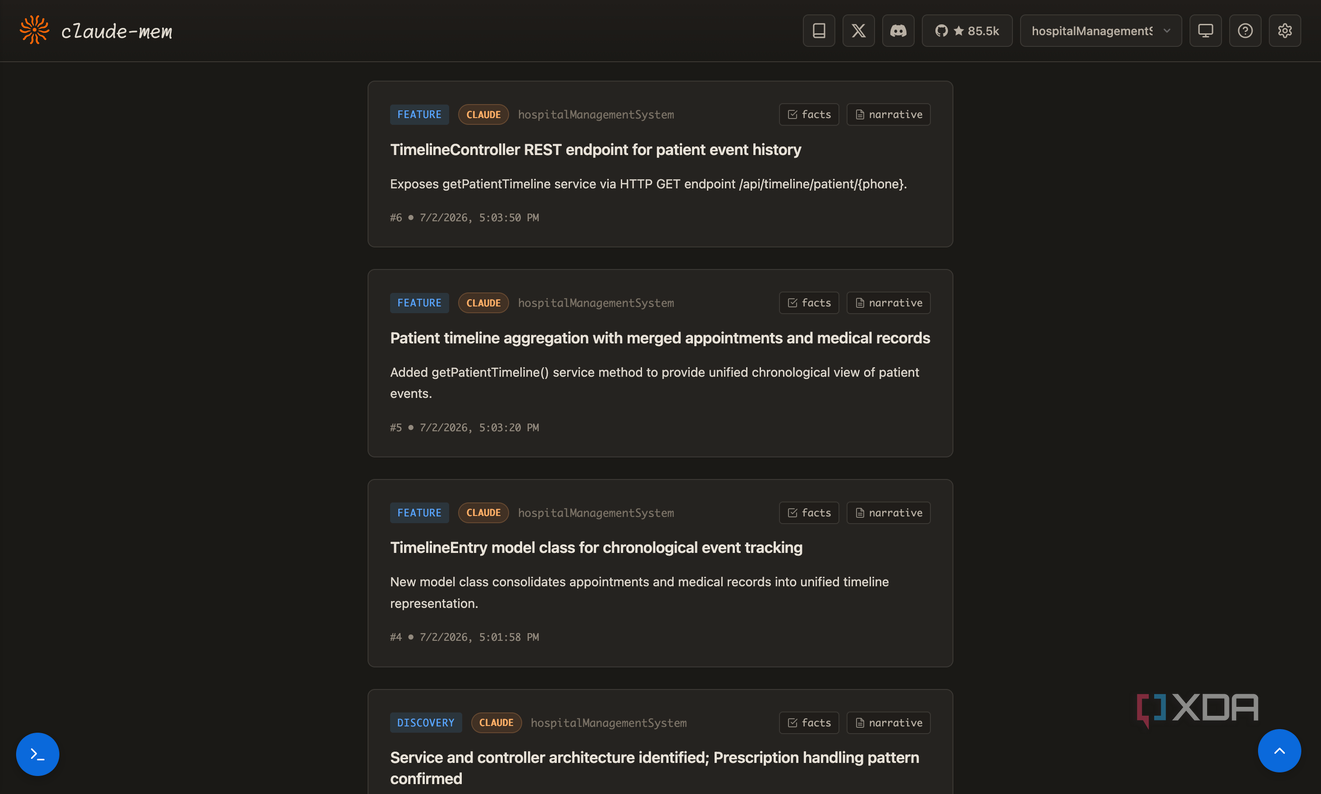
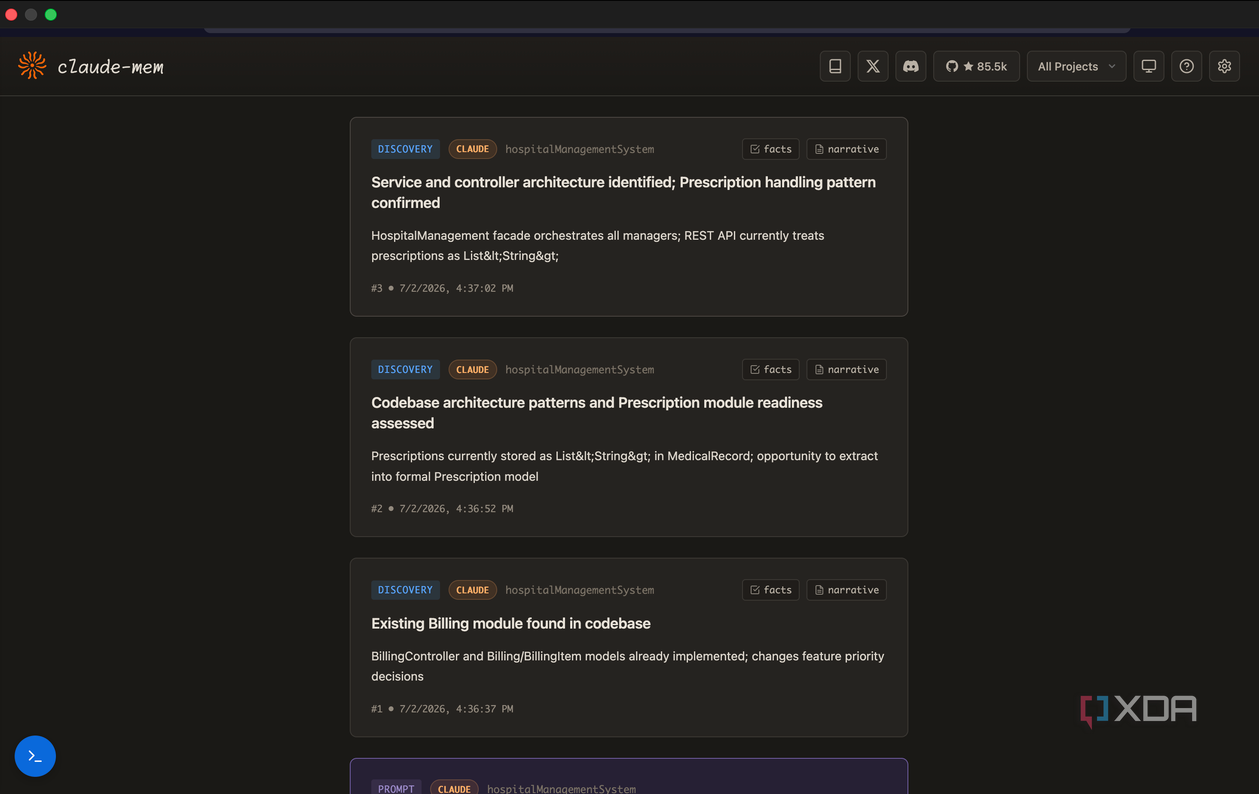
Подобные системы способны сохранять устаревшую информацию, которая была актуальна несколько сессий назад, но больше не отражает реальное состояние репозитория. В итоге ИИ тратит драгоценное время на сверку старых данных с текущим кодом, а устаревший контекст порой направляет агента по ложному пути. Зачастую задачи в одной директории не имеют глубокой связи между собой, и хранение общей истории служит лишь дополнительным информационным шумом.
Раздутый файл CLAUDE.md и потеря фокуса
Файлы CLAUDE.md — прекрасный способ управлять поведением ассистента в рамках проекта, но со временем я стал добавлять туда абсолютно всё: правила кодинга, рабочие привычки, крайние случаи и старые ошибки, которые не хотел повторять. В отличие от серверов, содержимое CLAUDE.md подгружается в контекст проекта при каждом запуске, поэтому его раздувание обходится слишком дорого.
Я заметил: чем длиннее становился этот файл, тем менее надежно выполнялись инструкции. Важные правила тонули среди десятков второстепенных заметок, а устаревшие указания продолжали влиять на совершенно несвязанные задачи. Это полностью совпадает с рекомендациями разработчиков из Anthropic, которые советуют держать файлы конфигурации короткими, так как большой объем текста ухудшает следование правилам.
Режим Plan mode нужен далеко не для каждой мелочи
Я всегда ценил функцию Plan mode за возможность заставить агента обдумать предстоящие действия и вовремя пресечь неверный подход. Однако со временем я стал включать этот режим по умолчанию для любых, даже самых элементарных задач. Когда требуется внести пару мелких правок, предварительное составление детального плана избыточно.
В таких сценариях я фактически оплачивал дополнительный цикл рассуждений, не получая реальной отдачи. Нейросеть тратила время на написание плана для изменений, которые занимали секунды, после чего просто выполняла ту же работу. Оптимальный сетап — это не тот, в который напичканы все существующие «продвинутые» настройки, а тот, который предоставляет модели ровно столько данных, сколько требуется для конкретной задачи, и ничего лишнего.
