
Мой блог
Как я повторил трюк Spotify для Claude Code: экономия токенов, которая обошлась дороже

Вопрос экономии токенов при решении агентских задач стоит очень остро. Обработка объемных документов или генерация тестов с помощью передовых моделей обходится недешево, особенно при оплате по API. Инженеры Spotify попытались решить эту проблему, внедрив специальный плагин shunt, который перекладывает рутинное чтение и написание кода на более дешевые или локальные языки. Я решил воспроизвести этот подход в собственном окружении с Claude Code, чтобы проверить эффективность метода на практике.
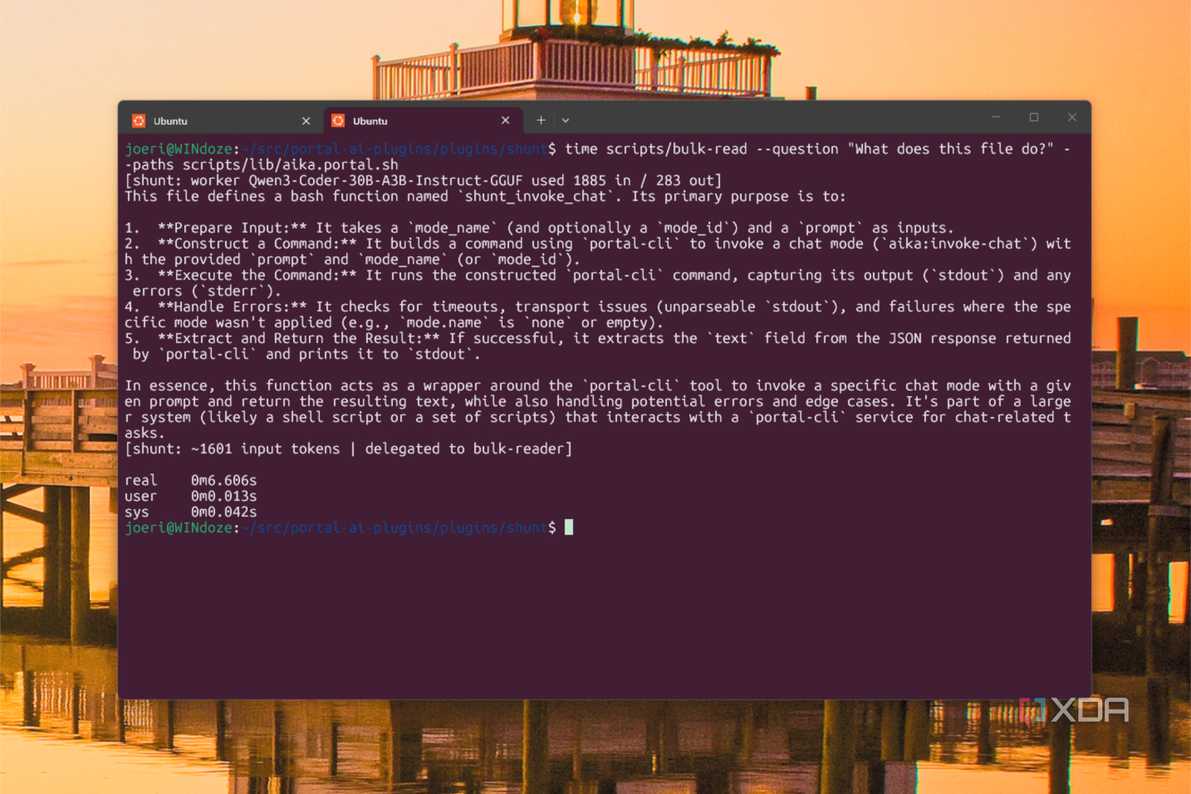
Исходное решение Spotify строилось на использовании двух режимов в корпоративной платформе Portal. Идея проста: бо́льшая часть работы агента заключается вовсе не в логическом мышлении, а в обычном чтении файлов. Когда инструмент пытается проанализировать документ длиннее 350 строк, специальный хук перенаправляет задачу на вспомогательную модель, которая возвращает краткую выжимку. Аналогичным образом работает и генерация шаблонного кода, отправляемого напрямую на диск.
Настройка плагина и первые технические трудности
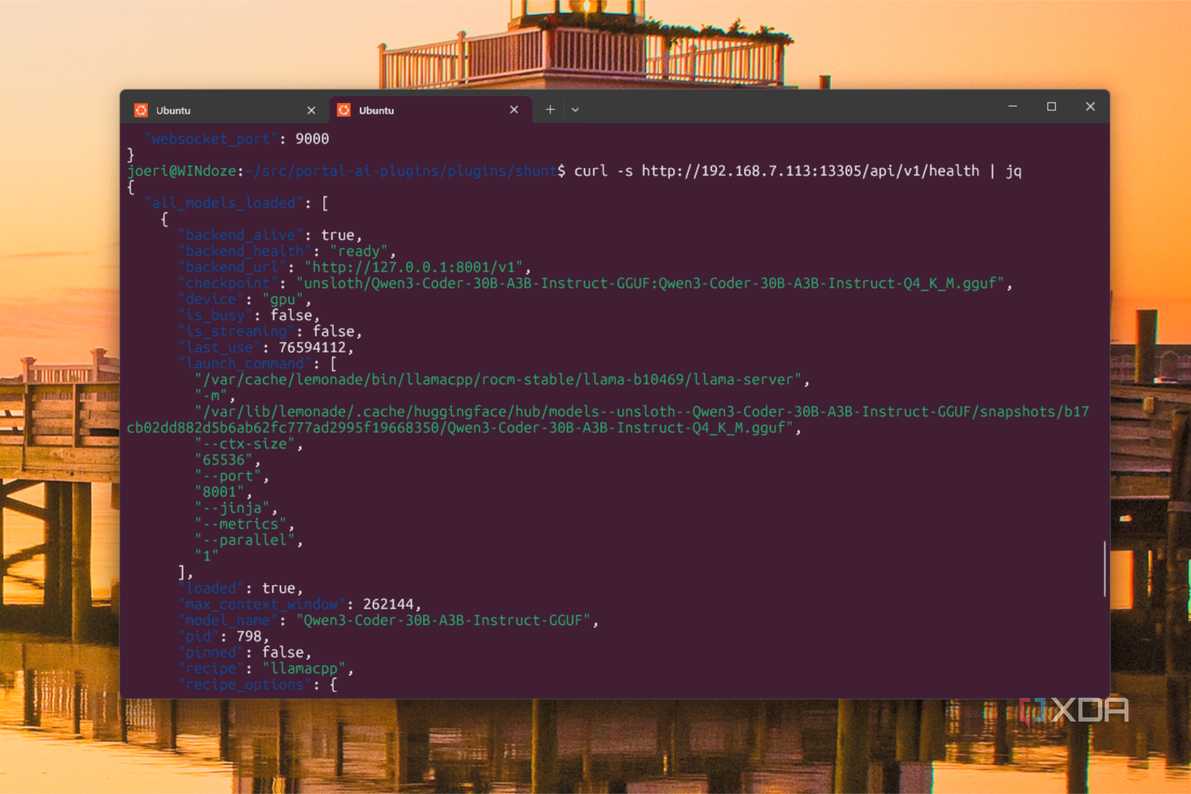
Согласно отчетам Spotify, на масштабных монорепозиториях экономия при чтении крупных файлов достигала 90% при задействовании условного Gemini 2.5 Flash в качестве рабочей модели. Поскольку оригинальный плагин является открытым, мне удалось отвязать его от закрытой экосистемы Portal. В качестве альтернативы я задействовал сервер Lemonade с локальной моделью Qwen3-Coder-30B-A3B и утилиту Claude Haiku через безголосовую сессию Claude Code, что ближе всего к оригинальной архитектуре.
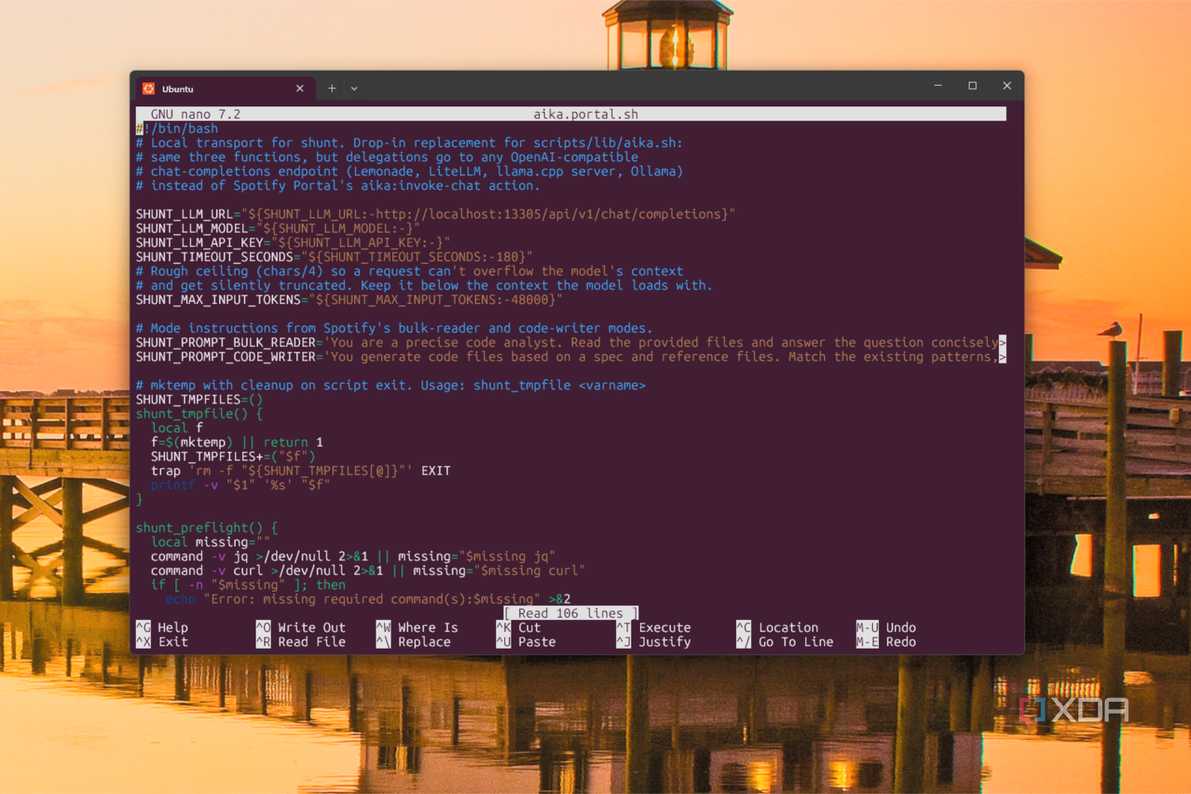
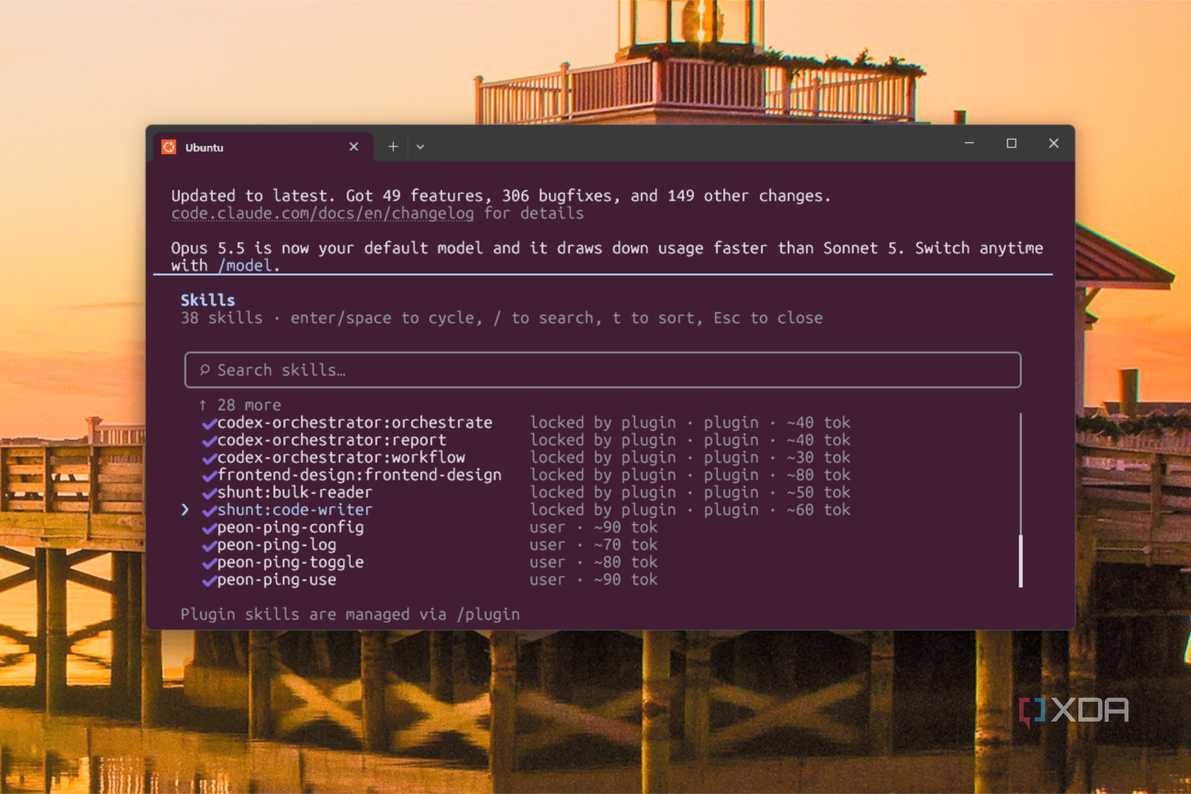
Однако перед тем как удалось запустить систему в работу и замерить первые токены, пришлось столкнуться с тремя серьезными сбоями. Во-первых, хуки плагина использовали устаревший формат команд, который текущая версия Claude Code просто не принимала, из-за чего все запросы завершались ошибками, пока я не изменил возвращаемые значения. Во-вторых, локальная модель выдавала некорректные данные: бэкенд ROCm заставлял Qwen3-Coder придумывать несуществующие функции, тогда как бэкенд Vulkan справлялся с копированием строк корректно. В-третьих, автономный режим Claude Code пытался задействовать интерактивные разрешения, которые в фоновом режиме приводили к сохранению системных подсказок вместо готового кода.
Почему стандартные хуки не сработали с актуальными моделями
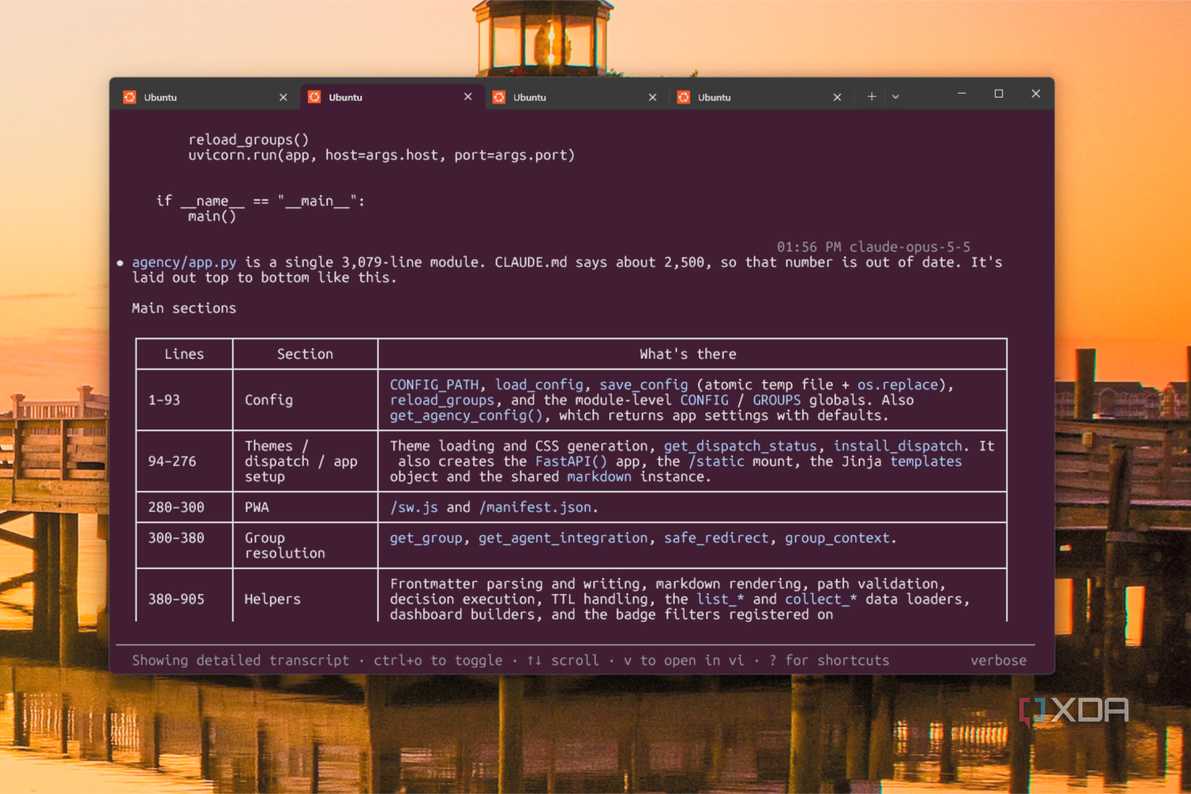
Моим испытательным стендом стала открытая панель Agency, а в роли главного мозга выступала актуальная модель Opus 5.5. Я замерял показатели в командной строке с помощью команды контекста, учитывая базовые фиксированные накладные расходы сессии. Первой задачей было извлечь все HTTP-маршруты из файла размером более 3000 строк. На практике Opus справился с помощью встроенного поиска grep, вообще не открывая сам файл целиком и потратив минимум токенов на формирование таблицы маршрутов.
Когда я усложнил задачу и попросил проанализировать логику организации кода и зависимостей, разница между включенным и выключенным плагином оказалась минимальной и укладывалась в рамки статистической погрешности. Модель Opus действовала ровно так же, как и раньше: находила нужные фрагменты через grep и точечно подгружала их через утилиту sed. Хуки плагина просто не перехватывали те команды, которые использовались в работе, поэтому специализированный навык чтения оставался невостребованным.
Делегирование записи: почему самостоятельная работа оказалась эффективнее
Убедившись, что функция чтения работала автономно и без помощи плагина, я перешел к тестированию генерации тестов для интерфейса командной строки. Opus успешно загрузил инструмент написания кода и сформировал детальную спецификацию, описав все требования к окружению, датам и стандартному вводу. Однако подключенные вспомогательные модели не смогли справиться с задачей на должном уровне.
Локальная модель Qwen3-Coder проигнорировала важные ограничения из спецификации и запустила тесты в неверной директории, в результате чего провалилось подавляющее большинство проверок. В итоге основной модели Opus пришлось читать весь черновой вариант и переписывать код с нуля. Вариант с Claude Haiku сработал точнее, но допустил ошибку с фиксированной датой в тестовых данных, из-за чего Opus также пришлось выполнять исправления. В результате делегирование потребовало на 23–34% больше токенов и заняло в семь-десять раз больше времени.
Скорость работы и целесообразность использования сторонних решений
Отдельной проблемой стала скорость генерации. На бэкенде Vulkan локальная модель выдавала около двенадцати токенов в секунду, из-за чего обработка файлов затягивалась на несколько минут, а иногда и вовсе приводила к тайм-аутам. Сессии с Claude Haiku также не отличались мгновенным откликом, поскольку фоновый запуск процессов добавлял существенную задержку. В конечном счете опыт Spotify актуален для тех сценариев, где базовые модели читают массивные файлы целиком на регулярной основе.
Если же ваша рабочая модель, подобно актуальным версиям от Anthropic, умеет работать с контекстом выборочно и самостоятельно проверяет качество сгенерированного кода, попытка подключить дополнительные слои делегирования лишь увеличит расходы. Перед внедрением подобных оптимизаций стоит проверить реальные показатели сессии: если инструмент не обращается к полномасштабному чтению крупных файлов, лучший способ сэкономить токены — оставить систему в исходном виде.
