
Мой блог
Как разработчики дообучили модель GigaAM-v3 для точного распознавания IT-терминов

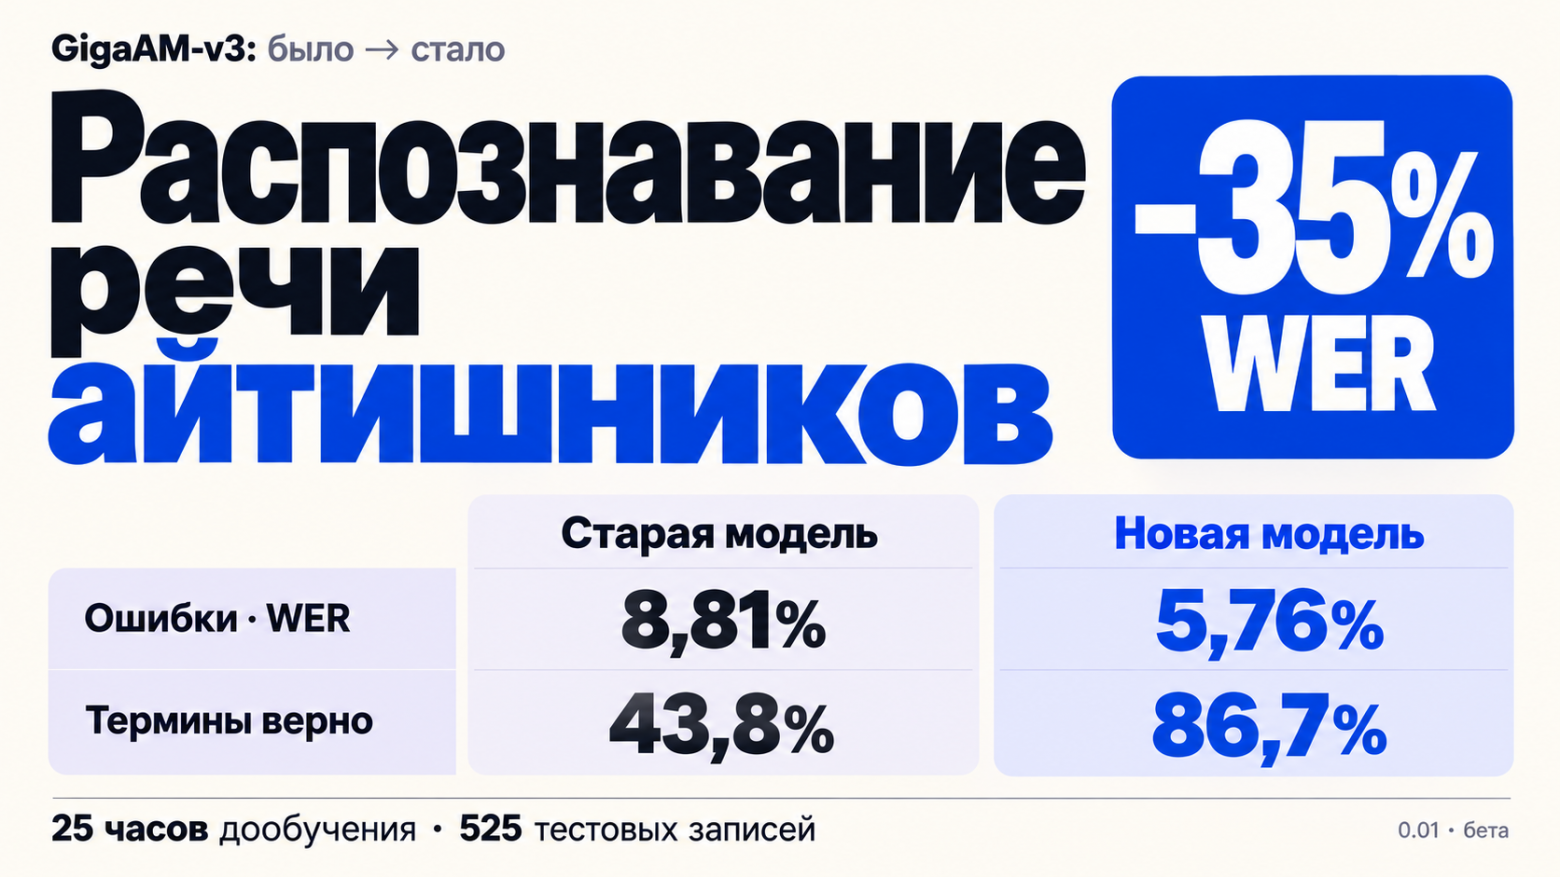
Авторы проекта по созданию программы для диктовки поделились опытом дообучения речевой модели GigaAM-v3. Популярное семейство алгоритмов хорошо справлялось с обычной русской связной речью, однако на специализированных IT-терминах и аббревиатурах часто допускало ошибки или полностью пропускало слова. Проведенное дообучение на 25 часах живой речи позволило значительно повысить точность расшифровки профессиональной лексики.
В данном материале подробно рассматриваются этапы сбора данных, особенности разметки с помощью вспомогательных алгоритмов, процесс настройки параметров обучения RNNT-архитектуры и результаты тестирования готовой версии.
Особенности базовой модели и задачи оптимизации
GigaAM-v3 построена на архитектуре Conformer. В рабочей конфигурации используется версия v3_e2e_rnnt, которая формирует итоговый текст сразу с расставленными знаками препинания и заглавными буквами. Обработка длинных аудиодорожек на сервере предварительно разделяется по паузам с помощью Silero VAD, а короткие сегменты поступают на анализ пачками.
В фокусе внимания разработчиков находились три категории распространенных ошибок: англоязычные наименования технологий, устоявшиеся заимствования вроде «дашборд» и аббревиатура «ИИ». Традиционный словарь текстовых замен помогал лишь частично, так как один и тот же технический термин в зависимости от произношения мог транслитерироваться совершенно по-разному. При этом архитектуру нейросети, код модели и исходный формат весов решили сохранить, чтобы обновленная версия бесшовно встала на место предыдущей.
Сбор и разметка тренировочного датасета
Для формирования качественной обучающей выборки короткие аудиофрагменты отбирались по результатам работы базовой модели с упором на наличие латиницы и вариативных терминов. К ним добавили образцы обычной разговорной речи и записи публичных подкастов на технологические тематики. Всего тренировочный массив составил более 25 часов аудиоматериала.
Каждую запись не расшифровывали вручную целиком: в конвейере использовали комбинацию базовой GigaAM и Whisper large-v3-turbo. Первая лучше удерживала русскую пунктуацию, а вторая точнее справлялась с английскими названиями. Для устранения разногласий применялась мультимодальная модель, которой передавали исходный звук и обе текстовые гипотезы для исправления нестыковок. Дополнительно внедрялись фильтры по метрикам схожести для отсечения артефактов и ошибочных сопоставлений.
Процесс дообучения RNNT-модели
Модель распространяется под лицензией MIT, которая разрешает модификацию и коммерческое использование при сохранении уведомлений об авторских правах. Процесс запускался на одной арендованной видеокарте A100 с объемом памяти 40 ГБ в среде PyTorch. В выбранной конфигурации были заморожены препроцессор, субдискретизация и первые десять слоев энкодера, а обучались верхние шесть слоев и RNNT-голова.
Параметры оптимизации включали использование алгоритма AdamW с дифференцированным шагом обучения для энкодера, линейный прогрев с последующим косинусным снижением, смешанную точность FP16 и метод аугментации SpecAugment. Из-за особенностей формирования тензора логитов батчи ограничивались как по суммарной длительности, так и по общему размеру элементов, чтобы предотвратить переполнение видеопамяти.
Результаты внедрения и оценка качества
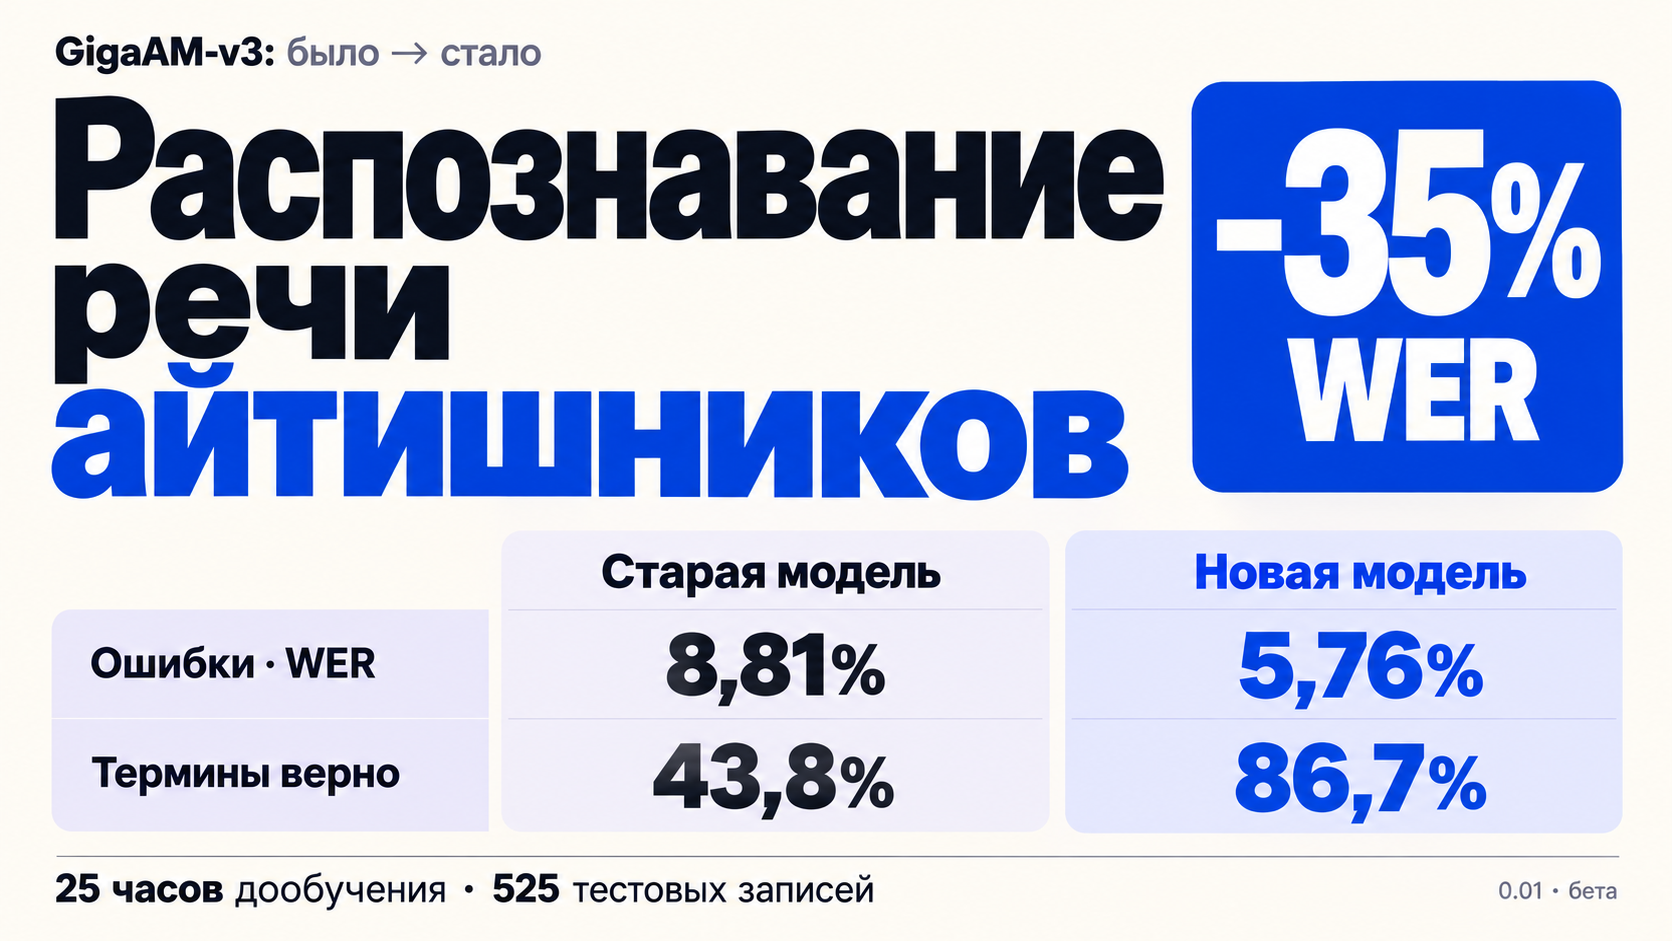
Сравнение исходной и дообученной версий на выделенных тестовых наборах показало заметный рост качества распознавания терминологии. На коротких записях доля корректно записанных терминов увеличилась с 43,8% до 86,7%, а показатель WER снизился примерно на 35%. Точность распознавания аббревиатуры «ИИ» также возросла.
Тем не менее, зафиксированы и специфические побочные эффекты: общее количество пропущенных слов в некоторых тестах слегка возросло, а метрики с учетом регистра и пунктуации на отдельных подмножествах данных ухудшились из-за изменения стиля разметки. Редкие наименования по-прежнему требуют расширения датасета.
Развертывание на сервере и дальнейшие планы
Обновленные веса хранятся в защищенной директории с проверкой контрольных сумм SHA-256 и подключаются через изолированные тома Docker. Переключение воркеров производилось последовательно с предварительным тестированием в автономном контейнере, включающим проверку обработки тишины и фонового шума.
В качестве приоритетных направлений для дальнейшей оптимизации разработчики выделяют улучшение распознавания обычной речи с точной пунктуацией, борьбу с пропусками слов и сбор дополнительных живых записей с редкими техническими терминами.
