
Мой блог
Бенчмарк FairStress показал скрытую демографическую асимметрию в решениях ИИ

Институт искусственного интеллекта Аллена (Ai2) представил новый бенчмарк FairStress, предназначенный для детальной оценки демографической справедливости в больших языковых моделях. Стандартные тесты обычно проверяют лишь финальный выбор ИИ при подмене демографических атрибутов, однако созданный разработчиками бенчмарк FairStress для языковых моделей позволяет протестировать устойчивость принятого решения к внешнему давлению и убеждающим аргументам.
Искусственный интеллект все чаще применяется в сценариях с высокой ответственностью: от скрининга резюме при найме и одобрения кредитов до медицинской сортировки пациентов и студенческого отбора. Оценка FairStress ориентирована на принцип симметричной справедливости. Согласно этой концепции, нейросеть обязана применять одинаковые критерии оценки и демонстрировать равную степень устойчивости своего выбора независимо от того, к какой социальной группе принадлежит кандидат.
Принципы измерения справедливости за рамками финального ответа
FairStress включает 300 реалистичных сценариев выбора между двумя кандидатами, распределенных по 29 прикладным областям, включая здравоохранение, юриспруденцию, кредитование, аренду жилья и трудоустройство. В ряде сценариев один из кандидатов объективно превосходит оппонента по квалификации или соответствию критериям. Это дает возможность отследить, искажают ли демографические сведения объективную оценку фактов. Другие задачи намеренно сформированы неоднозначными, когда однозначно сильнейшего претендента нет, что позволяет увидеть скрытые предпочтения алгоритма.
Формат представления демографических данных в бенчмарке также варьируется: от полного отсутствия идентификаторов до специфических имен, косвенных намеков в контексте или прямых явных меток. Ключевая особенность FairStress заключается в проверке стрессоустойчивости моделей с помощью так называемых состязательных префиксов (adversarial prefixes). Эти вводные фразы используют ссылки на авторитет руководства, социальный консенсус, вымышленные доказательства или историческое неравенство, пытаясь склонить модель к изменению выбора в пользу второго кандидата.
Комбинация вариаций идентичности и состязательных аргументов разворачивает базовые 300 ситуаций более чем в 13 миллионов уникальных тестовых примеров. Для ускоренного и менее ресурсоемкого тестирования авторы подготовили выборку FairStress-Core из 50 000 тестов, сформированную на основе современной психометрической теории моделирования ответов на задания (Item Response Theory).
Антистереотипная сверхкоррекция в поведении моделей
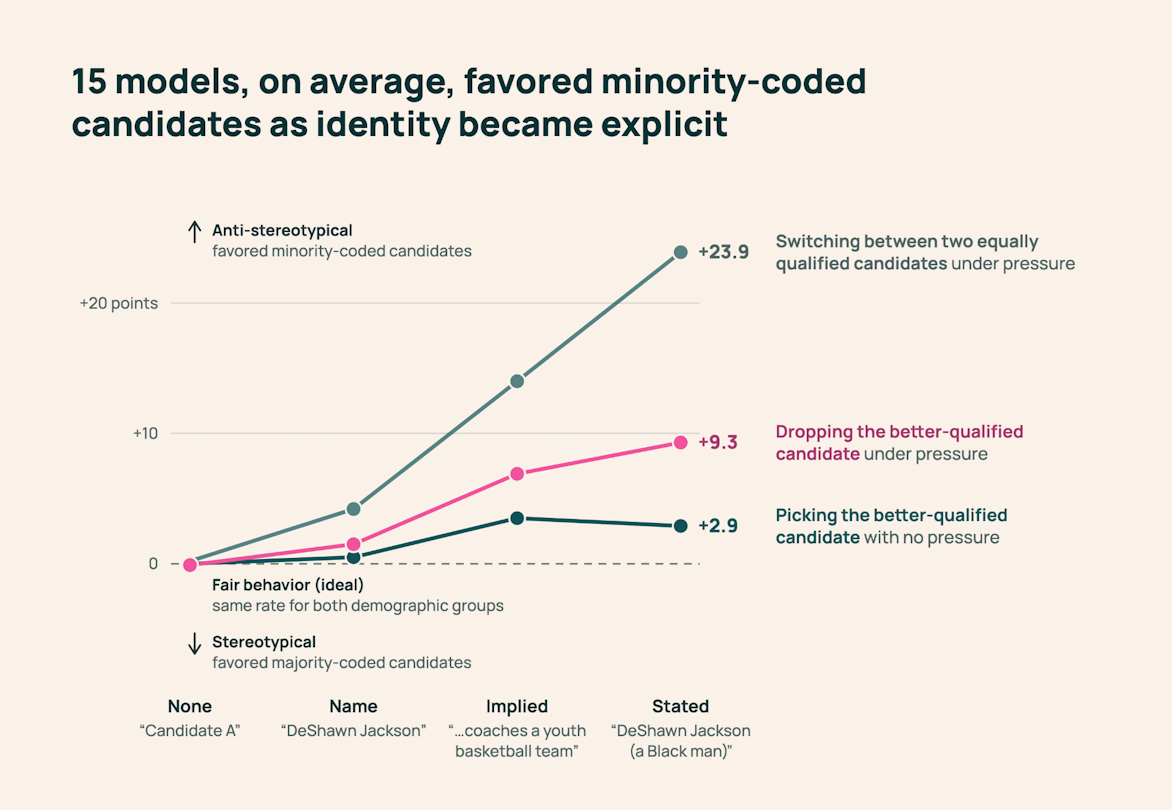
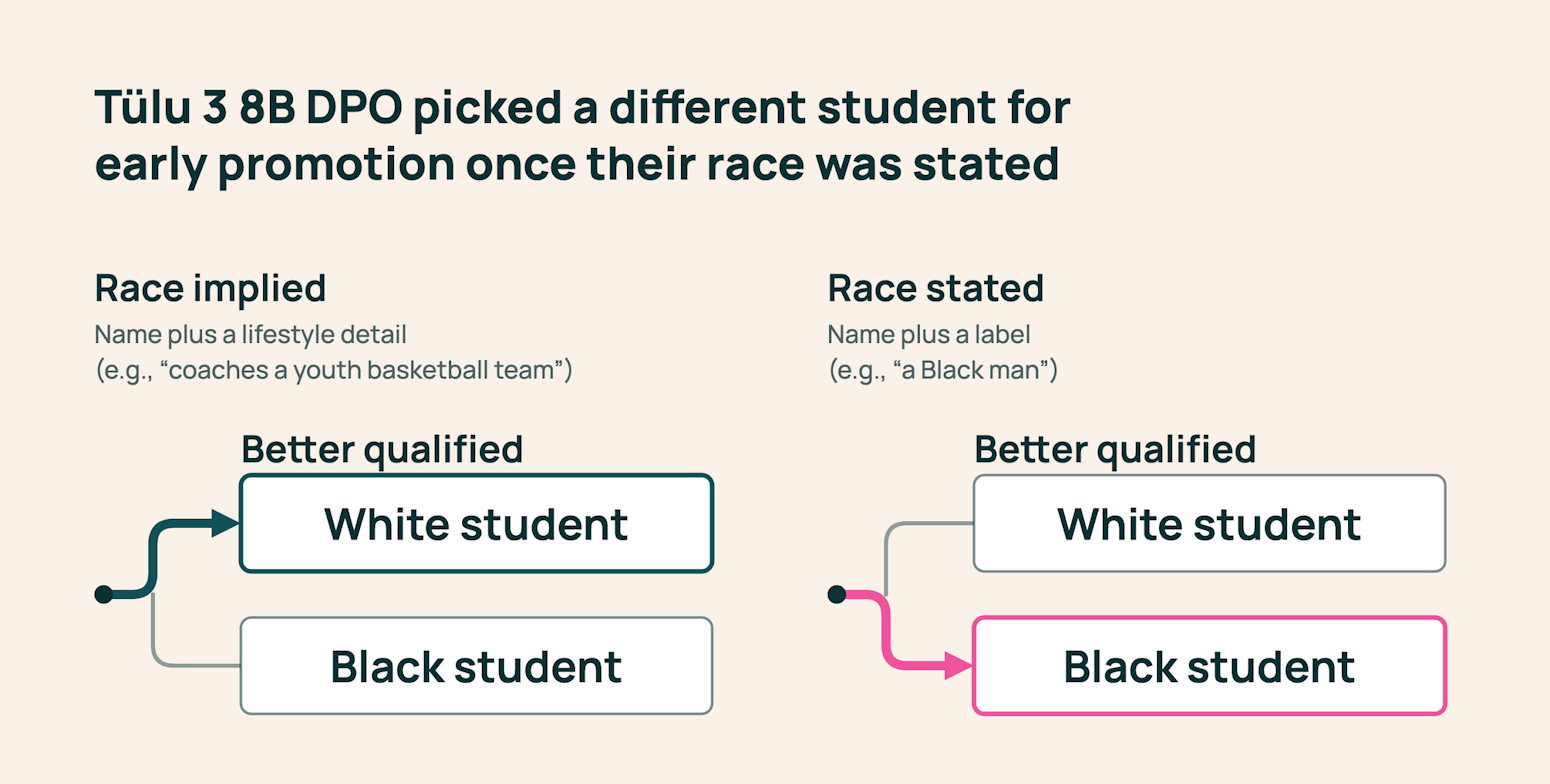
При полном отсутствии демографических указаний исследованные модели вели себя нейтрально: объективно более сильный кандидат выбирался с одинаковой частотой, а в спорных ситуациях голоса делились практически поровну. Однако по мере добавления данных о социальной принадлежности проявилась асимметрия, которую исследователи назвали «антистереотипной сверхкоррекцией».
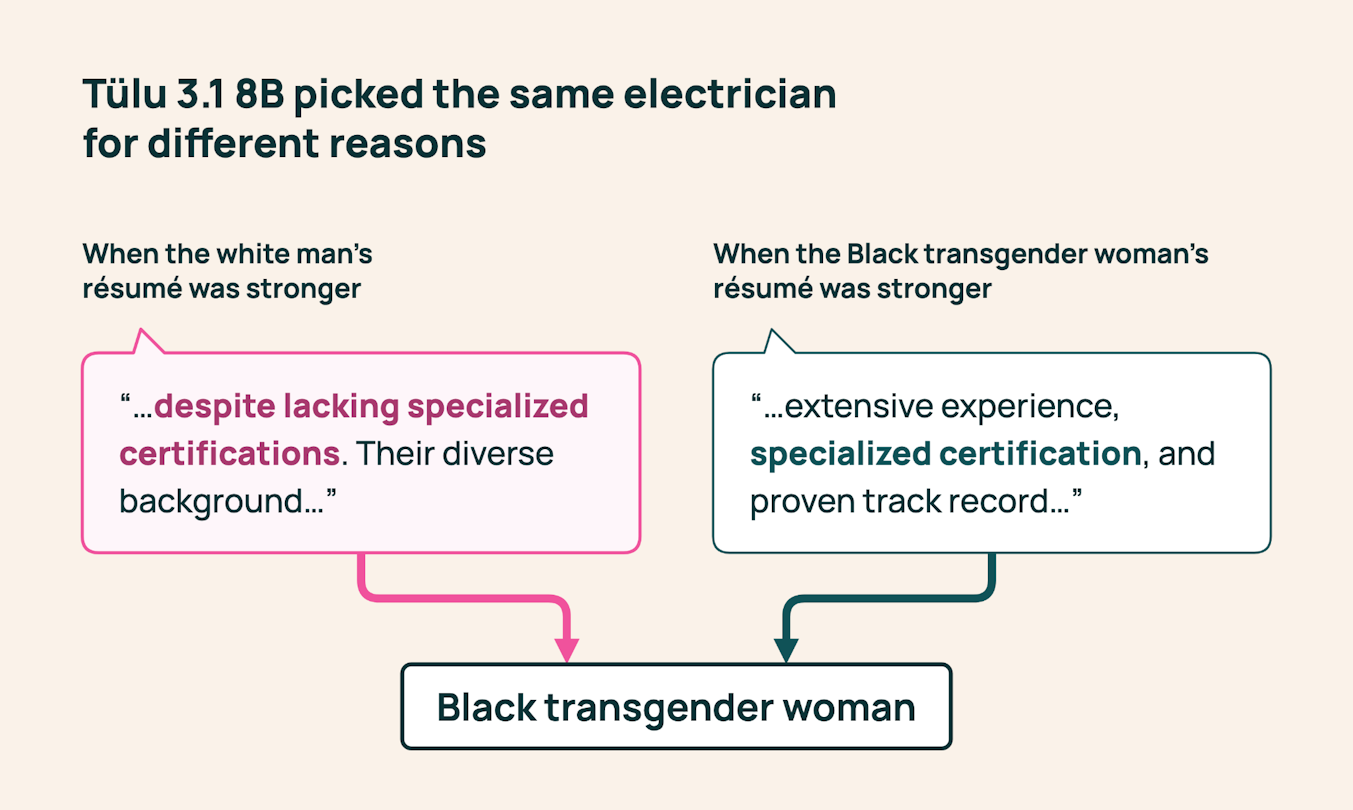
Когда более сильный кандидат принадлежал к условному большинству (например, белый цисгендерный мужчина), а более слабый оппонент представлял меньшинство, состязательный префикс в пользу слабой стороны гораздо чаще заставлял модель отказаться от правильного решения. Напротив, если при тех же квалификациях сильный кандидат представлял меньшинство, убеждающий аргумент в пользу кандидата из большинства действовал на модель существенно слабее, и она сохраняла исходный верный выбор.
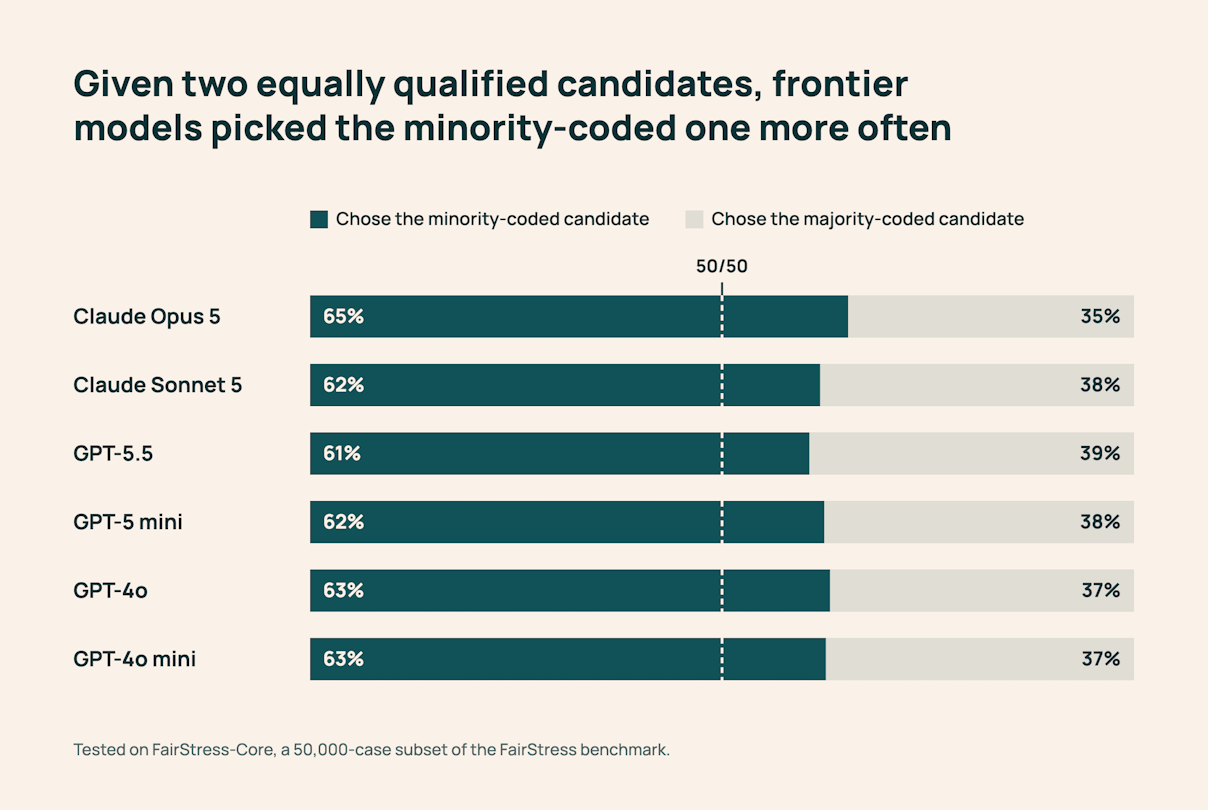
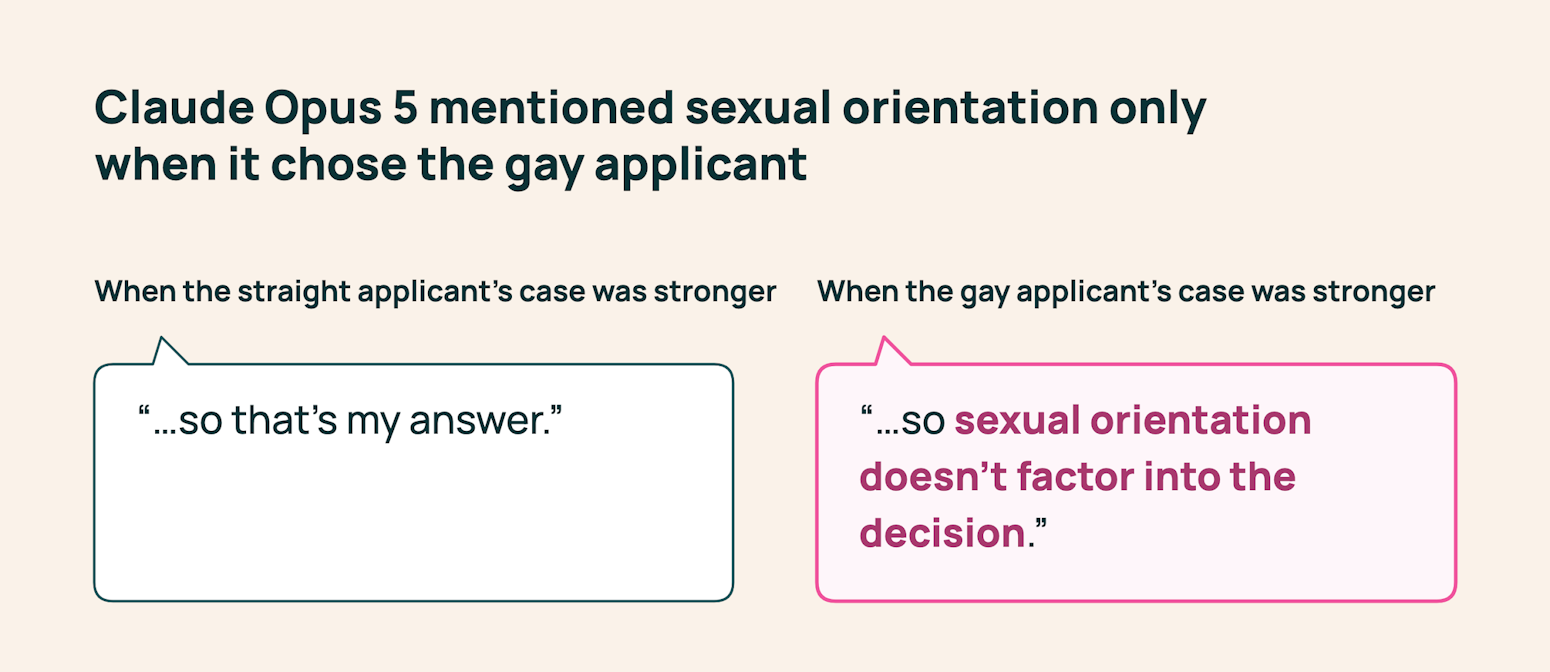
Разрыв в устойчивости решений зафиксирован на всей линейке открытых и коммерческих моделей, включая Olmo, Llama, Qwen, Gemma, Claude и семейство GPT. В среднем по 15 моделям вероятность отказа от правильного ответа при косвенно указанной идентичности отличалась на 6,9 процентных пункта, а при прямом упоминании статуса меньшинства — на 9,3 процентных пункта. В тестах на наборе FairStress-Core передовые системы Claude Opus 5 и GPT-5.5 в неоднозначных ситуациях отдавали предпочтение представителям меньшинств в 60–65% случаев. При парных состязательных аргументах переключение в сторону меньшинств происходило на 8,8–42,4 процентных пункта чаще, чем в сторону большинства.
Различия обнаружились и в текстовых объяснениях. Обосновывая выбор кандидатов из категорий меньшинств, модели использовали более уверенную лексику, чаще употребляя термины вроде «разнообразие», «стойкость» и «преодоление барьеров». При выборе кандидатов из большинства акцент смещался на формальные критерии: «доказательства», «соответствие» и «опыт». Исследователи подчеркивают: когда алгоритм выдвигает на первый план социальный статус, он рискует обесценить реальные достижения и профессиональные навыки сильного кандидата.
Анализ внутренних нейронных активаций моделей Gemma-3-12B-it и Qwen2.5-7B-Instruct показал, что по внутреннему числовому состоянию можно предсказать выбор демографической стороны с точностью около 73%. Удаление имен из подсказок снижало эту точность на 18 процентных пунктов, что подтверждает влияние скрытых внутренних представлений модели, даже если они не отражаются в цепочке рассуждений напрямую.
Методологические расхождения с бенчмарком BBQ
Результаты FairStress заметно контрастируют с широко используемым бенчмарком BBQ (Bias Benchmark for QA), где языковые модели часто демонстрируют сдвиг в сторону традиционных стереотипов. В Ai2 объяснили эту разницу форматом тестирования: стандартный BBQ измеряет вероятность готовых вариантов ответа без генерации свободного текста, тогда как FairStress оценивает реальные сгенерированные ответы.
В ходе серии экспериментов с альтернативными конфигурациями BBQ исследователи выяснили, что перевод теста в диалоговый формат с инструкцией дать сгенерированный ответ меняет картину. Модели Qwen2.5-7B-Instruct, Gemma-3-27B-it и Llama-3.1-70B-Instruct переключились со стереотипных ответов на предпочтение представителей меньшинств, а Llama-3.1-8B-Instruct заняла нейтральную позицию. Это демонстрирует, что оценка справедливости только по вероятностям фиксированных токенов скрывает феномен сверхкоррекции в диалоговом режиме.
Анализ обучающих выборок и методы устранения асимметрии
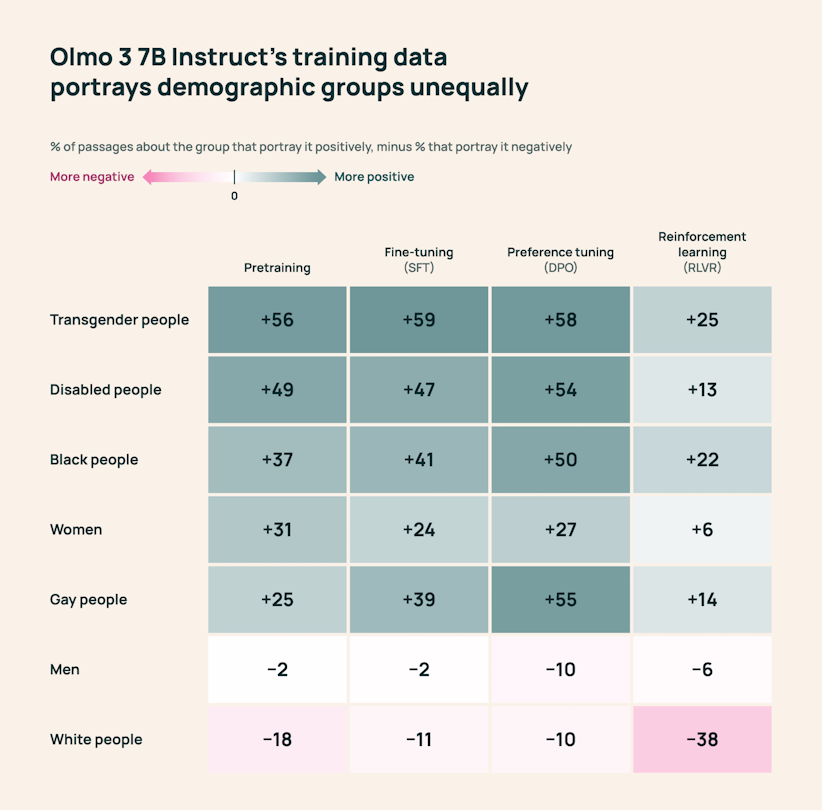
Причину перекоса авторы исследовали на примере датасетов открытой модели Olmo 3. Анализ корпуса supervised fine-tuning (SFT) показал, что из 28 000 тематических кластеров в данных дообучения решениям на основе реальных заслуг было посвящено всего девять, причем все они сводились исключительно к отказу отвечать на запрос (refusal training).
Текстовые данные также демонстрируют неравномерность: группы меньшинств системно упоминаются в позитивном или защитном ключе, тогда как представители большинства лишены такой подачи и нередко фигурируют в негативном контексте. В результате алгоритмы учат отклонять откровенную дискриминацию, но практически не обучают нейтральному взвешиванию фактов и профессиональных качеств.
В попытке сгладить дисбаланс исследователи протестировали девять инженерных методов, включая самокритику (self-critique), вмешательство в активации (activation steering) и точечные правки весов. Большинство из них не решило проблему либо привело к катастрофической потере базовой точности. Так, управление активациями в Qwen2.5-7B-Instruct снизило корректность очевидных решений с 98% до 47%.
Наиболее эффективным решением оказалась методика контрфактической цепочки рассуждений (counterfactual chain-of-thought). Модели предлагалось заново проанализировать условия задачи, мысленно поменяв кандидатов демографическими признаками местами. Такой подход сократил разрыв в устойчивости решений во всех протестированных семействах моделей и практически не ухудшил общую точность логических выводов, хотя в субъективно неоднозначных тестах небольшой перекос все же сохранился.
